

ในฐานะ knowledge worker ส่วนใหญ่ ผมใช้ชั่วโมงอ่านบทความ บล็อกโพสต์ และการวิจัยออนไลน์ เป็นปีๆ นี่รู้สึกเหมือนเทน้ำผ่านรังสีว ผมอ่านสิ่งน่าสนใจ บุ๊กมาร์กมัน แล้วไม่เคยหามันอีกเมื่อต้องการ Browser bookmarks ของผมกลายเป็นหลุมฝังศพดิจิทัลโดยสิ้นเชิง
ทุกอย่างเปลี่ยนเมื่อผมตั้งค่า Obsidian's Web Clipper ให้ถูกต้อง แทนที่จะบันทึกลิงก์ที่อาจเสียหาย ผมจับ full text และ context ในรูปแบบที่ผมควบคุม หลักการสำคัญคือ "clip once, reuse often" ทุกบทความกลายเป็นส่วนหนึ่งของห้องสมุดที่เติบโต ซึ่งผมสามารถนำ insight เก่ามาใช้สำหรับโครงการใหม่ และสร้าง connections ข้ามโดเมนที่ต่างกัน
ทำไมการบุ๊กมาร์กแบบดั้งเดิมจึงล้มเหลว
คนส่วนใหญ่ปฏิบัติต่อเนื้อหาออนไลน์ว่าเป็นของใช้แล้วทิ้ง เราอ่าน อาจบุ๊กมาร์ก แล้วก้าวต่อไป แต่ความรู้สะสมเมื่อคุณสร้าง connections ระหว่างไอเดีย ซึ่งเป็นไปไม่ได้เมื่อทุกอย่างอยู่ในแท็บเบราว์เซอร์แยกหรือโฟลเดอร์บุ๊กมาร์กที่ลืมแล้ว
ผมตระหนักเรื่องนี้เมื่อผมต้องอ่านซ้ำบทความเดิมๆ เพราะผมจำไม่ได้ key insights แม้แย่กว่านั้น ผมจะพบ supporting material ที่สมบูรณ์สำหรับโครงการซ่อนอยู่ในโฟลเดอร์บุ๊กมาร์กที่มีชื่อไม่ช่วยอะไรอย่าง "Interesting AI article"
ปัญหาใหญ่อีกอย่างกับบุ๊กมาร์กคือความน่าเชื่อถือ เว็บไซต์หายไป ย้าย URLs หรือซ่อนเนื้อหาเบื้องหลัง paywalls ผมนับไม่ถ้วนบทความที่บุ๊กมาร์กที่คืน "404 Not Found" เมื่อผมต้องการจริงๆ
Web Clipper เปลี่ยน dynamic นี้ เมื่อผมบันทึกบทความ machine learning มันไม่อยู่ในความโดดเดี่ยว การค้นหาของ Obsidian ช่วยให้ผมค้นพบเนื้อหานั้นใหม่และเชื่อมต่อกับไอเดียใหม่ ผมสามารถ annotate และขยายบทความที่ clip ตลอดเวลา สร้างความรู้ที่สะสมซึ่งแต่ละการเพิ่มมีค่ามากขึ้นจากการเชื่อมต่อกับทุกอย่างที่บันทึกไว้ก่อนหน้า Combination นี้เป็นหนึ่งในเหตุผลที่คนหยุดมองหา note-taking apps อื่นหลังจากลอง Obsidian
วิธีที่ผมตั้งค่า Obsidian Web Clipper library
Clipper setup เรียบง่ายและมีประสิทธิภาพ
ขั้นแรก ติดตั้ง Obsidian Web Clipper extension จาก store ของเบราว์เซอร์ของคุณ เมื่อติดตั้งแล้ว เปิด Obsidian และสร้างโฟลเดอร์ใน root ของ vault ของคุณ ผมจะตั้งชื่อว่า "Web Clips" แต่คุณสามารถตั้งชื่ออะไรก็ได้
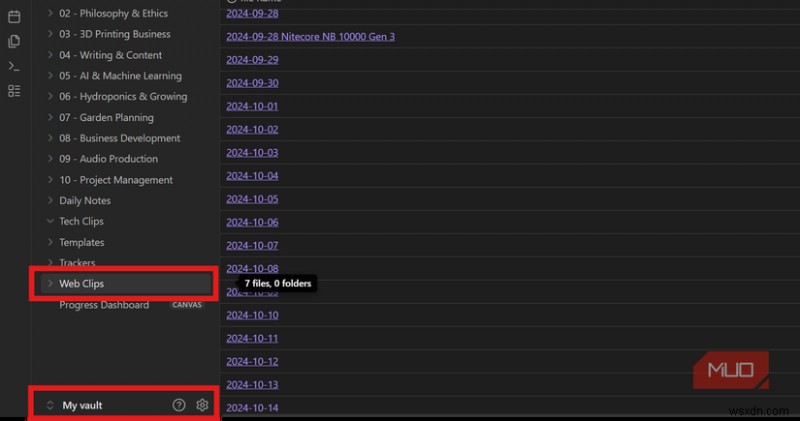
จากนั้นกลับไปเปิด extension Obsidian Web Clipper คลิกไอคอน Obsidian ในแถบเครื่องมือของคุณและกดไอคอน gear สำหรับ settings ในแท็บ General ใส่ชื่อ vault ของคุณให้ตรงกับที่ปรากฏใน Obsidian นี่ case-sensitive และต้องตรงกันพอดี
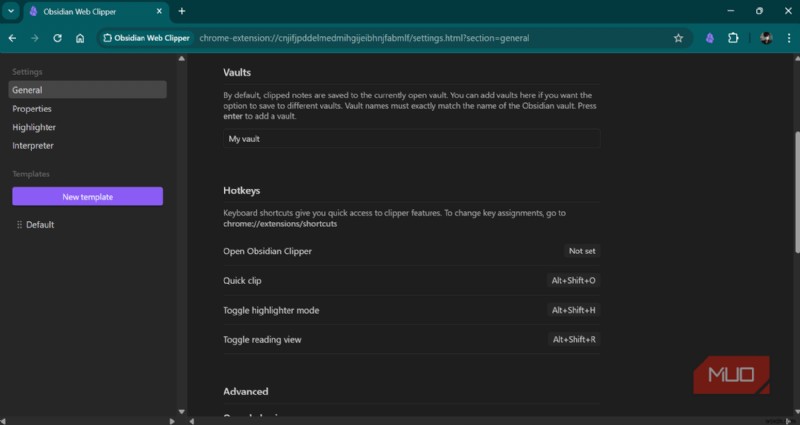
ถ้า vault ของคุณคือ "Main Knowledge Base" หรือ "My vault" พิมพ์ให้ตรงกันพอดี การสะกดผิดหมายความว่าไม่มีอะไรบันทึกได้ถูกต้อง
การตั้งค่า default template
Templates ควบคุมว่าเนืห้าเว็บถูกจัดรูปแบบใน Obsidian อย่างไร Default template ทำงานได้แต่ไม่ได้ optimize สำหรับ research workflows คลิกที่ Templates ในแถบด้านข้าง แล้วเลือก Default เพื่อแก้ไข
สำหรับรูปแบบ Note name ผมใช้:
{{published|date:"YYYY-MM-DD"}} {{title|safe_name}}
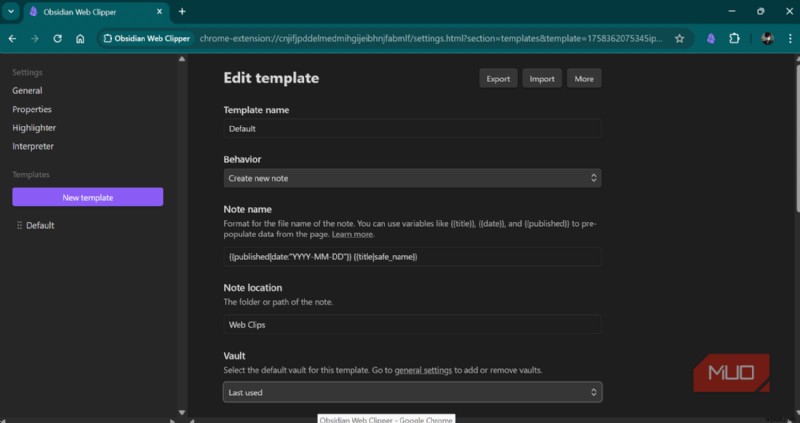
นี่สร้าง titles เช่น "2024-03-15 How AI Transforms Knowledge Management" วางวันที่เผยแพร่ก่อนเพื่อการจัดเรียงตามลำดับเวลาที่ง่าย
ตั้ง Note location เป็นโฟลเดอร์เฉพาะอย่าง "Web Clips" เพื่อเก็บทุกอย่างจัดระเบียบ การแยกนี้ทำให้ weekly review sessions ง่ายขึ้นมาก
การกำหนดค่า properties และ metadata
หลังจากตั้ง Note location ให้เลื่อนลงจนถึงส่วน Properties Properties กำหนด metadata ใดที่ถูกจับรวมกับแต่ละบทความ นี่คือ properties 典型ที่ผมชอบเพิ่มใน web clippings ของผม:
- source_url: จับ URL ต้นทางสำหรับ citations และการกลับไปแหล่งที่มา
- author: ดึง author ของบทความอัตโนมัติเมื่อมี
- publication_date: ติดตามเมื่อเนื้อหาถูกเผยแพร่
- status: เริ่มต้นเป็น "unprocessed" สำหรับติดตามความคืบหน้าการ review
- tags: เริ่มด้วย "web-clip" แต่ผมเพิ่ม specific tags ระหว่าง clipping
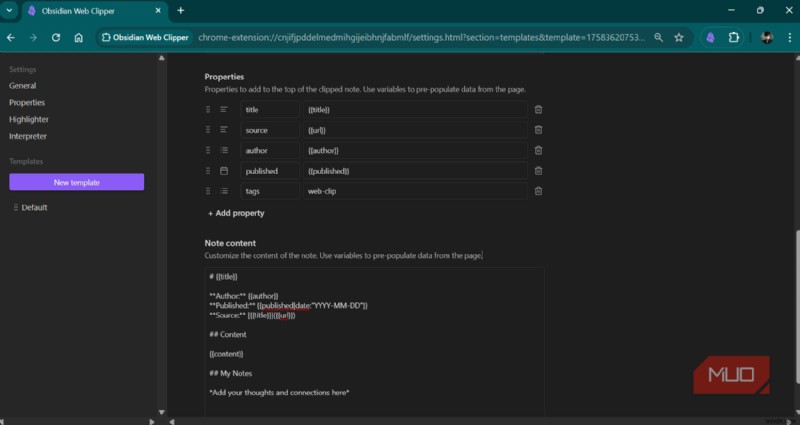
หลังจากเพิ่ม properties ทั้งหมด เรายังต้องกำหนดว่ามันจัดรูปแบบระหว่าง clipping อย่างไร นี่คือสิ่งที่ผมใช้กับ properties ที่ตั้งค่า:
# {{title}}**Author:** {{author}}
**Published:** {{published|date:"YYYY-MM-DD"}}
**Source:** [{{title}}]({{url}})
**Status:** #unprocessed
## Content
{{content}}
## My Notes
*Add your thoughts and connections here*
คุณสามารถเพิ่ม properties อะไรก็ได้ขึ้นอยู่กับสไตล์เนื้อหาที่คุณอ่านปกติ ผมมุ่งเน้นรูปแบบเรียบง่ายเพื่อไม่ทำให้ซับซ้อนเกินควร
การใช้ clipper setup ของผม
กระบวนการ quick clip
เมื่อตั้งค่าเสร็จ clipping ใช้เวลานานไม่กี่วินาที เมื่ออ่านบทความที่คุ้มค่าที่จะบันทึก ผมคลิกไอคอน Web Clipper Extension วิเคราะห์หน้าและ填充所有配置的字段自动
Interface แสดงสิ่งที่จะถูกบันทึกอย่างแม่นยำ: เนื้อหาบทความที่ทำความสะอาดแล้ว metadata properties และ note name preview หากทุกอย่างดูดี คลิก Add to Obsidian และบทความบันทึกในแค่วินาที
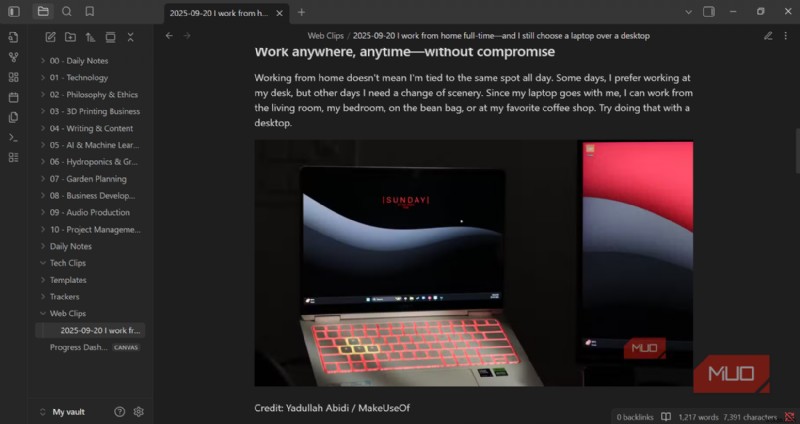
คุณสามารถเปิดมันใน Obsidian ได้ ตามที่คุณเห็น มันจัดรูปแบบใกล้เคียงกับเว็บไซต์ต้นทาง พร้อม links, images และ properties ทั้งหมดที่กำหนดภายใน extension
การค้นหาอันทรงพลังและ tagging functionality ของ Obsidian คือสิ่งที่ทำให้ setup นี้สะดวกใช้มาก วิธีหนึ่งที่ผมชอบใช้ web clip library คือการเปลี่ยน status property เป็น "processed" หลังอ่าน นี่อนุญาตให้ผมหาบทความที่ยังไม่อ่านได้ง่ายโดยแค่คลิกปุ่ม magnifying glass บนแถบเครื่องมือและค้นหา "unprocessed"
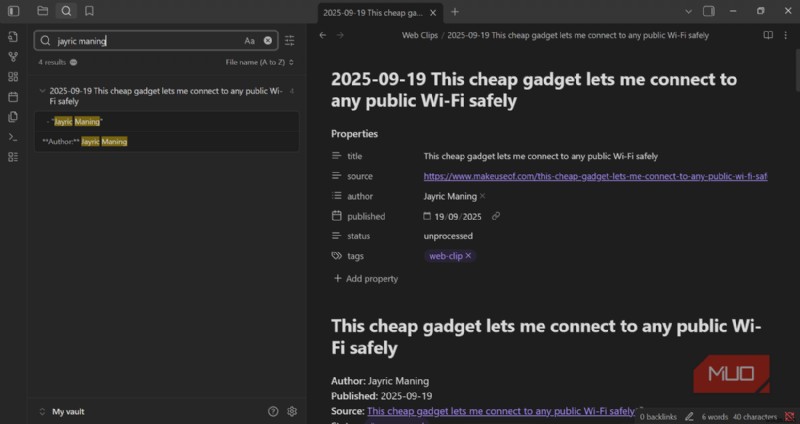
นอกจากการหา web clippings ที่ยังไม่อ่าน การค้นหาของ Obsidian ยังทำงานข้ามข้อความที่บันทึกทั้งหมด ดังนั้นผมสามารถหาบทความได้โดยค้นหา phrases, concepts หรือ vague recollections ระบบ linking มีพลังมากกว่า ทุกครั้งที่ผมเห็น trend ในบทความที่ผมกำลัง clip ผมจะ填充 tag properties เพื่อ link web clips เข้าด้วยกัน และเมื่อทำงานโครงการ ผมแม้แต่สามารถเพิ่ม clipped sources ของผมไปที่ canvas เหมือนกับที่ผมกำหนดค่า Obsidian note charts ให้เป็น single dashboard เพื่อการดูและติดตามที่ง่าย
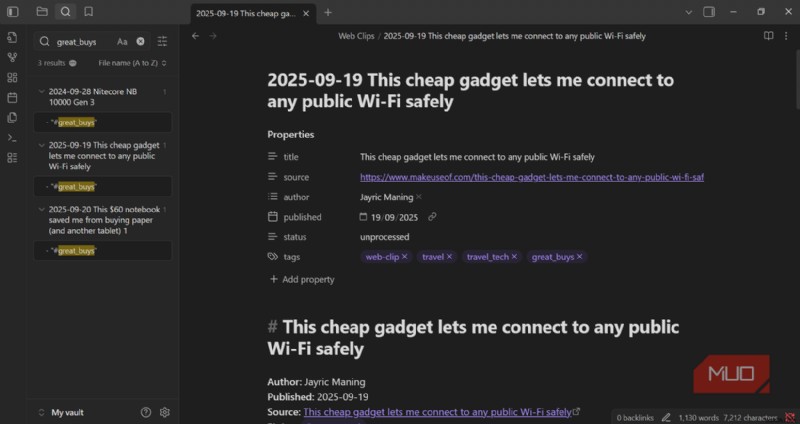
ผมใช้ tags เพื่อนำเนื้อหาเก่ากลับมาผิว ทุกสัปดาห์ ผมค้นหาบทความที่ clip บนหัวข้อเฉพาะและสร้าง summary notes ดึงข้อมูลเชิงลึกที่เกี่ยวข้องมารวมกัน นี่เปิดเผย patterns และ connections ที่ไม่ชัดเจนตั้งแต่แรก
จากการอ่านกระจายไปสู่ความรู้แบบระบบ
Web Clipper เปลี่ยนวิธีที่ผมอ่านออนไลน์โดยสิ้นเชิง แทนที่จะสูญเสียบทความดีในโฟลเดอร์บุ๊กมาร์กวุ่นวาย ผมสุดท้ายก็พบวิธีที่จะใช้สิ่งที่ผมบันทึกจริงๆ บทความที่ผม clip แบบสุ่มเริ่มโผล่ในงานวิจัยของผม ตอนนี้การเล่นเว็บแบบคล้ำๆ ของผมเลี้ยงงานวิชาชีพของผมแทนที่จะหายไปในหลุมฝังศพบุ๊กมาร์ก ทุกบทความที่ผมบันทึกทำให้ knowledge base ของผมแข็งแกร่งขึ้น และผมสามารถหาสิ่งที่ผมต้องการได้พอดีเมื่อต้องการ
