

การสร้างข้อมูลแบบเพิ่มเติมด้วยการดึงข้อมูล (Retrieval‑augmented generation - RAG) ควรเสริมโมเดลภาษาขนาดใหญ่ด้วยความรู้ภายนอก ระบบ RAG อาจทำงานได้อย่างสวยงามในสาธิต: ชุดข้อมูลเล็กที่ได้รับการดูแล คำค้นหาที่สะอาด และงบประมาณเวลาแฝงที่ไม่มีข้อจำกัด นำไปสู่คำตอบที่มีความรู้และมีพื้นฐาน ซึ่งผู้ใช้เชื่อว่าถูกต้อง อย่างไรก็ตาม ทีมหลายทีมพบว่าหนึ่งครั้งที่ปรับใช้แอปพลิเคชัน RAG ของพวกเขาให้ผู้ใช้ ประสิทธิภาพจะล้มลง คำค้นหากลายเป็นคลุมเครือ คอรัสขยายตัว คุณภาพการดึงข้อมูลลดลง เวลาแฝงเพิ่มขึ้น และระบบเริ่มลดความแม่นยำไปในเงๆ แม้แต่ยิ่งกว่านั้น เทคนิคการประเมินที่ไม่ดีจะซ่อนว่าระบบเริ่มล้มเหลวที่ไจนจนกว่าผู้ใช้จะร้องเรียน บทความนี้สำรวจเหตุผลว่าทำไมระบบ RAG หลายระบบถึงล้มเหลวในการผลิต เราได้รับข้อมูลจากงานวิจัยล่าสุดและแนวทางปฏิบัติของอุตสาหกรรม เราจัดกรอบปัญหาเกี่ยวกับคุณภาพการดึงข้อมูล การแลกเปลี่ยนเวลาแฝง การลอยตัวของ embedding และช่องว่างการประเมินผลเป็นห่วงโซ่ของโหมดความล้มเหลว แต่ละลิงก์ในห่วงโซ่นี้ต้องได้รับการคำนึงถึงเพื่อสร้างระบบ RAG การผลิตที่แข็งแกร่ง
ข้อสรุปสำคัญ
- ความล้มเหลวของ RAG ส่วนใหญ่เริ่มต้นที่การดึงข้อมูล ไม่ใช่การสร้าง เมื่อระบบดึงหลักฐานที่ไม่สมบูรณ์ ไม่เกี่ยวข้อง หรือจัดอันดับหลักฐานอย่างไม่ดี แม้ LLM ที่แข็งแกร่งก็จะสร้างคำตอบที่อ่อนแอ
- การดึงข้อมูลที่ดีขึ้นต้องการเลือกทางการวิศวกรรมที่ดีขึ้น การแบ่งชันข้อมูลที่ตระหนักโดเมน (domain-aware chunking) การดึงข้อมูลแบบไฮบริด และการจัดอันดับใหม่ (reranking) ถูกนำเสนอเป็นเทคนิคหลักเพื่อปรับปรุงความเกี่ยวข้องและลดความล้มเหลวในการดึงข้อมูลที่เงียบๆ
- เวลาแฝงกลายเป็นข้อคอขวดในการผลิตอย่างรวดเร็ว การเพิ่ม top_k ให้ใหญ่ขึ้น การเพิ่ม reranker บริบทยาว และขั้นตอนการดึงข้อมูลเพิ่มเติม อาจปรับปรุงการเรียกคืน (recall) ได้ แต่ก็อาจทำให้ระบบช้าจนเกินกว่าผู้ใช้จริงจะทนได้
- การลอยตัวของ Embedding (Embedding drift) ลดประสิทธิภาพลงเงียบๆ ตามเวลา การเปลี่ยนแปลงของโมเดล embedding ชุดเอกสาร และคำศัพท์ของผู้ใช้ สามารถเปลี่ยนพฤติกรรมการดึงข้อมูลได้ จึงจำเป็นต้องมีการกำหนดเวอร์ชันและความสามารถในการสังเกต (observability)
- คุณภาพคำตอบสุดท้ายเพียงอย่างเดียวไม่เพียงพอสำหรับการประเมินผล ทีมต้องการเมตริกการดึงข้อมูลและการสร้างแยกกัน ชุดทดสอบที่เป็นจริง การตรวจสอบอย่างต่อเนื่อง และความสามารถของระบบในการไม่ตอบ (abstain) เมื่อหลักฐานอ่อนแมหรือหายไป
ความล้มเหลวเนื่องจากคุณภาพการดึงข้อมูลที่ต่ำ
คุณภาพการดึงข้อมูลที่ต่ำเป็นหนึ่งในสาเหตุที่พบบ่อยที่สุดของความล้มเหลวของระบบ RAG เมื่อปรับใช้ในสภาพแวดล้อมการผลิต นักพัฒนาบ่อยครั้งที่ 탓 LLM สำหรับคำตอบที่ผิด/แย่ อย่างไรก็ตาม ข้อบกพร่องมักอยู่ก่อนหน้าในไปป์ไลน์ หากระบบไม่สามารถดึงหลักฐานที่สมบูรณ์หรือเกี่ยวข้อง หรือจัดอันดับหลักฐานอย่างไม่ดี แม้โมเดลที่ดีที่สุดก็ไม่น่าจะสร้างคำตอบที่น่าเชื่อถือ คุณภาพการดึงข้อมูลควรถือเป็นเรื่องสำคัญระดับแรก (first-class engineering concern) มากกว่าขั้นตอนเบื้องหลัง
ความล้มเหลวส่วนใหญ่เกิดขึ้นก่อนที่ LLM จะเห็นคำค้นหา
ไปป์ไลน์มาตรฐาน埋め込みคำค้นหาของผู้ใช้ ดึงเอกสาร top‑k จาก vector store และส่งให้ LLM ทุกลูกศรในไปป์ไลน์นั้นเป็นจุดล้มเหลวที่เป็นไปได้
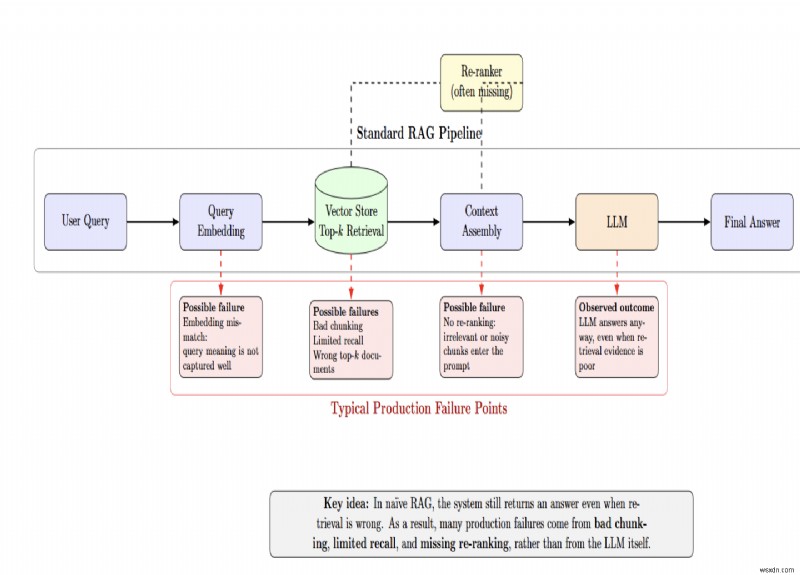
RAG แบบง่าย (Naïve RAG) ปิดบังความล้มเหลวเหล่านี้ เนื่องจากระบบให้คำตอบไม่ว่าการดึงข้อมูลจะผิดหรือถูก ปัญหาในการผลิตหลายอย่างเกิดจากกลยุทธ์การแบ่งชัน (chunking) ที่ไม่ดี การเรียกคืน (recall) จำกัด และการขาดการจัดอันดับใหม่ (re‑ranking) มากกว่าข้อบกพร่องของ LLM
ข้อผิดพลาดในการแบ่งชัน (Chunking) สร้างความล้มเหลวเงียบๆ
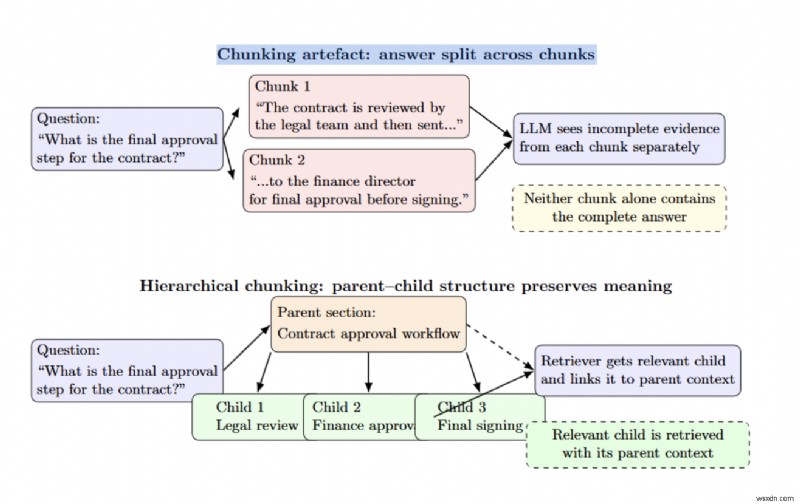
ขนาดชัน (chunk size) ส่งผลต่อ precision/recall — ชันขนาดใหญ่ให้บริบทมากขึ้นแต่ความเกี่ยวข้องน้อยลง ส่วนชันขนาดเล็กให้ความแม่นยำสูงแต่สูญเสียข้อมูลรอบข้าง การแบ่งชันแบบลำดับชั้น (hierarchical/parent–child chunking) แก้ไข trade‑off นี้โดยจัดเก็บส่วนทั้งหมดเป็น parent chunk และดึงเฉพาะ child chunk ที่เกี่ยวข้องขนาดเล็ก
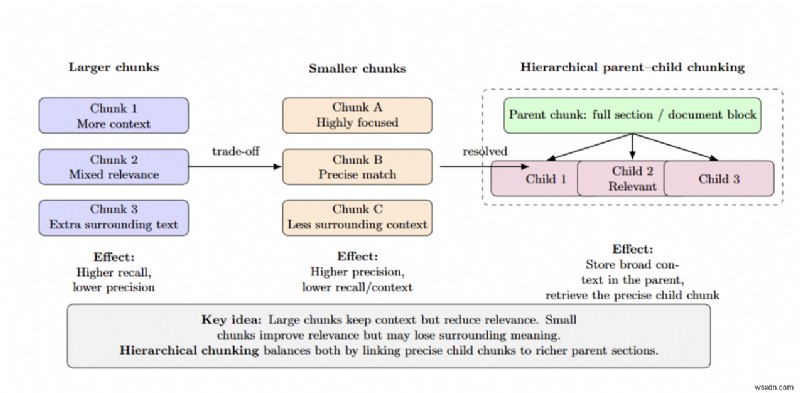
การทดสอบภายในของ NVIDIA บนสไลด์การนำเสนอของมหาวิทยาลัยพบว่าการแบ่งชันแบบลำดับชั้นปรับปรุงความแม่นยำของคำตอบจาก 61% ด้วย fixed‑size chunks เป็น 89% สำคัญที่จะเลือกขนาดชันที่เหมาะสม พร้อมทั้งเคารพขอบเขตโครงสร้างและใช้การแบ่งที่ตระหนักโดเมน (domain‑aware splitting) เมื่อเป็นไปได้
การดึงข้อมูลแบบไฮบริดและการจัดอันดับใหม่ (Re‑ranking)
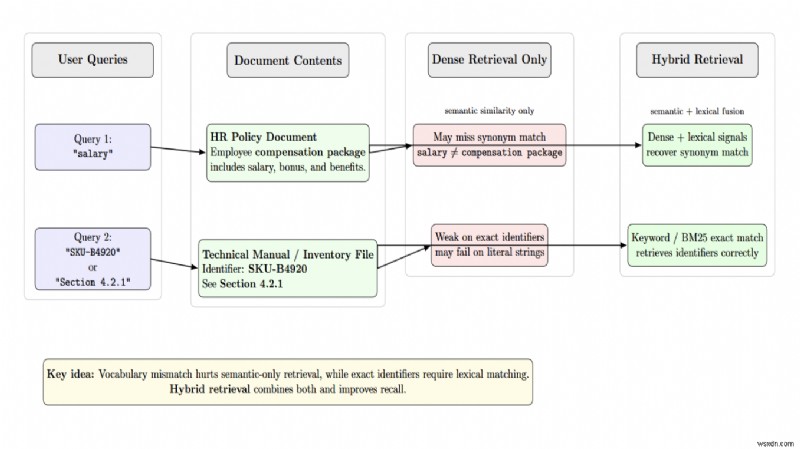
การดึงข้อมูลแบบ dense (vector) ดีที่ความคล้ายคลึงเชิงความหมาย แต่พลาดตัวระบุตัวตนที่แน่นอน การค้นหาคำสำคัญ (keyword search) ไวต่อคำที่แน่นอน แต่ล้มเหลวกับการสำมะโรงความหมาย (semantic paraphrases) ระบบการดึงข้อมูลแบบไฮบริดรัน dense (vector) retrieval และ sparse (BM25/keyword) retrieval พร้อมกัน แล้วรวมผลลัพธ์ด้วย reciprocal rank fusion
ระบบการดึงข้อมูลแบบไฮบริดแก้ปัญหาความไม่ตรงกันของคำศัพท์ (vocabulary mismatch) โดยรวมสัญญาณความคล้ายคลึงเชิงความหมายกับสัญญาณการจับคู่เชิงคำศัพท์ (lexical matching) การให้คะแนนใหม่ (rescoring) คู่ผู้สมัครด้วย re‑ranker (cross‑encoder) หลัง fusion ปรับปรุง recall โดยพื้นฐาน rerankers จัดเรียงเอกสารที่ดึงมาใหม่ เพื่อให้เฉพาะเอกสารที่เกี่ยวข้องที่สุดเข้าสู่บริบทที่ LLM จะตรวจสอบ ทำให้ประหยัด token limit และหลีกเลี่ยงการ塞滿บริบท (context stuffing) พร้อมปรับปรุง recall ของ LLM
เมตริกการดึงข้อมูลต้องได้รับการตรวจสอบแยกต่างหาก
ทีมมักวัดคุณภาพคำตอบแบบ end‑to‑end เท่านั้น การดึงข้อมูลเองมีเมตริกที่ใช้ได้: precision@k (สัดส่วนของชันที่ดึงมาเป็นที่เกี่ยวข้อง?), recall@k (สัดส่วนของชันที่เกี่ยวข้องที่คุณดึงมา?), mean reciprocal rank (ชันที่เกี่ยวข้องแรกอยู่สูงแค่ไหน?), และ normalized discounted cumulative gain (การจัดอันดับโดยรวมดีแค่ไหน?)
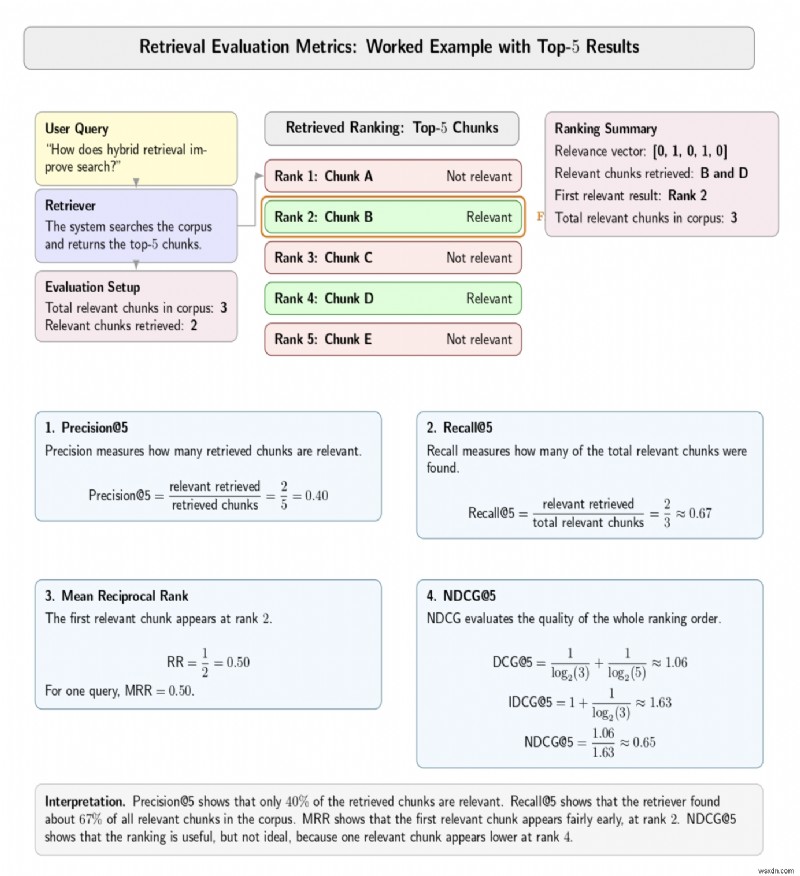
หากคุณไม่วัดเมตริกเหล่านี้ คุณจะไม่รู้ว่าความล้มเหลวมาจากการดึงข้อมูลที่แย่หรือการสร้างที่แย่ คำค้นหาทดสอบและชุดข้อมูลมาตรฐาน (golden datasets) จะให้คุณประเมินแบบออฟไลน์ หากคุณติดตามเมตริกเหล่านี้บนคำค้นหาจริง คุณจะสามารถแสดงการถดถอยในการผลิตได้
การวินิจฉัยความล้มเหลวในการดึงข้อมูลด้วยตัวอย่าง
คำค้นหาที่คลุมเครือและความไม่ตรงกันของคำศัพท์มักทำให้การดึงข้อมูลผิด ผู้ใช้อาจค้นหา "salary" ในขณะที่เอกสารอ้างถึง "compensation package" Dense embeddings อาจไม่รับรู้คำพ้องนัย ในขณะที่ hybrid retrieval แก้ไขได้ กรณีอีกกรณีคือการจับคู่ที่แน่นอน เช่น ตัวระบุ (identifiers) คำค้นหา "SKU‑B4920" หรือ "Section 4.2.1" ต้องการการจับคู่เชิงคำศัพท์ที่แน่นอน
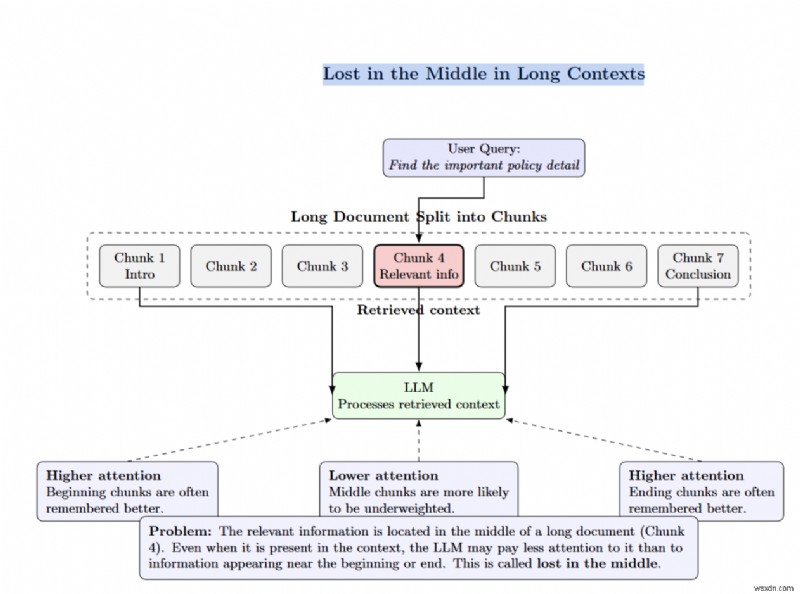
"Lost in the middle" เกิดขึ้นเมื่อข้อมูลที่เกี่ยวข้องถูกฝังลึกในเอกสารยาว LLM จะให้น้ำหนักน้อยกับ token ในชันกลาง
Chunking artefacts (อสิริจากการแบ่งชัน) เกิดขึ้นเมื่อคำตอบถูกแบ่งครึ่งระหว่างสองชัน ทำให้ไม่มีชันไหนมีคำตอบครบถ้วน การแบ่งชันแบบลำดับชั้นช่วยลดปัญหานี้โดยเชื่อมโยงโหนด parent และ child
ความล้มเหลวเนื่องจากเวลาแฝง (Latency) ระเบิดในระบบจริง
เวลาแฝงเป็นหนึ่งในสาเหตุหลักที่ระบบ RAG ที่ทำงานในสาธิต ติดขัดในการผลิต เมื่อไปป์ไลน์การดึงข้อมูลซับซ้อนขึ้น เวลาตอบสนองสามารถเพิ่มขึ้นอย่างรวดเร็วและบังคับทีมให้ต้องแลกเปลี่ยนระหว่างคุณภาพคำตอบกับความสามารถในการใช้งาน
การแลกเปลี่ยนระหว่างการดึงข้อมูลและเวลาแฝง
ทีมการผลิตมักต้องทำสมดุลระหว่างคุณภาพการดึงข้อมูลและงบประมาณเวลาแฝง ทุกอย่างที่เพิ่มเวลาตอบสนอง (การเพิ่ม top_k, การเพิ่ม hybrid retrieval, การ reranking, หรือการรันโมเดลบริบทยาว) ตัดงบประมาณเหล่านั้น trade‑off นี้ยิ่งยากเพราะผู้ใช้คาดหวังคำตอบที่ตอบสนองเร็ว และการรวมระบบองค์กรมาพร้อมกับงบประมาณเวลาแฝงที่แข็งกระด้าง อย่างไรก็ตาม ตามงานวิจัยล่าสุดของ Cornell และ NVIDIA RAG ก่อให้เกิดภาระเวลาแฝงอย่างมีนัยสำคัญ การรันการดึงข้อมูลบ่อยเกินไปอาจเพิ่มความแม่นยำ แต่เพิ่มเวลาแฝง end‑to‑end ใกล้เคียง 30 วินาที — สูงเกินไปสำหรับการใช้งานจริง
การสร้าง (Generation) มักครอบงำ แต่การดึงข้อมูลก็สำคัญ
การ benchmark ด้วย RAGPerf แสดงว่า การสร้างมักเป็นส่วนใหญ่ของไปป์ไลน์ RAG แบบข้อความเท่านั้น การเลือก LLM ขนาดเล็กสามารถลดเวลาแฝงได้มากโดยไม่เสียสละคุณภาพคำตอบ หากคุณภาพการดึงข้อมูลยังคงรักษาไว้ ไปป์ไลน์แบบมัลติโมดัล (PDF และการดึงข้อมูลภาพ) มีความต้องการคำนวณสูงบางส่วนเนื่องจาก reranking และโมเดล cross‑modal ที่เกี่ยวข้อง เวลาแฝงการดึงข้อมูลอาจเพิ่มขึ้นเมื่อ vector databases ช้าหรือไม่รองรับการค้นหาพร้อมกัน อย่างไรก็ตาม แม้กับการค้นหาที่รวดเร็ว reranking ก็สามารถครอบงำเวลาแฝงรวมสำหรับ workloads RAG หลายๆ
เวลาแฝง ต้นทุน และหน้าต่างบริบท (Context Windows)
บางทีมพยายามแก้ recall โดยเพิ่ม top_k หรือ塞เอกสารมากขึ้นเข้าไปในบริบทของ LLM การศึกษาแสดงให้เห็นว่ามีผลลัพธ์ตรงข้าม ยิ่งคุณเพิ่มเอกสารใน prompt มากเท่าไหร่ LLM จะยิ่งทรงจำข้อมูลที่ถูกต้องได้น้อยลง การ reranking การดึงข้อมูลแก้ปัญหานี้โดยดึงเอกสารมาก แล้วเลือกเฉพาะที่ดีที่สุดสำหรับ LLM หน้าต่างบริctxยาวทำให้เกิด "lost in the middle" และต้นทุนคำนวณที่สูงมาก
การเพิ่มประสิทธิภาพเวลาแฝง
การแก้ไขเวลาแฝงในระบบ RAG ต้องการการประสานงานอย่างตั้งใจทั่วไปป์ไลน์ทั้งหมด:
| Focus Area | What to Do | Why It Matters |
|---|---|---|
| Retrieval quality | Use domain-aware chunking instead of default fixed windows. Preserve document structure where it matters. Combine dense and lexical retrieval. Add reranking. Use metadata intelligently. | Improves coverage and relevance, and helps the system retrieve context that is more useful for grounded answers. |
| Latency control | Measure every stage. Remove steps that do not produce meaningful gains. Keep the pipeline as simple as the use case allows. Build for the real interaction pattern. | Reduces unnecessary overhead and keeps the system responsive in real production settings. |
| Drift management | Version embeddings, indexes, chunking strategies, and ingestion policies. Re-evaluate when documents change or models are swapped. Engineer freshness explicitly. | Prevents silent quality decay as content, models, and query patterns evolve over time. |
| Evaluation | Maintain golden datasets based on real queries. Separate retrieval metrics from generation metrics. Measure context precision, recall, groundedness, and faithfulness. | Helps identify the true failure point instead of relying only on final answer quality. |
| Monitoring and tracing | Run evaluations before deployment and monitor after launch. Add tracing across the retrieval and generation layers. | Makes regressions visible and helps teams diagnose failures more precisely in production. |
| Abstention behavior | Let the system say when evidence is missing, stale, or contradictory. | Improves trust by favoring disciplined grounding over confident but weak answers. |
ความล้มเหลวเนื่องจาก Embedding Drift และการเปลี่ยนแปลงของความรู้
Embeddings แสดงข้อความเป็นเวกเตอร์มิติสูงที่ความหมายคล้ายกันอยู่ใกล้กัน ทีมบ่อยครั้งที่ re‑embed เอกสารด้วยโมเดล embedding ที่ต่างกัน หรือเปลี่ยน query encoders โดยไม่ได้กำหนดเวอร์ชัน index อย่างถูกต้อง หรือ benchmark การเปลี่ยนแปลงความเกี่ยวข้อง โมเดลใหม่อาจแข็งแกร่งกว่า objectively แต่อาจเปลี่ยนโครงสร้างชุมชน (neighborhood structure) อย่างไม่คาดคิดที่ส่งผลต่อการจัดอันดับ recall หรือแม้แต่ภาษาเฉพาะโดเมน โมเดลที่เก่งใน benchmark ทั่วไปอาจทำงานแย่มากกับภาษาองค์กรจริงของคุณ
สามสาเหตุของ Drift
- Model drift (การลอยตัวของโมเดล). โมเดล Embedding ถูกอัปเดตอย่างต่อเนื่อง เมื่อคุณ index เอกสารด้วยเวอร์ชันหนึ่งของโมเดล embedding คุณไม่สามารถค้นหาได้ด้วย embeddings จากโมเดลอื่น การเปลี่ยนโมเดล embedding โดยไม่ re‑index corpus จะส่งผลต่อการดึงข้อมูลของคุณ
- Corpus drift (การลอยตัวของคอรัส). เมื่อคุณเพิ่มเอกสารใหม่เข้า index โดยเฉพาะเอกสารประเภทใหม่ ปริภูมิเวกเตอร์จะเปลี่ยนแปลง ชุมชนเวกเตอร์หนาแน่นใหม่ปรากฏขึ้น ชุมชนเหล่านั้นเริ่มดึงคำค้นหาที่ควรจับคู่กับเอกสารอื่น การเพิ่มเนื้อหาที่ผู้ใช้สร้างหรือเนื้อหาที่มี noise จะลดคุณภาพการดึงข้อมูลตามเวลา แม้คุณจะไม่เปลี่ยนโมเดล embedding
- Query drift (การลอยตัวของคำค้นหา). คำศัพท์ของผู้ใช้ขยายและเปลี่ยนแปลงตามเวลา คำใหม่เข้ามาใช้ ("remote work," "stablecoin," "prompt engineering") และ терминология เก่า薄れ去る Pre‑existing embeddings ไม่สามารถจับคู่กับคำที่ไม่มีอยู่ตอนฝึกได้ หากบริษัทเปลี่ยนชื่อผลิตภัณฑ์ การค้นหาชื่อใหม่จะล้มเหลวเพราะ embeddings ยังสะท้อนชื่อเก่า
การตรวจจับ Embedding Drift ด้วย Mean Reciprocal Rank
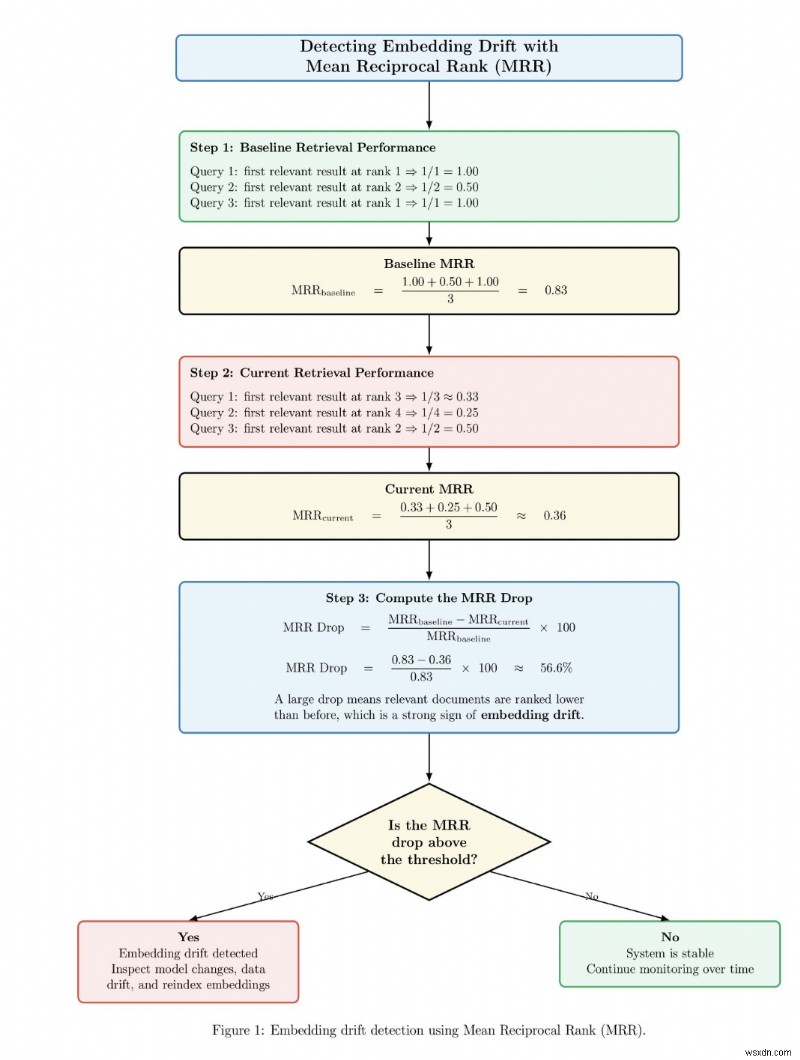
ด้านล่างคือแผนภาพตัวอย่างที่แสดงวิธีการตรวจจับ embedding drift โดยการติดตามการเปลี่ยนแปลงของประสิทธิภาพการดึงข้อมูลก่อนและหลังการเปลี่ยนแปลงระบบ หรือตามเวลา แผนภาพคำนวณ baseline MRR score ก่อน ซึ่งเอกสารที่เกี่ยวข้องปรากฏใกล้ด้านบนของการจัดอันดับ จากนั้นคำนวณ current MRR score ซึ่งเอกสารที่เกี่ยวข้องถูกจัดอันดับต่ำลง ระบบจึงคำนวณเปอร์เซ็นต์การลดลงระหว่าง baseline MRR และ current MRR หากการลดลงของ MRR สูงกว่าเกณฑ์ที่กำหนดไว้ล่วงหน้า ระบบจะแจ้งเตือน embedding drift และแนะนำให้ทบทวนโมเดล embedding การกระจายข้อมูล และ index มิฉะนั้น หากการลดลงต่ำกว่าเกณฑ์ ระบบจะกำหนดว่าระบบการดึงข้อมูลเสถียรและดำเนินการตรวจสอบต่อ
เพื่อเหตุผลนี้ ระบบ RAG การผลิตจำเป็นต้องมีการกำหนดเวอร์ชันและ observability อย่างชัดเจน Embeddings ควรมีเวอร์ชัน Index builds ควรติดตามได้ (traceable) นโยบาย chunking ควรจดบันทึกและ reproducible หากคุณภาพเริ่มลดลง คุณต้องสามารถตอบคำถามได้ว่า: โมเดล embedding ใดผลิต index นี้? กฎ chunking ใดสร้างชันนี้? เอกสารนี้ถูก re‑ingested เข้าระบบเมื่อไหร่? Retriever และ reranker ใดให้บริการคำขอนี้?
หากคุณไม่มี visibility เข้าไปในไปป์ไลน์ drift จะดูสุ่ม แต่ด้วยมัน จะกลายเป็น diagnosable (วินิจฉัยได้)
ความล้มเหลวเนื่องจากช่องว่างการประเมินผล: ซ่อนจุดคอขวดที่แท้จริง
การประเมินผลที่อ่อนแอเป็นสาเหตุอันดับสี่ที่ทีมล้มเหลวในการปรับใช้ระบบ RAG เข้าสู่การผลิต เรามักประเมินเฉพาะคำตอบสุดท้าย นั้นไม่เพียงพอ
RAG ระดับการผลิตคือไปป์ไลน์ ที่หลายชั้น input ที่แย่สามารถทำให้ output สุดท้ายแย่ได้ Retriever อาจล้มเหลวในการดึงเอกสารที่ถูกต้อง Ranker อาจจัดอันดับหลักฐานที่ดีที่สุดต่ำเกินไป Context assembler อาจรวม noise มากเกินไป Generator อาจเลื้อยคลี่ผ่าน passage ที่แข็งแกร่งที่สุด คำตอบอาจถูกต้องในระดับกว้าง แต่ยังคง unfaithful (ไม่ซื่อสัตย์) ต่อหลักฐานที่ดึงมา คุณไม่สามารถระบุช่วงที่อ่อนแอได้หากคุณให้คะแนนเฉพาะข้อความ output สุดท้าย
เมตริกการดึงข้อมูลควรประเมินแยกต่างหาก
เพื่อเหตุผลนี้ การประเมิน RAG ควรรวมเมตริกการดึงข้อมูลแยกจากเมตริกการสร้าง เมตริกการดึงข้อมูลควรรวม context precision และ context recall
- Context Recall: ตรวจสอบว่า passage ที่ดึงมามีข้อมูลที่จำเป็นสำหรับตอบคำถามหรือไม่
- Context Precision: วัดว่าชุดที่ดึงมาส่วนใหญ่เกี่ยวข้องหรือปน noise
- Ranking quality: คุณภาพการจัดอันดับก็สำคัญ เพราะ passage ที่เกี่ยวข้องที่ rank 1 มีประโยชน์กว่า passage เดียวกันที่ rank 10
เมตริกการสร้าง (Generation Metrics) สำคัญไม่แพ้กัน
เมื่อวัดการดึงข้อมูลแล้ว ชั้นการสร้างต้องได้รับการประเมินในตัวของมันเอง สองเมตริกสำคัญคือ groundedness และ faithfulness
- Groundedness: ถามว่าคำตอบสะท้อนข้อมูลที่ให้ในบริบทที่ดึงมาหรือไม่
- Faithfulness: ถามว่าโมเดลแสดงบริบทนั้นอย่างถูกต้องหรือไม่ เมตริกนี้สำคัญเพราะระบบอาจดูน่าเชื่อถือแต่ยังคงสะท้อนวัสดุต้นทางผิด
ข้อมูลทดสอบที่ไม่เป็นจริง ซ่อนความล้มเหลวจริง
ข้อมูลทดสอบที่ไม่เป็นจริงเป็นอีกปัญหาหลัก ทีมหลายทีมประเมินบนคำถามสังเคราะห์ที่สะอาดหรือ prompts ที่ดูแลอย่างระมัดระวังโดยทีมภายใน นั้นปิดบังผิวความล้มเหลวจริงอย่างฟ้อนดamental เงื่อนไขการประเมินในการผลิตควรรวมคำถามที่คลุมเครือ เอกสารที่ขัดแย้งกัน input ของผู้ใช้ที่ไม่ครบ เนื้อหาเก่า และสถานการณ์ที่คำตอบที่ถูกต้องคือ ไม่ตอบเลย หากชุดข้อมูลไม่สะท้อนพฤติกรรมผู้ใช้จริง การประเมินจะกลายเป็นกลไกสบายใจ (comfort mechanism) มากกว่าอุปกรณ์วินิจฉัย
การประเมินต้องดำเนินต่อไปหลังปรับใช้ (Deployment)
การประเมินไม่ควรหยุดหลังจากที่คุณทำ initial run เสร็จ Production RAGs เปลี่ยนแปลง เอกสารเปลี่ยน Embeddings ถูกสลับ Ranking logic พัฒนา Prompt templates เปลี่ยน ถ้าไม่มีการประเมินเป็นส่วนหนึ่งของ CI/CD และ production tracing หลัง deployment คุณจะรู้ regression จากผู้ใช้ที่ไม่พอใจ แทนที่จะเป็นจากการตรวจสอบของตัวเอง
ทำไม Production RAG ถึงล้มเหลวแม้ Benchmarks ดูดี
นี่คือจุดที่ทีมหลายทีมสับสน Benchmarks ดีขึ้น แต่ระบบ live ยังคงผิดหวัง
ความล้มเหลวในการผลิตมักเกิดจาก incentive misalignment (การจูงใจที่ไม่สอดคล้อง) ทีมพยายาม optimize สำหรับ retrieval recall โดยไม่คำนึงถึง latency budgets หรือ optimize สำหรับ LLM scores สูงขึ้นโดยไม่ติดตาม retrieval precision Retrieval อาจ over‑tuned犠牲 generation quality นำเสนอ noise Generation อาจ over‑tuned โดยไม่คำนึงถึงการปรับปรุง retrieval อัตราส่วนที่เหมาะสมระหว่างความแม่นยำของ retrieval และ generation ขึ้นอยู่กับแอปพลิเคชัน กรณีการใช้งานที่มีความเสี่ยงสูง เช่น compliance, legal ต้องการ faithfulness และ context precision มากที่สุด กรณีการใช้งานเชิงสร้างสรรค์อาจอนุญาต noise เพื่อแลกกับความเร็ว
การผลิตไม่ได้ optimize บนเมตริกเดียว มี tradeoffs ระหว่าง retrieval quality, latency, freshness, groundedness และ operational simplicity นั่นคือเหตุผลที่ความสำเร็จในสาธิตสามารถหลอกลวงได้มาก Demos ให้รางวัลระบบที่ "聽起來對" (sound right) การผลิตให้รางวัลความน่าเชื่อถือ (reliability)
วิธีแก้ไขระบบ Production RAG
ทางออกไม่ใช่การทิ้ง RAG แต่เป็นการจัดการมันเป็นระบบการดึงข้อมูลที่มีวินัย
| Focus Area | What to Do | Why It Matters |
|---|---|---|
| Retrieval quality | Use domain-aware chunking instead of default fixed windows. Preserve document structure where it matters. Combine dense and lexical retrieval. Add reranking. Use metadata intelligently. | Improves coverage and relevance, and helps the system retrieve context that is more useful for grounded answers. |
| Latency control | Measure every stage. Remove steps that do not produce meaningful gains. Keep the pipeline as simple as the use case allows. Build for the real interaction pattern. | Reduces unnecessary overhead and keeps the system responsive in real production settings. |
| Drift management | Version embeddings, indexes, chunking strategies, and ingestion policies. Re-evaluate when documents change or models are swapped. Engineer freshness explicitly. | Prevents silent quality decay as content, models, and query patterns evolve over time. |
| Evaluation | Maintain golden datasets based on real queries. Separate retrieval metrics from generation metrics. Measure context precision, recall, groundedness, and faithfulness. | Helps identify the true failure point instead of relying only on final answer quality. |
| Monitoring and tracing | Run evaluations before deployment and monitor after launch. Add tracing across the retrieval and generation layers. | Makes regressions visible and helps teams diagnose failures more precisely in production. |
| Abstention behavior | Let the system say when evidence is missing, stale, or contradictory. | Improves trust by favoring disciplined grounding over confident but weak answers. |
คำถามที่พบบ่อย (FAQ)
วัดคุณภาพการดึงข้อมูลใน RAG ยังไง?
เราใช้เมตริกการดึงข้อมูล เช่น context precision, context recall, และ ranking quality รวมถึงตรวจสอบว่าหลักฐานที่ดึงมารองรับการสร้างคำตอบจริงๆ
อะไรทำให้ระบบ RAG ล้มเหลวในการผลิต?
ความล้มเหลวในการผลิตมักเกิดจากการเสื่อมสภาพของคุณภาพการดึงข้อมูล, latency creep, embedding/corpus drift, และแนวทางปฏิบัติการประเมินที่แย่ซ่อนว่าปัญหาเริ่มที่ไหน
Embedding drift ในไปป์ไลน์ RAG คืออะไร?
Embedding drift เกิดเมื่อการอัปเดตโมเดล embedding, คอรัส, หรือพฤติกรรมคำค้นหาแบบสด เปลี่ยนพฤติกรรมการดึงข้อมูล (ลดความเกี่ยวข้อง) อย่างช้าๆ โดยไม่ทำให้ระบบเสียหายอย่างชัดเจน
ทำไม RAG latency ถึงเพิ่มขึ้นที่ scale?
Latency เพิ่มขึ้นเพราะระบบการผลิตมักเพิ่ม query rewriting, multiple retrieval passes, reranking, extra model calls, และ corpora ใหญ่ขึ้น ทั้งหมดเพิ่มเวลาประมวลผลและความซับซ้อนทางปฏิบัติการ
ประเมิน groundedness และ faithfulness ใน RAG ยังไง?
คุณเปรียบเทียบคำตอบที่สร้างขึ้นกับหลักฐานที่ดึงมา ตรวจสอบว่าข้ออ้างมีหลักฐานจากแหล่งที่มา และคำพูดสะท้อนแหล่งเหล่านั้นอย่างถูกต้องโดยไม่ได้สร้างหรือบิดเบือน
สรุป
ความล้มเหลวในการผลิตของระบบ RAG ส่วนใหญ่ไม่ใช่ผลจากจุดล้มเหลวเดี่ยว แทนที่จะเป็นเช่นนั้น วิศวกรที่รับผิดชอบจะสังเกตว่าการเสียหายส่วนใหญ่เริ่มจากลิงก์อ่อนแอในห่วงโซ่ที่เชื่อมต่อกัน คุณภาพการดึงข้อมูลเกือบจะเป็นตัวล้มเหลวแรกเสมอ วิศวกร "แก้" ปัญหานี้โดยใช้การดึงข้อมูลมากขึ้น บริบทมากขึ้น และชั้น orchestration มากขึ้น การทำเช่นนั้นเพิ่ม latency ขณะที่ embeddings, คอรัส และพฤติกรรมผู้ใช้ลอยตัวไปตามเวลา เมตริกการประเมินที่อ่อนแอซ่อนว่าระบบล้มเหลวที่ไหนจริงๆ ผู้ใช้เริ่มสังเกตและเสียความไว้วिशก่อนผู้จัดการจะรู้ว่ามีปัญหา ณ เวลานั้น การเสียหายของรูปแบบดูน่าปริศนา อย่างไรก็ตาม ปัญหาเหล่านี้ชัดเจนตั้งแต่ต้น
RAG ล้มเหลวที่ scale ไม่ใช่เพราะรูปแบบผิด แต่มาจากการที่การสร้างระบบ RAG การผลิตต้องการ retrieval engineering ที่แข็งแกร่ง, การจัดการ latency, การลด drift, และการประเมินต่อเนื่อง พวกเขาต้องการ ranking ที่ดีขึ้น chunking ที่ดีขึ้น observability ที่ดีขึ้น และการวัด groundedness และ faithfulness สำคัญที่สุด ทีมต้องจัดการ RAG เป็นระบบมีชีวิต (living system) แทนที่จะเป็นสถาปัตยกรรม demo แบบ set‑it‑and‑forget‑it
อ้างอิง
- RAG System in Production: Why It Fails and How to Fix It
- Best Chunking Strategies for RAG (and LLMs) in 2026
- What is RAG evaluation? Measuring retrieval quality and answer groundedness
- Towards Understanding Systems Trade-offs in Retrieval-Augmented Generation Model Inference
- RAGPerf: An End-to-End Benchmarking Framework for Retrieval-Augmented Generation Systems
- Rerankers and Two-Stage Retrieval
- From RAG to Context - A 2025 year-end review of RAG
 ผลงานนี้ได้รับอนุญาตภายใต้ Creative Commons Attribution-NonCommercial-ShareAlike 4.0 International License.
