

ผมเผยแพร่บทความทดสอบเมธอดสตริงของ Ruby กับอักขระ Unicode บางตัว เพื่อดูว่าพฤติกรรมแปลกหรือไม่ หลายเมธอดทำงานผิดปกติ
ข้อติชมบางอย่างว่าผมใช้สตริงที่ยังไม่ normalized ผมเองก็งงเรื่อง Unicode normalization เหมือนกัน สันนิษฐานว่า Rubyists หลายคนก็เช่นกัน
ด้วย normalization สามารถแปลงสตริง Unicode หลายตัวที่พฤติกรรมแปลก ให้ทำงานร่วมกับเมธอดสตริงของ Ruby ได้ดีขึ้น แต่:
- การแปลงไม่สมบูรณ์เสมอไป บางลำดับ Unicode จะทำให้เมธอดสตริงของ Ruby ทำงานผิดตลอด
- ต้องทำเอง ไม่ว่า Ruby, Rails หรือ DB จะ normalize ให้อัตโนมัติโดย default
บทความนี้เป็นบทนำสั้นเกี่ยวกับ Unicode normalization ใน Ruby หวังให้เป็นจุดเริ่มต้นสำหรับการสำรวจต่อ
มาลอง normalize สตริงกัน
เมธอด
String#unicode_normalizeเพิ่มใน Ruby 2.2 เขียนด้วย Ruby เอง จึงไม่เร็วเท่าไลบรารี normalization อย่าง utf8_proc และ unicode gems ที่ใช้ C
เหตุที่ต้อง normalize: ใน Unicode มีหลายวิธีเขียนอักขระเดียวกัน ตัวอักษร "Å" แทนได้ด้วย code point "\u00c5" หรือการรวมตัวอักษร "A" และ accent: "A\u030A"
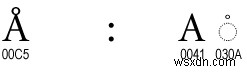
Normalization แปลงรูปแบบหนึ่งเป็นอีกแบบ:
"A\u030A".unicode_normalize #=> 'Å' (เหมือน "\u00C5")
แต่ไม่ได้มีแค่หนึ่งวิธี normalize นั่นจะง่ายเกินไป! มี 4 วิธี เรียกว่า "normalization forms" ย่อหน้าอักษรอาณัติ: NFD, NFC, NFKD, NFKC
String#unicode_normalize ใช้ NFC โดย default แต่ระบุ form อื่นได้:
"a\u0300".unicode_normalize(:nfkc) #=> 'à' (เหมือน "\u00E0")
แต่ความจริง 4 forms ทำอะไร? มาดูกัน
Normalization Forms
มี 2 ประเภทของการ normalize:
- Composition (การรวม): แปลงอักขระหลาย code points เป็น single code point เช่น
"a\u0300"กลายเป็น"\u00E0"ทั้งคู่ encode อักขระà - Decomposition (การแยก): ทำตรงข้าม composition แปลง single-code-point เป็น multiple code points เช่น
"\u00E0"กลายเป็น"a\u0300"
Composition และ decomposition แต่ละอย่างทำได้ 2 แบบ:
- Canonical: รักษา glyphs ตัวอย่าง:
"2⁵"คงเป็น"2⁵"แม้บางระบบไม่รองรับ superscript-five - Compatibility: แทนที่ glyphs ด้วย compatibility characters เช่น
"2⁵"จะกลายเป็น"2 5"
สอง operation และสอง option รวมกันเป็น 4 "normalization forms" ตารางด้านล่างรายการทั้งหมด พร้อมคำอธิบายและตัวอย่าง input/output:
| Name | Description | Input | Output |
|---|---|---|---|
| NFD | Canonical Decomposition | Å "\u00c5" |
Å "A\u030A" |
| NFC | Canonical Decomposition Followed by Canonical Composition | Å "A\u030A" |
Å "\u00c5" |
| NFKD | Compatibility Decomposition | ẛ̣ "\u1e9b\u0323" |
ṩ "\u0073\u0323\u0307" |
| NFKC | Compatibility Decomposition Followed by Canonical Composition | ẛ̣ "\u1e9b\u0323" |
ṩ "\u1e69" |
ดูตารางนานๆ จะเห็น acronyms มีความหมาย:
- "NF" = "normalization form"
- "D" = "decomposition"
- "C" = "composition"
- "K" = "kompatibility" :)
รายละเอียดเพิ่มเติมดูที่ Unicode Standard Annex #15
เลือก normalization form
form ที่ควรใช้ขึ้นกับงาน ผมแนะนำตาม Unicode Normalization FAQ
ใช้ NFC สำหรับความเข้ากันได้ของสตริง
ถ้าต้องการให้เมธอดสตริงของ Ruby ทำงานกับ Unicode ส่วนใหญ่ ส่วนใหญ่ควรใช้ NFC มันเป็น default ของ String#unicode_normalize ไม่ใช่เรื่องบังเอิญ
- รวม multi-code-point characters เป็น single code points ได้เท่าที่ทำได้ Multi-code-point characters เป็นต้นเหตุหลักของปัญหาเมธอดสตริง
- ไม่เปลี่ยน glyphs ผู้ใช้ปลายทางไม่เห็นการเปลี่ยนแปลงข้อความที่พิมพ์
แต่ไม่ใช่ multi-code-point characters ทุกตัวรวมเป็น single code point ได้ ในกรณีเหล่านั้น เมธอดสตริงของ Ruby จะทำงานแย่:
s = "\u01B5\u0327\u0308" # => "Ƶ̧̈", อักขระที่รวมไม่ได้
s.unicode_normalize(:nfc).size # => 3, แม้มีแค่อักขระเดียว
ใช้ NFKC สำหรับความปลอดภัยและความเข้ากันได้กับ DB
หากทำงานกับข้อความด้านความปลอดภัย เช่น usernames หรือสนใจให้ข้อความเข้ากันได้กับ database NFKC น่าจะดี
- แปลงอักขระที่อาจก่อปัญหาเป็น compatibility characters
- จากนั้นรวมอักขระทั้งหมดเป็น single code points
ทำไมดีต่อความปลอดภัย: ทưởng像 user ชื่อ "HenryIV" ผู้บุกรุกอาจสมัคร username "HenryⅣ" ดูเหมือนกันแตกต่างจริง ตัวแรกใช้ ASCII "IV" ตัวหลังใช้ Unicode Roman numeral 4: "Ⅳ"
ป้องกันได้โดย normalize ด้วย NFKC ก่อนตรวจสอบ uniqueness NFKC แปลง "\u2163" เป็น ASCII "IV"
a = "Henry\u2163"
b = "HenryIV"
a.unicode_normalize(:nfc) == b.unicode_normalize(:nfc) # => false เพราะ NFC รักษา glyphs
a.unicode_normalize(:nfkc) == b.unicode_normalize(:nfkc) # => true เพราะ NFKC แปลงทั้งคู่เป็น ASCII "IV"
คำส่งท้าย
หลังศึกษา ผมน่าประหลาดใจว่า Unicode normalization ไม่ใช่หัวข้อบูรณะในชุมชน Ruby/Rails คาดว่า Rails ทำให้ แต่ดูเหมือนไม่ได้ และไม่ normalize ข้อมูลจากผู้ใช้ ทำให้เมธอดสตริงของ Ruby ไม่เชื่อถือได้
หากอ่านคิดว่ามีข้อมูลผมไม่รู้ ติดต่อได้ที่ twitter @StarrHorne หรือ email starr@honeybadger.io Unicode กว้างมาก ผมพิสูจน์แล้วว่าไม่รู้หมด :)
