

Parsing คือศิลป์การทำความเข้าใจชุดของสตริง และแปลงเป็นรูปแบบที่เราเข้าใจได้ คุณอาจใช้ regular expressions แต่ไม่เหมาะสมเสมอไป
เช่น การ parse HTML ด้วย regex มักไม่ใช่ความคิดที่ดี
ใน Ruby มี Nokogiri ทำงานนี้ให้ แต่การสร้าง parser เองจะทำให้คุณเรียนรู้มากมาย เริ่มกันเลย!
การ Parse ด้วย Ruby
หัวใจของ parser คือ class StringScanner
Class นี้เก็บสำเนาของสตริงและตัวชี้ตำแหน่ง (position pointer) ตัวชี้ช่วยให้เราเดินผ่านสตริงค้นหา tokens ต่างๆ
เมธอดที่จะใช้:
.peek.scan_until.getch
อีกเมธอดมีประโยชน์คือ .scan (โดยไม่มี until)
หมายเหตุ:
ถ้า StringScanner ไม่พร้อมใช้งาน ให้ลองเพิ่ม require 'strscan'
ผมเขียนทดสอบ 2 กรณีเป็นเอกสาร เพื่อเข้าใจการทำงานของ class นี้:
describe StringScanner do let (:buff) { StringScanner.new "testing" } it "can peek one step ahead" do expect(buff.peek 1).to eq "t" end it "can read one char and return it" do expect(buff.getch).to eq "t" expect(buff.getch).to eq "e" end end สำคัญ: บางเมธอดเลื่อนตัวชี้ตำแหน่ง (getch, scan) ส่วนบางตัวไม่ (peek) ตรวจสอบตำแหน่งได้ตลอดด้วย .inspect หรือ p
Parser Class
Parser class เป็นที่ที่ทำงานหลัก เรา initialize ด้วยข้อความที่ต้องการ parse แล้วสร้าง StringScanner เรียก parse method:
def initialize(str) @buffer = StringScanner.new(str) @tags = [] parse end
ใน test กำหนดแบบนี้:
let(:parser) { Parser.new "<body>testing</body> <title>parsing with ruby</title>" } จะลุยรายละเอียด class นี้ในที หลังมาดูชิ้นสุดท้ายของโปรแกรมก่อน
Tag Class
Class นี้เรียบง่าย ทำหน้าที่เป็น container และ data class สำหรับผลลัพธ์การ parse
class Tag attr_reader :name attr_accessor :content def initialize(name) @name = name end end
เริ่ม Parse กันเถอะ!
เพื่อ parse เราต้องดู input text หา patterns เช่น รู้ว่า HTML มีรูปแบบ:
<tag>contents</tag>
มี 2 องค์ประกอบชัดเจน: tag names และข้อความภายใน tags ถ้าเขียน formal grammar ด้วย BNF จะประมาณนี้:
tag = <opening_tag> <contents> <closing_tag> opening_tag = "<" <tag_name> ">" closing_tag = "</" <tag_name> ">"
เราจะใช้ peek ของ StringScanner ดูว่าสัญลักษณ์ถัดไปเป็น opening tag ไหม ถ้าใช่ เรียก find_tag และ find_content:
def parse_element if @buffer.peek(1) == '<' @tags << find_tag last_tag.content = find_content end end
เมธอด find_tag จะ:
- 'Consume' ตัวอักษร opening tag
- Scan จนกว่าจะเจอสัญลักษณ์ปิด (">")
- สร้างและคืน Tag object ใหม่พร้อม tag name
โค้ดดังนี้ สังเกต chop ตัวอักษรสุดท้าย เพราะ scan_until รวม '>' ในผลลัพธ์ ซึ่งเราไม่ต้องการ
def find_tag @buffer.getch tag = @buffer.scan_until />/ Tag.new(tag.chop) end
ขั้นตอนต่อไป หา content ภายใน tag scan_until เลื่อน pointer ไปที่ถูกต้องแล้ว ใช้ scan_until อีกครั้งหา closing tag คืนค่า content
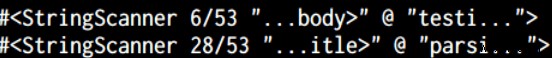
def find_content tag = last_tag.name content = @buffer.scan_until /<\/#{tag}>/ content.sub("</#{tag}>", "") end ตอนนี้:
เพียงแค่เรียก parse_element ใน loop จนกว่าจะไม่เจอ tags อีก
def parse until @buffer.eos? skip_spaces parse_element end end
โค้ดเต็มได้ที่: https://github.com/matugm/simple-parser ดู branch 'nested_tags' สำหรับรุ่นขยายที่รองรับ nested tags
สรุป
การเขียน parser เป็นหัวข้อน่าสนใจ และอาจซับซ้อนได้
ถ้าไม่อยากสร้าง parser เอง ใช้ parser generators เช่น treetop และ parslet ใน Ruby
