

บทความก่อนหน้าในชุดนี้ได้ระบุว่า Solid Queue เป็นตัวเลือกที่ยอดเยี่ยมหากคุณต้องการระบบสำหรับประมวลผล background jobs มันลดการพึ่งพาภายนอก — ไม่ต้องใช้ Redis! — โดยจัดเก็บงานทั้งหมดในฐานข้อมูลของคุณ แม้จะเช่นนั้น มันก็มีประสิทธิภาพสูงมาก
แต่เพียงมีประสิทธิภาพเพียงอย่างเดียวไม่เพียงพอสำหรับระบบ background job ที่พร้อมสำหรับ production นักพัฒนา Rails คาดหวังมากมายตลอดหลายปี เราไม่ได้แค่อยาก enqueue jobs ให้รันในพื้นหลัง เราอยากจัดตารางงาน รันงานตามตารางเวลาที่ซ้ำกัน และอาจอยากจำกัดจำนวนงานที่รันพร้อมกันได้ เราอยากได้คุณสมบัติมากขึ้น!
สิ่งที่น่าทึ่งคือ Solid Queue ให้คุณสมบัติทั้งหมดเหล่านี้มาพร้อมกัน out of the box มาสำรวจ Solid Queue ลึกลงไปและเรียนรู้ว่ามันทำได้อย่างไร!
การจัดตารางงานด้วย Solid Queue สำหรับ Ruby on Rails
ก่อนอื่น ถึงเวลาสรุปย้อนกลับเล็กน้อย Solid Queue ใช้ฐานข้อมูลของคุณ — และแค่ฐานข้อมูลของคุณ — เพื่อจัดเก็บข้อมูลงาน ทุกอย่างที่มันทำได้รับการสนับสนุนโดยตารางฐานข้อมูลหนึ่งหรือหลายตาราง การจัดตารางงาน — กล่าวคือ การกำหนดงานให้รันที่เวลาจุดหนึ่งในอนาคต — ไม่แตกต่างออกไป งานที่จัดตารางใดๆ จะถูกจัดเก็บใน solid_queue_scheduled_executions
ตารางนี้เกือบเหมือนตาราง solid_queue_ready_executions ความต่างเดียวคือการเพิ่มคอลัมน์ scheduled_at ซึ่งบอกว่างานที่จัดตารางควรถูกดำเนินการเมื่อไหร่ มายืนยันดูโดยดูสิ่งที่เกิดขึ้นเมื่อเราจัดตารางงาน
ไม่มีสิ่งที่น่าประหลาด Solid Queue เพิ่มแถวใหม่ในตาราง solid_queue_scheduled_executions ซึ่งมีข้อมูลที่เราคาดหวัง แต่เราจะไปจากระเบียนที่มีอยู่นี้สู่การรันงานจริงในเวลาที่ถูกต้องอย่างไร?
เราต้องการกระบวนการที่สำรวจ (poll) ตาราง solid_queue_scheduled_executions อย่างต่อเนื่อง กระบวนการนั้นเรียกว่า Dispatcher และมีหน้าที่รับผิดชอบในการดำเนินการงานที่จัดตารางให้ตรงเวลา มันเริ่มทำงานเมื่อ Solid Queue เริ่มต้น — ไม่ต้องการการกำหนดค่าเพิ่มเติม อย่างไรก็ตาม หากต้องการ คุณสามารถเริ่มกระบวนการ dispatcher เพียงอย่างเดียวได้โดยการรัน Solid Queue ด้วยการกำหนดค่าเฉพาะ
ในกรณีที่คุณสงสัยว่า กระบวนการ Dispatcher ถูกกำกับดูแลอย่างไร นั่นเป็นหน้าที่ของ Supervisor ที่มีชื่ออย่างเหมาะสม มันติดตามกระบวนการที่ทำงานอยู่ภายใน Solid Queue รวมถึงกระบวนการ worker และ Dispatchers
Dispatcher ทำงานจริงอย่างไร มันกำหนดเมธอด poll ที่ถูกเรียกภายในลูปเพื่อตรวจสอบงานที่จัดตารางอย่างต่อเนื่อง โค้ดการ polling กระจายอยู่ในหลายคลาสและโมดูล แต่ในรูปแบบที่ลดทอนมาก จะมีลักษณะประมาณนี้:
คำสำรวจ (query) เพื่อดึง 'ready' scheduled executions เป็นเรื่องตรงไปตรงมา
ดังนั้น งานที่จัดตารางใดๆ ที่มี scheduled_at ในอดีตก็พร้อมที่จะถูก dispatch ตามที่เราครอบคลุมในส่วนหนึ่งของชุดนี้ เมื่อ Solid Queue dispatch งาน มันจะสร้างระเบียน ReadyExecution และทำลายระเบียน ScheduledExecution ที่สอดคล้องกัน ระเบียน ReadyExecution จะถูก worker processes ทั่วไปนำไป และงานที่สอดคล้องจะถูกรัน
จนถึงตอนนี้ดีแล้ว งานที่จัดตารางไม่ได้ซับซ้อนนัก! มาดูสิ่งที่ซับซ้อนกว่า: recurring tasks
Recurring Tasks (งานที่เกิดซ้ำ)
Recurring tasks เป็นคุณสมบัติที่ขอบ่อยสำหรับ background job processors กล่าวง่ายๆ คือ background jobs ที่ควรรันตามตารางเวลาที่ซ้ำกัน คล้ายกับ Cron jobs ที่คุณกำหนดตารางเวลา (เช่น ทุก 5 นาที ทุกวันเที่ยงวัน ฯลฯ) สำหรับเวลาที่งานควรเกิดขึ้น
ใน Solid Queue คุณกำหนด recurring jobs โดยใช้ไฟล์ config/recurring.yml ตัวอย่างเช่น หากเราอยากรัน job CleanupData ทุกวันเที่ยงวัน เราจะทำได้ดังนี้:
Solid Queue ใช้ Fugit เพื่อแยกวิเคราะห์นิพจน์ตารางเวลา ซึ่งเป็นเหตุผลที่ตารางเวลาที่อ่านเข้าใจได้แบบมนุษย์ เช่น 'every day at noon' จึงได้รับอนุญาต เมื่อใช้ scheduled tasks คุณกำหนดคลาสของ job ที่จะรันและอาร์กิวเมนต์ job ใดๆ ReadMe ของ SolidQueue recurring tasks ที่ยอดเยี่ยมให้รายละเอียดมากขึ้น เราอยู่ที่นี่เพื่อเรียนรู้ว่ามันทำงานอย่างไร จึงมาดูใต้ฝาครอบกัน
Recurring tasks ถูกแทนด้วยโมเดล RecurringTask ซึ่งได้รับการสนับสนุนโดยตาราง solid_queue_recurring_tasks ที่สอดคล้องกัน คอลัมน์ในนั้นสอดคล้องกับฟิลด์ที่มีในไฟล์การกำหนดค่า
เมื่อคุณเริ่ม SolidQueue ระเบียน recurring task จะถูกสร้างขึ้นตามไฟล์การกำหนดค่า recurring tasks ของคุณ เพื่อสร้าง jobs ในเวลาที่ถูกต้อง เราต้องการกระบวนการใหม่อีกครั้ง — คราวนี้เรียกว่า Scheduler Scheduler เป็นพี่น้องของ Dispatcher ที่เรารู้จักแล้ว มันทำงาน почтиเหมือนกัน: กระบวนการใหม่ถูกสร้างเมื่อ Solid Queue เริ่มต้น และกระบวนการนี้รันลูปไม่มีที่สิ้นสุด ความต่างระหว่าง Scheduler และ Dispatcher คือสิ่งที่เกิดขึ้นภายในลูปนั้น Dispatcher สำรวจตาราง solid_queue_scheduled_executions ส่วน Scheduler สำรวจ solid_queue_recurring_tasks — และจัดตารางงานในเวลาที่ถูกต้อง ดังนั้น Scheduler รู้ได้อย่างไรว่าเวลาที่ถูกต้องคือเมื่อไหร่ และเมื่อไหร่ควรจัดตารางงานที่ถูกต้อง?
เพื่อตอบคำถามนั้น เราต้องตรวจสอบการนำไปใช้อย่างใกล้ชิด คลาส Scheduler สร้างออบเจ็กต์ RecurringSchedule ใหม่ที่กำหนดเมธอด schedule เมธอดนั้นถูกเรียกซ้ำๆ สำหรับแต่ละ scheduled task นี่คือเวอร์ชันที่ลดทอน:
มาถอดรหัสโค้ดนี้ Solid Queue ใช้ Concurrent::ScheduledTask (จากไลบรารี concurrent-ruby) เพื่อสร้าง thread ใหม่ Thread นั้นถูกจัดตารางให้รันในเวลาที่ระบุโดยตารางเวลาของ recurring task เมื่อ thread นั้นรัน มันจะสร้าง thread อีกตัวหนึ่งแบบ recursive เพื่อจัดตาราง recurring task ถัดไป แล้วมัน enqueue 'current' scheduled job
มาดูตัวอย่าง recurring task เรียบง่ายเพื่อเข้าใจภาพรวม
หากเราเริ่ม Solid Queue เวลา 8:30 ตัวแปรภายในเมธอด schedule จะถูกกำหนดค่าดังนี้ ไม่ได้เป็นตัวต่อตัวนะ เราลดทอนมากที่นี่
ดังนั้น background thread ของเราถูกจัดตารางให้รันอีก 30 นาที คือเวลา 9:00 เมื่อเวลานั้นมาถึง background thread จะถูกดำเนินการ มันรัน thread_task.enqueue(at: 9:00) — ดังนั้น instance ของ CleanupData จะถูกวางคิวเพื่อดำเนินการ มันยังเรียกตัวเองแบบ recursive ผ่าน thread_schedule.schedule เนื่องจากตอนนี้เป็นเวลา 9:00 ตัวแปรสำหรับการเรียกครั้งนี้จึงเปลี่ยนไป
ดังนั้น background thread ถูกจัดตารางให้รันอีกครั้งที่ 10:00 และวัฏจักรดำเนินต่อไป คุณอาจสงสัยว่าจะเกิดอะไรขึ้นหาก scheduling thread ถูกฆ่า ตัวอย่างเช่น ระหว่าง re-deploy หรือ system crash จะทำให้ตารางเวลาของคุณล้มเหลวไหม? โชคดีที่คำตอบคือไม่ Cron schedules เป็น static นิพจน์อย่าง 'Every Hour' จะ resolve เป็น 10:00, 11:00, 12:00 และไปเรื่อยๆ ไม่ว่าจะเริ่ม Solid Queue เมื่อไหร่ การหยุดชะงักของ scheduling thread ไม่เปลี่ยนแปลงสิ่งนั้น
นี่คือรายละเอียดการนำไปใช้อื่นๆ ที่ควรทราบ ก่อนอื่น รูปแบบการจัดตารางการเกิดซ้ำของ recurring task ก่อนดำเนินการนั้นได้รับแรงบันดาลใจจาก GoodJob ที่สอง RecurringTask.enqueue ไม่สร้างระเบียน Job และ ReadyExecution ใหม่ตามที่คุณคาดหวัง แทนที่จะสร้างระเบียนอีกตัวหนึ่งคือ RecurringExecution
ระเบียนนี้มีไว้เพื่อป้องกันการดำเนินการ recurring jobs ซ้ำๆ มี index บน task_key และ run_at พร้อม unique constraints เพื่อวัตถุประสงค์นั้น RecurringTask จะถูก enqueue ก็ต่อเมื่อไม่มี RecurringExecution ก่อนหน้าสำหรับเวลาเดียวกันและ job เดียวกัน
ผู้อ่านที่รอบคอบจะสังเกตว่าโค้ดสนิทนี้ชี้ให้เห็นข้อจำกัดใน Solid Queue นั่นคือ หากคุณไม่ได้ใช้ Solid Queue เป็น backend เพื่อรัน cron-style tasks ของคุณ — ใช่ คุณทำได้ — Solid Queue ไม่สามารถรับประกันได้ว่า recurring jobs จะถูก enqueue เพียงครั้งเดียว หากคุณอยู่ในสถานการณ์เช่นนั้น คุณควรทราบเรื่องนี้
คุณอาจสงสัยอีกว่าจะเกิดอะไรขึ้นหาก Scheduler process ตายหรือถูกฆ่า — ตัวอย่างเช่น ระหว่างการ deploy เนื่องจาก recurrences ถูกจัดการโดย thread การฆ่า thread จะทำลายตารางเวลาไหม? โชคดีที่คำตอบคือไม่
Concurrency Controls (การควบคุมการทำงานพร้อมกัน)
มาดูคุณสมบัติสุดท้ายของ Solid Queue คือ concurrency controls บางครั้งคุณอยากจำกัดว่าจะมี jobs ประเภทใดประเภทหนึ่งรันพร้อมกันได้กี่ตัว คุณสามารถทำได้ด้วย Solid Queue โดยใช้ limits_concurrency
ที่นี่เรากำลังบอก SolidQueue ให้รัน instance สูงสุดหนึ่งตัวของ MyJob สำหรับแต่ละ user มาตรวจสอบการกำหนดค่าอย่างละเอียด
to: จำนวนงานสูงสุดที่คุณต้องการให้รันพร้อมกันkey: อาร์กิวเมนต์ที่จำเป็นเพื่อระบุว่างานใดควรถูกจำกัดร่วมกัน ในตัวอย่างของเรา jobs ที่มี User ID เดียวกันจะถูกจำกัดให้รันพร้อมกันได้เพียงครั้งเดียว คุณอาจใช้ job arguments ใดๆ เป็นkeyแต่ค่าคงที่อย่างสตริงหรือสัญลักษณ์ก็ได้duration: เวลาสูงสุดที่ Solid Queue สามารถรับประกัน concurrency ได้หลังจาก job ถูก enqueue หากงานของคุณรันนานกว่านั้น concurrency controls จะไม่มีผลและงานอาจทับซ้อนกัน เราจะเรียนรู้ว่าทำไมภายหลัง!group: คุณสามารถใช้ตัวเลือกนี้เพื่อจำกัด concurrency ข้ามคลาส job ต่างๆ
หากต้องการเรียนรู้เพิ่มเติม ขออ้างอิงเอกสาร concurrency control Concurrency controls เป็นคุณสมบัติที่ซับซ้อนที่สุดของ Solid Queue หาก scheduled tasks ยังไม่ทำให้หัวคุณหมุน การเรียนรู้ว่าคุณสมบัตินี้ทำงานอย่างไรแน่นอนจะทำให้มันหมุน
มาเริ่มจากพื้นฐาน เช่นคุณสมบัติ Solid Queue อื่นๆ concurrency controls ได้รับการสนับสนุนโดยโมเดลต่างๆ และตารางฐานข้อมูลที่สอดคล้องกัน สองตัวที่คุณต้องระวังเป็นพิเศษคือ Semaphore และ BlockedExecution
มาดู Semaphore ก่อน ตามที่ชื่อบ่งชี้ นี่คือการนำรูปแบบ counting semaphore ไปใช้ เมื่อ Solid Queue enqueue job ที่มี limits_concurrency มันจะพยายาม acquire semaphore lock ตาม concurrency key ก่อน Concurrency key นี้ขึ้นอยู่กับอาร์กิวเมนต์ที่ส่งให้ limits_concurrency นั่นคือ job class, key, และ group name — หากมีการให้มา หาก semaphore พร้อมใช้งาน job จะถูก enqueue หากไม่ได้ จะสร้างระเบียน BlockedExecution แทน
Semaphores มี value เพื่อรองรับหลาย concurrent jobs คุณสามารถคิดว่านี่คือ remaining capacity ของ semaphore การ acquire semaphore หมายถึงการลดค่าลง และการ release หมายถึงการเพิ่มค่าขึ้น Semaphore ถือว่าไม่พร้อมใช้งานเมื่อค่าของมันเป็นศูนย์ มาดูตัวอย่างว่ากลไกล็อกทำงานอย่างไรสำหรับ job เรียบง่าย
มาดูสิ่งที่เกิดขึ้นหากเราพยายาม enqueue job นี้หลายครั้งติดกัน
- Instance แรกของ
MyJobถูก enqueue ไม่มี semaphore อยู่แล้ว จึงสร้างขึ้นใหม่ ค่าเริ่มต้นคือlimit - 1เนื่องจาก limit ของคุณคือ 3 ค่าเริ่มต้นของ semaphore จึงเป็น 2 - Instance ที่สองของ
MyJobถูก enqueue Solid Queue พยายาม acquire lock สำหรับ job นั้น Job สามารถ enqueue ได้เพราะค่าเป็น 2 ซึ่งมากกว่าศูนย์ ค่า semaphore ลดลงเหลือ 1 - Instance ที่สามของ job ของเราถูก enqueue เราทำขั้นตอนเดียวกันอีกครั้ง ค่า semaphore ตอนนี้เป็นศูนย์
- Instance ที่สี่ของ
MyJobถูก enqueue การ acquire semaphore ล้มเหลวเพราะค่าตอนนี้เป็นศูนย์ ระเบียนBlockedExecutionถูกสร้างสำหรับ job นั้น - Instance แรกของ job ของเราเสร็จสิ้น เมื่อเสร็จ มัน release semaphore ดังนั้นค่า semaphore กลายเป็น 1 อีกครั้ง
- เมื่อเสร็จ Instance แรกยังเรียกเมธอดเพื่อ release jobs ที่ถูกบล็อก
- Instance ที่สี่ของ
MyJobถูก release และพยายาม acquire lock อีกครั้ง ค่า semaphore เป็น 1 ดังนั้น lock สามารถ acquire ได้ และ blocked job ถูก enqueue ค่า semaphore ตอนนี้เป็นศูนย์
โค้ดสำหรับการ release semaphore เมื่อ job เสร็จเป็นเรื่องตรงไปตรงมา
ยังมีรายละเอียดอีกอย่างที่เรายังไม่ได้กล่าวถึง ทำไม semaphores จึงมีวันหมดอายุ และทำไมเราต้องตั้งค่า duration เมื่อใช้ limits_concurrency?
มาพิจารณาสิ่งที่เกิดขึ้นเมื่อ job crash โดยไม่ release semaphore ของมัน — ตัวอย่างเช่น เมื่อ worker ที่ประมวลผล job นั้นตาย หากเราไม่เพิ่มกลไกบางอย่างเพื่อทำความสะอาด semaphores ล็อกที่ถูกครองโดย job นั้นจะถูกเก็บไว้ตลอดไป ในกรณีแย่ที่สุด นี่จะบล็อกงานอื่นๆ ไม่ให้ถูกประมวลผลตลอดกาล
Semaphores มี expiry ที่สอดคล้องกับ duration ที่ให้ในนิยาม job เพื่อหลีกเลี่ยงสถานการณ์นั้น หาก semaphore หมดอายุ — ซึ่งเกิดขึ้นหากไม่มี jobs ถูก enqueue — semaphore จะถูกทำลาย เรารู้จักกระบวนการที่รับผิดชอบแล้ว — คือเพื่อนของเรา Dispatcher มันสร้างอินสแตนซ์ของคลาส ConcurrencyMaintenance ซึ่งทำสองอย่าง:
- แรก ลบ semaphores ที่หมดอายุใดๆ
- สอง ตรวจสอบว่ามี blocked jobs ไหม และ release พวกมัน
Jobs ถูก release ทีละตัว ดังนั้น concurrency limits จะยังคงมีผล แต่พิจารณาสิ่งที่เกิดขึ้นหาก job ของคุณรันนานกว่า duration ที่กำหนด ในกรณีนั้น semaphore จะถูกทำความสะอาด แม้ job จะยังคงรันอยู่ หาก job อีกตัวถูก enqueue ต่อมา jobs นั้นจะทับซ้อนกัน
การติดตาม Solid Queue สำหรับ Rails ด้วย AppSignal
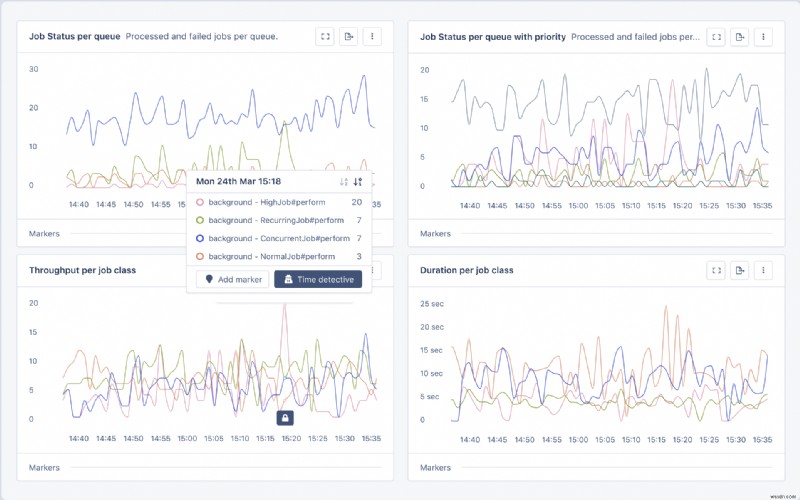
เช่นที่เราได้ระบุ Solid Queue ทำได้มากมาย อย่างไรก็ตาม ด้วยส่วนที่เคลื่อนไหวทั้งหมดนี้ การติดตามจึงเป็นสิ่งสำคัญ โชคดีที่ AppSignal ให้การสนับสนุน built-in สำหรับ Solid Queue พร้อมแดชบอร์ดสำเร็จรูปสำหรับเวลาดำเนินการงาน throughput และอัตราความล้มเหลว เพียงติดตั้ง AppSignal ในแอปพลิเคชัน Rails ของคุณ และคุณก็พร้อมแล้ว
AppSignal จะตรวจจับการใช้งาน Solid Queue ของคุณโดยอัตโนมัติและสร้าง active job dashboard ที่มีกราฟสำหรับเมตริกสำคัญ เช่น อัตราข้อผิดพลาดและ throughput
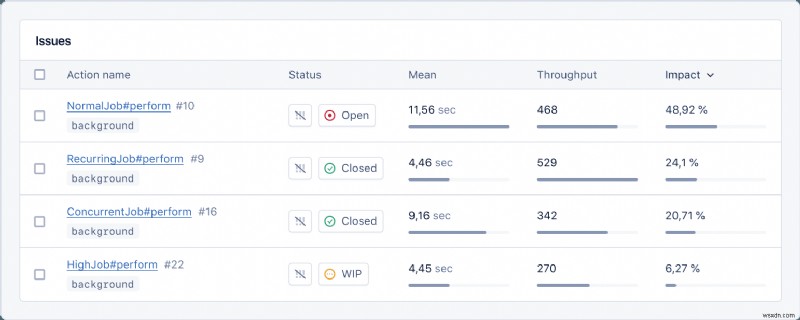
หากคุณเห็น jobs ที่ทำงานผิดปกติ — ไม่ว่าจะเป็นเพราะรันช้า หรือมีข้อผิดพลาดมากเกินไป — ให้กำหนดสถานะและผู้รับผิดชอบเพื่อแก้ไขปัญหาได้อย่างมีประสิทธิภาพ
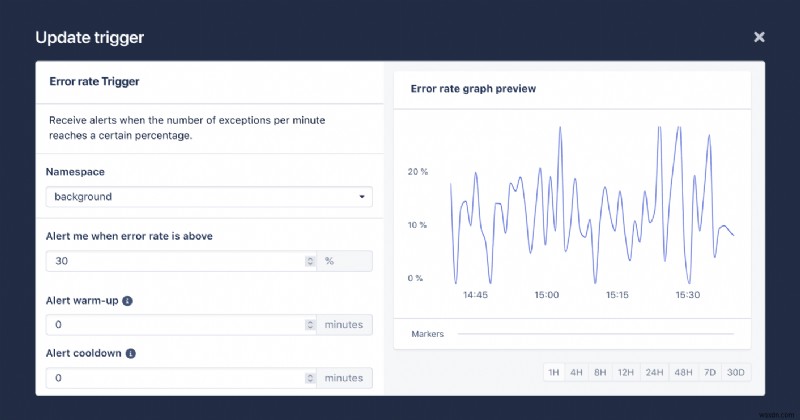
แน่นอนว่าคุณไม่ควรต้องมองแดชบอร์ดตลอดวันเพื่อ 알아ว่าเป็นปัญหา AppSignal Alerts ดูแลคุณอยู่ เพียงสร้าง alert ใหม่สำหรับ job metrics เช่น อัตราความล้มเหลวและระยะเวลาของ job และคุณก็พร้อมแล้ว
Solid Queue מדהים สำหรับเพิ่มการประมวลผลงานทรงพลังให้แอปพลิเคชันของคุณโดยไม่ต้องยุ่งยาก AppSignal ทำอย่างเดียวกันเมื่อพูดถึงการติดตาม!
สรุป
เราได้ครอบคลุมพื้นที่มากมายในการสำรวจคุณสมบัติขั้นสูงของ Solid Queue ตั้งแต่ scheduled jobs ไปจนถึง dependency chains ที่ซับซ้อน แต่ละคุณสมบัติสร้างบนพื้นฐานที่มั่นคงที่เราอภิปรายในส่วนหนึ่ง ตามที่เราเห็น การสร้าง job processing backend ไม่ใช่งานง่าย แต่โดยการดำดิ่งลึกลงไปใน source code ของ Solid Queue และการทำงานของมัน เราได้รับความเข้าใจและความชมชอบในความท้าทายที่เกี่ยวข้อง
ในทุกกรณี Solid Queue เป็นการเพิ่มที่ยอดเยี่ยมสู่ระบบนิเวศของ Rails เนื่องจากการออกแบบฐานข้อมูลที่ยอดเยี่ยมและการประสานงานกระบวนการ มันให้เครื่องมือที่คุณต้องการ ในขณะที่รักษาสัญญาหลักไว้: ความเรียบง่ายและความน่าเชื่อถือ โดยไม่พึ่งพาการพึ่งพาภายนอก
Happy coding!
