

การทำความเข้าใจประสิทธิภาพของ NGINX อาจทำให้รู้สึกท่วมท้น มีจุดข้อมูลมากมายที่ต้องติดตาม และอาจจะยากที่จะรู้ว่าจุดไหนเกี่ยวข้องกับคุณและจุดไหนที่คุณสามารถละเลยได้
ในบทความนี้ เราจะอธิบายว่าคุณสามารถใช้ AppSignal เพื่อตรวจสอบ NGINX ได้อย่างไร โดยขยายการมองเห็นประสิทธิภาพของแอปพลิเคชันของคุณ
ทำให้เมตริกทั้งหมดของคุณกลายเป็นเรื่องง่าย
AppSignal ช่วยให้คุณสร้างแดชบอร์ดที่กำหนดเองด้วยเมตริกประสิทธิภาพตั้งแต่ throughput ไปจนถึงเวลาตอบสนอง การสร้างแดชบอร์ดด้วยตนเองใช้เวลา และอาจจะยากที่จะรู้ว่าเมตริกไหนสำคัญจริงๆ ด้วยเหตุนี้ AppSignal จึงทำให้กระบวนการนี้เป็นอัตโนมัติผ่าน Magic Dashboards เมื่อคุณติดตั้ง AppSignal เอเจนต์ของเราจะสแกนโครงสร้างพื้นฐานของคุณ และเราจะสร้างแดชบอร์ดที่สำคัญที่สุดให้โดยอัตโนมัติ รวมถึงแดชบอร์ด NGINX
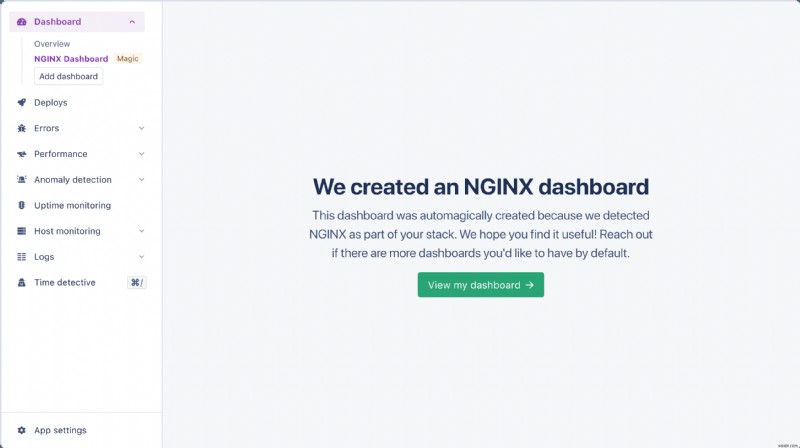
Magic Dashboards ของคุณจะปรากฏขึ้นโดยอัตโนมัติภายใต้รายการแดชบอร์ดของแอปพลิเคชัน เมื่อตั้งค่าแดชบอร์ดแล้ว คุณสามารถปรับแต่งเพื่อแสดงเมตริกที่เหมาะกับบริบทเฉพาะของแอปพลิเคชันของคุณได้
แสดงเมตริก NGINX ด้วย Magic Dashboards
มาดูว่า Magic Dashboards ช่วยให้คุณใช้งานการดำเนินการของ NGINX ได้อย่างไรเมื่อความพร้อมใช้งานของแอปพลิเคชันถูกคุกคาม โดยการจราจรสูงทำให้เกิดการล่ม
ลองจินตนาการว่าคุณมีแอปพลิเคชันชื่อ SnapGram ที่ช่วยให้ผู้ใช้อัปโหลดรูปภาพ ดูและกดไลค์รูปภาพของผู้ใช้คนอื่น แอปพลิเคชันของคุณมีผู้ใช้ที่มุ่งมั่นจำนวนน้อย และค่อนข้างเสถียร ไม่มีปัญหาความพร้อมใช้งาน
ทั้งหมดนี้เปลี่ยนไปเมื่อคู่แข่งหลักห้ามการแชร์รูปภาพแมวและคาปูชิโน่อย่างไม่คาดคิด ทำให้ผู้ใช้ย้ายมาที่ SnapGram ภายในไม่กี่ชั่วโมง จำนวนผู้ใช้งานเพิ่มขึ้นจากนับร้อยเป็นพันๆ ทันใดนั้น พันๆ คนร้องเรียนว่าไม่สามารถใช้ SnapGram ได้ แต่เมื่อคุณตรวจสอบบันทึกของแอปพลิเคชัน ทุกอย่างดูเหมือนจะทำงานปกติ และไม่มีการเพิ่มขึ้นของเหตุการณ์ข้อผิดพลาด
แดชบอร์ด Magic ของ NGINX บอกเรื่องราวอีกอย่างหนึ่ง:
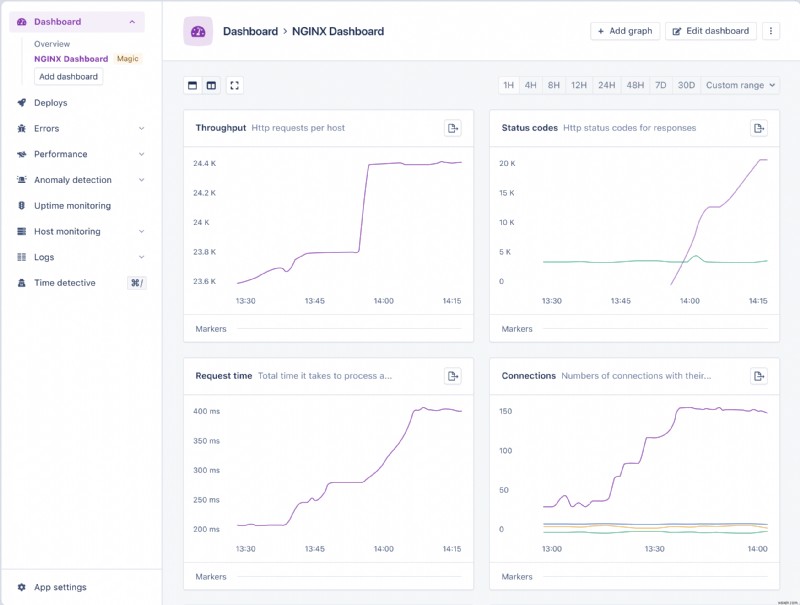
กราฟ Throughput ให้ข้อมูลเชิงลึกอย่างรวดเร็วเกี่ยวกับจำนวนคำขอที่แอปพลิเคชันของเรากำลังรับ ดูจากกราฟ เราเห็นว่า SnapGram "ทำลายอินเทอร์เน็ต" - ได้รับคำขอมากมาย กราฟ Request time ก็เพิ่มขึ้นเช่นกัน แสดงว่า SnapGram ใช้เวลานานขึ้นในการตอบสนองคำขอ กราฟ Connections ซึ่งแสดงสถานะการเชื่อมต่อกับแอปพลิเคชันของเรา บอกว่ามีคนหลายคนรอให้ SnapGram ตอบสนอง มันไม่สามารถรับมือกับความต้องการได้
เนื่องจาก SnapGram ไม่สามารถรับมือกับความต้องการได้ กราฟ Status codes จึงแสดงว่า timeout เพิ่มขึ้นอย่างรวดเร็ว ผู้คนส่วนใหญ่ที่พยายามโต้ตอบกับ SnapGram ได้รับข้อผิดพลาด timeout เนื่องจากสิ่งนี้เกิดขึ้นก่อนที่กระบวนการแอปพลิเคชันของ SnapGram จะรับคำขอ การวิเคราะห์บันทึกเพียงอย่างเดียวจึงจะไม่แจ้งเตือนให้เรารู้ถึงปัญหานี้ (เราจะเห็นเพียงเปอร์เซ็นต์น้อยของคำขอที่ SnapGram จัดการสำเร็จ)
ตอนนี้ที่คุณรู้ว่าปัญหาไม่ได้อยู่ที่โค้ด คุณสามารถปรับปรุงความพร้อมใช้งานของ SnapGram ได้โดยการเพิ่มเซิร์ฟเวอร์เพิ่มเติม เพื่อให้แอปพลิเคชันจัดการトラฟฟิกได้ดีขึ้น เซิร์ฟเวอร์ใหม่แต่ละตัวจะปรากฏเป็นเครื่องหมายที่แตกต่างกันในกราฟ Upstream Response Time และ Upstream Status Code ของ Magic Dashboard ให้ข้อมูลเชิงลึกต่อกระบวนการ
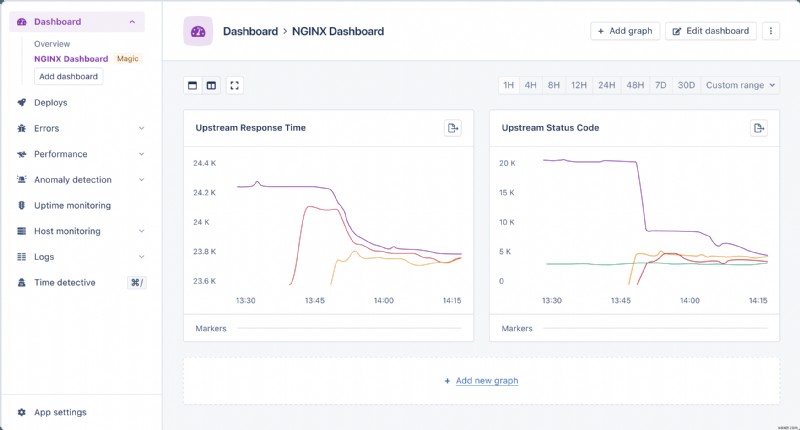
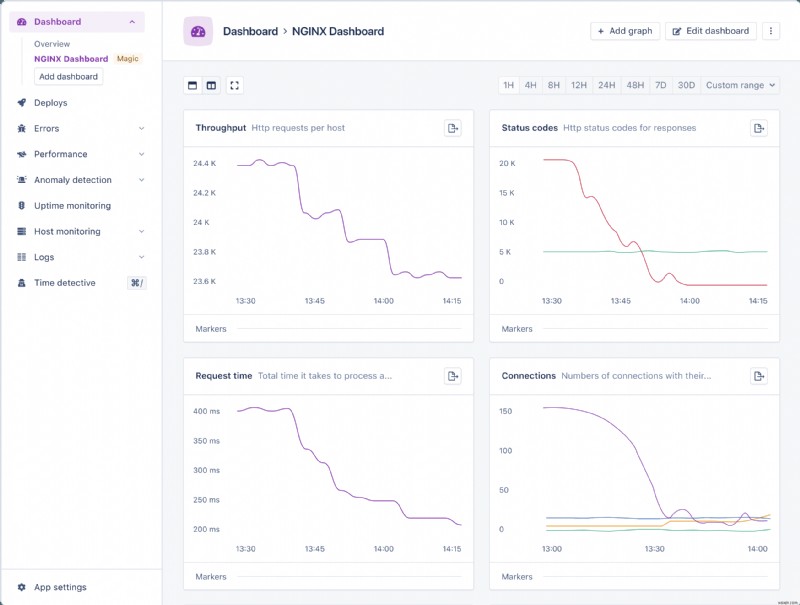
เพื่อลดโหลดบน SnapGram ลงอีก คุณยังเปิดใช้งาน upstream caching ด้วย เมื่อคำขอที่ถูกแคชมากขึ้น เวลาคำขอ (และเวลาคำขอ upstream) จะลดลงเมื่อแรงกดดันบนแอปพลิเคชันลดลง เมื่อ SnapGram เสถียรและคำขอของผู้ใช้ได้รับการบริการ คุณจะสังเกตว่าผู้ใช้หยุดร้องเรียนและกลับมาแชร์รูปแมวและคาปูชิโน่อีกครั้ง
เมตริกมากขึ้น = ความมหัศจรรย์มากขึ้น
SnapGram เป็นเพียงตัวอย่างง่ายๆ ของการเข้าถึงเมตริกที่อ่านง่ายสามารถช่วยให้คุณรักษาเสถียรภาพแอปพลิเคชันและใช้ประโยชน์สูงสุดจากการรวม NGINX ได้
Magic Dashboards NGINX ของเราสามารถติดตามเมตริกต่อไปนี้ได้:
- Request Time: เวลาที่เซิร์ฟเวอร์ NGINX ใช้ในการตอบสนองคำขอ โดยเป็นค่าเฉลี่ยต่อนาทีและค่าเปอร์เซ็นไทล์ 95
- Throughput: จำนวนคำขอที่เซิร์ฟเวอร์ NGINX จัดการ
- Request Length: ความยาวในไบต์ของคำขอที่รับจากไคลเอ็นต์โดยเซิร์ฟเวอร์ NGINX โดยเป็นค่าเฉลี่ยต่อนาทีและค่าเปอร์เซ็นไทล์ 95
- Response Length: ความยาวในไบต์ของการตอบสนองที่ส่งไปยังไคลเอ็นต์โดยเซิร์ฟเวอร์ NGINX โดยเป็นค่าเฉลี่ยต่อนาทีและค่าเปอร์เซ็นไทล์ 95
- Status Codes: จำนวนรหัสสถานะของการตอบสนองที่ส่งโดยเซิร์ฟเวอร์ NGINX
- Connections: เกจของการเชื่อมต่อที่กำลังถูกจัดการโดยเซิร์ฟเวอร์ NGINX วัดหนึ่งครั้งต่อนาทีและแบ่งตามสถานะการเชื่อมต่อ
- Upstream Status Codes: จำนวนรหัสสถานะของการตอบสนองที่ส่งโดยเซิร์ฟเวอร์ upstream ที่เซิร์ฟเวอร์ NGINX ทำหน้าที่เป็น proxy
- Upstream Response Time: เวลาที่ใช้ในการตอบสนองคำขอโดยเซิร์ฟเวอร์ upstream ที่เซิร์ฟเวอร์ NGINX ทำหน้าที่เป็น proxy โดยเป็นค่าเฉลี่ยต่อนาทีและค่าเปอร์เซ็นไทล์ 95
- Upstream Cache Status: สถานะแคช (เช่น HIT หรือ MISS) เมื่อจัดการคำขอที่ถูกแคชและ proxy จากเซิร์ฟเวอร์ upstream
หากคุณพร้อมที่จะเริ่มต้นกับ NGINX และ AppSignal เรียนรู้เพิ่มเติมเกี่ยวกับการกำหนดค่าการรวม AppSignal ในเอกสารเมตริก NGINX ของเรา
Magic Dashboards ของ AppSignal เป็นเพียงหนึ่งในคุณสมบัติที่ขับเคลื่อนโดยนักพัฒนาหลายอย่างที่ช่วยให้คุณได้รับประโยชน์สูงสุดจากการตรวจสอบแอปพลิเคชันของคุณ นักพัฒนายังชื่นชอบการตรวจสอบของเราเพราะเรามี:
- อินเทอร์เฟซที่直覺และนำทางง่าย
- ราคาที่เรียบง่ายและคาดการณ์ได้
- การสนับสนุนจากนักพัฒนาสู่นักพัฒนา
หากคุณเป็นผู้ใช้ทดลองใหม่ คุณยังสามารถรับกล่อง stroopwafels ฟรีได้ เมื่อคุณเริ่มส่งข้อมูลบางส่วน โปรดติดต่อเรา และเราจะส่งแพ็กเกจให้คุณ 🍪!
Connor James
Developer Marketing Manager ที่ AppSignal โจ๋นพอดแคสต์ที่รัก cannoli จนคิดว่าจะเปลี่ยนชื่อเป็น Connoli เขาคิดว่ามีตัวอักษร 'u' ในคำว่า color คุณอาจพบเขาบนไมค์ บนเวที หรือนอนบนโซฟาเมื่อเขาว่าง
บทความทั้งหมดโดย Connor James
