

เผยแพร่ครั้งแรกเมื่อวันที่ 17 มิถุนายน 2563 ที่ Onica.com/blog
องค์กรทั่วอุตสาหกรรมมองหาการใช้ data analytics สำหรับการดำเนินงานและฟังก์ชันอื่นๆ ที่สำคัญต่อความสำเร็จ อย่างไรก็ตาม เมื่อปริมาณข้อมูลเพิ่มขึ้น การจัดการและการดึงคุณค่าอาจกลายเป็นซับซ้อนมากขึ้น
Amazon Redshift
Amazon® Redshift® เป็นบริการ data warehouse อันทรงพลังจาก Amazon Web Services® (AWS) ที่ทำให้การจัดการข้อมูลและ analytics ง่ายขึ้น มาดู Amazon Redshift และแนวทางปฏิบัติที่ดีที่สุดบางอย่างที่คุณสามารถนำไปใช้เพื่อเพิ่มประสิทธิภาพการสืบค้นข้อมูล
Data lakes เทียบ Data warehouse
ก่อนจะขุดลึก Amazon Redshift สำคัญที่จะรู้ความแตกต่างระหว่าง data lakes และ warehouses Data lake เช่น Amazon S3 เป็นที่เก็บข้อมูลแบบรวมศูนย์ที่เก็บ structured และ unstructured data ในทุก scale และจากหลายแหล่งโดยไม่เปลี่ยนแปลงข้อมูล ส่วน Data warehouses เก็บข้อมูลในสถานะที่ reconciled เพื่อเพิ่มประสิทธิภาพ analytics ต่อเนื่อง และโหลดเฉพาะข้อมูลที่จำเป็นสำหรับ analytics จาก data lakes
Amazon Redshift นำการจัดเก็บสำหรับ data analytics ไปสู่ระดับถัดไป โดยรวมคุณสมบัติของ data lakes และ warehouses เข้าด้วยกันในแนวทาง "lake house" มันอนุญาตให้สืบค้น data lakes ขนาด exabyte-scale ขนาดใหญ่ ในขณะที่ยังคงคุ้มค่า ลด redundancy ของข้อมูล และลด overhead การบำรุงรักษาและต้นทุนการดำเนินงาน
สถาปัตยกรรม Amazon Redshift
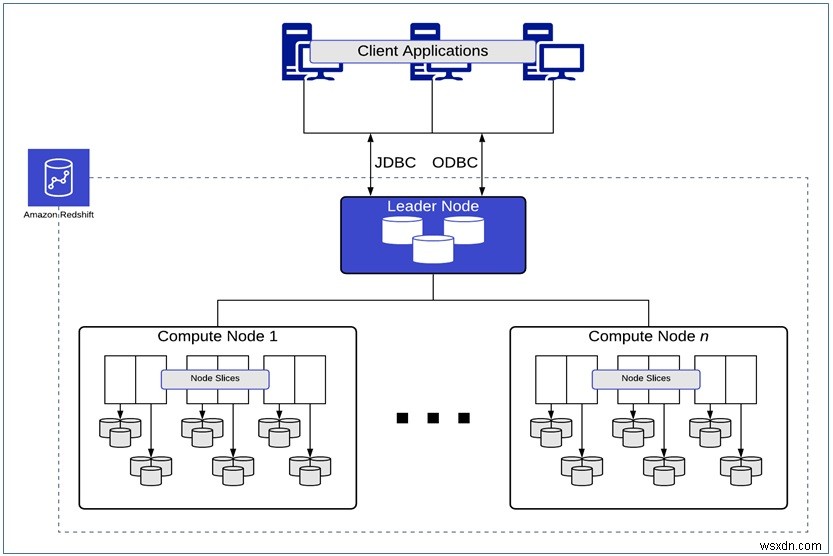
เพื่อประมวลผลคำขอซับซ้อนบนชุดข้อมูลใหญ่อย่างรวดเร็ว สถาปัตยกรรม Amazon Redshift รองรับ massively parallel processing (MPP) ที่กระจายงานข้าม compute nodes หลายตัวเพื่อประมวลผลพร้อมกัน
โหนดเหล่านี้จัดกลุ่มเป็นคลัสเตอร์ และแต่ละคลัสเตอร์ประกอบด้วย 3 ประเภทของโหนด:
Leader Node: จัดการ connections ทำหน้าที่เป็น SQL endpoint และประสาน parallel SQL processing
Compute Nodes: ประกอบด้วย slices ดำเนินการคำขอแบบขนานบนข้อมูลที่จัดเก็บใน columnar format และใน 1 MB immutable blocks คลัสเตอร์ Amazon Redshift สามารถมี compute nodes ระหว่าง 1 ถึง 128 แบ่งเป็น slices ที่มีข้อมูลตารางและทำหน้าที่เป็น local processing zone
Amazon Redshift Spectrum Nodes: ดำเนินการคำขอต่อ Amazon S3 data lake
การเพิ่มประสิทธิภาพการสืบค้น
ด้วยการนำ physical layout ของข้อมูลในคลัสเตอร์มา congruent กับ query patterns ของคุณ คุณสามารถสกัดประสิทธิภาพการสืบค้นที่เหมาะสมที่สุดได้ หาก Amazon Redshift ไม่ทำงานอย่างเหมาะสม พิจารณากำหนดค่า workload management ใหม่
กำหนดค่า Workload Management (WLM) ใหม่
มักทิ้งไว้ที่ค่าเริ่มต้น การปรับ WLM สามารถปรับปรุงประสิทธิภาพได้ คุณสามารถทำให้เป็นอัตโนมัติหรือทำด้วยมือได้ เมื่อเป็นอัตโนมัติ Amazon Redshift จัดการการใช้หน่วยความจำและ concurrency ตามการใช้ทรัพยากรของคลัสเตอร์ มันอนุญาตให้คุณตั้งค่า priority-designated queues แปดคิว เมื่อทำด้วยมือ คุณสามารถปรับจำนวน concurrent queries, memory allocation และ targets ได้
คุณยังสามารถเพิ่มประสิทธิภาพการสืบค้นผ่านพารามิเตอร์การกำหนดค่า WLM ต่อไปนี้:
Query monitoring rules ช่วยคุณจัดการคำขอที่แพงหรือ runaway queries
Short query acceleration ช่วยคุณ prioritize short-running queries מעל longer-running queries โดยใช้ machine learning algorithms เพื่อพยากรณ์เวลาการดำเนินการคำขอ
Concurrency scaling ช่วยคุณเพิ่ม transient clusters หลายตัวในวินาทีเพื่อเร่ง concurrent read queries
WLM best practices
บาง WLM tuning best practices รวมถึง:
- สร้าง WLM queries ต่างกันสำหรับประเภท workloads ที่ต่างกัน
- จำกัด maximum total concurrency สำหรับ main cluster ไว้ที่ 15 หรือน้อยกว่าเพื่อเพิ่ม throughput
- เปิดใช้งาน concurrency scaling
- ลดจำนวนทรัพยากรในคิวให้น้อยที่สุด
การปรับปรุงการกระจายข้อมูล
แถวของตารางถูกกระจายโดย Amazon Redshift ข้าม node slices โดยอัตโนมัติ ตาม distribution styles ต่อไปนี้:
AUTO: เริ่มด้วย ALL และเปลี่ยนเป็น EVEN เมื่อตารางโตALL: ประกอบด้วยตารางขนาดเล็ก frequently joined และ infrequently modified วางบน slice แรกของแต่ละ compute nodeEVEN: ประกอบด้วย fact tables ขนาดใหญ่ standalone ที่ไม่ได้ joined หรือ aggregated บ่อยใน round-robin distribution ข้าม slicesKEY: ประกอบด้วย fact tables ที่ joined บ่อย หรือ large dimension tables ใน style นี้ ค่า column ถูก hash และค่า hash เดียวกันถูกวางบน slice เดียวกัน
การใช้ distribution patterns ที่ถูกต้องสามารถเพิ่มประสิทธิภาพการดำเนินการ JOIN, GROUP BY และ INSERT INTO SELECT ได้
การปรับปรุงการจัดเรียงข้อมูล
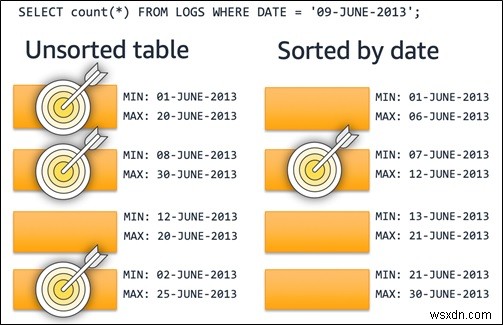
Sort keys กำหนด physical order ของข้อมูลบนดิสก์ คอลัมน์ตารางที่ใช้ใน WHERE clause predicates เป็นตัวเลือกที่ดีสำหรับ sort keys และมักใช้คอลัมน์ที่เกี่ยวกับวันที่หรือเวลา ใช้ Zone maps ที่เก็บในหน่วยความจำและสร้างโดยอัตโนมัติ เพื่อกำหนดค่าขีดจำกัดสำหรับแต่ละบล็อกของข้อมูล การใช้ sort keys และ zone maps ร่วมกันอย่างมีประสิทธิภาพสามารถช่วยคุณจำกัด scans ให้เหลือเพียงจำนวนบล็อกขั้นต่ำที่จำเป็น
แผนภาพต่อไปนี้แสดงวิธีที่การจัดเรียงตารางโฟกัสเป้าหมายการสแกนสำหรับคำขอที่ขึ้นอยู่กับเวลา ด้วยเหตุนี้ปรับปรุงประสิทธิภาพคำขอ
แนวทางปฏิบัติที่ดีที่สุดสำหรับประสิทธิภาพคำขอที่เหมาะสม
การใช้การเปลี่ยนแปลง Amazon Redshift ที่กล่าวมาข้างต้นสามารถปรับปรุงประสิทธิภาพคำขอและปรับปรุงค่าใช้จ่ายและประสิทธิภาพทรัพยากร นี่คือ best practices เพิ่มเติมที่คุณสามารถนำไปใช้เพื่อปรับปรุงประสิทธิภาพเพิ่มเติม:
- ใช้
SORTkeys บนคอลัมน์ที่มักใช้ในWHEREclause filters - ใช้
DISTKEYบนคอลัมน์ที่มักใช้ในJOINpredicates - Compress ทุกคอลัมน์ยกเว้นคอลัมน์ sort-key แรก
- Partition data ใน data lake ตาม query filters เช่น access pattern
เพื่อสำรวจ best practices เพิ่มเติม ลองดำดิ่งสู่ Amazon Redshift changes และดูตัวอย่างการวิเคราะห์คำขอลึก อ่าน AWS Partner Network (APN) Blog
หากคุณกำลังเริ่มต้นการเดินทางข้อมูลและมองหาการใช้บริการ AWS เพื่อพัฒนา data platform ของคุณอย่างรวดเร็ว น่าเชื่อถือ และคุ้มค่า ติดต่อทีม Data Engineering & Analytics ของเราวันนี้
เรียนรู้เพิ่มเติมเกี่ยวกับบริการ Onica
ใช้แท็บ Feedback เพื่อแสดงความคิดเห็นหรือถามคำถาม คุณยังสามารถคลิก Sales Chat เพื่อแชททันทีและเริ่มสนทนาได้
