

Redis เป็นเทคโนโลยีพื้นฐาน (bedrock technology) และเราบางครั้งเห็นผู้คนพิจารณาสถาปัตยกรรมทางเลือก ไปไม่กี่ปี KeyDB ได้นำเสนอเรื่องนี้ และ gầnๆ นี้โครงการใหม่ Dragonfly อ้างว่าเป็น Redis-compatible in-memory datastore ที่เร็วที่สุด เราเชื่อว่าโครงการเหล่านี้นำเทคโนโลยีและแนวคิดน่าสนใจมากมายที่คุ้มค่าที่จะพูดคุยและอภิปราย ที่นี่ Redis เราชอบการท้าทายแบบนี้ เพราะมันบังคับให้เรายืนยันหลักการสถาปัตยกรรมที่ Redis ออกแบบไว้ตั้งแต่แรก (เครดิตให้ Salvatore Sanfilippo aka antirez)
แม้เราจะมองหาโอกาสในการนวัตกรรมและพัฒนาประสิทธิภาพและความสามารถของ Redis ตลอดเวลา เราก็อยากแบ่งปمنมุมมองและความคิดเห็นเกี่ยวกับเหตุผลที่สถาปัตยกรรมของ Redis ยังคงเป็น best-in-class สำหรับ in-memory real-time datastore (cache, database, และทุกอย่างระหว่างนั้น)
ในส่วนต่อไป เราจะเน้นมุมมองของเราเกี่ยวกับความเร็วและความแตกต่างทางสถาปัตยกรรมที่เกี่ยวข้องกับการเปรียบเทียบที่เกิดขึ้น ในท้ายบล็อกนี้ เรายังให้รายละเอียดเกี่ยวกับ benchmark และการเปรียบเทียบประสิทธิภาพกับโครงการ Dragonfly ที่เราพูดถึงด้านล่าง และเชิญชวนคุณให้ตรวจสอบและทำซ้ำด้วยตัวเอง
ความเร็ว (Speed)
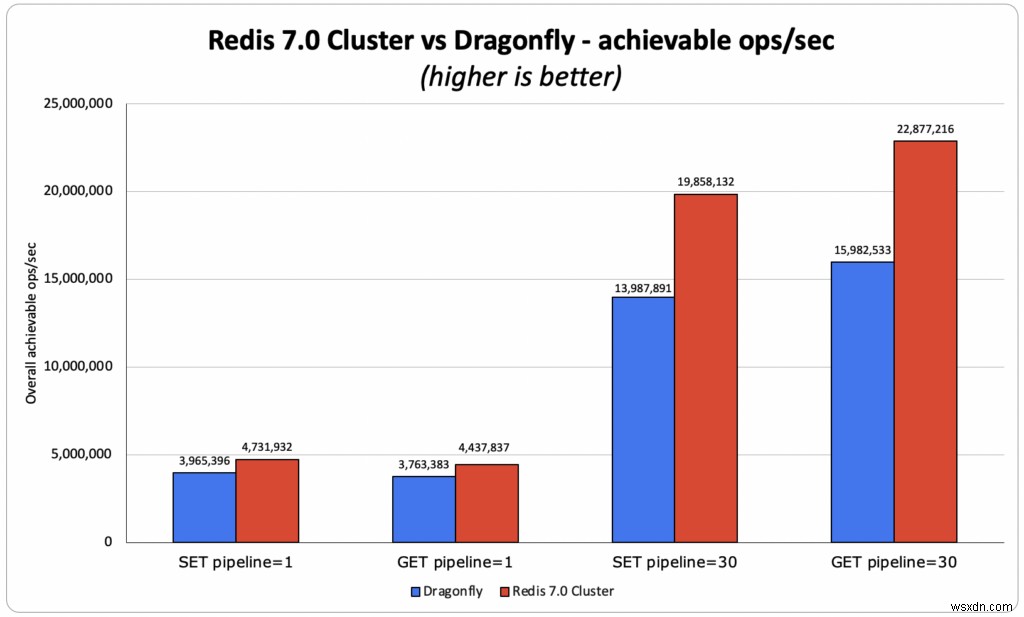
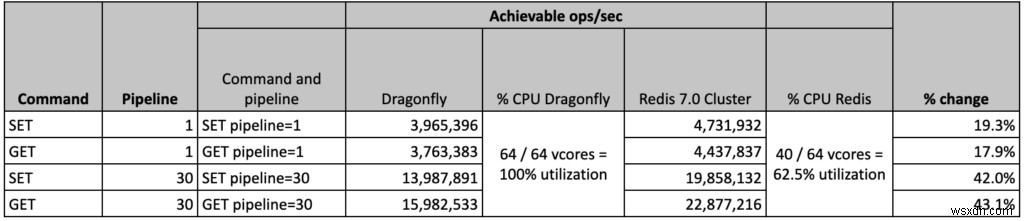
Benchmark ของ Dragonfly เปรียบเทียบ standalone single process Redis instance (ที่ใช้ได้แค่ single core) กับ multithreaded Dragonfly instance (ที่ใช้ทุก core ที่มีบน VM/เซิร์ฟเวอร์) น่าเสียดายว่า การเปรียบเทียบนี้ไม่ได้แทนวิธีที่ Redis ถูกใช้งานในโลกจริง ในฐานะผู้สร้างเทคโนโลยี เราพยายามเข้าใจอย่างแน่ชัดว่าเทคโนโลยีของเราเปรียบเทียบกับอื่นๆ อย่างไร ดังนั้นเราทำการเปรียบเทียบที่เราเชื่อว่าเป็นธรรม (fair comparison) โดยเปรียบเทียบ 40-shard Redis 7.0 Cluster (ที่สามารถใช้ core ส่วนใหญ่ของ instance) กับ Dragonfly โดยใช้ชุดการทดสอบประสิทธิภาพบน instance type ใหญ่ที่สุดที่ทีม Dragonfly ใช้ใน benchmark ของพวกเขา คือ AWS c6gn.16xlarge ในการทดสอบของเรา เราพบว่า Redis ทำ throughput ได้มากกว่า Dragonfly 18% - 40% แม้ใช้เพียง 40 จาก 64 vCores เท่านั้น
ความแตกต่างทางสถาปัตยกรรม (Architectural differences)
พื้นหลังบางส่วน
เราเชื่อว่าการตัดสินใจทางสถาปัตยกรรมของผู้สร้างโครงการ multithreaded เหล่านี้ ได้รับอิทธิพลจาก pain points ที่พวกเขาเผชิญในงานก่อนหน้า เราตกลงกันว่า การรัน single Redis process บน multi-core machine บางครั้งมีหลายสิบ core และหลายร้อย GB ของหน่วยความจำ จะไม่ได้ใช้ประโยชน์จากทรัพยากรที่มีอยู่ชัดเจน แต่นี่ไม่ใช่วิธีที่ Redis ถูกออกแบบมาให้ใช้งาน นี่คือแค่วิธีที่ผู้ให้บริการ Redis หลายแห่งเลือกที่จะรันบริการของพวกเขา
Redis ขยายตัวแบบแนวนอน (horizontally) โดยการรัน multi-processes (ใช้ Redis Cluster) แม้ในบริบทของ single cloud instance ที่ Redis (บริษัท) เราพัฒนาแนวคิดนี้ต่อ และสร้าง Redis Enterprise ที่ให้ management layer 允许用户大规模运行 Redis,具有高可用性、即时故障转移、数据持久性和默认启用的备份。
我们决定分享一些我们在幕后使用的原则,以帮助人们了解我们认为在生产环境中运行 Redis 的良好工程实践。
架构原则
每个 VM 运行多个 Redis 实例
每个 VM 运行多个 Redis 实例让我们能够:
- 使用完全共享无关架构(shared-nothing architecture)在垂直和水平方向上线性扩展。这将始终比仅垂直扩展的多线程架构提供更多灵活性。
- 提高复制速度,因为复制是在多个进程中并行完成的。
- 由于新 VM 的 Redis 实例将同时从多个外部 Redis 实例填充数据,因此可以从 VM 故障中快速恢复。
将每个 Redis 进程限制在合理的大小
我们不允许单个 Redis 进程增长超过 25 GB(使用 Redis on Flash 时为 50 GB)。这让我们能够:
- 享受 copy-on-write 的好处,而不必在为复制、快照和 Append Only File (AOF) 重写而 fork Redis 时支付大内存开销的代价。"是的",如果你不这样做,你(或你的用户)将付出高昂代价,如这里所示。
- 轻松管理集群、迁移分片、重新分片、扩展和重新平衡,因为每个 Redis 实例都保持较小。
水平扩展至关重要
能够以水平扩展运行内存数据存储极其重要。以下只是几个原因:
- 更好的弹性 - 集群中使用的节点越多,集群就越稳健。例如,如果你在 3 节点集群上运行数据集且一个节点退化,那是你集群的 1/3 没有表现;但如果你在 9 节点集群上运行数据集且一个节点退化,那只是你集群的 1/9 没有表现。
- 更容易扩展 - 向集群添加额外节点并仅迁移一部分数据集到它,比垂直扩容容易得多,垂直扩容需要引入更大的节点并复制整个数据集(想想在这个潜在漫长过程中中间可能发生的所有坏事…)
- 逐步扩展更具成本效益 - 垂直扩容,尤其是在云端,很昂贵。在许多情况下,即使你只需要给数据集增加几 GB,也需要将实例大小加倍。
- 高吞吐量 - 在 Redis,我们看到许多客户在小数据集上运行高吞吐量工作负载,具有非常高的网络带宽和/或高包每秒 (PPS) 需求。想想 1GB 数据集配合 1M+ ops/sec 的用例。在单节点 c6gn.16xlarge 集群 (128GB, 64 CPUs, 100gbps, $2.7684/hr) 上运行合理吗?而不是 3 节点 c6gn.xlarge 集群 (8GB, 4 CPU, 高达 25Gbps, $0.1786/hr 每个),成本不到 20%,且方式更稳健?能够在保持成本效益和提高弹性的同时增加吞吐量,似乎是个容易的答案。
- NUMA 的现实 - 垂直扩容也意味着运行双插槽服务器,具有多核和大 DRAM;这种基于 NUMA 的架构非常适合像 Redis 这样的多进程架构,因为它表现得更像是一个小节点网络。但 NUMA 对多线程架构更具挑战性,从我们与其他多线程项目的经验来看,NUMA 可能会降低内存数据存储的性能高达 80%。
- 存储吞吐量限制 - 像 AWS EBS 这样的外部磁盘,扩展速度不如内存和 CPU 快。事实上,云服务提供商根据使用的机器类别施加存储吞吐量限制。因此,有效扩展集群以避免上述问题并满足高数据持久性要求的唯一方法是使用水平扩展,即通过添加更多节点和更多网络连接磁盘。
- 临时磁盘 - 临时磁盘是运行 Redis on SSD(SSD 用作 DRAM 替代品,但不是持久存储)的绝佳方式,并享受基于磁盘数据库的成本,同时保持 Redis 速度(看我们如何用 Redis on Flash 做到这一点)。同样,当临时磁盘达到极限时,扩展集群的最好方式,在许多情况下是唯一方法,是添加更多节点和更多临时磁盘。
- 商品硬件 - 最后,我们有许多 on-premises 客户在本地数据中心、私有云甚至小型边缘数据中心运行;在这些环境中,很难找到拥有超过 64 GB 内存和 8 CPU 的机器,再次,扩展的唯一方法是水平的。
总结
我们感谢社区提供的新鲜、有趣的想法和技术,就像新一波多线程项目所提供的那样。未来甚至有可能其中一些概念会进入 Redis(像 io_uring 我们已经开始研究,更现代的字典,更战术性的线程使用等)。但就可预见的未来,我们不会放弃 Redis 提供的共享无关、多进程架构的基本原则。这种设计提供了最佳性能、扩展性和弹性,同时也支持内存实时数据平台所需的各种部署架构。
附录 Redis 7.0 vs. Dragonfly benchmark 详情
Benchmark 概要
版本:
- 我们使用 Redis 7.0.0 并从源码构建
- Dragonfly 于 6 月 3 日从源码构建 (hash=e806e6ccd8c79e002f721a1a5ecb847bd7a06489) 如 https://github.com/Dragonfly/dragonfly#building-from-source 建议
目标:
- 验证 Dragonfly 结果可复现,并确定检索它们的完整条件(考虑到 memtier_benchmark 上缺少一些配置、操作系统版本等…)详见此处
- 确定在 AWS c6gn.16xlarge instance 上可达到的最佳 OSS Redis 7.0.0 Cluster 性能,匹配 Dragonfly 的 benchmark
客户端配置:
- OSS Redis 7.0 解决方案需要更多打开的连接到 Redis Cluster,因为每个 memtier_benchmark 线程连接到所有分片
- OSS Redis 7.0 解决方案在两个 memtier_benchmark 进程运行 benchmark 但都在同一个客户端 VM 上以匹配 Dragonfly benchmark 时提供最佳结果
资源利用和最佳配置:
- OSS Redis Cluster 在 40 个主分片时达到最佳结果,意味着 VM 上有 24 个备用 vCPU。虽然机器没有被完全利用,但我们发现增加分片数量没有帮助,反而降低了整体性能。我们仍在调查这种行为。
- 另一方面,Dragonfly 解决方案完全占满 VM,所有 64 个 VCPU 达到 100% 利用率。
- 对于两种解决方案,我们改变客户端配置以达到最佳可能结果。如下所示,我们设法复现了大部分 Dragonfly 数据,甚至在 pipeline 等于 30 时超越了最佳结果。
- 这意味着我们用 Redis 达到的数字还有进一步增加的潜力。
最后,我们还发现 Redis 和 Dragonfly 都没有受到网络 PPS 或带宽限制,因为我们确认在使用的 2 个 VM 之间(客户端和服务端都用 c6gn.16xlarge)我们可以达到 >10M PPS 和 >30 Gbps TCP,载荷约 300B。
分析结果
- GET pipeline 1 sub-ms:
- OSS Redis: 4.43M ops/sec,平均和 p50 都达到亚毫秒延迟。平均客户端延迟 0.383 ms
- Dragonfly 声称 4M ops/sec:
- 我们复现了 3.8M ops/sec,平均客户端延迟 0.390 ms
- Redis vs Dragonfly – Redis throughput 高出 10% 对比 Dragonfly 声称结果,高出 18% 对比我们复现的 Dragonfly 结果。
- GET pipeline 30:
- OSS Redis: 22.9M ops/sec,平均客户端延迟 2.239 ms
- Dragonfly 声称 15M ops/sec:
- 我们复现了 15.9M ops/sec,平均客户端延迟 3.99 ms
- Redis vs Dragonfly – Redis 好 43% (对比 Dragonfly 复现结果) 和 52% (对比 Dragonfly 声称结果)
- SET pipeline 1 sub-ms:
- OSS Redis: 4.74M ops/sec,平均和 p50 都达到亚毫秒延迟。平均客户端延迟 0.391 ms
- Dragonfly 声称 4M ops/sec:
- 我们复现了 4M ops/sec,平均客户端延迟 0.500 ms
- Redis vs Dragonfly – Redis 好 19% (我们复现了 Dragonfly 声称的相同结果)
- SET pipeline 30:
- OSS Redis: 19.85M ops/sec,平均客户端延迟 2.879 ms
- Dragonfly 声称 10M ops/sec:
- 我们复现了 14M ops/sec,平均客户端延迟 4.203 ms
- Redis vs Dragonfly – Redis 好 42% (对比 Dragonfly 复现结果) 和 99% (对比 Dragonfly 声称结果)
memtier_benchmark 每种变体使用的命令:
- GET pipeline 1 sub-ms
- Redis:
- 2X: memtier_benchmark –ratio 0:1 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram
- Dragonfly:
- memtier_benchmark –ratio 0:1 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram
- Redis:
- GET pipeline 30
- Redis:
- 2X: memtier_benchmark –ratio 0:1 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram –pipeline 30
- Dragonfly:
- memtier_benchmark –ratio 0:1 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram –pipeline 30
- Redis:
- SET pipeline 1 sub-ms
- Redis:
- 2X: memtier_benchmark –ratio 1:0 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram
- Dragonfly:
- memtier_benchmark –ratio 1:0 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram
- Redis:
- SET pipeline 30
- Redis:
- 2X: memtier_benchmark –ratio 1:0 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram –pipeline 30
- Dragonfly:
- memtier_benchmark –ratio 1:0 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram –pipeline 30
- Redis:
基础设施详情
我们对客户端(运行 memtier_benchmark)和服务端(运行 Redis 和 Dragonfly)使用相同的 VM 类型,规格如下:
- VM:
- AWS c6gn.16xlarge
- aarch64
- ARM Neoverse-N1
- 每插槽核心数: 64
- 每核心线程数: 1
- NUMA 节点: 1
- AWS c6gn.16xlarge
- 内核: Arm64 Kernel 5.10
- 安装内存: 126GB
