

บทนำ
ในไม่กี่ปีที่ผ่านมา Serverless Architectures และ Edge Computing เป็นที่นิยมสำหรับ Application Deployments แตการจัดเก็บ Application State และ Data ภายใน Serverless/Edge Functions เป็นเรื่องอื่น มีความยากหลายอย่าง เช่น การจัดการ Connections ไป Database, ทำให้ Data Available สำหรับ Fast Access จากหลาย Locations ฯลฯ มีเพียงไม่กี่ Database Services ที่รองรับ Serverless Access และน้อยกว่านั้นที่เหมาะกับ Edge Functions (อ่านวิเคราะห์ละเอียด ที่นี่)
ที่ Upstash ตั้งแต่วันแรก เราให้ Serverless Redis-Compatible Database สำหรับ Low Latency ด้วย Pricing Model แบบ Per-Request นอกจากนี้เรายังมี First-class REST API สร้างบน Database โดยตรง REST API กำจัด Connection Management Hassle โดยเฉพาะใน Serverless Functions และเข้าถึงได้แม้ใน Restricted Environments เช่น Edge Locations หรือ Web Browsers
วันนี้เรายินดีประกาศ Global Database ซึ่งเป็นขั้นตอนต่อไปทำให้ Database Available Globally ใกล้ Clients และ Edge Locations สำหรับ Low Latency Reads Global Database พร้อมใน Free Tier ลองใช้ฟรีโดยไม่มีค่าใช้จ่าย
Use When? (ใช้เมื่อไหร่?)
Global Database Deploy ไปหลาย Regions บน Continents ต่างๆ Client Requests ถูก Route ไป Nearest Region เพื่อ Minimize Latency เมื่อ Users แจกแจงทั่วโลก Upstash Global Databases ใช้ได้สำหรับ:
- Edge Functions (Cloudflare Workers, Fastly Compute): Built-in REST API และ Low Latency Access จาก Edge Locations ทั้งหมดทำให้เป็น Perfect Solution
- Multi-region Serverless Deployments: AWS Lambda, Vercel และ Netlify Functions Deploy ได้หลาย Regions Global Database ให้ Low Latency Data ทุกที่ที่ Serverless Functions อยู่
- Web/Mobile Platforms: ใช้ Read-only REST API เข้าถึง Redis Database จาก Web/Mobile App โดยตรง Global Database ให้ Better Latencies เนื่องจาก User อาจมาจากที่ไหนก็ได้
เป้าหมายอีกอย่างของ Global Database คือทำให้ Database Resilient ต่อ Region-wide Failures เมื่อ Region ไหนไม่ Available Requests จะ Route ไป Nearest Available Region ทำให้ Database ยังคง Available
How it Works? (ทำงานอย่างไร?)
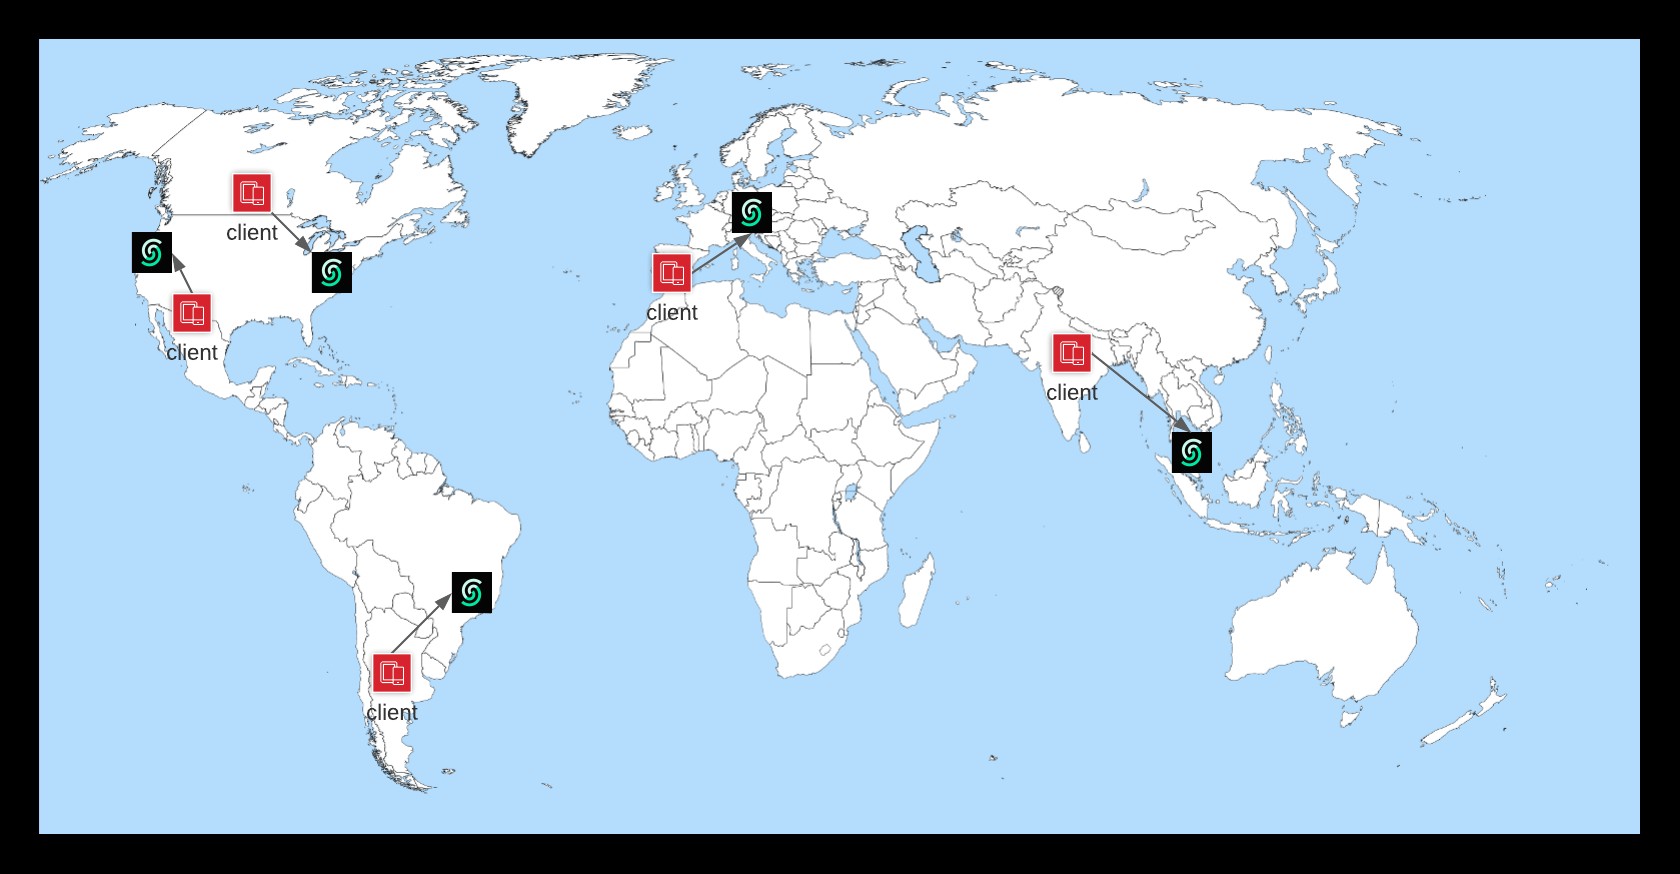
ใน Global Database Model มี Multiple Replicas ของ Database เดียวกันสร้าง Cluster ร่วมกัน แต่ละ Replica เชื่อมต่อกับ Cluster Members อื่นๆ และ Track Liveness ของแต่ละตัวด้วย Failure Detector ทั้ง Cluster Membership และ Failure Detection จัดการด้วย Gossip-based Communication Protocol (ดู SWIM: Scalable Weakly-consistent Infection-style Process Group Membership Protocol)
สำหรับ Replicate Data (เฉพาะ Writes/Updates/Deletes) ใช้ Single Leader Replication Model กลุ่ม Keys ถูก Assign ให้ Leader Replica ซึ่ง Elected ผ่าน Leader Election Mechanism หลัง Membership Change Replicas ที่เหลือกลายเป็น Backups ของ Leader สำหรับกลุ่ม Keys นั้น เมื่อ Leader Replica ถูก Detect ว่า Failed โดย Failure Detector Replicas ที่เหลือเริ่ม Leader Election Round ใหม่และ Elect Leader ใหม่ ระหว่าง Election Database ไม่ Available ช่วงสั้น Requests จะ Block จน Election เสร็จ
เฉพาะ Leader Replica ที่ Accept และ Process Write Requests Backup Replicas Forward Writes ไป Leader ภายในโดยไม่ Notify Client ดังนั้นไม่ว่า Replica Type (Leader หรือ Backup) Client ส่ง Write Request ได้ หลัง Process Write Request Leader Propagate ไป Backup Replicas
More on Consistency (เพิ่มเติมเกี่ยวกับ Consistency)
ปัจจุบัน Global Databases เป็น Weakly Consistent ไม่รองรับ Strong Consistency Response ของ Write Request ส่งกลับ Client หลัง Leader Process Operation โดยไม่รอ ACK จาก Majority ของ Backups ผลลัพธ์ของ Write Replicate ไป Backups แบบ Asynchronous ใน Parallel
Read Requests Processed โดย Replica ใดก็ได้ ให้ Better Read Scalability แต่หมายความว่า Read อาจ Return Stale Value จนกว่า Write Result สำหรับ Key เดียวกันจะถึง Backup Replica
Would be Easier Without Conflicts! (จะง่ายกว่านี้ถ้าไม่มี Conflicts!)
กรณี Cluster-wide Failure เช่น Network Partition อาจมี Multiple Leaders Elected สำหรับ Key เดียวกัน หมายถึง Multiple Replicas Accept Writes และ Data Diverge บน Replicas ต่างกัน อาจป้องกัน Conflicts ตั้งแต่ต้นด้วย Stronger Model ด้วย Protocols เช่น Calvin, Spanner (หรือ Paxos, Raft) แต่เป็น Path อื่นที่เราไม่ต้องการตอนนี้
แทนที่จะป้องกัน Global Database อนุญาตให้ Conflicts เกิดขึ้น และ Resolve ด้วย LWW (Last-Write-Wins) Algorithm ทำให้ Replicas Converge ไปสู่ State เดียวกัน Eventually ทุก Write ใน Upstash มี Unique Monotonic Sequence Number ทุกครั้งที่ Replica กลายเป็น Leader มัน Mark Sequence ของ Write แรกที่ Process เมื่อ Two Leader Replicas Discover Each Other พวกเขา Share Writes หลังจากกลายเป็น Leader และ Resolve Conflicts
Not All Replicas Are Equal (ไม่ใช่ทุก Replica เท่าเทียม)
บาง Replicas "เท่าเทียมกันมากกว่า" เพราะแค่บางตัวถูก Elect เป็น Leaders ใน Global Database Cluster Replica สามารถ Mark ว่า Learner ทำให้ unsuitable สำหรับ Leader Election Learner Replicas จะเป็น Read-only ตลอดและไม่เป็น Candidate สำหรับ Leadership
การเพิ่ม Learner Replicas ไม่ส่งผลต่อ Stability ของ Cluster และไม่ก่อให้เกิด Write Conflicts เมื่อ Split แม้ Split จาก Leader พวกเขายัง Allow Read Requests และ Sync Writes ที่เหลือหลัง Split Healed Learner Replicas เป็น Utility ที่ดีมากสำหรับขยาย Edge Locations เพิ่มเติม
More Regions, More Replicas? (Region มากขึ้น, Replicas มากขึ้น?)
ใน Initial Release เราเสนอ Global Database ด้วย 5 Replicas ใน 5 Regions Replicas นอก US และ EU ถูก Mark ว่า Learners ดังนั้นเฉพาะ Replicas ใน US และ EU Regions ที่สามารถ Elected เป็น Leaders ได้ นี่ลดโอกาส Write Conflicts ระหว่าง Network Partition แต่ยังอนุญาตให้เราเพิ่ม Regions เป็น Learner Replicas ได้โดยไม่กังวล Network Partitions
Still Way to Go (ยังมี路要เดิน)
ปัจจุบัน Global Databases ออกแบบเพื่อ Optimize/Minimize Read Operations Latency เท่านั้น ไม่เหมาะสำหรับ Write-heavy Loads เรากำลังปรับปรุง Write Latency ด้วย Design ที่ดีกว่า
นอกจาก Initial 5 Region Setup เรากำลังพิจารณาเปิด Regions เพิ่ม และ/หรือ Region Groups ต่างๆ ในอนาคต ตาม Demand และ Feedback จาก Users
ติดต่อเราได้ที่ Twitter และ Discord สำหรับความคิดเห็น/ไอเดีย และคำถาม
