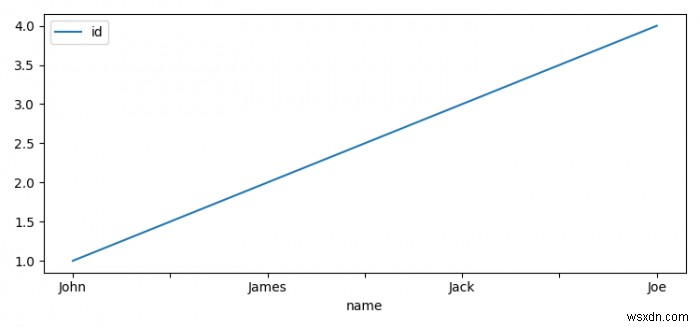
หากต้องการใช้ Matplotlib เพื่อพล็อตผลลัพธ์จาก PySpark SQL สามารถทำตามขั้นตอนต่อไปนี้:
- กำหนดขนาดรูปและปรับระยะห่างระหว่างและรอบซับพล็อต
- สร้างอินสแตนซ์ SparkContext ซึ่งเป็นจุดเริ่มต้นหลักของฟังก์ชัน Spark
- สร้างอินสแตนซ์ HiveContext ซึ่งเป็น Spark SQL ที่รวมกับข้อมูลที่จัดเก็บใน Hive
- สร้างรายการเรคคอร์ดเป็นทูเพิล
- กระจายคอลเลกชัน Python ในเครื่องเพื่อสร้าง RDD
- แมปเรคคอร์ดในรายการให้ตรงกับสกีมาฐานข้อมูล
- สร้างอินสแตนซ์สกีมาเพื่อลงทะเบียนตาราง "my_table"
- แทรกเรคคอร์ดลงในตาราง
- รันคิวรี SQL เพื่อดึงข้อมูล
- แปลงผลลัพธ์ที่ได้เป็น DataFrame ของ Pandas
- ตั้งค่าดัชนีด้วยแอตทริบิวต์ name และพล็อต
- ใช้เมธอด show() เพื่อแสดงรูป
ตัวอย่าง
from pyspark.sql import Row
from pyspark.sql import HiveContext
import pyspark
import matplotlib.pyplot as plt

plt.rcParams["figure.figsize"] = [7.50, 3.50]
plt.rcParams["figure.autolayout"] = True

sc = pyspark.SparkContext()
sqlContext = HiveContext(sc)

test_list = [(1, 'John'), (2, 'James'), (3, 'Jack'), (4, 'Joe')]
rdd = sc.parallelize(test_list)
people = rdd.map(lambda x: Row(id=int(x[0]), name=x[1]))
schemaPeople = sqlContext.createDataFrame(people)
sqlContext.registerDataFrameAsTable(schemaPeople, "my_table")

df = sqlContext.sql("Select * from my_table")
df = df.toPandas()
df.set_index('name').plot()
plt.show()
ผลลัพธ์