

เมื่อเร็วๆ นี้ การหาซอฟต์แวร์ Linux ที่เยี่ยม ใหม่ และเฉพาะตัว กลายเป็นงานยาก งานหนัก และเมื่อพูดถึง "เมื่อเร็วๆ นี้" ผมหมายถึง 4-5 ปีที่ผ่านมา ตั้งแต่ความกระตือรือร้นและนวัตกรรมในพื้นที่เดสก์ท็อปเริ่มลดลง สุดท้ายมีขีดจำกัดว่าจะมีสิ่งดีๆ อยู่ได้เท่าไหร่ในปริมาณสติปัญญาที่จำกัด แต่别忘了การเปลี่ยนโฟกัสผิดไปที่มือถือ และการพังทลายของฝัน "ปีของ Linux"
สิ่งนี้ทำให้การทดสอบซอฟต์แวร์อายุ 4 ปีชื่อ OCRFeeder น่าสนใจ คิดว่ามีเหตุผล 2 ข้อ ถ้ามันดี มันก็ดี สอง ผมสนใจความก้าวหน้าของการจดจำตัวอักษรด้วยแสง (OCR) และว่าเครื่องมือของเรา (อ่านว่า AI) ทำได้สมควรหรือไม่ ผมเขียนเรื่องนี้โดยละเอียดไปแล้ว และรีวิว YAGF ในปี 2015 ตอนนี้มาดู OCRFeeder และว่ามันทำอะไรได้บ้าง ตามมา นักรบ Linux กล้าหาญ
คำไม่ได้มาง่ายกับ jpg
ติดตั้งโปรแกรม มีไลบรารีที่ต้องดึงมาค่อนข้างเยอะ ใน Ubuntu 18.04 รายการยาวหลายบรรทัด คุณได้เครื่องยนต์ OCR Tesseract เป็นชุดเริ่มต้นสำหรับโปรแกรมนี้
blt gir1.2-goocanvas-2.0 gir1.2-gtkspell3-3.0 libgoocanvas-2.0-9 libgoocanvas-2.0-common libgtkspell3-3-0 liblept5 libtesseract4 libyelp0 python-bs4 python-chardet python-enchant python-html5lib python-lxml python-numpy python-olefile python-pil python-renderpm python-reportlab python-reportlab-accel python-sane python-tk python-webencodings tesseract-ocr tesseract-ocr-eng tesseract-ocr-osd tk8.6-blt2.5 unpaper yelp yelp-xsl
Suggested packages:
blt-demo python-gobject python-wxgtk3.0 python-genshi python-lxml-dbg python-lxml-doc gfortran python-dev python-nose python-numpy-dbg python-numpy-doc python-pil-doc python-pil-dbg python-renderpm-dbg python-egenix-mxtexttools python-reportlab-doc python-sane-dbg tix python-tk-dbg
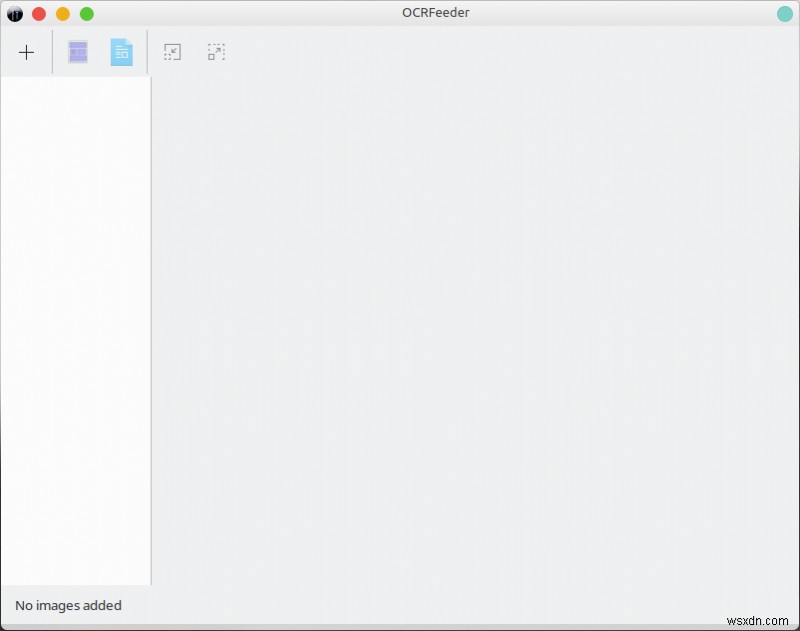
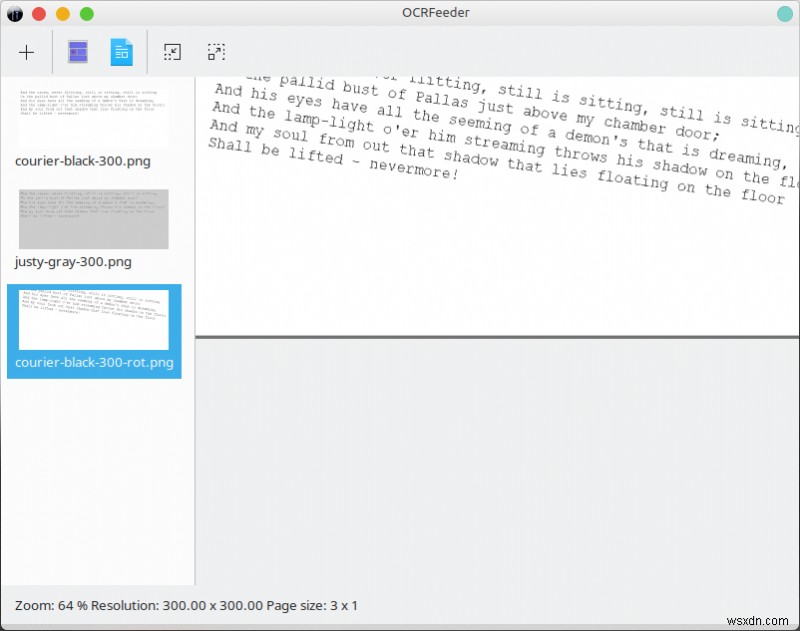
เปิดโปรแกรม อินเทอร์เฟซค่อนข้าง utilitarian คุณต้องโหลดภาพขึ้นมาหนึ่งหรือหลายภาพ ก่อนจะนำไปให้เครื่องยนต์ OCR ประมวลผล และหวังว่าจะได้ข้อความที่แม่นยำทางด้านอื่น เมื่อเสร็จแล้ว คุณสามารถส่งออกข้อความไปยัง LibreOffice ได้
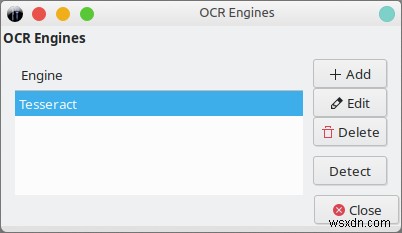
เครื่องยนต์ OCR
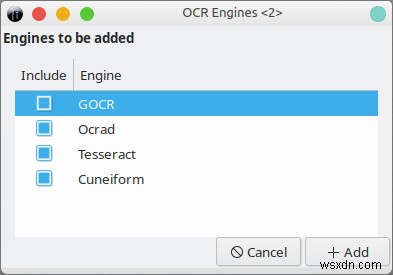
какกล่าวไว้ โดยค่าเริ่มต้น OCRFeeder จะใช้ Tesseract แต่คุณสามารถเพิ่มเครื่องยนต์อื่นๆ ได้ ผมลอง CuneiForm, GOCR และ Ocrad โปรแกรมตรวจจับและโหลดทั้งหมดได้ถูกต้อง น่าสนใจมาก ให้คุณลองเอกสารหลายวิธี เพราะอาจโชคดีกับเครื่องยนต์บางตัว
การแปลงภาพเป็นข้อความ
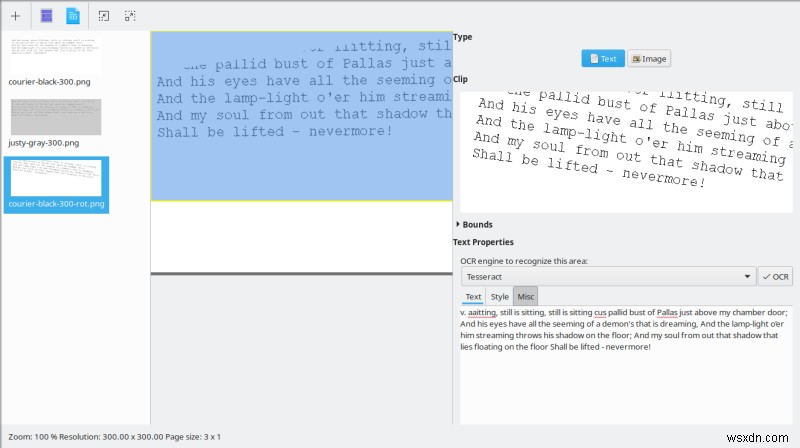
ตอนนี้ส่วนสำคัญ ผมติดปัญหานิดหน่อย ให้โปรแกรมตรวจจับข้อความอัตโนมัติ (recognize all pages) ในภาพที่มีทั้งหมด และได้เอาต์พุตที่มีสีแปลกๆ เรื่องนี้ใช้เวลาประมาณ 3 นาทีสำหรับไฟล์ PNG 3 ไฟล์ และในช่วงนั้น CPU ของ OCRFeeder ประมาณ 17% และ Tesseract ประมาณ 4-5% เวลาสามารถลดลงได้ถ้าแอปพลิเคชันใช้งานโปรเซสเซอร์ทุกโคร์ได้ดีกว่านี้ แล้วเอาต์พุตแปลกๆ ผมไม่แน่ใจว่าทำต่อยังไง แปลกมาก ดูเหมือนไม่ได้ก้าวหน้าเลย
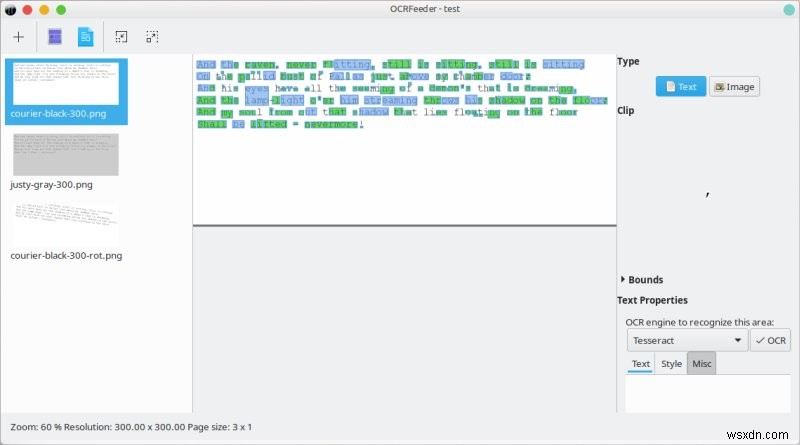
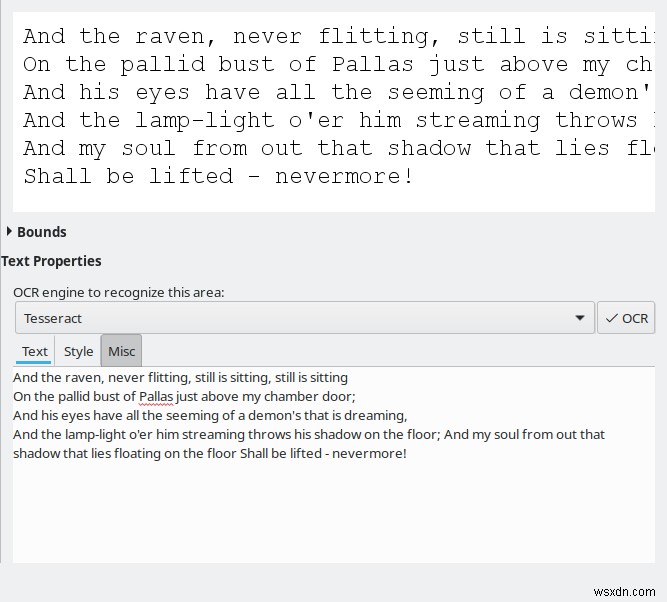
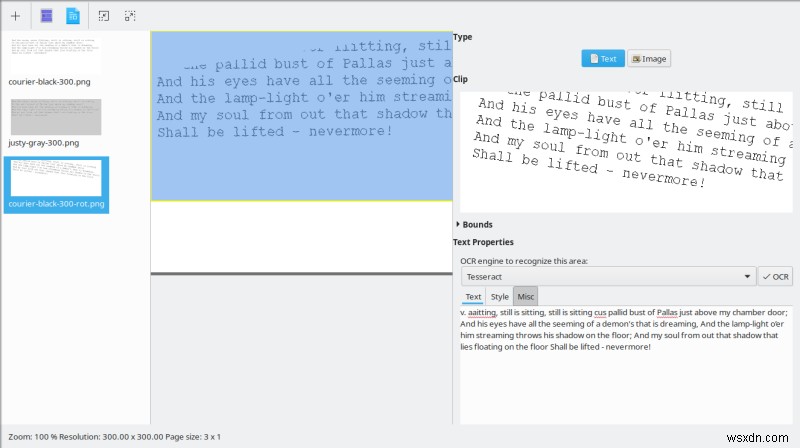
แล้วผมตระหนักว่าสามารถใช้เมาส์ลากเลือกส่วนของภาพที่แสดงได้ และจะมีหน้าต่างแยกเปิดขึ้น ให้เลือกเครื่องยนต์ OCR ที่ต้องการ และรันการแปลงจริง เลยปัญหาแสดงผล ทำงานได้ค่อนข้างดี และใช้เวลาไม่กี่วินาทีต่อภาพ
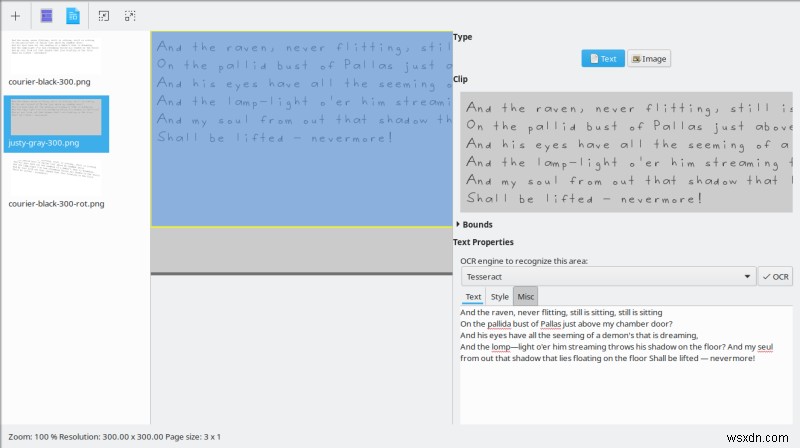
โดยไม่มีการฝึกหรือเปลี่ยนค่าเริ่มต้น ผลลัพธ์ที่แตกต่างกันระหว่างเครื่องยนต์ 4 ตัวมีความแตกต่างมาก Tesseract ให้ผลดีที่สุด - และเป็นตัวเดียวที่ยอมรับได้ ส่วนอื่นๆ ไม่พอใช้เลย ไม่แน่ใจว่าทำไม แค่เป็นแบบนั้น
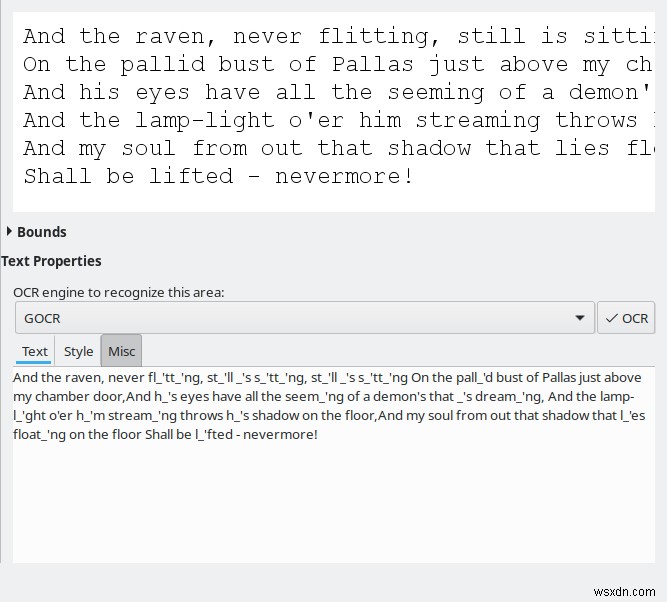
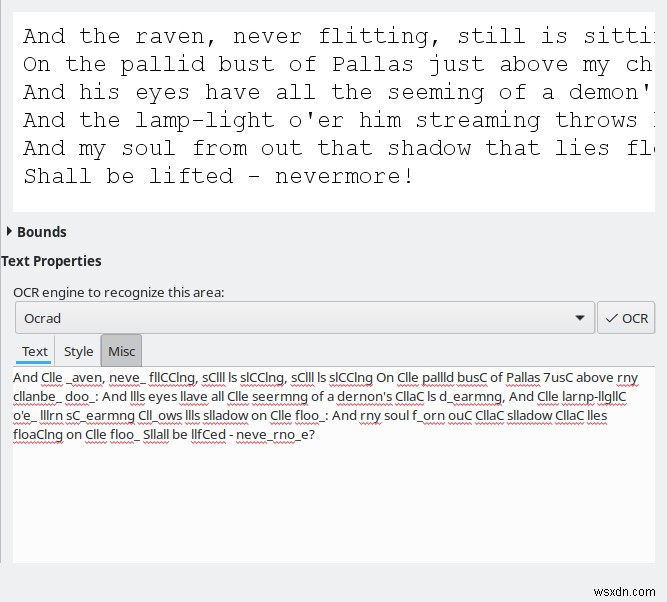
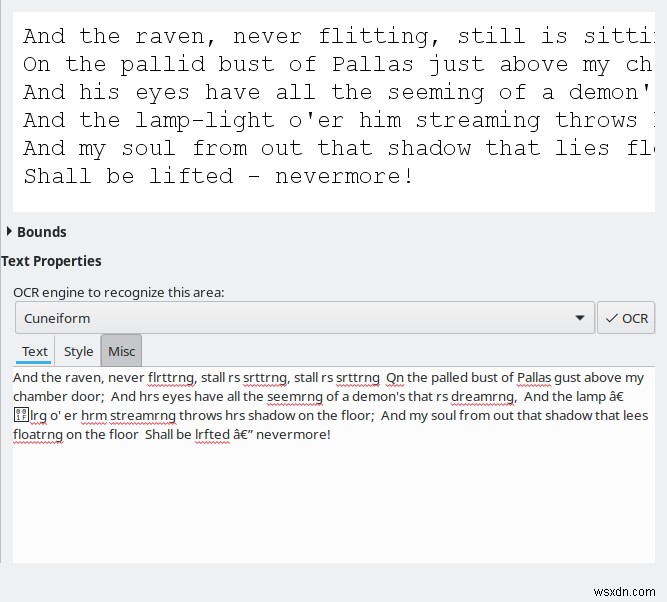
ผมยังสังเกตว่าภาพพื้นหลังสีเทาให้ผลดีกว่า ในอดีต Tesseract ติดปัญหา ดังนั้นการปรับปรุงที่เข้าไปในเครื่องยนต์นี้ ยินดีตอนรับ แต่นี่ไม่ได้เป็นเรื่องของ OCRFeeder โดยตรง คุณสามารถรัน Tesseract เองจากบรรทัดคำสั่งได้หากต้องการ
การแก้ไขภาพเอียงและเอากระดาษออก
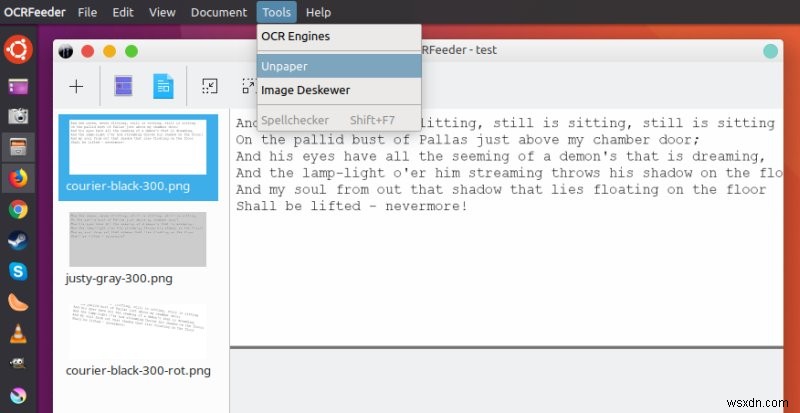
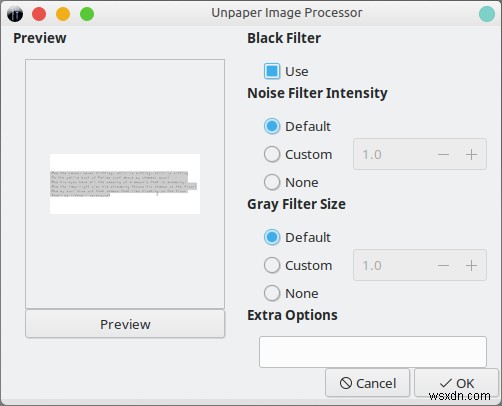
OCRFeeder มาพร้อม 2 ฟังก์ชันน่าสนใจ - ความพยายามหมุนข้อความในภาพสแกนที่เอียงอัตโนมัติ และความสามารถในการเอาพื้นหลังกระดาษออกเพื่อลด noise และให้การแปลงแม่นยำขึ้น ผมลองทั้งสอง Deskew ทำงานได้ดี Unpaper พอใช้ แต่หลังจากหมุนข้อความแล้ว (ซึ่งผมทำใน GIMP ในภาพควบคุมเมื่อก่อน) ผลการแปลงดีขึ้นอีก
ส่งออกเป็น ODT
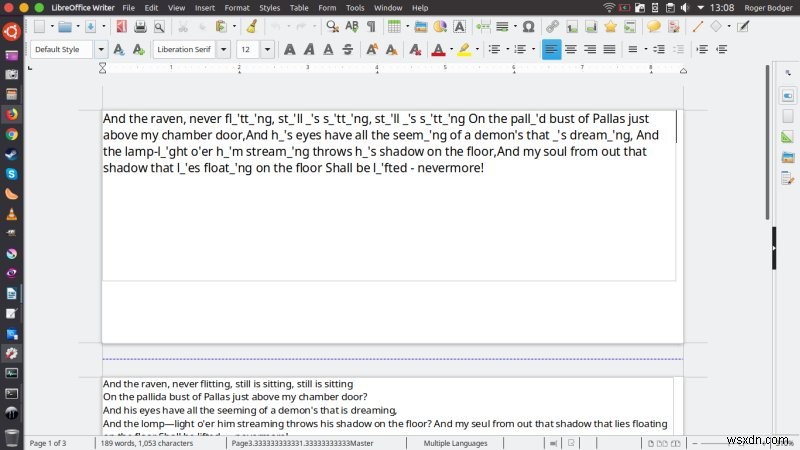
ส่วนนี้ค่อนข้าง tricky ผมลองหลายครั้ง และเจอข้อผิดพลาดหลายอย่าง สุดท้ายทำงานได้ เอาต์พุตไม่ได้สวยงาม แต่จุดดีคือ สามารถส่งออกการแปลงหลายครั้งพร้อมกันได้ รวมถึงใช้เครื่องยนต์ต่างกันสำหรับภาพต่างๆ น่าสนใจดี
การตั้งค่า
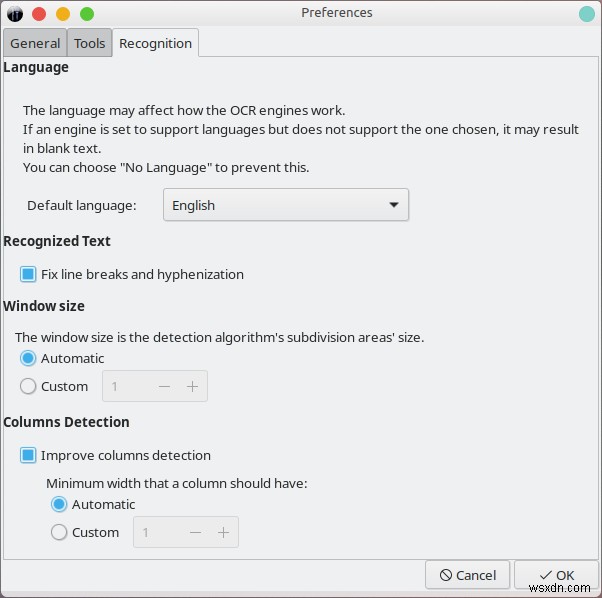
สุดท้าย คุณมีตัวเลือกเปลี่ยนพฤติกรรมของโปรแกรม ไม่มีอะไรใหญ่โต แต่ช่วยได้กับการตรวจจับและความแม่นยำ ส่วนใหญ่เกี่ยวกับการตรวจจับความกว้างคอลัมน์ข้อความ ขอบเขต การเลือกภาษา และคล้ายๆ กัน สำหรับคนส่วนใหญ่ ค่าเริ่มต้นจะเป็นจุดเริ่มต้นที่สมเหตุสมผล
สรุป
OCRFeeder เป็นซอฟต์แวร์ที่สมเหตุสมผลและยืดหยุ่น ใช้เครื่องยนต์หลายตัวได้ และอัลกอริทึมแก้ไขภาพเป็นการเพิ่มที่ดี ทำให้ OCRFeeder น่าจะเป็นซอฟต์แวร์ประเภทนี้ที่มีศักยภาพมากที่สุดในตลาดฟรี แต่ความหวังของคุณต้องพังทันที เพราะไม่น่าจะมีอัปเดตเร็วๆ นี้ เว้นใครมารับมือเพราะมีตลาดที่จะได้แต่โลก Linux ติดอยู่ในตำแหน่งยากระหว่างความเหนื่อยล้าและความไม่มากกว่า
เรื่องอายุและอัปเดตไปก่อน สำหรับส่วนใหญ่ OCRFeeder ส่งมอบ คุณภาพการแปลงไม่แย่ คุณไม่สูญเสียอะไรจากการใช้ UI ทำงาน และฟังก์ชันส่งออกให้สร้างเอกสารที่ดีสำหรับการแก้ไขต่อไป ผมยินดีกับการปรับปรุงของ Tesseract ดังนั้นถ้าคุณมีภาพที่มีข้อความเยอะ และอยากลองแปลงข้อความมือเขียนบนแบบฟอร์มโบราณให้กลายเป็นสิ่งทันสมัยและใช้งานได้ คุณสามารถทำได้ OCRFeeder รองรับ PDF และอ่านจากสแกนเนอร์โดยตรง คุ้มค่าที่จะทดลอง ตอนนี้ไปต่อแล้ว ลาก่อน
ขอให้สนุกกับการทำงาน!
