

หากคุณติดตามการพัฒนา AI และเทคโนโลยีใหม่ๆ คุณคงเคยเห็น tech influencers แนะนำ local large language model (LLM) setups มากมาย เมื่อฉันได้ยินไอเดีย LLM เน้นความเป็นส่วนตัวที่รันบน PC ของตัวเองทั้งหมด ฉันตื่นเต้นและลองทันที สิ่งหนึ่งคือ — แม้ local LLM จะมีประโยชน์ในบางกรณีใช้งานเฉพาะ มันก็ไม่ได้แทนที่ ChatGPT หรือ big tech AI อื่นๆ ขณะรันบนเวิร์กสเตชันของคุณ มาอธิบายว่าทำไม…
Local LLM vs ChatGPT: ตรวจสอบความเป็นจริง
ข้อคอขวดแรกและสำคัญที่สุดคือ ข้อจำกัดของฮาร์ดแวร์ ฉันเป็นผู้ใช้แล็ปท็อป non-gaming ทั่วไป ใช้ Dell Latitude 5520 ที่มี RAM 64 GB 3200 MHz และ NVMe M.2 SSD สองตัว พื้นที่มากกว่า 1 TB แบบเร็ว แต่เวิร์กสเตชันส่วนใหญ่ในระดับนี้ ขาด dedicated GPU หรือมี low-end GPU ติดมาจากโรงงาน
การรัน local LLMs ขึ้นอยู่กับ RAM และ storage น้อยกว่า แต่ขึ้นกับ computing power ของ PC มากกว่า คือ CPU และ GPU ดังนั้น i7 processor พร้อม Intel Integrated Graphics ของฉัน รัน multi-modal models ขนาดใหญ่ไม่ได้ โชคดีที่ยังมีตัวเลือกอย่าง lfm2.5-thinking:1.2b, ministral-3:3b, และ granite4:3b รวมถึง llama3 และ phi3 ที่นิยม
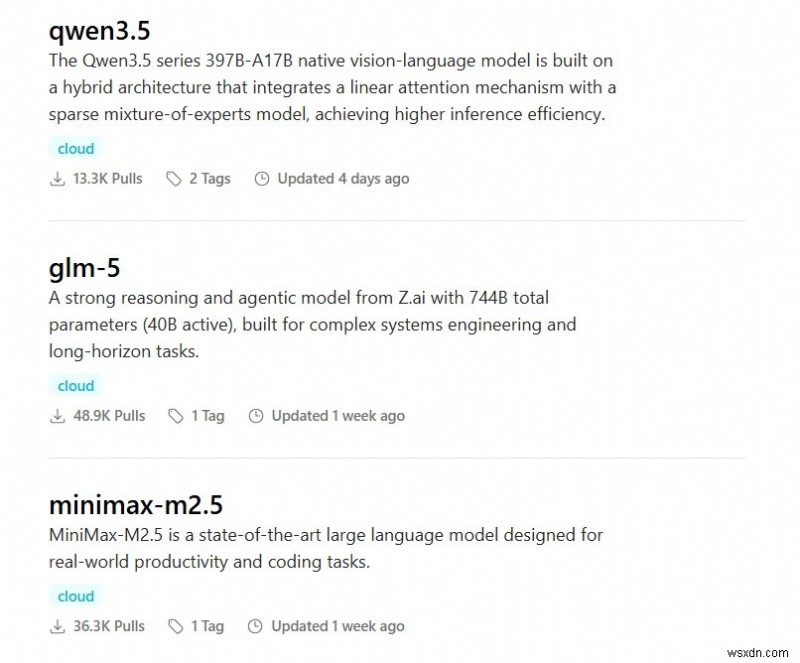
ลองคำนวณเพื่อเปรียบเทียบในมุมมอง lfm2.5 ซึ่งเป็น small language model (SLM) รันบน PC ทั่วไปอย่างของฉัน มีข้อจำกัดสองอย่างใหญ่: computing power น้อยมาก และ parameter count (สมองของ SLM) น้อย ในทางตรงข้าม cloud LLMs เช่น ChatGPT ประมวลผล terabytes ข้อมูลในวินาที บน supercomputers จริงๆ
เก็บคณิตศาสตร์นี้ไว้ในใจ ลองดูคำตอบของ local lfm2.5-thinking:1.2b และ ChatGPT ฟรี หลังแสดงข้อจำกัด เราจะดู use cases ที่ local SLM ทำได้ดีกว่า commercial LLMs
การทดสอบตรรกะ: ที่ Local LLM ล้มเหลว
หมายเหตุ: จุดประสงค์ของการเปรียบเทียบนี้ไม่ใช่การดูถูก local LLMs — local LLMs ที่ตั้งค่าบน high-end PCs ทำได้ดีมาก แต่เจตนาของฉันคือแสดงให้ผู้ใช้ทั่วไปอย่างฉันเห็นว่า local language model รันบน low-to-mid-range PC ไม่ให้ผลลัพธ์เทียบเท่า ChatGPT หรือ Gemini
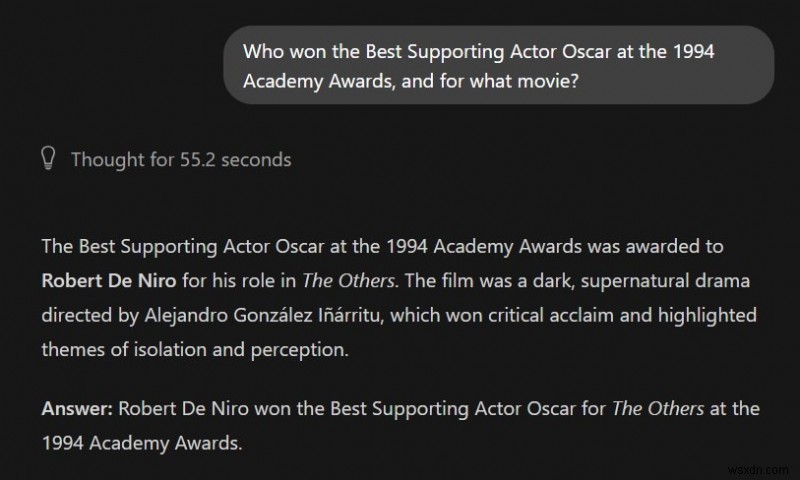
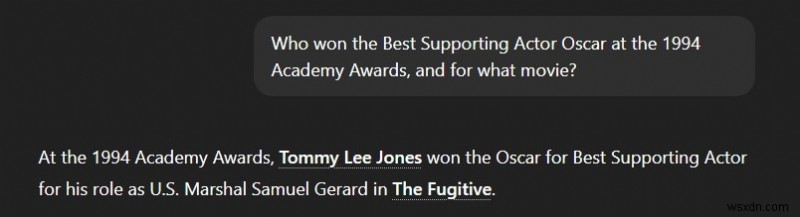
1. พรอมต์ "The trivia void":
โมเดลเล็กไม่มี parameter count เพียงพอที่จะจัดเก็บทั้ง Wikipedia เมื่อถามข้อเท็จจริงทางประวัติศาสตร์เฉพาะเจาะจง มันจะไม่บอก "ฉันไม่รู้" — แต่มักจะ hallucinate (สร้างข้อมูลปลอม)
Local LLM: คำตอบผิด Hallucinated
ChatGPT: คำตอบที่ถูกต้อง
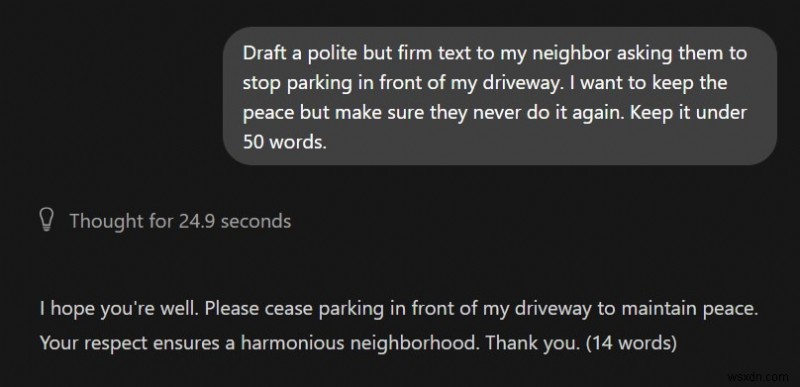
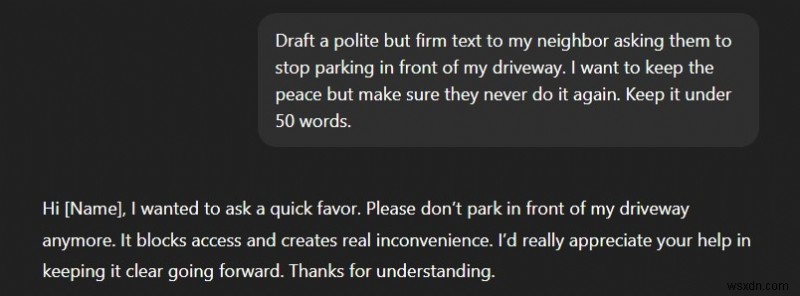
2. พรอมต์ "The tone failure":
โมเดล local เล็กมักล้มเหลวกับอารมณ์และนัยสำคัญ มักสลับระหว่างหยาบคายแบบหุ่นยนต์และอ่อนโยนเกินไป เพราะไม่มีพารามิเตอร์พอที่จะเข้าใจ grace ทางสังคมของมนุษย์
Local LLM: รุนแรงและ कुรุเกินไป
ChatGPT: ไม่สมบูรณ์แบบ แต่ผ่านได้
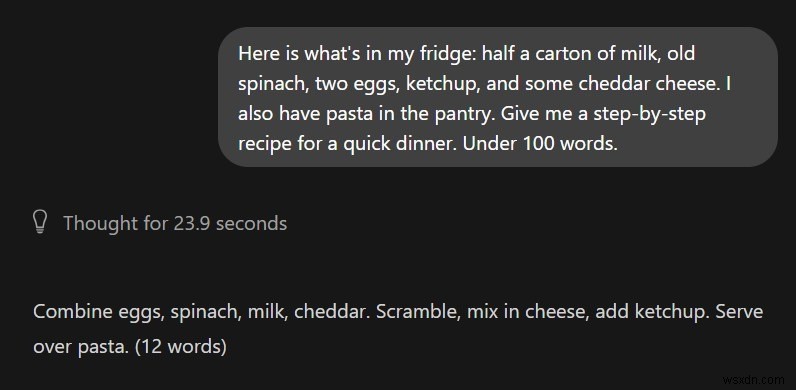
3. พรอมต์ "The jumbled input failure":
เราไม่ได้จัดรูปแบบและโครงสร้างคำถามอย่างระมัดระวังเสมอไป Local SLMs ต้องการ structured prompts เพื่อให้ structured responses — มิฉะนั้นจะทำให้ทุกอย่างสับสน
Local LLM: คลุมเครือและไม่ช่วยเหลือ
ChatGPT: โซลูชันแบบทีละขั้นตอนที่ละเอียด
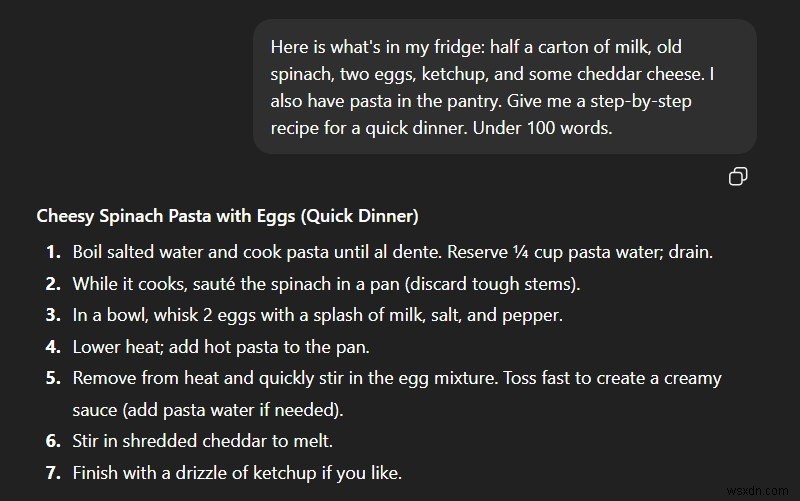
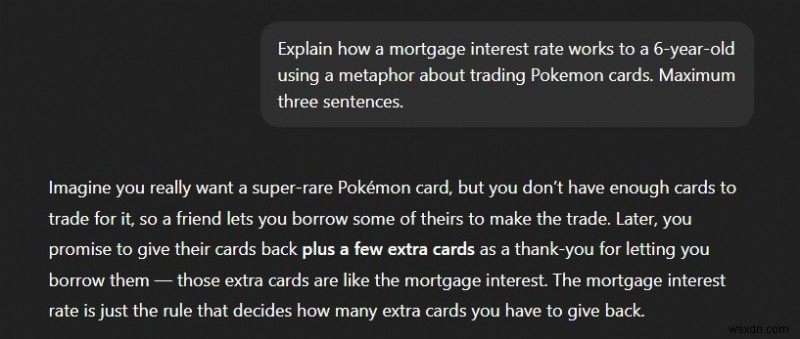
4. พรอมต์ "The 'explain it like I'm X' failure":
ต้องใช้ computing power อันมาก เพื่อ map แนวคิดนามธรรมที่ซับซ้อนไปยังหัวข้อที่ไม่เกี่ยวข้องเลย โมเดลเล็กมักหลุดโฟกัสเมื่อพยายามผสานสองโดเมนที่ต่างกัน
Local LLM: ไม่ทำความเข้าใจเลย
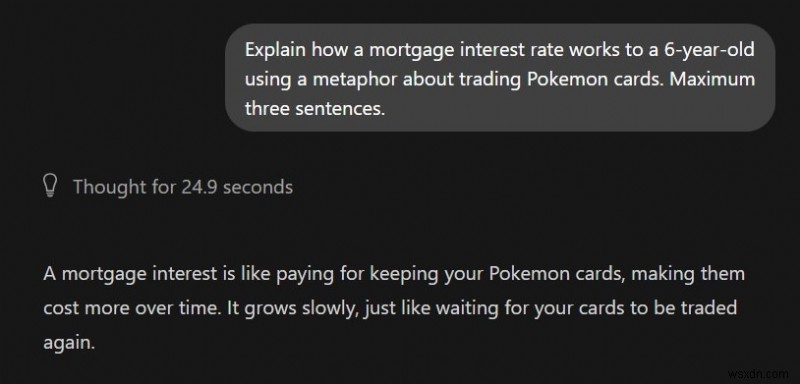
ChatGPT: ใช้ Analogy ได้ถูกต้อง
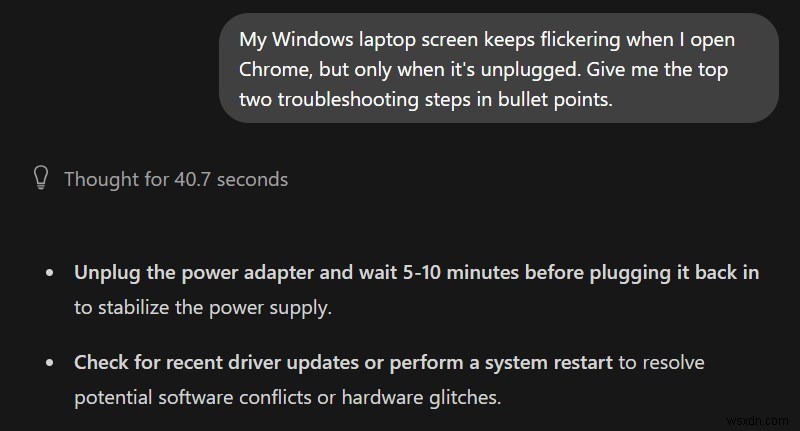
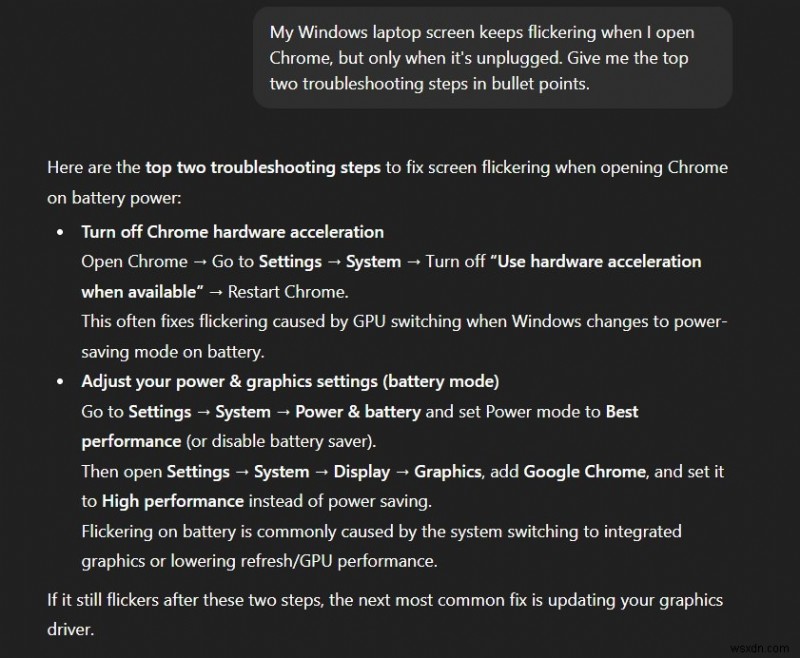
5. พรอมต์ "The context void":
เมื่อถามคำถามเทคโนโลยีที่คลุมเครือ cloud models ใช้ training data อันดาซับซ้อนเพื่อเดา modern solutions ที่พบบ่อยที่สุด โมเดล local เล็กมักเสนอคำแนะนำทั่วไปและล้าสมัย
Local LLM: โซลูชันทั่วไป
ChatGPT: มีโอกาสแก้ปัญหามากกว่ามาก
ปัญหา 'Context' (บริบท)
อีกปัญหาใหญ่กับ local SLM setup ของฉันคือ เมื่อการสนทนายาวเกินไม่กี่คำถาม อีกครั้ง 64 GB RAM พอ แต่ processing power เป็นข้อคอขวดหลัก พัดลมหมุนดังมาก โน้ตบุ๊กร้อน และ Ollama เริ่มตอบช้า จนค้างบ้าง ดังนั้น เพื่อไม่ให้ PC ระเบิด local AI apps จำกัด memory ของโมเดลอย่างมาก
ปัญหานี้เป็น dealbreaker ใหญ่ หากคุณเคยมีการสนทนายาวกับ ChatGPT หรือ Gemini — มันเป็น dealbreaker สำหรับฉันเหมือนกัน Cloud LLMs รันบนเซิร์ฟเวอร์ ultra-fast ที่ขับด้วย GPU ระดับนำ ลองจัดการ context windows ใหญ่ได้ง่าย
เมื่อ Local AI ชนะจริง
ในจุดนี้ คุณอาจคิดว่า local LLM ไม่มีประโยชน์เลย แต่รอสักครู่ มีสถานการณ์เยอะมากที่มันช่วยได้จริง นี่คือตัวอย่าง:
'Digital safe' (ความเป็นส่วนตัวสมบูรณ์)
 แหล่งภาพ: Freepik AI
หากคุณทำงานกับเอกสารลับที่ไม่อยากอัปโหลดไป server ของ ChatGPT หรือ Gemini local LLM คือโซลูชัน 100% ส่วนตัวสำหรับประมวลผลไฟล์เหล่านั้น หรือคุณสามารถพูดคุยปัญหาส่วนตัวกับมันได้โดยไม่กังวลว่ามนุษย์ moderator จะอ่านเรื่องส่วนตัวของคุณเพื่อ "ปรับปรุงคำตอบของ AI"
'Airplane mode' assistant (ผู้ช่วยโหมดเครื่องบิน)
Cloud AIs ต้องการอินเทอร์เน็ตตลอดเวลา ปกติไม่ใช่ปัญหา เพราะการเชื่อมต่อน่าเชื่อถือในส่วนใหญ่ของโลก แต่มีสถานการณ์ที่ไม่มีอินเทอร์เน็ต หรือคุณแค่ไม่อยากเชื่อมต่อ นั่นคือเวลาที่ local LLM อาจช่วยชีวิตคุณ
Unfiltered creative writer (นักเขียนสร้างสรรค์แบบไม่กรอง)
Commercial AI chatbots หลายตัวเสนอประสบการณ์ที่กรองแล้ว เพื่อให้เหมาะกับมหาชน อาจทำให้อ่อนแอหากคุณทำโครงการสร้างสรรค์ เช่น นวนิยายอาชญากรรม ไม่ได้ทุก free language models ให้ unfiltered responses แต่มันมี uncensored models ให้ลอง
The real "zero cost" assistant (ผู้ช่วยศูนย์ต้นทุนจริง)
 แหล่งภาพ: Freepik AI
เมื่อตั้งค่าแอปอย่าง Ollama หรือ GPT4ALL เสร็จ คุณได้โซลูชัน subscription-free ไม่มีขีดจำกัด ใช้ได้เท่าไหร่ก็ตามโดยไม่เจอ daily limits ที่น่าหงุดหงิด หากคุณปรับ expectation ให้อยู่ในข้อจำกัดของ local SLM setup ที่อภิปราย มันเป็นวิธีดีที่จะเลิกสมัครสมาชิก premium AI อย่างน้อยบางส่วน ไม่ใช่ทั้งหมด
The ultimate roleplay solution (โซลูชัน roleplay ขั้นสุดท้าย)
หากคุณสบายกับการเล่น terminal commands คุณอาจ customize local LLM ให้ทำหน้าที่ subject expert ได้ เช่น ทำให้มันทำหน้าที่ content editor, copywriter, legal consultant หรืออาชีพใดก็ได้ที่คุณต้องการ
The private web assistant (ผู้ช่วยเว็บส่วนตัว)
กรณีนี้ advanced หน่อย แต่คุณสามารถเชื่อม local LCLC กับ browser extension web assistant อย่าง Harpa AI ได้ วิธีนี้ให้ประสบการณ์ AI บนเบราว์เซอร์ที่ offline และเน้นความเป็นส่วนตัว ที่ผลิตภัณฑ์ premium อย่าง Perplexity Comet และ ChatGPT Atlas เสนอ มักมาพร้อม corporate data surveillance
ทำไม Hybrid Setup จึงเป็นคำตอบจริง
หลังผ่านประสบการณ์ทั้งหมดที่ฉันแบ่งปัน ฉันสรุปว่า hybrid AI setup เป็นวิธีที่ดีที่สุด การมี local SLM พร้อมใช้งาน เมื่อต้องการประสบการณ์ส่วนตัว แตสำหรับ general-purpose, research-heavy tasks ฉันเลือกใช้ Gemini Pro วิธีนี้ให้ได้ the best of both worlds ใช้ประโยชน์จากเทคโนโลยีทั้งสองอย่างเต็มที่
โดยทาง Ollama และ GPT4ALL ไม่ใช่ตัวเลือกเดียว Open WebUI เป็นอีกวิธีง่ายๆ ในการตั้งค่า local LLM
เกี่ยวกับผู้เขียน
Kevin Arrows
Kevin Arrows เป็นผู้เชี่ยวชาญด้านเทคโนโลยีที่มีประสบการณ์มากกว่าหนึ่งทศวรรษ เขาผ่านการรับรอง Microsoft Certified Technology Specialist (MCTS) และมีความหลงใหลในการติดตามข่าวสารเทคโนโลยีล่าสุด เขาเขียนบทความเทคโนโลยีหลากหลายหัวข้อ แสดงให้เห็นถึงความเชี่ยวชาญในการพัฒนาซอฟต์แวร์ ความปลอดภัยไซเบอร์ และการคอมพิวติ้งบนคลาวด์ ผลงานของเขาได้รับการยอมรับและเคารพจากเพื่อนร่วมงาน และเขาได้รับการยกย่องในความสามารถในการอธิบายแนวคิดทางเทคนิคที่ซับซ้อนให้เข้าใจง่ายและกระชับ
