

ยินดีต้อนรับสู่ภาคต่อของชุดบทเรียนสร้าง web scraper ในบทนี้จะแนะนำตัวอย่างการ scrape ข้อมูลจากเว็บพอดแคสต์ของผม จะอธิบายรายละเอียดการดึงข้อมูล วิธีการทำงานของ helper และ utility methods และการรวมชิ้นส่วนทั้งหมด
หัวข้อ
- Scraping My Podcast
- Pry
- Scraper
- Helper Methods
- Writing Posts
Scraping My Podcast
นำสิ่งที่เรียนรู้ไปปฏิบัติจริง พอดแคสต์ Between | Screens ของผมต้อง redesign ด่วน มีปัญหาทำให้ตื่นนอนไม่หลับ จึงตัดสินใจสร้าง static site ใหม่ด้วย Middleman โฮสต์บน GitHub Pages
ใช้เวลาพอสมควรปรับ дизайн หลังปรับ Middleman blog ให้เข้ากับความต้องการ เหลือแค่นำเข้าเนื้อหาจาก Sinatra app ที่เก็บใน database จึงต้อง scrape เนื้อหาเดิมมาใส่ใน static site ใหม่
ทำมือไม่ได้เลย — ใช้เพื่อนสนิท Nokogiri และ Mechanize ช่วยงาน 것이ดีกว่า งาน scrape นี้เล็ก ไม่อยุ่งยาก แต่มีรายละเอียดน่าสนใจสำหรับมือใหม่
นี่คือสกรีนชอตจากพอดแคสต์เก่าและใหม่
Screenshot Old Podcast
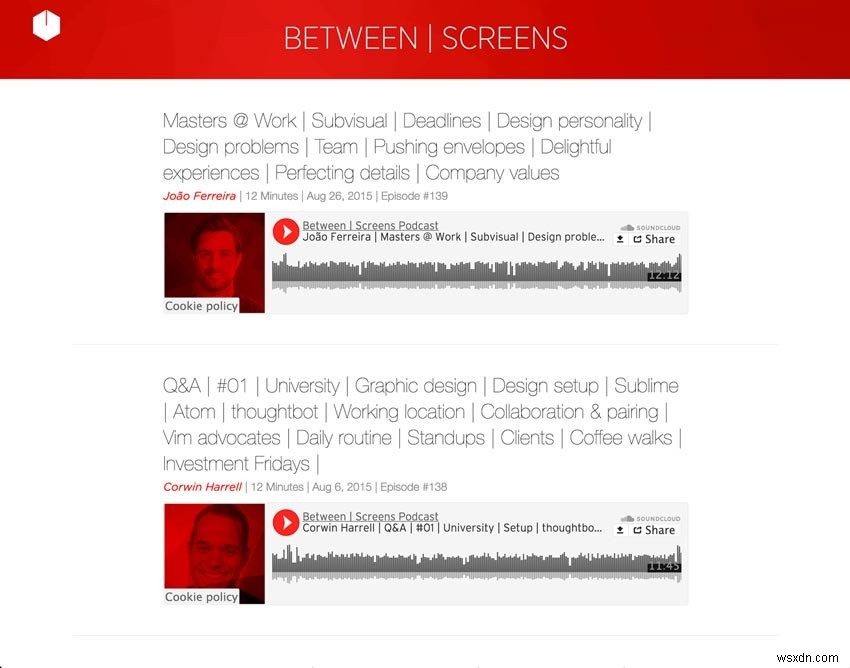
Screenshot New Podcast
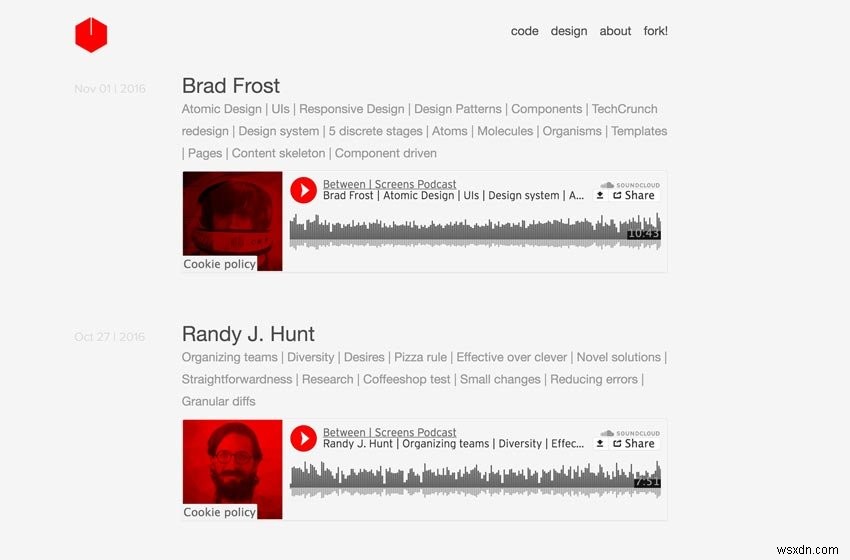
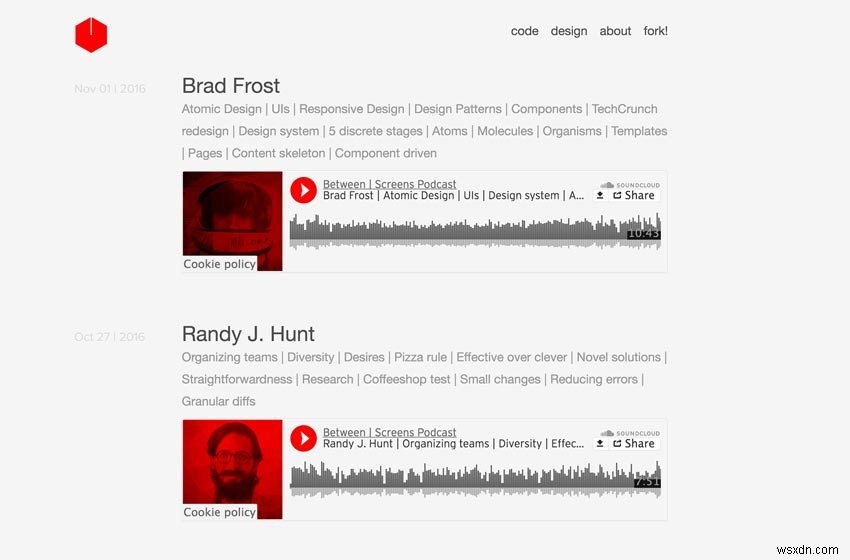
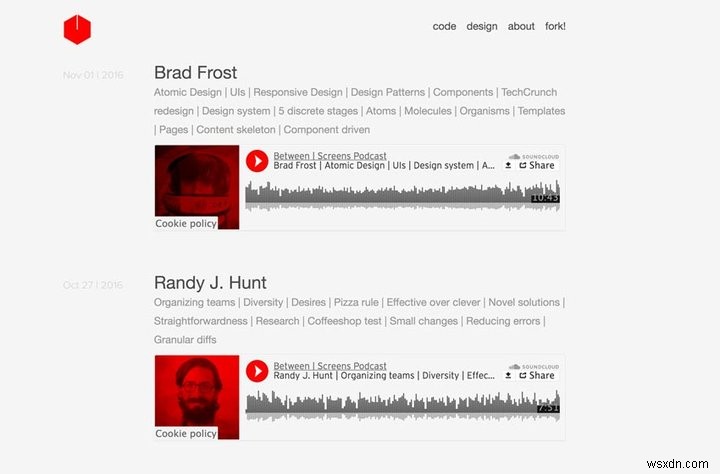
มาแบ่งงานที่ต้องทำ: ต้องดึงข้อมูลต่อไปนี้จาก 139 ตอน ที่กระจายอยู่ใน 21 หน้า index แบบ pagination:
- ชื่อตอน (title)
- ผู้สัมภาษณ์ (interviewee)
- หัวข้อย่อย/รายการหัวข้อ (subheader with topic list)
- เลขทрек SoundCloud (SoundCloud track number)
- วันที่ (date)
- หมายเลขตอน (episode number)
- ข้อความจาก show notes
- ลิงก์จาก show notes
วนลูปผ่าน pagination ให้ Mechanize คลิกลิงก์แต่ละตอน ในหน้ารายละเอียดจะมีข้อมูลทั้งหมด ใช้ข้อมูลที่ scrape ได้ เติมใน front matter และ "body" ของไฟล์ markdown แต่ละตอน
ด้านล่างคือตัวอย่างการ compose markdown ไฟล์ใหม่ นี่คือขั้นตอนสุดท้ายของสคริปต์
def compose_markdown
def compose_markdown(options={})
  <<-HEREDOC
---
title: #{options[:interviewee]}
interviewee: #{options[:interviewee]}
topic_list: #{options[:title]}
tags: #{options[:tags]}
soundcloud_id: #{options[:sc_id]}
date: #{options[:date]}
episode_number: #{options[:episode_number]}
---
#{options[:text]}
HEREDOC
end
อยากเพิ่มฟีเจอร์ที่เว็บเก่าไม่มี: ระบบ tagging ครบครันสำคัญมาก อยากให้ผู้ฟังมีเครื่องมือค้นพบลึก ต้องมี tags สำหรับแต่ละผู้สัมภาษณ์ และแยก subheader เป็น tags ด้วย ผลิต 139 ตอนในซีซั่นแรก ต้องเตรียมพร้อมสำหรับปริมาณเนื้อหาใหญ่ ระบบ tagging ลึกกับ recommendations ใส่ใจทำให้เว็บเบาและเร็ว
มาดูโค้ดเต็มสำหรับ scrape เนื้อหาเว็บผม ลองอ่านภาพรวม ผมหลีกเลี่ยง abstraction มากเกินไป เน้นความชัดเจน ทำ refactor บ้างเพื่อความเข้าใจง่าย แต่ทิ้งบางส่วนไว้ให้ลองปรับปรุงเอง การเรียนรู้คุณภาพมาจากการลงมือทำจริง
ผมแยก methods เยอะแล้วเป็น helpers เล็กๆ เหมาะกับการ apply knowledge จากบทความก่อนหน้าเกี่ยว code smells และ refactoring ถ้ายังเข้าใจยาก กังวลไม่ต้อง เราทุกคนผ่านมาแล้ว ลองทำต่อไปจะคล่องขึ้น
Full Code
require 'Mechanize'
require 'Pry'
require 'date'

# Helper Methods
# (Extraction Methods)
def extract_interviewee(detail_page)
  interviewee_selector = '.episode_sub_title span'
  detail_page.search(interviewee_selector).text.strip
end

def extract_title(detail_page)
  title_selector = ".episode_title"
  detail_page.search(title_selector).text.gsub(/[?#]/, '')
end

def extract_soundcloud_id(detail_page)
  sc = detail_page.iframes_with(href: /soundcloud.com/).to_s
  sc.scan(/\d{3,}/).first
end

def extract_shownotes_text(detail_page)
  shownote_selector = "#shownote_container > p"
  detail_page.search(shownote_selector)
end

def extract_subtitle(detail_page)
  subheader_selector = ".episode_sub_title"
  detail_page.search(subheader_selector).text
end

def extract_episode_number(episode_subtitle)
  number = /[#]\d*/.match(episode_subtitle)
  clean_episode_number(number)
end

# (Utility Methods)
def clean_date(episode_subtitle)
  string_date = /[^|]*([,])(.....)/.match(episode_subtitle).to_s
  Date.parse(string_date)
end

def build_tags(title, interviewee)
  extracted_tags = strip_pipes(title)
  "#{interviewee}"+ ", #{extracted_tags}"
end

def strip_pipes(text)
  tags = text.tr('|', ',')
  tags = tags.gsub(/[@?#&]/, '')
  tags.gsub(/[w\/]{2}/, 'with')
end

def clean_episode_number(number)
  number.to_s.tr('#', '')
end

def dasherize(text)
  text.lstrip.rstrip.tr(' ', '-')
end

def extract_data(detail_page)
  interviewee = extract_interviewee(detail_page)
  title = extract_title(detail_page)
  sc_id = extract_soundcloud_id(detail_page)
  text = extract_shownotes_text(detail_page)
  episode_subtitle = extract_subtitle(detail_page)
  episode_number = extract_episode_number(episode_subtitle)
  date = clean_date(episode_subtitle)
  tags = build_tags(title, interviewee)
  options = {
    interviewee: interviewee,
    title: title,
    sc_id: sc_id,
    text: text,
    tags: tags,
    date: date,
    episode_number: episode_number
  }
end

def compose_markdown(options={})
  <<-HEREDOC
---
title: #{options[:interviewee]}
interviewee: #{options[:interviewee]}
topic_list: #{options[:title]}
tags: #{options[:tags]}
soundcloud_id: #{options[:sc_id]}
date: #{options[:date]}
episode_number: #{options[:episode_number]}
---
#{options[:text]}
HEREDOC
end

def write_page(link)
  detail_page = link.click
  extracted_data = extract_data(detail_page)
  markdown_text = compose_markdown(extracted_data)
  date = extracted_data[:date]
  interviewee = extracted_data[:interviewee]
  episode_number = extracted_data[:episode_number]
  File.open("#{date}-#{dasherize(interviewee)}-#{episode_number}.html.erb.md", 'w') { |file| file.write(markdown_text) }
end

def scrape
  link_range = 1
  agent ||= Mechanize.new
  until link_range == 21
    page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
    link_range += 1
    page.links[2..8].map do |link|
      write_page(link)
    end
  end
end

scrape
ทำไมไม่ require "Nokogiri"? เพราะ Mechanize ให้ความต้องการ scraping ครบครัน Mechanize สร้างบน Nokogiri และ extract เนื้อหาได้ แต่ Nokogiri สำคัญต้องครอบคลุมในบทความแรกเพราะเป็นพื้นฐาน
Pry
ก่อนเข้าโค้ด แนะนำเครื่องมือ debug: Pry วาง Pry.start(binding) ที่ไหนก็ได้ในโค้ด จะ inspect application ณ จุดนั้นได้ ช่วย debug ทีละขั้นตอน ตัวอย่าง วางหลัง write_page ตรวจสอบ link:
Pry
...
def scrape
  link_range = 1
  agent ||= Mechanize.new
  until link_range == 21
    page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
    link_range += 1
    page.links[2..8].map do |link|
      write_page(link)
      Pry.start(binding)
    end
  end
end
...
รันสคริปต์ จะได้ output แสดงบรรทัดที่หยุด:
Output
»$ ruby noko_scraper.rb
321: def scrape
322: link_range = 1
323: agent ||= Mechanize.new
324:
326: until link_range == 21
327: page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
328: link_range += 1
329:
330: page.links[2..8].map do |link|
331: write_page(link) =>
332: Pry.start(binding)
333: end
334: end
335: end
[1] pry(main)>
พิมพ์ link ดู object:
Terminal
[2] pry(main)> link
=> #<Mechanize::Page::Link "Masters @ Work | Subvisual | Deadlines | Design personality | Design problems | Team | Pushing envelopes | Delightful experiences | Perfecting details | Company values" "/episodes/139">
ตรงตามที่ต้องการ ดีแล้ว ทำทีละขั้นตอนอย่างนี้สำคัญมาก ไม่ได้ครอบคลุม Pry ลึก เพราะต้องใช้บทความเต็มๆ แค่แนะนำใช้แทน IRB shell กลับไปงานหลัก
Scraper
ไปดูชิ้นส่วนหลักๆ กัน
podcast_scraper.rb
...
def write_page(link)
  detail_page = link.click
  extracted_data = extract_data(detail_page)
  markdown_text = compose_markdown(extracted_data)
  date = extracted_data[:date]
  interviewee = extracted_data[:interviewee]
  episode_number = extracted_data[:episode_number]
  file_name = "#{date}-#{dasherize(interviewee)}-#{episode_number}.html.erb.md"
  File.open(file_name, 'w') { |file| file.write(markdown_text) }
end

def scrape
  link_range = 1
  agent ||= Mechanize.new
  until link_range == 21
    page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
    link_range += 1
    page.links[2..8].map do |link|
      write_page(link)
    end
  end
end
...
scrape method ทำอะไร? ลูปทุกหน้า index ของพอดแคสต์เก่า ใช้ URL เก่าบน Heroku เพราะเว็บใหม่อยู่ที่ betweenscreens.fm มี 20 หน้า ตัวแปร link_range ควบคุมลูป ใส่ใน URL แต่ละหน้า ง่ายและมีผล
def scrape
page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
แต่ละหน้ามี 8 ตอน ใช้ page.links หาลิงก์ที่จะคลิก ไปหน้ารายละเอียด ใช้ range links[2..8] เพราะ consistent ทุกหน้า ไม่ต้องใช้ CSS selectors
ส่ง link ไป write_page ซึ่งทำงานส่วนใหญ่ คลิก link ไป detail page แล้ว extract ข้อมูล
def write_page
extracted_data = extract_data(detail_page)
def extract_data
def extract_data(detail_page)
  interviewee = extract_interviewee(detail_page)
  title = extract_title(detail_page)
  sc_id = extract_soundcloud_id(detail_page)
  text = extract_shownotes_text(detail_page)
  episode_subtitle = extract_subtitle(detail_page)
  episode_number = extract_episode_number(episode_subtitle)
  date = clean_date(episode_subtitle)
  tags = build_tags(title, interviewee)
  options = {
    interviewee: interviewee,
    title: title,
    sc_id: sc_id,
    text: text,
    tags: tags,
    date: date,
    episode_number: episode_number
  }
end
ใช้ extraction methods หลายตัวกับ detail_page ดึง interviewee, title, sc_id, text, episode_title, episode_number แยก helpers เล็กๆ เพื่อความชัดเจน
Helper Methods
Extraction Methods
แยก helpers เพื่อให้ methods เล็กลง encapsulation ดีขึ้น โค้ดอ่านง่าย รับ detail_page ดึงข้อมูลเฉพาะที่ต้องการ
def extract_interviewee(detail_page)
  interviewee_selector = '.episode_sub_title span'
  detail_page.search(interviewee_selector).text.strip
end
ค้นหา selector ดึง text ตัด whitespace
def extract_title(detail_page)
  title_selector = ".episode_title"
  detail_page.search(title_selector).text.gsub(/[?#]/, '')
end
ดึง title ตัด ? และ # ออก เพราะไม่เข้ากับ front matter
def extract_soundcloud_id(detail_page)
  sc = detail_page.iframes_with(href: /soundcloud.com/).to_s
  sc.scan(/\d{3,}/).first
end
ดึง SoundCloud id จาก iframe: หา iframe ที่ href มี soundcloud.com ทำเป็น string แล้ว scan regex หาตัวเลข track id
"[#<Mechanize::Page::Frame nil \"https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/221003494&auto_play=false&hide_related=false&show_comments=false&show_user=true&show_reposts=false&visual=true\"> ]"
match regex ได้ "221003494"
def extract_shownotes_text(detail_page)
  shownote_selector = "#shownote_container > p"
  detail_page.search(shownote_selector)
end
ดึง show notes paragraphs ง่ายมาก
def extract_subtitle(detail_page)
  subheader_selector = ".episode_sub_title"
  detail_page.search(subheader_selector).text
end
ดึง subtitle เตรียม extract episode number
def extract_episode_number(episode_subtitle)
  number = /[#]\d*/.match(episode_subtitle)
  clean_episode_number(number)
end
ใช้ regex อีกครั้ง ดู before/after:
episode_subtitle
" João Ferreira | 12 Minutes | Aug 26, 2015 | Episode #139 "
number
"#139"
ขั้นตอนสุดท้าย:
def clean_episode_number(number)
  number.to_s.tr('#', '')
end
ตัด # ออก ได้ 139 มาดู utility methods อื่นๆ
Utility Methods
หลัง extract แล้ว ต้อง clean data เตรียม compose markdown เช่น slice episode_subtitle หา date และ build tags
def clean_date
def clean_date(episode_subtitle)
  string_date = /[^|]*([,])(.....)/.match(episode_subtitle).to_s
  Date.parse(string_date)
end
regex หา date รูปแบบ " Aug 26, 2015" แปลงเป็น Date object เพื่อใช้ใน Middleman posts
string_date
" Aug 26, 2015"
Date
2015-08-26
def build_tags
def build_tags(title, interviewee)
  extracted_tags = strip_pipes(title)
  "#{interviewee}"+ ", #{extracted_tags}"
end
รับ title และ interviewee ตัด pipe characters และ junk ออก
def strip_pipes
def strip_pipes(text)
  tags = text.tr('|', ',')
  tags = tags.gsub(/[@?#&]/, '')
  tags.gsub(/[w\/]{2}/, 'with')
end
แทน pipe ด้วย comma ตัด @, ?, #, & และแทน abbreviation ของ with
Before
"Masters @ Work | Subvisual | Deadlines | Design personality | Design problems | Team | Pushing envelopes | Delightful experiences | Perfecting details | Company values"
After
"João Ferreira, Masters Work , Subvisual , Deadlines , Design personality , Design problems , Team , Pushing envelopes , Delightful experiences , Perfecting details , Company values"
รวม interviewee name ใน tags คั่นด้วย comma ทั้งหมดเกิดใน extract_data
Writing Posts
def compose_markdown
def compose_markdown(options={})
  <<-HEREDOC
---
title: #{options[:interviewee]}
interviewee: #{options[:interviewee]}
topic_list: #{options[:title]}
tags: #{options[:tags]}
soundcloud_id: #{options[:sc_id]}
date: #{options[:date]}
episode_number: #{options[:episode_number]}
---
#{options[:text]}
HEREDOC
end
สำหรับเผยแพร่ตอนพอดแคสต์บน Middleman ใช้ blogging system แทน blog posts ธรรมดา สร้าง show notes แสดง episode จาก SoundCloud ผ่าน iframe ใน index แค่แสดง iframe + title
รูปแบบที่ต้องการคือ front matter key/value store สำหรับ static sites แทน database เก่า ข้อมูล: interviewee name, date, SoundCloud track id, episode number วางระหว่าง --- สามขีดด้านบน ข้อความตอนอยู่ด้านล่าง (คำถาม, ลิงก์, sponsor)
Front Matter
---
key: value
key: value
key: value
key: value
---
Episode content goes here.
ใน compose_markdown ใช้ HEREDOC compose ไฟล์พร้อม front matter สำหรับแต่ละตอน จาก options hash ที่ส่งมา
def compose_markdown
...
<<-HEREDOC
---
title: #{options[:interviewee]}
interviewee: #{options[:interviewee]}
topic_list: #{options[:title]}
tags: #{options[:tags]}
soundcloud_id: #{options[:sc_id]}
date: #{options[:date]}
episode_number: #{options[:episode_number]}
---
#{options[:text]}
HEREDOC
...
นี่คือ blueprint ของตอนพอดแคสต์ใหม่ สังเกต syntax #{options[:interviewee]} interpolation ใน HEREDOC ไม่ต้อง double quotes
ยังอยู่ในลูป ภายใน write_page สำหรับแต่ละ link ที่คลิกไป detail page ขั้นต่อไปคือเตรียมเขียนไฟล์จริง ต้องมี: date, interviewee name, episode number และ markdown_text
def write_page
...
markdown_text = compose_markdown(extracted_data)
date = extracted_data[:date]
interviewee = extracted_data[:interviewee]
episode_number = extracted_data[:episode_number]
file_name = "#{date}-#{dasherize(interviewee)}-#{episode_number}.html.erb.md"
...
เขียนไฟล์ด้วย file_name และ markdown_text:
def write_page
...
File.open(file_name, 'w') { |file| file.write(markdown_text) }
...
รายละเอียดชื่อไฟล์: รูปแบบ 2016-10-25-Avdi-Grimm-120 เริ่มต้นวันที่ มีชื่อผู้สัมภาษณ์ และหมายเลขตอน ใช้ helper dasherize แปลงชื่อให้มี dash:
def dasherize
def dasherize(text)
  text.lstrip.rstrip.tr(' ', '-')
end
ตัด whitespace นำ/ท้าย แทน space ด้วย dash ส่วนที่เหลือต่อสตริง: "date-interviewee-name-episodenumber"
def write_page
...
"#{date}-#{dasherize(interviewee)}-#{episode_number}.html.erb.md"
...
เนื้อหาจาก HTML site ต้องใช้ extension .html.erb.md ตอนหน้าที่เขียนเองแค่ .md ก็พอ
จบลูปใน scrape จะได้ไฟล์ตอนหนึ่ง長得像這樣:
2014-12-01-Avdi-Grimm-1.html.erb.md
---
title: Avdi Grimm
interviewee: Avdi Grimm
topic_list: What is Rake | Origins | Jim Weirich | Common use cases | Advantages of Rake
tags: Avdi Grimm, What is Rake , Origins , Jim Weirich , Common use cases , Advantages of Rake
soundcloud_id: 179619755
date: 2014-12-01
episode_number: 1
---
Questions:
- What is Rake?
- What can you tell us about the origins of Rake?
- What can you tell us about Jim Weihrich?
- What are the most common use cases for Rake?
- What are the most notable advantages of Rake?
Links:
In">https://www.youtube.com/watch?v=2ZHJSrF52bc">In memory of the great Jim Weirich
Rake">https://github.com/jimweirich/rake">Rake on GitHub
Jim">https://github.com/jimweirich">Jim Weirich on GitHub
Basic">https://www.youtube.com/watch?v=AFPWDzHWjEY">Basic Rake talk by Jim Weirich
Power">https://www.youtube.com/watch?v=KaEqZtulOus">Power Rake talk by Jim Weirich
Learn">https://devblog.avdi.org/2014/04/30/learn-advanced-rake-in-7-episodes/">Learn advanced Rake in 7 episodes - from Avdi Grimm ( free )
Avdi">https://about.avdi.org/">Avdi Grimm
Avdi Grimm’s screencasts:
Ruby">https://www.rubytapas.com/">Ruby Tapas
Ruby">https://devchat.tv/ruby-rogues/">Ruby Rogues podcast with Avdi Grimm
Great ebook:
Rake">https://www.amazon.com/Rake-Management-Essentials-Andrey-Koleshko/dp/1783280778">Rake Task Management Essentials fromhttps://twitter.com/ka8725"> Andrey Koleshko
Scraper เริ่มจากตอนสุดท้าย ลูปย้อนกลับมาตอนแรก ตัวอย่างตอน 01 ด้านบน มี front matter ข้อมูลที่ scrape ได้ ทั้งหมดเคยล็อกใน database ของ Sinatra app ตอนนี้พร้อมสำหรับ Middleman static site เนื้อหาใต้ --- คือ show notes: คำถามและลิงก์
Final Thoughts
เสร็จแล้ว พอดแคสต์ใหม่ขึ้นและรันอยู่แล้ว ดีใจที่ redesign ใหม่ทั้งระบบ เผยแพร่ตอนใหม่สนุกขึ้น ค้นหาเนื้อหาง่ายขึ้นสำหรับผู้ใช้
ตอนนี้ควรเปิด code editor ลองปรับปรุงโค้ด หาทางทำให้เรียบง่ายขึ้น มีโอกาส refactor หลายจุด
หวังตัวอย่างนี้ให้แนวคิดว่าทำได้อะไรบ้างด้วย web scraping skills ยิ่งไปกว่านี้ก็ทำได้ โอกาสธุรกิจเล็กๆ ก็เยอะ
แต่อย่ารีบ รอสักครู่ ถ้าคลิกไม่ทัน อย่าหวาดกลัว เป็นเรื่องปกติ ส่วนหนึ่งของการเดินทาง Happy scraping!
