

วันนี้เราจะเจาะลึกกลยุทธ์บางอย่างที่คุณสามารถใช้เพื่อขยายสเกลแอปพลิเคชัน Ruby on Rails ให้รองรับฐานผู้ใช้จำนวนมาก
วิธีที่ชัดเจนหนึ่งในการขยายสเกลแอปพลิเคชันคือการทิ้งเงินเพิ่มเข้าไป และมันทำงานได้ดีมาก — เพิ่มเซิร์ฟเวอร์อีก 몇 ตัว อัปเกรดเซิร์ฟเวอร์ฐานข้อมูล และโวอิลา ปัญหาประสิทธิภาพหลายอย่างก็หายไป poof!
แต่บ่อยครั้งก็สามารถขยายสเกลแอปพลิเคชันได้โดยไม่ต้องเพิ่มเซิร์ฟเวอร์ นั่นคือสิ่งที่เราจะพูดถึงวันนี้
ลองเริ่มกันเถอะ!
ใช้ AppSignal สำหรับแอปพลิเคชัน Rails ของคุณ
ก่อนที่เราจะเจาะลึกการขยายสเกลและการเพิ่มประสิทธิภาพประสิทธิภาพ คุณต้องระบุ ก่อน ว่าคุณต้องทำสิ่งนี้หรือไม่ จุดคอขวดคืออะไรในแอปพลิเคชันของคุณ และทรัพยากรไหนบ้างที่สามารถขยายสเกลได้
วิธีง่ายหนึ่งในการทำสิ่งนี้คือใช้ performance monitoring และ metrics สำหรับ Ruby ของ AppSignal
Performance dashboard ช่วยให้คุณระบุ controller actions และ background jobs ที่ช้าในเฉพาะจุดได้อย่างแม่นยำ
ตัวอย่างเช่น นี่คือลักษณะของ performance dashboard สำหรับ ActiveRecord:
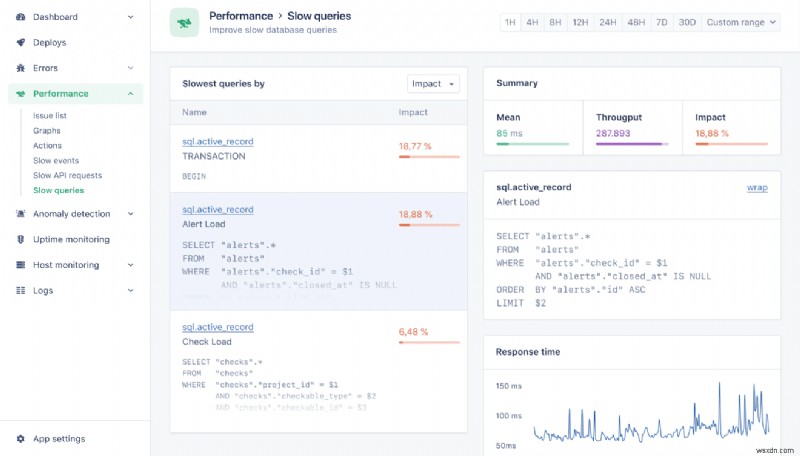
นี่ให้จุดเริ่มต้นที่ดีสำหรับการเดินทางขยายสเกลใดๆ — ไม่ว่าคุณจะตัดสินใจเพิ่มเซิร์ฟเวอร์หรือเพิ่มประสิทธิภาพผ่านโค้ด
ตอนนี้ มาไปที่เทคนิคที่ง่ายที่สุดที่คุณสามารถใช้เพื่อขยายสเกลแอป Rails ของคุณ — caching
Caching ใน Ruby on Rails
Caching ช่วยให้คุณหยุดคำนวณสิ่งเดียวกันซ้ำๆ ได้
ตัวอย่างเช่น สมมติว่าคุณดำเนินแพลตฟอร์มโซเชียลมีเดียและมีโพสต์ที่ได้รับความนิยมมาก Caching สามารถช่วยให้คุณได้ CPU cycles กลับมาทันทีที่คุณใช้ในการ render โพสต์นั้นสำหรับทุกผู้ใช้ และนั่นเป็นเพียงส่วนหนึ่งของสิ่งที่ caching ช่วยคุณได้
มาดูทรัพยากรทั้งหมดที่สามารถ cache ได้
Caching Views
การ render views บางครั้งอาจเป็นการดำเนินการที่มีค่าใช้จ่ายสูง โดยเฉพาะเมื่อ view นั้นมีข้อมูลมากที่ต้อง render แม้การดำเนินการจะไม่แพง การใช้ view ที่ pre-rendered จะให้คุณประสิทธิภาพมากมายเทียบกับการ render view เดียวกันล้านครั้ง
Rails รองรับสิ่งนี้แบบ out of the box โดยใช้ view helper cache ตัวอย่างเช่น นี่คือวิธีที่มันสามารถ cache แต่ละโพสต์เมื่อ render รายการ:
สำหรับสิ่งนี้ Rails จะ cache แต่ละโพสต์ภายใต้ key เฉพาะที่ขึ้นอยู่กับ HTML content ของ template, post id, และ update timestamp
เพื่ออ่านเพิ่มเติมเกี่ยวกับเทคนิคนี้ ดูโพสต์ Fragment caching in Rails และ Rails collection caching
สิ่งหนึ่งที่ต้องระวังคือ cache keys ไม่ได้รวม nested template content ดังนั้น หากคุณ nest cache calls ลึกกว่าหนึ่งระดับ อาจมี stale results อ่านเพิ่มเติมใน Russian doll caching in Rails
Caching Responses
นอกจาก caching views/fragments แล้ว คุณยังสามารถเลือก cache full response ของคำขอ GET ได้ สิ่งนี้รองรับผ่าน headers If-None-Match และ If-Modified-Since ที่ browser ส่งมา
เมื่อ header If-None-Match อยู่บนคำขอ เซิร์ฟเวอร์สามารถตอบกลับ 304 Not Modified โดยไม่มี content หากไม่มีการเปลี่ยนแปลงใน response Server-computed Etag จะถูกเปรียบเทียบกับค่าภายใน header นั้น
เช่นเดียวกัน หาก header If-Modified-Since อยู่โดยไม่มี If-None-Match เซิร์ฟเวอร์สามารถตอบกลับ 304 Not Modified โดยไม่มี content (ตราบใดที่ response ไม่ได้เปลี่ยนแปลงมาตั้งแต่วันนั้น)
Rails ให้วิธีง่ายๆ ในการทำสิ่งนี้ภายใน controller actions คุณสามารถเขียนได้เพียง:
Rails จะส่ง headers ทั้งหมดที่จำเป็นเพื่อรองรับ caching จัดการ incoming headers และตอบกลับ 304 เมื่อข้อมูลไม่ได้เปลี่ยน เซิร์ฟเวอร์สามารถข้ามการ render full views อีกครั้งได้ ยกเว้นสิ่งมีการเปลี่ยนแปลง คุณสามารถอ่านเพิ่มเติมเกี่ยวกับ advanced configuration สำหรับกลยุทธ์นี้ใน Client-side caching in Rails: conditional GET requests
Caching Values
สุดท้าย ยังเป็นไปได้ที่จะ cache raw values (อะไรก็ตามที่สามารถ serialize ไปยัง cache store) นี่มักมีประโยชน์สำหรับการ cache ผลลัพธ์ของ operations ที่ใช้ทรัพยากรมากหรือช้า และหลีกเลี่ยงการทำซ้ำอีกครั้ง
การระบุ value ที่ได้ประโยชน์จาก caching นี้ ขึ้นอยู่กับแอปพลิเคชันมาก แต่โดยทั่วไป การดูที่ slowest events ของคุณสามารถชี้ทางได้
สุดท้าย เมื่อคุณระบุว่าจะ cache อะไร API ที่ Rails ให้สำหรับสิ่งนี้ใช้ง่ายมาก:
โค้ดข้างต้นจะ perform_the_slow_computation เพียงครั้งเดียว และ cache value ภายใต้ key cache_key_with_version ครั้งต่อไปที่โค้ดเดียวกันถูกเรียก Rails จะตรวจสอบก่อนว่ามี cached value อยู่แล้วหรือไม่ และใช้แทนการทริกเกอร์ perform_the_slow_computation อีกครั้ง
ส่วนสำคัญที่สุดของกลยุทธ์ caching นี้คือการคำนวณ cache key ที่ดีซึ่งขึ้นอยู่กับ inputs ทั้งหมดที่ใช้ในการคำนวณ value เพื่อให้แน่ใจว่าเราไม่ใช้ค่าเก่า
Cache Stores
ตอนนี้เรารู้ว่าจะ cache อะไรและเทคนิคที่ Rails ให้มาสำหรับจัดเก็บสิ่งต่างๆ ใน cache คำถามที่เป็นเหตุเป็นผลคือ — เราจะ cache ข้อมูลนี้ที่ไหน? Rails มาพร้อมกับ cache store adapters ในตัวหลายตัว Cache stores ที่ได้รับความนิยมมากที่สุดสำหรับ production use cases คือ Redis และ Memcached มีตัวเลือกอื่นๆ อีกสองสามตัว — file store และ memory store การอภิปรายเต็มรูปแบบของ stores เหล่านี้สามารถหาได้ในโพสต์ Rails' built-in cache stores: an overview
File และ memory stores สามารถยอดเยี่ยมสำหรับ development เพื่อเริ่มทำงานเร็ว แต่โดยปกติไม่เหมาะสำหรับ production โดยเฉพาะหากคุณทำงานใน distributed setup ด้วยหลายเซิร์ฟเวอร์ Redis และ memcached ทั้งคู่เหมาะสำหรับ production use ตัวไหนที่คุณใช้โดยทั่วไปขึ้นอยู่กับแอปพลิเคชัน
Background Workers ใน Ruby on Rails
แอปพลิเคชันส่วนใหญ่ต้องการ background jobs สำหรับ mailers, regular clean-ups, หรือการดำเนินการที่ใช้เวลานานใดๆ ที่ไม่ต้องการให้ผู้ใช้อยู่ภายใน โอกาสคือคุณมี background worker ตั้งค่าไว้แล้ว
ทุกครั้งที่คุณพบว่าตัวเองทำอะไรที่ใช้เวลาเกินหนึ่งวินาทีภายใน controller action ให้ดูว่าสามารถย้ายไป background worker แทนได้หรือไม่ สิ่งนี้อาจตั้งแต่ operation ที่ user-facing เช่น การค้นหาข้อมูลในตารางขนาดใหญ่ ไปจนถึง API method ที่ ingest ข้อมูลจำนวนมาก
ตัวอย่างการ Implement
ในการรัน custom jobs Rails ให้ Active Job framework มาดูว่าเราสามารถใช้มันย้าย logic การกรองที่ซับซ้อนมากไป background job ได้อย่างไร ก่อนอื่น ให้สร้าง background job ของเรา:
เราสามารถรัน job นี้จาก controller เหมือนนี้:
เราต้อง render loading indicator บน template ขณะที่เรารอ job คำนวณข้อมูลและส่งผลลัพธ์
แต่เราจะได้ผลลัพธ์จาก job ไปที่ view อย่างไร? Turbo ทำให้สิ่งนี้ง่ายมาก ตัวอย่างเช่น ภายใน view เราสามารถ subscribe ไปที่ turbo-stream events บน notification channel เฉพาะโดยใช้ turbo_stream_from
ใช้สิ่งนี้ เรามาเขียน templates:
เนื่องจาก data ไม่ได้ถูกกำหนดใน controller action เริ่มต้น เราจะ render เพียง loading indicator เฉพาะ มาส่งผลลัพธ์จาก job ของเราตอนนี้:
ส่วนสำคัญที่นี่คือเมธอด notify_completed มันใช้ Turbo::StreamsChannel broadcast replace event ไปยัง notification stream [user, :huge_datasets] ที่เรา subscribe จาก view ของเรา
นั่นคือทุกสิ่งที่เราต้องการเพื่อย้าย operations ที่ซับซ้อนจาก controller ไป background jobs ข้อได้เปรียบหลักของการย้ายงานไป background คือ background workers สามารถขยายสเกลได้แยกจาก web servers ซึ่งปลดปล่อยทรัพยากรฝั่ง web server มาก สำหรับผู้ใช้ interface แบบนี้ก็รู้สึกตอบสนองมากกว่า เพราะเราสามารถตอบสนองเร็วและส่งผลลัพธ์แบบ incremental
หมายเหตุ: หากคุณต้องการช่วยตัดสินใจระหว่าง background job worker อ่าน Delayed Job vs. Sidekiq: Which Is Better?
การขยายสเกลฐานข้อมูลในแอปพลิเคชัน Ruby on Rails ของคุณ
ทรัพยากรที่ขยายสเกลได้ตัวสุดท้ายที่เราจะพูดถึงในโพสต์นี้คือฐานข้อมูล ฐานข้อมูลเป็นหัวใจของแอปพลิเคชันส่วนใหญ่ เมื่อข้อมูลและจำนวนเซิร์ฟเวอร์ที่เข้าถึงข้อมูลนั้นเพิ่มขึ้น ฐานข้อมูลเริ่มรู้สึกโหลด
วิธีที่ง่ายที่สุดในการขยายสเกลฐานข้อมูลคือเพิ่ม processing power และ memory ให้เซิร์ฟเวอร์ฐานข้อมูล เทียบกับการขยายสเกล web servers การทำสิ่งนี้กับฐานข้อมูลมักเป็นการดำเนินการที่ช้ามาก โดยเฉพาะหากคุณมี storage สูง
ตัวเลือกที่สองในการขยายสเกลฐานข้อมูลคือขยายสเกล horizontally โดยใช้หลายฐานข้อมูลหรือ sharding ฐานข้อมูลของคุณ ดู Multiple Databases with Active Record สำหรับรายละเอียดเพิ่มเติม
แทนที่จะทำนั้น เราจะโฟกัสที่การเพิ่มประสิทธิภาพประสิทธิภาพฐานข้อมูลโดยดูที่ PostgreSQL
ค้นหา Queries ที่ใช้เวลานานใน PostgreSQL
ก่อนอื่น เราต้องระบุ queries ที่ใช้เวลานานที่สุดของเรา วิธีที่เราทำได้คือการ query ตาราง pg_stat_statements ที่มีสถ계를เกี่ยวกับ SQL statements ทั้งหมดที่ execute บนเซิร์ฟเวอร์ มาดูว่าสามารถหา top 100 queries ที่มี run times สูงสุดได้อย่างไร:
นี่จะคืนค่า query, จำนวนการเรียก และ average run time ของ queries เหล่านี้ ลองหาตัวที่คุณคิดว่าอาจเร็วกว่านี้และวิเคราะห์ว่าทำไมมันช้า
คุณยังสามารถรัน EXPLAIN หรือ EXPLAIN ANALYZE บน query เพื่อดู query plan และรายละเอียดการ execute จริงตามลำดับ
หนึ่งในสิ่งสำคัญที่สุดที่ต้องดูในผลลัพธ์คือ Seq Scan ซึ่งบ่งชี้ว่า Postgres ต้องผ่านระคอร์ดทั้งหมดแบบ sequential เพื่อรัน query หากสิ่งนี้เกิดขึ้น ลอง bypass sequential scan นั้นโดยการเพิ่ม index ไปที่คอลัมน์ที่คุณ filter
ตารางที่มี Sequential Scans มากที่สุด
Query อีกอย่างที่ฉันชอบรันคือการหาจำนวน sequential scans ทั้งหมดที่รันต่อตาราง:
หากคุณเห็นตารางใหญ่ (ด้วยจำนวน rows สูง) และค่า count สูงจากผลลัพธ์นี้ แล้วคุณมีปัญหา ลองตรวจสอบ queries ทั้งหมดต่อตารางนั้น หาตัวที่อาจรัน sequential scans และเพิ่ม indices ให้ลดลง
การใช้งาน Index
คุณยังสามารถหาสถ계เกี่ยวกับการใช้งาน index ได้โดยรัน query นี้:
นี่คืนค่าเปอร์เซ็นต์การใช้งาน index สำหรับแต่ละตาราง ตัวเลขต่ำหมายความว่าคุณขาด indexes บางตัวบนตารางนั้น
สรุป
ในโพสต์นี้ เราสำรวจกลยุทธ์หลายอย่างในการขยายสเกลแอปพลิเคชัน Ruby on Rails ของคุณ รวมถึง caching และ background workers เรายังดูการเพิ่มประสิทธิภาพประสิทธิภาพฐานข้อมูล PostgreSQL ของคุณ
Rails ทำให้การเพิ่มหลายชั้นของการเพิ่มประสิทธิภาพประสิทธิภาพให้แอปพลิเคชันของคุณง่ายมาก
การพิจารณาสำคัญที่สุดกับ scalability คือการระบุ bottlenecks ในแอปพลิเคชันก่อนที่เราจะกระทำ ตัวช่วย monitor ประสิทธิภาพที่ดีสามารถช่วยได้ หากคุณต้องการตัวหนึ่ง ดู AppSignal for Ruby
ขอให้เขียนโค้ดสนุกสนาน!
P.S. หากคุณต้องการอ่านโพสต์ Ruby Magic ทันทีที่เผยแพร่ สมัครรับจดหมายข่าว Ruby Magic และจะไม่พลาดโพสต์ใดๆ!
