

คุณอ่านแผนการดำเนินการ (Execution Plans) อย่างไร? จากขวาไปซ้าย, ซ้ายไปขวา, หรือดูจาก Cost? หรือว่าดูจากอ็อบเจกต์อย่าง Index Scan, Table Scan, และ Lookup? บล็อกนี้อภิปรายวิธีอ่านแผนการดำเนินการของ Microsoft® SQL Server
บทนำ
แม้ SQL Server มักจะสร้างแผนที่ดี แต่บางครั้งมันไม่พอที่จะตรวจสอบแผนของตัวเองและแก้ไขแผนที่ไม่ดี
คุณสามารถรับแผนการดำเนินการประมาณการ (Estimated) และแผนการดำเนินการจริงแบบกราฟิก (Actual Graphical) ใน SQL Server สร้างแผนเหล่านี้ได้โดยใช้คำสั่ง Ctrl+M หรือ Ctrl+L หรือใช้ไอคอนที่อยู่ขวาของไอคอน Execute บนแถบเครื่องมือมาตรฐานของ SQL Server Management Studio (SSMS) SQL Server มีแผนประเภทอื่นๆ อีก แต่ไม่ได้ครอบคลุมในโพสต์นี้
แผนการดำเนินการประมาณการและแผนจริง
มีแผนการดำเนินการ 2 ประเภท:
-
แผนการดำเนินการประมาณการ (Estimated Execution Plan): แผนประมาณการให้การประมาณการงานที่ SQL Server คาดว่าจะต้องทำเพื่อรับข้อมูล
-
แผนการดำเนินการจริง (Actual Execution Plan): แผนจริงสร้างขึ้นหลังจากรันคิวรี่ Transact-SQL หรือ Batch แล้ว ดังนั้น แผนจริงจึงมีข้อมูล Runtime เช่น เมตริกการใช้ทรัพยากรจริง และคำเตือน Runtime
การประมวลผลข้อมูล
คุณเคยสังเกตความแตกต่างระหว่างแผนประมาณการและแผนจริงสำหรับคิวรี่เดียวกันหรือไม่? มักจะเหมือนกัน แต่อาจต่างกันได้เพราะการเปลี่ยนแปลงของ Statistics, Schema, หรือข้อมูล คุณควรตรวจสอบแผนการดำเนินการจริงเสมอเมื่อ Troubleshooting
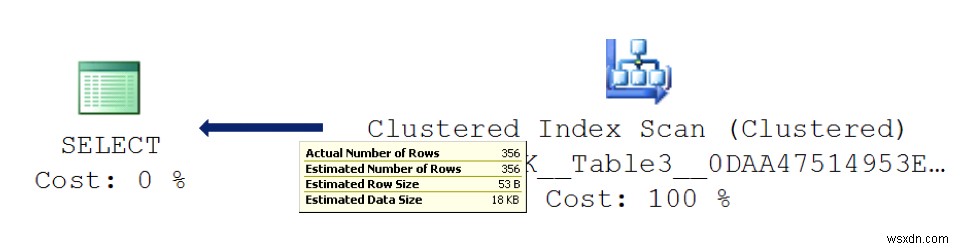
อ่านแผนการดำเนินการอย่างถูกต้องเพื่อระบุจุดสำคัญ เริ่มด้วยการดู Data Flow แทนที่จะดู Cost อย่าคิดถึง Logical หรือ Physical Reads สำคัญคือต้องลดจำนวนการดำเนินการ Input/Output (I/O) 身为 DBA คุณรู้ว่าการเข้าถึง Storage เป็นทรัพยากรฮาร์ดแวร์ที่ช้าที่สุด ดังนั้นคุณควรพยายามลดกิจกรรมนี้ ลองสำรวจ Statistics ได้อย่างไร และแผนการดำเนินการแสดงมันหรือไม่? แสดงครับ! ลองชี้เมาส์ไปที่ตัวบ่งชี้ขวาไปซ้าย จะแสดงจำนวนเรคคอร์ดและขนาดข้อมูล แต่ละเส้นจะหนาหรือบางตามปริมาณข้อมูลที่ออปเปอเรชันส่งคืน ตามภาพประกอบ:
หากคุณมีอ็อบเจกต์มาก คุณต้องการวิธีที่ดีกว่าเพื่อดูภาพรวมปริมาณข้อมูลที่แต่ละออปเปอเรชันประมวลผล ดาวน์โหลด SentryOne Plan Explorer และดูแผนด้วยเครื่องมือนี้เพื่อวิธีง่ายๆ ในการได้ภาพรวม
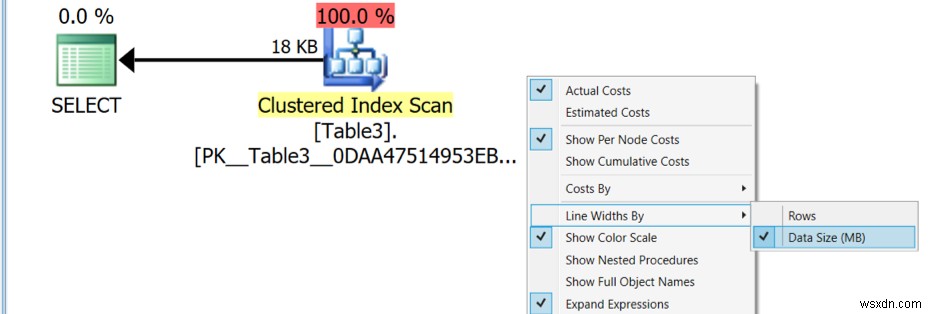
หลังจากดาวน์โหลดและตั้งค่า SentryOne บนระบบของคุณ เปิดแผนการดำเนินการด้วยมัน SentryOne มีมุมมองและคำอธิบายมากมาย ซึ่งคุณสามารถใช้ตามต้องการ เพื่อรับมุมมองการประมวลผลข้อมูล ให้เปลี่ยนมุมมองโดยเลือกตัวเลือก Data size in MB ตามภาพต่อไปนี้ เป้าหมายของคุณคือหาโอกาสลดการประมวลผลข้อมูลโดยรวม
หากคุณต้องการลดความเครียด I/O คุณอาจดูค่า T-SQL SET STATISTICS IO ON เพื่อรับความเข้าใจโดยรวมเกี่ยวกับการใช้ I/O ของคิวรี่ คุณควรตั้งค่านี้ก่อนรันคิวรี่ใน SSMS เพื่อดูแท็บ Message ในแผง Result ควรจะคล้ายกับผลลัพธ์ต่อไปนี้:
(356 row(s) affected) Table 'Table3'. Scan count 1, logical reads 5, physical reads 0, read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob read-ahead reads 0. ผลลัพธ์ logical reads 5 แสดงว่า SQL Server อ่าน 40 KB (5 * 8 KB) หน้าเพื่อรับข้อมูลจากหน่วยความจำ เมื่อเพิ่มประสิทธิภาพคิวรี่ อย่าเพิกเฉยต่อ Logical Reads เพราะบนเซิร์ฟเวอร์จริงอาจเป็น Physical Reads ได้ คุณไม่ทราบว่าหน้าที่คุณอ้างอิงอยู่ในหน่วยความจำหรือดิสก์ เป้าหมายควรเป็นการลดจำนวนการอ่านสะสม (Cumulative Read Operations)
แผนประมาณการเทียบแผนจริง
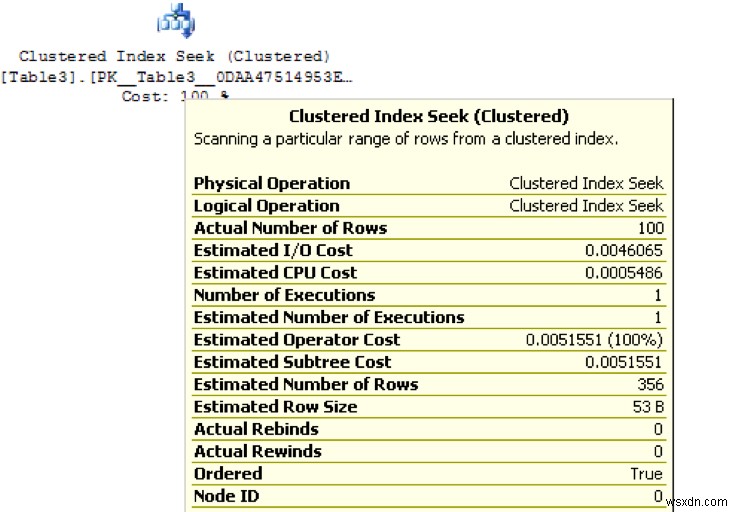
หลังจากสร้างแผนจริงแล้ว ชี้เมาส์ไปที่ออปเปอเรชันหรือหน่วยตรรกะใดๆ ในแผนการดำเนินการ ดูภาพต่อไปนี้เพื่อดูประเภท Physical Operations เช่น ผลลัพธ์ Clustered Index Seek หรือ Scan ดูจำนวนการดำเนินการ (Executions) และจำนวนแถวจริงและประมาณการ หลีกเลี่ยงการดู Cost ของออปเปอเรชันแต่ละตัว เพราะเป็นการประมาณการเป็นวินาทีบนฮาร์ดแวร์เก่า และอาจไม่ให้รายละเอียดที่แม่นยำ ในภาพต่อไปนี้ ออปเปอเรเตอร์ Clustered Index Seek ดำเนินการ 1 ครั้งเพื่อรับ 100 เรคคอร์ด และ SQL ประมาณการ 356 เรคคอร์ด ความแตกต่างอาจมาจาก Statistics ล้าสมัยหรือประสิทธิภาพคิวรี่
การวนซ้ำการดำเนินการ (Execution Iterations)
ภาพต่อไปนี้แสดงจำนวนการดำเนินการประมาณการ 1,154,121 ครั้งบน Clustered Index เพื่อรับ 1 เรคคอร์ด นี่มีนัยสำคัญมาก แม้ Cost ของออปเปอเรเตอร์จะต่ำ และเราอาจเพิกเฉยไปดูออปเปอเรชันอื่นที่มี Cost สูงกว่า แต่นี่อาจเป็นการเลือกที่มีค่าใช้จ่ายสูง การดำเนินการแบบนี้มีผลกระทบสูงต่อประสิทธิภาพคิวรี่ 儘管มี Clustered Index Row ID (RID) Lookups เป็นการดำเนินการคล้ายกันสำหรับ Heap
ฐานข้อมูลชั่วคราว (Tempdb)
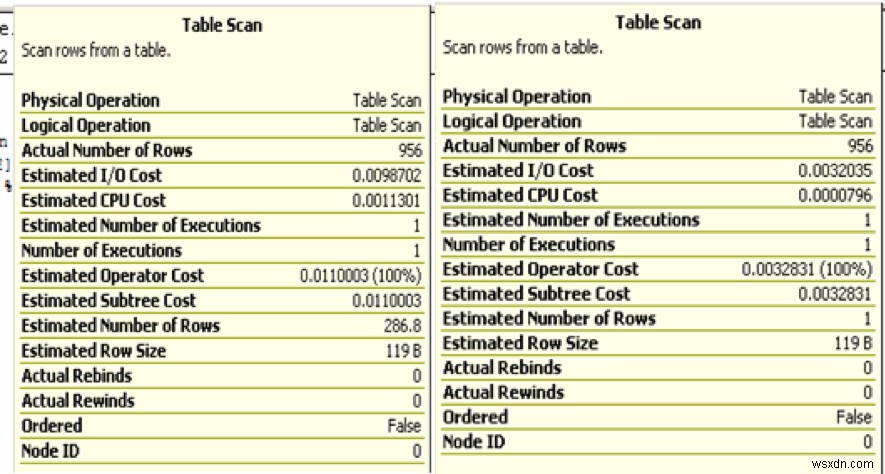
ความแตกต่างระหว่างจำนวนเรคคอร์ดประมาณการและจริง เป็นอีกสิ่งที่คุณควรพิจารณา การประมาณการที่ผิดอาจทำให้คิวรี่ได้รับหน่วยความจำจำกัด เมื่อเกิดขึ้นมันจะใช้ Tempdb เพื่อทำงานให้เสร็จ การเลือกออปเปอเรเตอร์หรือแผนที่ผิดโดย SQL Server อาจทำให้การดำเนินการช้าและการแยกคิวรี่ ตามภาพต่อไปนี้ จำนวนเรคคอร์ดจริงเท่ากัน แตการประมาณการต่างกัน อาจมาจาก Statistics ล้าสมัยหรือหายไป โปรดทราบว่า Table Variables ไม่มี Statistics ดังนั้นแผนจะคืนค่า 1 และ 1K ในเวอร์ชันใหม่จนกว่าจะใช้ตัวเลือก Recompile ดังนั้น Table Variables จึงไม่ใช่ตัวเลือกที่ดีสำหรับจำนวนเรคคอร์ดมาก
ออปเปอเรเตอร์ Sort (การจัดเรียง)
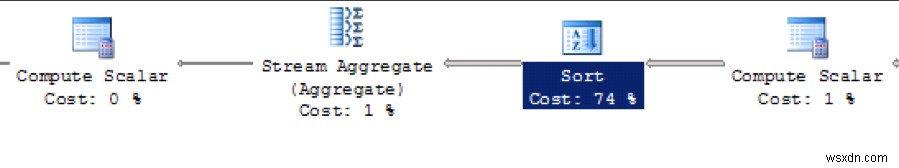
คุณต้องพิจารณาผลกระทบของการจัดเรียง ออปเปอเรเตอร์ Sort ใช้ส่วนใหญ่สำหรับฟังก์ชัน: Aggregate, Merge Join, หรือ Order By Clause นี่อาจไม่มีผลกระทบกับเรคคอร์ดเพียงนิดหน่อย แต่ทุกเรคคอร์ดเพิ่มเติมจะทำให้การประมวลผลช้าลง พยายามหลีกเลี่ยงการจัดเรียงหรืออย่าใช้ Order By Clause หากจำเป็นต้องจัดเรียง ให้ใช้ Application Grid ทำการจัดเรียงแทนการส่งข้อมูลที่จัดเรียงแล้วไปยังแอปพลิเคชัน
ภาพต่อไปนี้แสดง Cost ของการจัดเรียง:
ออปเปอเรเตอร์ Spool
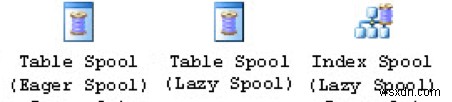
ออปเปอเรเตอร์สำคัญอีกตัวที่คุณต้องดูคือ Spool Spool เป็นออปเปอเรเตอร์ที่ช้า เพราะจัดเก็บอ็อบเจกต์ซ่อนหรือตารางงานชั่วคราว (Work Tables) ใน Tempdb นี้ยังช้าลงอีกด้วยออปเปอเรเตอร์เฉพาะที่ทำให้ Rebind หรือ Rewind มีหลายประเภทใน SQL Server เช่น Eager, Lazy, Table/Index, ฯลฯ SQL Server ใช้ Spool เมื่อดีกว่าที่จะอ้างอิง Temp Work Table แทนที่จะกลับไปที่ Source Table สำหรับชุดผลลัพธ์ระหว่างทาง ภาพต่อไปนี้แสดงตัวอย่าง:
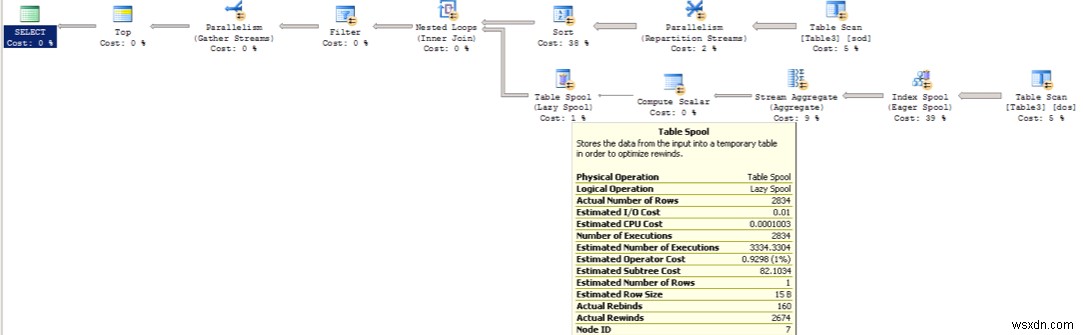
กับ Spool สำคัญคือต้องสังเกตจำนวน Rebinds และ Rewinds Rewind มีค่าใช้จ่ายสูงกว่า Rebind ตัวอย่างเช่น ในภาพต่อไปนี้ ออปเปอเรเตอร์แสดง 2,674 Rewinds ซึ่งหมายความว่าคิวรี่ถูกดำเนินการซ้ำ 2,674 ครั้งเพื่อรับข้อมูล มันคืนออปเปอเรเตอร์แต่ละตัวจาก Table Spool ไป Table Scan เพื่อรับแต่ละเรคคอร์ดใน Rewinds Rebind หมายถึงมันได้ข้อมูลจาก Spool และไม่ได้กลับไป Table Scan
ออปเปอเรเตอร์ Hash และ Nested Loop
เนื่องจากทำงานดีกับชุดเรคคอร์ดเล็ก Hash และ Nested Loops จึงเป็นออปเปอเรเตอร์ถัดไปที่คุณควรพิจารณา อย่างไรก็ตาม สำหรับชุดเรคคอร์ดใหญ่ หรือเมื่อมีความแตกต่างมากระหว่างแผนประมาณการและจริง ออปเปอเรเตอร์เหล่านี้อาจสร้างผลกระทบใหญ่ เพราะอาจใช้ Tempdb แทนหน่วยความจำ SQL Server แสดงคำเตือนในรายละเอียดออปเปอเรเตอร์: "operator used tempdb to spill data during executions" หากเกิดขึ้น ให้ใส่ใจ Statistics ดูหน่วยความจำที่จัดสรรสำหรับการดำเนินการ เพื่อดูการจัดสรรหน่วยความจำ ให้เปิดกล่องคุณสมบัติโดยเลือกจุดเริ่มต้นของแผนการดำเนินการ (ซ้ายไปขวา) หากไม่มีอะไรผิดปกติ การปรับแต่งคิวรี่ (Query Tuning) ควรเป็นตัวเลือกที่เหมาะสม
สรุป
เป้าหมายแรกในการเพิ่มประสิทธิภาพคิวรี่ควรเป็นการลดการอ่านและเขียนโดยรวม (คือ Disk I/O) อย่าลืม Logical Reads สำหรับการอ่านและเขียนในหน่วยความจำ การลด I/O แก้ปัญหาส่วนใหญ่และคิวรี่จะรันเร็วขึ้นมาก
ต่อไป ให้ดูออปเปอเรชันอื่นๆ ที่มีค่าใช้จ่ายสูงเนื่องจากกิจกรรมบน Tempdb จำไว้ว่า Tempdb ใช้สำหรับหลายการดำเนินการและมีค่าใช้จ่ายสูงเสมอ ดู Rewinds - จำนวนการดำเนินการของออปเปอเรชันใดๆ Spool, Sorting, และ Loops
สิ่งเหล่านี้มีค่าใช้จ่ายสูงเมื่อใช้กับ Tempdb อย่าลืมตรวจสอบคำเตือนบนแต่ละออปเปอเรเตอร์ เพราะให้ सुराग ที่ดี แม้โพสต์นี้ไม่ได้อภิปรายเกี่ยวกับ Missing Index Operator แต่ไม่ได้หมายความว่าคุณสามารถเพิกเฉยได้
ตรวจสอบมัน แต่อย่าสร้างดัชนีแบบโง่ เข้าดัชนีอื่นๆ ที่มีอยู่บนคอลัมน์เดียวกัน และพิจารณาผลกระทบต่อคิวรี่ที่กำลังรันในฐานข้อมูลของคุณ
ใช้แท็บ Feedback เพื่อแสดงความคิดเห็นหรือถามคำถาม คุณยังสามารถเริ่มสนทนากับเราได้
