

บทความนี้เจาะลึกรายละเอียดของฟีเจอร์ Oracle® Exadata® Smart Scan รวมถึงคำอธิบายว่าการประมวลผล SQL แตกต่างกันอย่างไรกับ Exadata และตัวอย่างการใช้งาน
บทนำ
Oracle ออกแบบและนำเสนอ Exadata ในปี 2008 เป็นหนึ่งในระบบ engineered systems แรกที่แตกต่างจากระบบฐานข้อมูลแบบดั้งเดิม ซึ่งต้องกำหนดค่า ติดตั้ง ปรับแต่ง และจัดการโดยผู้ใช้ engineered system มีองค์ประกอบที่จำเป็นทั้งหมด เช่น OS, ฐานข้อมูล, หน่วยความจำ และที่จัดเก็บ ติดตั้ง กำหนดค่า ปรับแต่ง และเพิ่มประสิทธิษ์ล่วงหน้าโดยผู้ให้บริการโซลูชัน เช่น Oracle
มีองค์ประกอบต่างๆ ของเครื่อง Exadata องค์ประกอบหลักมีดังนี้:
-
Database servers: เซิร์ฟเวอร์ระดับ Enterprise ที่รันซอฟต์แวร์ฐานข้อมูล Automatic Storage Management (ASM) หรือ Oracle Grid Infrastructure
-
Storage servers: เซิร์ฟเวอร์จัดเก็บ หรือ cells ที่รันซอฟต์แวร์ Exadata storage server ซึ่งจัดการคำขอ I/O ที่มาจาก database servers และคำขอข้อมูลที่ส่งกลับให้ผู้ใช้
-
InfiniBand network: เครือข่ายภายใน Exadata สร้างบน InfiniBand ซึ่งออกแบบมาสำหรับสภาพแวดล้อม high-performance computing เป็นหลัก
Exadata มาพร้อมซอฟต์แวร์ที่รู้จักกันในชื่อ Exadata Storage Software (ESS) ซึ่งเพิ่มประสิทธิภาพของฐานข้อมูล ESS คือ storage management server ที่ติดตั้งบนแต่ละ storage cell จัดการ storage servers และสื่อสารกับ database servers สำหรับคำขอที่เกี่ยวกับ storage ใดๆ
ฟีเจอร์สำคัญของ ESS
ต่อไปนี้คือฟีเจอร์สำคัญของ ESS:
-
Flash cache: Flash cache เป็น cache ประสิทธิภาพสูงบน cell servers ที่ cache ออบเจ็กต์ที่เข้าถึงล่าสุด
-
Flash log: Flash log ให้ที่จัดเก็บชั่วคราวประสิทธิภาพสูง ความหน่วงต่ำ และน่าเชื่อถือสำหรับ redo-log writes
-
EHCC: Exadata Hybrid Columnar Compression (EHCC) เปิดใช้งานระดับการบีบอัดข้อมูลสูงสุด EHCC จัดระเบียบข้อมูลเป็นชุดของแถวที่เรียกว่า compression units ภายใน compression unit EHCC จัดระเบียบข้อมูลตามคอลัมน์แล้วบีบอัดข้อมูล
-
Storage indexes: Storage indexes เป็นโครงสร้างในหน่วยความจำบน storage servers ที่ออกแบบมาเพื่อลดเวลาที่ใช้ในการอ่านข้อมูลจากดิสก์บน storage servers
-
Cell offloading: ไม่เหมือนการออกแบบ storage แบบดั้งเดิม storage cells ของ Exadata ถูกออกแบบมาเพื่อประมวลผลภาระงานบางส่วนภายในเพื่อลดภาระโดยรวมบน compute หรือ database nodes กระบวนการนี้เรียกว่า cell offloading
-
Smart Scan: Smart Scan อนุญาตให้การประมวลผล SQL ส่วนใหญ่เกิดขึ้นใน storage tier แทนที่จะเป็น database tier ซึ่งปรับปรุงประสิทธิภาพคิวรีอย่างมาก Smart Scan ลดปริมาณข้อมูลที่ส่งไปยัง database tier ดังนั้นลดการใช้ CPU บน database nodes
การประมวลผล SQL
โดยปกติ การประมวลผล SQL เกิดขึ้นบน database servers เท่านั้น ใน Exadata การประมวลผล SQL ถูกแบ่งและเกิดขึ้นบน storage tier ด้วย
การประมวลผล SQL แบบดั้งเดิม
ขั้นตอนต่อไปนี้ประกอบด้วยการประมวลผล SQL แบบดั้งเดิม ตามแผนภาพด้านล่าง:
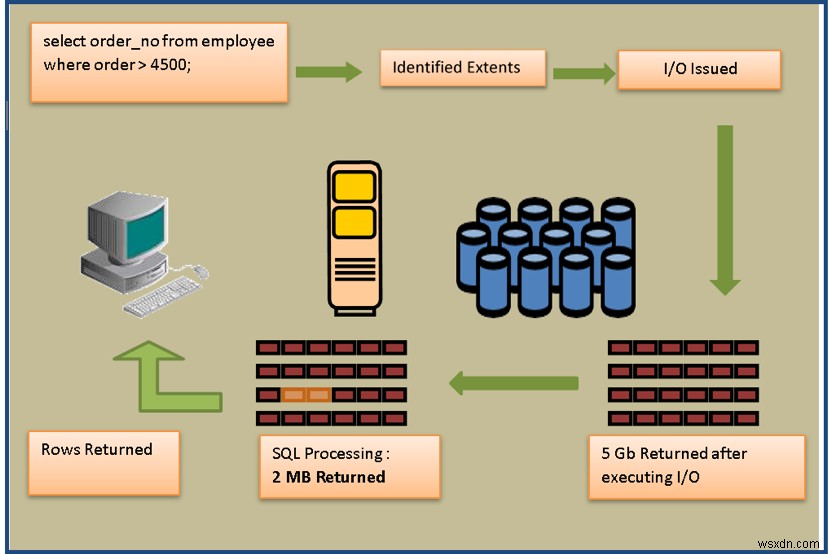
- ลูกค้าส่งคิวรี
- การกระทำนี้ทริกเกอร์ full table scan
- ฐานข้อมูลแมปคำขอไปยังไฟล์และ extents ที่เกี่ยวข้อง ซึ่งมีตารางที่กำลังสแกน
- คล้ายกับ full scan ฐานข้อมูลออกคำสั่ง I/O operations เพื่ออ่านบล็อกทั้งหมด
- บล็อกที่ถูกคิวรีของตารางทั้งหมดถูกอ่านเข้า memory
- กระบวนการค้นหาบล็อกสำหรับแถวที่ตรงกับ predicate
- สุดท้าย แถวที่ร้องขอถูกส่งกลับให้ลูกค้า
หากเป็นตารางใหญ่ บล็อกทั้งหมดจากตารางนั้นจะถูกอ่าน ถ่ายโอนผ่านเครือข่าย storage และคัดลอกเข้า memory กระบวนการอ่านแถวที่ไม่ต้องการจำนวนมากเข้า memory เพื่อทำ SQL operation ที่ร้องขอ ปริมาณข้อมูลที่ส่งขนาดใหญ่ใช้ bandwidth ส่งผลต่อ response time และสร้างภาระที่ไม่จำเป็นบน database tier
การประมวลผล SQL ของ Exadata server
ด้วย Exadata storage การประมวลผล SQL จัดการได้มีประสิทธิภาพมากกว่า เพราะใช้ Exadata storage software ซึ่งมี database logic สร้างอยู่ภายใน ขั้นตอนต่อไปนี้ประกอบด้วยการประมวลผล SQL ของ Exadata ตามแผนภาพด้านล่าง:
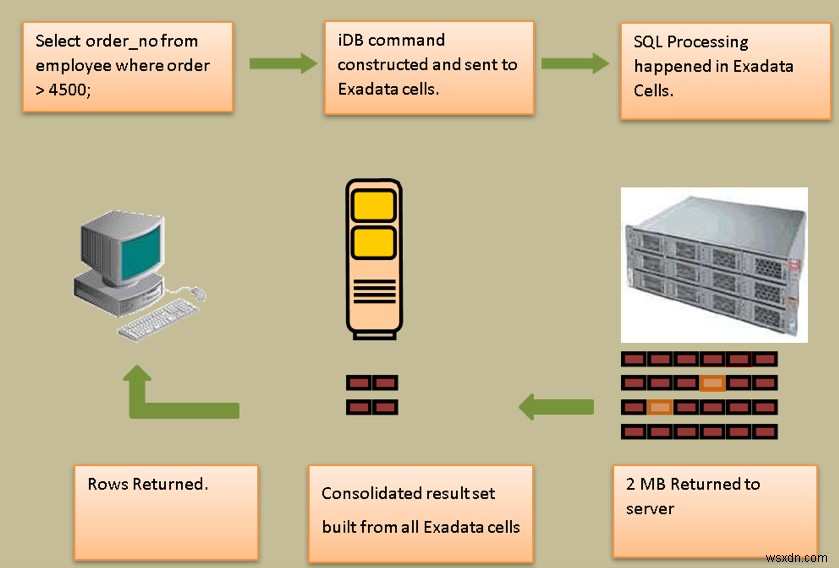
- ลูกค้าส่งคิวรี
- Database server สร้างข้อความ Intelligent Database (iDB) ซึ่งรวมเกณฑ์คิวรี ข้อความ iDB นี้ไปยัง storage servers ทั้งหมดใน rack
- ส่วนประกอบ cellsrv ของ ESS สแกนบล็อกข้อมูลเพื่อระบุแถวและคอลัมน์ที่ตรงกันและตรงตามคำขอ
- ทุก storage server รันเกณฑ์คิวรีแบบขนาน และส่งเฉพาะแถวที่เกี่ยวข้อง หรือ net result ไปยัง database server โดยใช้ interconnect
- Database รวมผลลัพธ์และส่งแถวกลับให้ลูกค้า
ข้อกำหนดของ Smart Scan
ต่อไปนี้คือข้อกำหนดในการใช้ Smart Scan:
- คุณสามารถใช้ Smart Scan ได้เฉพาะ full table scans หรือ full index scans เท่านั้น
- คิวรีต้องทำ direct-path reads
- คุณต้องตั้งค่าพารามิเตอร์การเริ่มต้นฐานข้อมูล
CELL_OFFLOAD_PROCESSINGเป็นTRUE - คุณต้องจัดเก็บ segments ใน disk groups ที่จัดเก็บอยู่บน Exadata cells อย่างสมบูรณ์
- ASM disk groups ที่จัดเก็บข้อมูล segment ต้องมีการตั้งค่า attribute ดังนี้: –
compatible.rdbms=11.2.0.0.0(หรือใหม่กว่า) –compatible.asm=11.2.0.0.0(หรือใหม่กว่า) –cell.smart_scan_capable=TRUE
ตัวอย่าง Smart Scan
รันขั้นตอนต่อไปนี้ ก่อนด้วย Smart Scan ที่เปิดใช้งาน แล้วตามด้วยปิดใช้งาน เพื่อวัดผลของ Smart Scan ต่อสถิติ
ขั้นตอนที่ 1: เชื่อมต่อกับฐานข้อมูล
รันคำสั่งต่อไปนี้เพื่อเชื่อมต่อกับฐานข้อมูลของคุณด้วย SQL*Plus:
[oracle@nd01db01 ~]$ sqlplus nd/nd SQL*Plus: Release 11.2.0.3.0 Production... ขั้นตอนที่ 2: ตรวจสอบสถิติ
รันคิวรีต่อไปนี้เพื่อตรวจสอบว่าสถิติอยู่ที่หรือใกล้ศูนย์:
SQL> select a.name, b.value/1024/1024 MB from v$sysstat a, v$mystat b where a.statistic# = b.statistic# and (a.name in ('physical read total bytes', 'physical write total bytes', 'cell IO uncompressed bytes') or a.name like 'cell phy%'); NAME MB --------------------------------------------------------------- --- physical read total bytes 0 physical write total bytes 0 cell physical IO interconnect bytes 0 cell physical IO bytes saved during optimized file creation 0 cell physical IO bytes saved during optimized RMAN file restore 0 cell physical IO bytes eligible for predicate offload 0 cell physical IO bytes saved by storage index 0 cell physical IO bytes sent directly to DB node to balance CPU 0 cell physical IO interconnect bytes returned by smart scan 0 cell IO uncompressed bytes 0 10 rows selected. ขั้นตอนที่ 3: รันคิวรี select พร้อมปิดใช้งาน Smart Scan
รันคิวรี select ต่อไปนี้พร้อม optimizer hint ที่ปิดใช้งาน Smart Scan:
SQL> select /*+ OPT_PARAM('cell_offload_processing' 'false') */ count(*) from sales where time_id between '01-JUN-2017' and '30-OCT-2017' and amount_sold = 1; COUNT(*) ---------- 134055 ขั้นตอนที่ 4: ตรวจสอบสถิติอีกครั้ง
รันคำสั่งต่อไปนี้เพื่อตรวจสอบสถิติอีกครั้ง สังเกตว่าข้อมูลทั้งหมดที่ถูกประมวลผลโดยคิวรีในขั้นตอนที่ 3 (physical read total bytes) ถูกส่งกลับไปยัง database server ผ่าน storage network (cell physical IO interconnect bytes)
SQL> select a.name, b.value/1024/1024 MB from v$sysstat a, v$mystat b where a.statistic# = b.statistic# and (a.name in ('physical read total bytes', 'physical write total bytes', 'cell IO uncompressed bytes') or a.name like 'cell phy%'); NAME MB --------------------------------------------------------------- ----------- physical read total bytes 759.429688 physical write total bytes 0 cell physical IO interconnect bytes 759.429688 cell physical IO bytes saved during optimized file creation 0 cell physical IO bytes saved during optimized RMAN file restore 0 cell physical IO bytes eligible for predicate offload 0 cell physical IO bytes saved by storage index 0 cell physical IO bytes sent directly to DB node to balance CPU 0 cell physical IO interconnect bytes returned by smart scan 0 cell IO uncompressed bytes 0 10 rows selected. ขั้นตอนที่ 5: รีเซ็ตสถิติ
รันคำสั่งต่อไปนี้เพื่อเชื่อมต่อเซสชันกับฐานข้อมูลใหม่เพื่อรีเซ็ตสถิติระดับเซสชัน:
[oracle@nd01db01 ~]$ sqlplus nd/nd SQL*Plus: Release 11.2.0.3.0 Production... ขั้นตอนที่ 6: ตรวจสอบสถิติอีกครั้ง
รันคิวรีต่อไปนี้เพื่อตรวจสอบว่าสถิติอยู่ที่หรือใกล้ศูนย์:
SQL> select a.name, b.value/1024/1024 MB from v$sysstat a, v$mystat b where a.statistic# = b.statistic# and (a.name in ('physical read total bytes', 'physical write total bytes', 'cell IO uncompressed bytes') or a.name like 'cell phy%'); NAME MB --------------------------------------------------------------- --- physical read total bytes 0 physical write total bytes 0 cell physical IO interconnect bytes 0 cell physical IO bytes saved during optimized file creation 0 cell physical IO bytes saved during optimized RMAN file restore 0 cell physical IO bytes eligible for predicate offload 0 cell physical IO bytes saved by storage index 0 cell physical IO bytes sent directly to DB node to balance CPU 0 cell physical IO interconnect bytes returned by smart scan 0 cell IO uncompressed bytes 0 10 rows selected. ขั้นตอนที่ 7: รันคิวรี select โดยไม่ปิดใช้งาน Smart Scan
รันคิวรี select ต่อไปนี้โดยไม่มี optimizer hint ที่ปิดใช้งาน Smart Scan:
SQL> select count(*) from sales where time_id between '01-JUN-2017' and '30-OCT-2017'and amount_sold = 1; COUNT(*) ------- 134055 ขั้นตอนที่ 8: ตรวจสอบสถิติ
รันคิวรีต่อไปนี้เพื่อตรวจสอบสถิติ สังเกตว่าคิวรียังคงทำ I/O ประมาณ 759 MB (physical read total bytes) เหมือนขั้นตอนที่ 4 แต่ครั้งนี้ส่งกลับไป DB server เพียง 1.7 MB (cell physical IO interconnect bytes) นี่เป็นผลของ Smart Scan ในการทำงาน ในกรณีนี้ Smart Scan กำลังทำงานบน I/O ที่เกี่ยวข้องกับคิวรีนี้ เพราะ cell physical IO bytes ที่ eligible สำหรับ predicate offload เท่ากับ physical read total bytes และ cell physical IO interconnect bytes returned by smart scan เท่ากับ cell physical IO interconnect bytes
SQL> select a.name, b.value/1024/1024 mb from v$sysstat a, v$mystat b where a.statistic# = b.statistic# and (a.name in ('physical read total bytes', 'physical write total bytes','cell IO uncompressed bytes') or a.name like 'cell phy%'); NAME MB ---------------------------------------------------------------- ---------- physical read total bytes 759.429688 physical write total bytes 0 cell physical IO interconnect bytes 1.71562805 cell physical IO bytes saved during optimized file creation 0 cell physical IO bytes saved during optimized RMAN file restore 0 cell physical IO bytes eligible for predicate offload 759.429688 cell physical IO bytes saved by storage index 0 cell physical IO bytes sent directly to DB node to balance CPU 0 cell physical IO interconnect bytes returned by smart scan 1.71562805 cell IO uncompressed bytes 759.429688 10 rows selected. สรุป
ฟีเจอร์ Smart Scan ใน Exadata เปิดใช้งานการประมวลผล SQL ให้เกิดขึ้นที่ storage tier แทนที่จะเป็น database tier เพื่อปรับปรุงประสิทธิภาพคิวรี Smart Scan ลดปริมาณข้อมูลที่ส่งไปยัง database tier ดังนั้นลดการใช้ CPU บน database nodes
ใช้แท็บ Feedback เพื่อแสดงความคิดเห็นหรือถามคำถาม
เรียนรู้เพิ่มเติมเกี่ยวกับบริการฐานข้อมูลและบริการแอปพลิเคชันของ Rackspace
