

บทนำ
การสำรองข้อมูลและกู้คืนฐานข้อมูล เป็นหนึ่งในกิจกรรมประจำวันที่สำคัญที่ผู้ดูแลฐานข้อมูล (DBA) ดำเนินการ การสำรองข้อมูลฐานข้อมูลคือสำเนาของข้อมูลของคุณที่สามารถใช้เพื่อกู้คืนข้อมูลในกรณีที่เกิดการสูญหายข้อมูล
บล็อกนี้จะแสดงวิธีการสำรองข้อมูลฐานข้อมูล Apache Cassandra และกู้คืนหลังจากเกิดความล้มเหลว
บทนำ
แม้ว่า Apache Cassandra จะเป็นแบบกระจายศูนย์ (decentralized) แต่สามารถทนทานต่อความล้มเหลวของโหนดเดี่ยวและหลายโหนดได้โดยไม่สูญหายข้อมูลธุรกิจใดๆ ตราบใดที่หนึ่งในโหนดในคลัสเตอร์มีข้อมูล อย่างไรก็ตาม ตามแนวทางปฏิบัติที่ดีที่สุด คุณควรกำหนดค่าการสำรองข้อมูลสำหรับฐานข้อมูล
ในกรณีเกิดความล้มเหลวใดๆ เช่น การสร้างคลัสเตอร์ใหม่ทั้งหมด การเสียหายของข้อมูล การลบข้อมูลโดยไม่ได้ตั้งใจ และอื่นๆ คุณสามารถกู้คืนข้อมูลจากการสำรองข้อมูลและดำเนินการธุรกิจต่อไปได้ด้วยผลกระทบน้อยที่สุดหรือไม่มีผลกระทบ
บริษัทมากขึ้นเรื่อยๆ ใช้ฐานข้อมูล NoSQL เช่น Cassandra เพื่อจัดการปริมาณข้อมูลธุรกิจขนาดใหญ่ ซึ่งรู้จักกันดีในนาม Big Data อย่างสำเร็จ Cassandra ซึ่งใช้โดยองค์กรชั้นนำมากมาย รับรองความสามารถในการขยายตัว ความทนทานต่อข้อผิดพลาด และความสอดคล้องเพื่อรองรับ Big Data
การสำรองข้อมูลและกู้คืนฐานข้อมูล Cassandra
คุณสามารถใช้ยูทิลิตี้ต่อไปนี้เพื่อสร้างสแนปชอตของฐานข้อมูล Cassandra และกู้คืนเมื่อจำเป็น:
nodetool(สำหรับสร้างสแนปชอต)sstableloader(สำหรับกู้คืนสแนปชอตการสำรองข้อมูล)
ภาพต่อไปนี้แสดงการย้ายจากคลัสเตอร์คลาวด์ไปยังคลัสเตอร์ Cassandra โดยใช้ sstableloader:
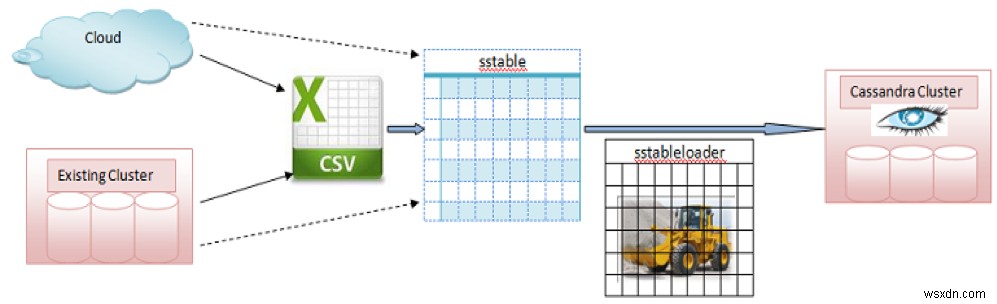
แหล่งที่มาของภาพ: https://dzone.com/articles/using-casandras-sstable-bulk
การสำรองข้อมูล (Backup)
ตัวอย่างต่อไปนี้ใช้ nodetool เพื่อสร้างสแนปชอตของฐานข้อมูล Cassandra keyspace(users) ที่มีตารางชื่อ employee
รายละเอียดคลัสเตอร์ Cassandra ต้นทาง:
$ nodetool -u cassandra -pw ******** -h localhost status
Datacenter: us-central1
=======================
Status=Up/Down |/ State=Normal/Leaving/Joining/Moving
--  Address     Load       Tokens  Owns (effective)  Host ID                               Rack
UN  10.128.0.2  121.52 KiB  256     63.3%             5957997f-7471-4c21-bead-37a6604812e2  f
UN  10.128.0.3  92.22 KiB   256     68.0%             87c2a663-a965-4675-b5ed-c4a46d77c796  f
UN  10.128.0.4  225.3 KiB   256     68.8%             8e12557f-be00-4387-bff3-ef51f431b9a0  f
ใช้คำสั่งต่อไปนี้เพื่อสำรองข้อมูล keyspace:
$ nodetool -h localhost -u cassandra -pw ****** snapshot users -t "users-201904201800"
Requested creating snapshot(s) for [users] with snapshot name [users-201904201800] and options {skipFlush=false}
Snapshot directory: users-201904201800
สิ่งนี้สร้างสแนปชอตการสำรองข้อมูลดังตัวอย่างต่อไปนี้:
/bitnami/cassandra/data/data/users/employee-c1319df0636211e9a0e3570eb7f8fd5f/snapshots/users-201904201800
$ ls -ltr
total 44
-rw-r--r-- 2 cassandra cassandra 16 Apr 20 12:05 md-1-big-Filter.db
-rw-r--r-- 2 cassandra cassandra 56 Apr 20 12:05 md-1-big-Summary.db
-rw-r--r-- 2 cassandra cassandra 32 Apr 20 12:05 md-1-big-Index.db
-rw-r--r-- 2 cassandra cassandra 134 Apr 20 12:05 md-1-big-Data.db
-rw-r--r-- 2 cassandra cassandra 10 Apr 20 12:05 md-1-big-Digest.crc32
-rw-r--r-- 2 cassandra cassandra 43 Apr 20 12:05 md-1-big-CompressionInfo.db
-rw-r--r-- 2 cassandra cassandra 4683 Apr 20 12:05 md-1-big-Statistics.db
-rw-r--r-- 2 cassandra cassandra 92 Apr 20 12:05 md-1-big-TOC.txt
-rw-r--r-- 1 cassandra cassandra 31 Apr 20 12:05 manifest.json
-rw-r--r-- 1 cassandra cassandra 865 Apr 20 12:05 schema.cql
$ date
Sat Apr 20 12:08:21 UTC 2019
ตอนนี้ ให้บีบอัดไดเรกทอรีไฟล์สำรองข้อมูล /snapshot และย้ายไฟล์ tar ไปที่ไดเรกทอรี /bitnami/Cassandra/data/data/backup
$ tar -cvf users-201904201800.tar *.*
manifest.json
md-1-big-CompressionInfo.db
md-1-big-Data.db
md-1-big-Digest.crc32
md-1-big-Filter.db
md-1-big-Index.db
md-1-big-Statistics.db
md-1-big-Summary.db
md-1-big-TOC.txt
schema.cql
$ ls -ltr
total 64
-rw-r--r-- 2 cassandra cassandra 16 Apr 20 12:05 md-1-big-Filter.db
-rw-r--r-- 2 cassandra cassandra 56 Apr 20 12:05 md-1-big-Summary.db
-rw-r--r-- 2 cassandra cassandra 32 Apr 20 12:05 md-1-big-Index.db
-rw-r--r-- 2 cassandra cassandra 134 Apr 20 12:05 md-1-big-Data.db
-rw-r--r-- 2 cassandra cassandra 10 Apr 20 12:05 md-1-big-Digest.crc32
-rw-r--r-- 2 cassandra cassandra 43 Apr 20 12:05 md-1-big-CompressionInfo.db
-rw-r--r-- 2 cassandra cassandra 4683 Apr 20 12:05 md-1-big-Statistics.db
-rw-r--r-- 2 cassandra cassandra 92 Apr 20 12:05 md-1-big-TOC.txt
-rw-r--r-- 1 cassandra cassandra 31 Apr 20 12:05 manifest.json
-rw-r--r-- 1 cassandra cassandra 865 Apr 20 12:05 schema.cql
-rw-r--r-- 1 cassandra cassandra 20480 Apr 20 12:22 users-201904201800.tar
cp *.tar /bitnami/cassandra/data/data/backup.
/bitnami/cassandra/data/data/backup
$ ls -ltr
-rw-r--r-- 1 cassandra cassandra 20480 Apr 20 12:23 users-201904201800.tar
หลังจากคัดลอกไฟล์ tar การสำรองข้อมูลไปยังตำแหน่งที่ไม่ใช่ค่าเริ่มต้น ให้ลบตาราง employee
หมายเหตุ: Cassandra แจกแจงข้อมูลตามคีย์พาร์ติชันและตัวคูณการจำลองที่กำหนดทั่วทั้งคลัสเตอร์ ดังนั้นคุณต้องรันคำสั่งสำรองข้อมูลนี้จากโหนดทั้งหมดของคุณ ตัวอย่างนี้ใช้สคริปต์เชลล์ Linux ใน crontab ซึ่งสำรองข้อมูลโหนดทั้งหมดพร้อมกัน
$ cqlsh -u cassandra -p *******
Connected to Test_Cassandra at 127.0.0.1:9042.
[cqlsh 5.0.1 | Cassandra 3.11.4 | CQL spec 3.4.4 | Native protocol v4]
Use HELP for help.
cassandra@cqlsh> use users;
cassandra@cqlsh:users> select * from employee;
emp_id | employee_address | employee_name
--------+------------------+---------------
8796   | Singapore        | Joy
5647   | London           | Mike
3452   | Canada           | Nancy
6453   | China            | John
(4 rows)
cassandra@cqlsh:users> drop table employee;
cassandra@cqlsh:users> select * from employee;
InvalidRequest: Error from server: code=2200 [Invalid query] message="unconfigured table employee"
การกู้คืน (Restore)
เพื่อกู้คืนตาราง employee จากสแนปชอตการสำรองข้อมูลของ keyspace (users) คุณต้องใช้ยูทิลิตี้ sstableloader ยูทิลิตี้ sstableloader ไม่ได้คัดลอกชุดของ sstables ไปยังแต่ละโหนดเท่านั้น แต่ยังส่งส่วนที่เหมาะสมของข้อมูลไปยังทุกโหนดตามกลยุทธ์การจำลองที่กำหนดสำหรับคลัสเตอร์ โปรดสังเกตว่าไม่จำเป็นต้องมีตารางว่างเพื่อกู้คืนข้อมูล
ใช้ขั้นตอนต่อไปนี้เพื่อกู้คืนไฟล์ tar ไปยัง backup/users:
$ pwd
/bitnami/cassandra/data/data/backup/users
$ ls -ltr
total 20
-rw-r--r-- 1 cassandra cassandra 20480 Apr 20 12:23 users-201904201800.tar
$ tar -xvf *.tar
manifest.json
md-1-big-CompressionInfo.db
md-1-big-Data.db
md-1-big-Digest.crc32
md-1-big-Filter.db
md-1-big-Index.db
md-1-big-Statistics.db
md-1-big-Summary.db
md-1-big-TOC.txt
schema.cql
สร้างลิงก์นิยม (soft link) สำหรับไดเรกทอรีผู้ใช้ด้วยชื่อตารางที่คุณจะกู้คืน
$ ln -s /bitnami/cassandra/data/data/backup/users employee
$ ls -ltr
total 64
-rw-r--r-- 1 cassandra cassandra 865 Apr 20 12:05 schema.cql
-rw-r--r-- 1 cassandra cassandra 92 Apr 20 12:05 md-1-big-TOC.txt
-rw-r--r-- 1 cassandra cassandra 56 Apr 20 12:05 md-1-big-Summary.db
-rw-r--r-- 2 cassandra cassandra 4683 Apr 20 12:05 md-1-big-Statistics.db
-rw-r--r-- 2 cassandra cassandra 32 Apr 20 12:05 md-1-big-Index.db
-rw-r--r-- 2 cassandra cassandra 16 Apr 20 12:05 md-1-big-Filter.db
-rw-r--r-- 2 cassandra cassandra 10 Apr 20 12:05 md-1-big-Digest.crc32
-rw-r--r-- 2 cassandra cassandra 134 Apr 20 12:05 md-1-big-Data.db
-rw-r--r-- 2 cassandra cassandra 43 Apr 20 12:05 md-1-big-CompressionInfo.db
-rw-r--r-- 1 cassandra cassandra 31 Apr 20 12:05 manifest.json
-rw-r--r-- 1 cassandra cassandra 20480 Apr 20 12:23 users-201904201800.tar
lrwxrwxrwx 1 cassandra cassandra 41 Apr 20 15:56 employee -> /bitnami/cassandra/data/data/backup/users
สร้างโครงสร้างตารางโดยใช้ไฟล์ .cql ที่สร้างขึ้นจากสแนปชอตการสำรองข้อมูล
เมื่อคุณดำเนินการสำรองข้อมูลสำหรับ keyspace จะสร้างไฟล์ชื่อ schema.cql ที่มีภาษา定义ข้อมูล (DDL) ของออบเจ็กต์ที่อยู่ใน keyspace
ใช้ schema.cql เพื่อสร้างออบเจ็กต์ employee ซึ่งถูกลบโดยไม่ได้ตั้งใจ
$ cqlsh -u cassandra -p ******** -f schema.cql
Warnings: dclocal_read_repair_chance table option has been deprecated and will be removed in version 4.0
dclocal_read_repair_chance table option has been deprecated and will be removed in version 4.0
$ cqlsh -u cassandra -p ******* -f schema.cql
กู้คืนข้อมูลจากสแนปชอตโดยใช้ sstableloader ซึ่งอ่านทุก sstables จากการสำรองข้อมูลและสตรีมข้อมูลเข้าไปในคลัสเตอร์ จากนั้นส่งส่วนข้อมูลที่เกี่ยวข้องไปยังแต่ละโหนดตามกลยุทธ์การจำลองที่กำหนดในคลัสเตอร์
Syntax: sstableloader -u <username> -pw password -d <hostname> <employee table softlink name with location>ใช้คำสั่งต่อไปนี้เพื่อกู้คืนข้อมูล:
$ sstableloader -u cassandra -pw ******** -d cassandra-cluster-1-node-0 /bitnami/cassandra/data/data/backup/users/employee
Established connection to initial hosts
Opening sstables and calculating sections to stream
Streaming relevant part of /bitnami/cassandra/data/data/backup/users/md-1-big-Data.db to [/10.128.0.2, /10.128.0.3, /10.128.0.4]
progress: [/10.128.0.2]0:0/1 0 % [/10.128.0.3]0:0/1 0 % [/10.128.0.4]0:1/1 100% total: 33% 0.032KiB/s (avg: 0.032KiB/s)
progress: [/10.128.0.2]0:0/1 0 % [/10.128.0.3]0:0/1 0 % [/10.128.0.4]0:1/1 100% total: 33% 0.000KiB/s (avg: 0.031KiB/s)
progress: [/10.128.0.2]0:0/1 0 % [/10.128.0.3]0:1/1 100% [/10.128.0.4]0:1/1 100% total: 66% 0.113KiB/s (avg: 0.050KiB/s)
progress: [/10.128.0.2]0:1/1 100% [/10.128.0.3]0:1/1 100% [/10.128.0.4]0:1/1 100% total: 100% 85.129KiB/s (avg: 0.074KiB/s)
progress: [/10.128.0.2]0:1/1 100% [/10.128.0.3]0:1/1 100% [/10.128.0.4]0:1/1 100% total: 100% 0.000KiB/s (avg: 0.073KiB/s)
progress: [/10.128.0.2]0:1/1 100% [/10.128.0.3]0:1/1 100% [/10.128.0.4]0:1/1 100% total: 100% 0.000KiB/s (avg: 0.073KiB/s)
Summary statistics:
Connections per host : 1
Total files transferred : 3
Total bytes transferred : 0.393KiB
Total duration : 5346 ms
Average transfer rate : 0.073KiB/s
Peak transfer rate : 0.074KiB/s
ทำซ้ำขั้นตอนเหล่านี้สำหรับทุกโหนดเพื่อดึงข้อมูลจาก sstables ของพวกเขา
ซ่อมแซมข้อมูลโดยใช้ nodetool repair ซึ่งเปรียบเทียบทุก replicas ของข้อมูลที่จัดเก็บบนโหนดที่รันคำสั่ง และอัปเดตแต่ละ replica ให้เป็นเวอร์ชันล่าสุด
$ nodetool repair -u Cassandra -pw ********
[2019-04-21 07:59:14,701] Starting repair command #1 (5b123ad0-640b-11e9-a0e3-570eb7f8fd5f), repairing keyspace users with repair options (parallelism: parallel, primary range: false, incremental: true, job threads: 1, ColumnFamilies: [], dataCenters: [], hosts: [], # of ranges: 768, pull repair: false)
[2019-04-21 07:59:16,450] Repair completed successfully
[2019-04-21 07:59:16,451] Repair command #1 finished in 1 second
[2019-04-21 07:59:16,460] Replication factor is 1. No repair is needed for keyspace 'system_auth'
[2019-04-21 07:59:16,474] Starting repair command #2 (5c22e780-640b-11e9-a0e3-570eb7f8fd5f), repairing keyspace system_traces with repair options (parallelism: parallel, primary range: false, incremental: true, job threads: 1, ColumnFamilies: [], dataCenters: [], hosts: [], # of ranges: 513, pull repair: false)
finished (progress: 1%)
[2019-04-21 07:59:17,653] Repair completed successfully
[2019-04-21 07:59:17,653] Repair command #2 finished in 1 second
ตรวจสอบข้อมูลในตาราง employee ซึ่งเราลบไป คำสั่งก่อนหน้ากู้คืนข้อมูลจากการสำรองข้อมูลที่คุณสร้างไว้ก่อนหน้านี้ ตอนนี้คุณต้องตรวจสอบข้อมูลเพื่อดูว่าถูกกู้คืนอย่างถูกต้องหรือไม่
$ cqlsh -u cassandra -p ********
Connected to Test_Cassandra at 127.0.0.1:9042.
[cqlsh 5.0.1 | Cassandra 3.11.4 | CQL spec 3.4.4 | Native protocol v4]
Use HELP for help.
cassandra@cqlsh> use users;
cassandra@cqlsh:users> select * from employee;
emp_id | employee_address | employee_name
--------+------------------+---------------
8796   | Singapore        | Joy
5647   | London           | Mike
3452   | Canada           | Nancy
6453   | China            | John
(4 rows)
สรุป
ในบทความนี้ คุณได้เรียนรู้วิธีการสำรองข้อมูลและกู้คืนตารางเข้าไปในฐานข้อมูล Cassandra อย่างไรก็ตาม หากคุณต้องการกู้คืน keyspace/ฐานข้อมูลเต็มรูปแบบ ให้ใช้ขั้นตอนข้างต้นโดยไม่ต้องมีส่วนกู้คืนตาราง คุณต้องสร้าง keyspace ใหม่และโหลดข้อมูลโดยใช้ sstableloader
จำนวนโหนดในคลัสเตอร์ฐานข้อมูลต้นทางและปลายทางไม่สำคัญกับ sstableloader เนื่องจากมันอ่านแต่ละ sstables จากการสำรองข้อมูล จากนั้นสตรีมข้อมูลเข้าไปในคลัสเตอร์ขณะวางข้อมูลตามกลยุทธ์การจำลองที่กำหนดในคลัสเตอร์
ใช้แท็บ Feedback เพื่อแสดงความคิดเห็นหรือถามคำถาม
เพิ่มประสิทธิภาพสภาพแวดล้อมของคุณด้วยการจัดการ การกำหนดค่า และการบริหารจัดการโดยผู้เชี่ยวชาญ
ผู้เชี่ยวชาญด้านบริการแอปพลิเคชันของ Rackspace (RAS) ให้บริการมืออาชีพและบริการที่จัดการทั่วพอร์ตโฟลิโอแอปพลิเคชันที่กว้างขวาง:
- แพลตฟอร์มอีคอมเมิร์ซและประสบการณ์ดิจิทัล
- การวางแผนทรัพยากรองค์กร (ERP)
- Business Intelligence
- Salesforce Customer Relationship Management (CRM)
- ฐานข้อมูล
- โฮสติ้งอีเมลและประสิทธิภาพการทำงาน
เราให้บริการ:
- ความเชี่ยวชาญที่ไร้ความลำเอียง: เราลดความซับซ้อนและนำทางการเดินทางการทำให้ทันสมัยของคุณ โดยเน้นความสามารถที่ส่งมอบคุณค่าทันที
- Fanatical Experience™: เรารวมแนวทาง Process first. Technology second.® กับการสนับสนุนทางเทคนิคที่专心เพื่อให้โซลูชันที่ครอบคลุม
- พอร์ตโฟลิโอที่ไม่มี對手: เราใช้ประสบการณ์คลาวด์ที่กว้างขวางเพื่อช่วยคุณเลือกและปรับใช้เทคโนโลยีที่เหมาะสมบนคลาวด์ที่เหมาะสม
- การส่งมอบที่คล่องตัว: เราพบคุณที่จุดที่คุณอยู่ในการเดินทางของคุณและปรับความสำเร็จของเราให้สอดคล้องกับของคุณ
แชทตอนนี้เพื่อเริ่มต้น
