

เผยแพร่ครั้งแรกในเดือนพฤศจิกายน 2020 ที่ ObjectRocket.com/blog
ที่ Rackspace ทีม ObjectRocket สามารถช่วยคุณจัดการ MongoDB® databases ของคุณ เราเสนอ disaster recovery, replication, fault tolerance และ high availability สำหรับ MongoDB database ของคุณ
บทนำ
ObjectRocket ปัจจุบันเสนอ Sharded และ Replica MongoDB instance options แต่เบื้องหลัง เราใช้ three-member replica sets เสมอสำหรับ data redundancy และ fault tolerance Sharded instances ประกอบด้วย dedicated mongos servers, config servers และ shards เอง ซึ่งแต่ละอันเป็น three-member replica set
อย่างไรก็ตาม disaster recovery เป็นเรื่องแตกต่าง ObjectRocket เสนอ disaster recovery scheme ที่ Sharded และ Replica MongoDB instances ของคุณได้รับ mirrored member replica sets ใน data center อื่นด้วยค่าใช้จ่ายเพิ่มเติม ที่คุณสามารถใช้ในกรณี disaster event
The Package (แพ็กเกจ)
ObjectRocket managed MongoDB instances ทั้งหมดมาพร้อม high availability, replication (data redundancy) และ fault tolerance เป็นแพ็กเกจ
High Availability (ความพร้อมใช้งานสูง)
ด้วย high availability (HA) คุณสามารถเข้าถึงข้อมูลของคุณตลอดเวลาผ่านเทคโนโลยีต่างๆ อย่างไรก็ตาม key component ของเกือบทุก HA solution คือ replica ของข้อมูลของคุณ นี่คือที่ที่ data redundancy เข้ามามีบทบาท คุณเห็นเพียง database เดียว แต่เบื้องหลังมี exact copies (replicas) สองหรือมากกว่าของข้อมูลนั้น ซึ่งช่วยให้เกิดการ shift จาก replica set node หนึ่งไปอีกตัวในกรณีล้มเหลว
Fault Tolerance (ความทนทานต่อข้อผิดพลาด)
Fault tolerance เป็นคุณสมบัติที่ทำให้ระบบดำเนินการต่อได้อย่างถูกต้องในกรณีที่ component ภายใน fault zone เดียวล้มเหลว เพื่อให้แน่ใจถึง business continuity เราใช้ hosts หรือ servers ที่ต่างกันสำหรับแต่ละ member ของ shard's replica-set ของคุณ ดังนั้นหากหนึ่งตัวล้ม อื่นๆ ยังทำงานต่อได้
Replication (Data Redundancy) (การจำลอง/ความซ้ำซ้อนของข้อมูล)
MongoDB replication เป็นกระบวนการ synchronize data ข้าม multiple servers ที่ application level Replication ให้ redundancy และเพิ่ม data availability ด้วย multiple copies ของข้อมูลบน database servers ที่ต่างกัน Replication ปกป้อง database จากการสูญเสีย single server และช่วยให้คุณ recover จาก hardware failure และ service interruptions ด้วย additional copies ของข้อมูล คุณสามารถ dedicate หนึ่งหรือมากกว่าสำหรับ disaster recovery, reporting หรือ backup
Disaster Recovery (Optional) (Disaster Recovery - ทางเลือก)
Disaster Recovery (DR) เป็นพื้นที่การวางแผนที่ปกป้ององค์กรจาก effects ของ significant negative events เช่น natural calamities, power failure ที่อาจทำให้ data center-level outage เป้าหมายของ DR คือให้ business ดำเนินต่อไปได้ใกล้เคียงกับปกติมากที่สุด
Use Case Without DR (Use Case โดยไม่มี DR)
สมมติสถานการณ์ที่คุณมียอดขายสูงตลอดปี โดยเฉพาะ Cyber Monday และช่วงเทศกาลวันหยุด
สถาปัตยกรรมจะมีลักษณะอย่างไร?
ในฐานะบริษัทสหรัฐฯ คุณต้องการเก็บข้อมูลภายในสหรัฐฯ ดังนั้นมาใช้ DFW data center ของเราเก็บข้อมูลของคุณ และ IAD datacenter เก็บ backup
เราบรรลุ HA โดยการ mirror ข้อมูลของคุณไปยังสองโหนดที่ทำหน้าที่เป็น secondary nodes หาก primary ล้มเหลวด้วยเหตุผลใดเหตุผลหนึ่ง secondary จะกลายเป็น primary node ใหม่ แต่ยังมี backup อีกตัว ในขณะเดียวกัน ทีมสนับสนุนของเราจะ recover โหนดที่ล้มเหลวและ sync กับ primary ใหม่
MongoDB สามารถ scale out แบบ horizontal ผ่าน single large Replica sets โดยใช้หนึ่ง primary และสอง secondary nodes พร้อม heartbeat communication สำหรับ up (หรือ down) states และ replication ไปยัง secondaries เกิดขึ้นผ่าน oplog
เราบรรลุ fault tolerance โดยการมีแต่ละ host บน hardware ที่ต่างกันภายใน datacenter เดียวกัน ดังนั้นหาก hardware ใดล้มเหลว MongoDB ของคุณยังคงทำงานได้
โดยทั่วไป shard อาจเป็น single MongoDB instance อย่างไรก็ตาม ตามที่กล่าวไว้ก่อนหน้านี้ replica sets บน ObjectRocket รวมถึงสาม MongoDB instances ตามภาพต่อไปนี้:
Shard:
- DFWNODE1: PRIMARY
- DFWNODE2: SECONDARY
- DFWNODE3: SECONDARY
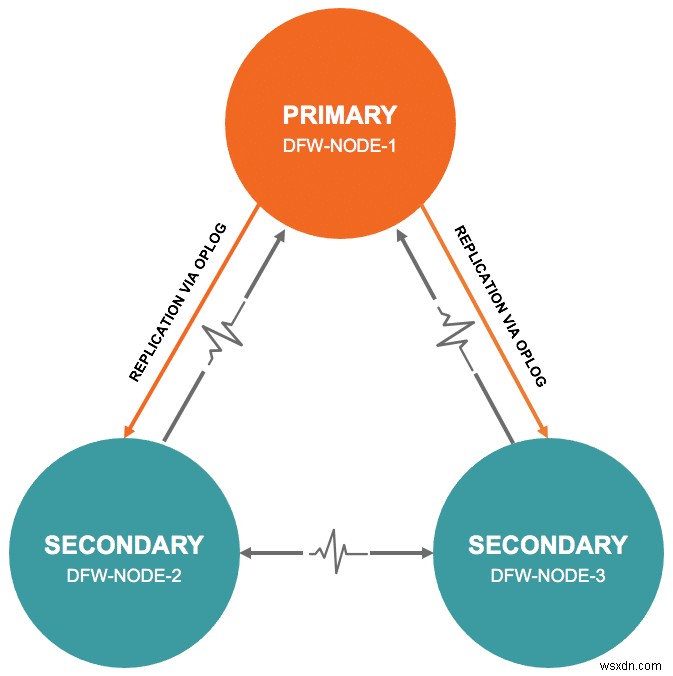
How HA, Data Redundancy และ Fault Tolerance ทำงานใน ObjectRocket
ในกรณี maintenance, downtime หรือ failure ระบบสามารถสลับ primary กับ secondary nodes ใดๆ และดำเนินต่อไปได้โดยไม่มีปัญหา ดังนั้นจึงให้ HA
Data ถูก replicate จาก PRIMARY node ไปยัง SECONDARY nodes ผ่าน oplog ดังนั้นจึงบรรลุ data redundancy
เกี่ยวกับ Fault Tolerance มาลองจินตนาการสถานการณ์ที่ไม่น่าจะเกิดขึ้นว่า server ที่ host หนึ่งใน Replica set members ชำรุด ไม่ว่าจะเป็น primary หรือ secondary node ที่ล้มเหลว MongoDB instance ของคุณยังคงทำงานใน two-node replica set จนกว่าทีมสนับสนุนจะแก้ไขปัญหา
Use Case With DR (Use Case พร้อม DR)
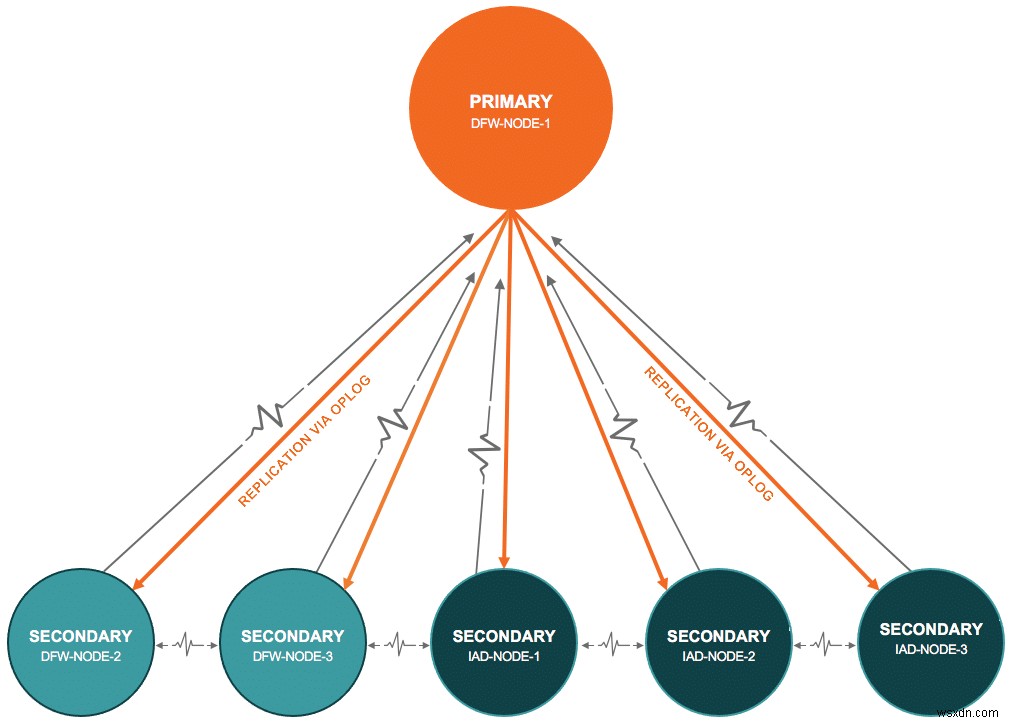
Scheme ของเรา mirror instance ปัจจุบันของคุณ (ไม่ว่าคุณจะเพิ่ม shards จำนวนเท่าไรก็ตาม) ในหนึ่งใน data centers ที่ใกล้ที่สุดกับ instance เรายังมี DR plan ตั้งค่าไว้ใน IAD สำหรับคุณ WE สามารถ connect IAD replica-set members ไปยัง primary node ใน DFW3 พร้อมข้อมูลของคุณ replicated synchronously ข้าม regions นี้รับรองว่าข้อมูลของคุณ up to date ตามตัวอย่างต่อไปนี้:
Shard:
- DFWNODE1: PRIMARY
- DFWNODE2: SECONDARY
- DFWNODE3: SECONDARY
- IADNODE1: SECONDARY
- IADNODE2: SECONDARY
- IADNODE3: SECONDARY
สรุป
HA, replication และ fault tolerance รวมกับ disaster recovery บนแพลตฟอร์ม ObjectRocket นอกจากนี้ เรายัง back ทั้งหมดนี้ด้วย smart people—เก็บคุณให้ปลอดภัยและเสถียรในช่วง peak times
เรียนรู้เพิ่มเติมเกี่ยวกับ Managed MongoDB
ใช้แท็บ Feedback เพื่อแสดงความคิดเห็นหรือถามคำถาม คุณยังสามารถเริ่มการสนทนากับเราได้
