

เผยแพร่ครั้งแรกโดย Tricore: 2 สิงหาคม 2560
แม้การเริ่มต้นใช้งาน MongoDB จะง่ายดาย แต่ปัญหาที่ซับซ้อนมากขึ้นจะเกิดขึ้นเมื่อคุณสร้างแอปพลิเคชัน คุณอาจพบว่าตัวเองกำลังสงสัยอย่าง:
- จะทำการซิงค์ใหม่ (re-sync) สมาชิกใน Replica Set ได้อย่างไร?
- จะกู้คืน MongoDB หลังจากเกิด Crash ได้อย่างไร?
- เมื่อไหร่ควรใช้ข้อกำหนด GridFS ของ MongoDB เพื่อจัดเก็บและดึงไฟล์?
- จะแก้ไขข้อมูลที่เสียหาย (Corrupted Data) ได้อย่างไร?
บทความบล็อกนี้แชร์เคล็ดลับบางประการสำหรับการจัดการสถานการณ์เหล่านี้เมื่อคุณใช้ MongoDB
เคล็ดลับที่ 1: อย่าพึ่งพาคำสั่ง Repair เพื่อกู้คืนข้อมูลของคุณ
หากฐานข้อมูลของคุณ Crash และคุณไม่ได้รันด้วยแฟล็ก --journal อย่าใช้ข้อมูลของเซิร์ฟเวอร์นั้น
คำสั่ง repair ของ MongoDB จะตรวจสอบทุกเอกสารที่พบและสร้างสำเนาที่สะอาด อย่างไรก็ตาม โปรดทราบว่ากระบวนการนี้ใช้เวลานาน ใช้พื้นที่ดิสก์มาก (เท่ากับปริมาณที่ใช้อยู่) และข้ามระเบียนที่เสียหาย เนื่องจากกระบวนการ Replication ของ MongoDB ไม่สามารถแก้ไขข้อมูลที่เสียหายได้ คุณจึงต้องแน่ใจว่าล้างข้อมูลที่อาจเสียหายก่อนการซิงค์ใหม่
เคล็ดลับที่ 2: ซิงค์ใหม่สมาชิกของ Replica Set
เพื่อซิงค์ใหม่สมาชิกของ Replica Set ให้แน่ใจว่ามี Secondary อย่างน้อยหนึ่งตัวและ Primary อย่างน้อยหนึ่งตัวทำงานอยู่ จากนั้นให้แน่ใจว่าคุณล็อกอินเป็นผู้ใช้ชื่อ Oracle และหยุดบริการ MongoDB
ล็อกอินเป็นผู้ใช้ชื่อ MongoDB และย้ายไฟล์ข้อมูลทั้งหมดในโฟลเดอร์สำรอง (backup) เพื่อให้สามารถกู้คืนได้หากพบปัญหา หากไฟล์เก่ายังคงอยู่ในโฟลเดอร์สำรอง คุณสามารถลบได้ หากไม่แน่ใจว่าจะหาไฟล์ข้อมูลได้ที่ไหน ให้ดูใน /etc/mongod.conf بصفته ผู้ใช้ชื่อ Oracle เริ่มบริการ MongoDB
ล็อกอินเข้าฐานข้อมูลเพื่อตรวจสอบ คุณไม่จำเป็นต้องยืนยันตัวตนเพื่อเข้าถึงฐานข้อมูลจนกว่าสมาชิกจะซิงค์ใน Replica Set
หลังจากกระบวนการ Replication เสร็จสิ้น สถานะจะเปลี่ยนจาก STARTUP2 เป็น SECONDARY
เคล็ดลับที่ 3: อย่าใช้ GridFS สำหรับข้อมูลไบนารีขนาดเล็ก
MongoDB ใช้ข้อกำหนด GridFS เพื่อจัดเก็บและดึงไฟล์ขนาดใหญ่ โดยสรุป GridFS จะแบ่งอ็อบเจกต์ไบนารีขนาดใหญ่ออกก่อนจัดเก็บในฐานข้อมูล GridFS ต้องการสองคิวรี่: หนึ่งสำหรับดึงข้อมูลเมตาของไฟล์ และอีกหนึ่งสำหรับดึงเนื้อหา ดังนั้น หากคุณใช้ GridFS จัดเก็บไฟล์ขนาดเล็ก คุณจะเพิ่มจำนวนคิวรี่ที่แอปพลิเคชันต้องทำเป็นสองเท่า
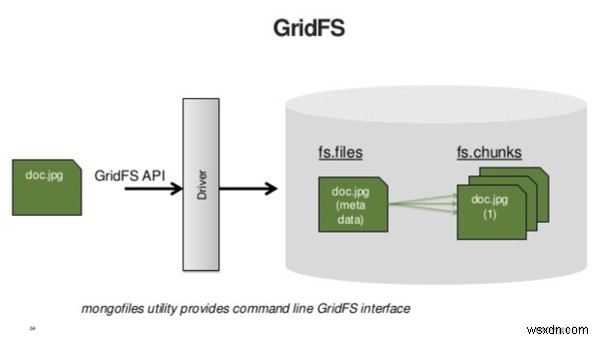
แหล่งที่มา: https://www.slideshare.net
GridFS ออกแบบมาเพื่อจัดเก็บข้อมูลขนาดใหญ่ (Big Data) หมายถึงข้อมูลที่ใหญ่เกินกว่าจะใส่ในเอกสารเดียวได้ กฎทั่วไปคือ สิ่งที่ใหญ่เกินกว่าจะโหลดในไคลเอ็นต์ น่าจะไม่ใช่สิ่งที่คุณต้องการโหลดทั้งหมดทีเดียวบนเซิร์ฟเวอร์ ทางเลือกคือการสตรีมมิ่ง (Streaming) อะไรที่คุณวางแผนจะสตรีมไปยังไคลเอ็นต์ นั้นเป็นผู้สมัครใจที่ดีสำหรับ GridFS
เคล็ดลับที่ 4: ลดการเข้าถึงดิสก์ให้น้อยที่สุด
นักพัฒนารู้ดีว่าการเข้าถึงข้อมูลจาก RAM เร็ว และจากดิสก์ช้า
แม้คุณจะรู้ว่าการลดจำนวนการเข้าถึงดิสก์เป็นเทคนิคการเพิ่มประสิทธิภาพที่ดี คุณอาจไม่รู้ว่าจะทำได้อย่างไร
วิธีหนึ่งคือใช้ Solid-State Drive (SSD) SSD ทำงานหลายอย่างเร็วกว่า Hard Disk Drive (HDD) แบบเดิมมาก และทำงานร่วมกับ MongoDB ได้ดีมาก แต่ก็มักเล็กกว่าและแพงกว่า
ภาพต่อไปนี้เปรียบเทียบ SSD และ HDD
แหล่งที่มา: https://www.serverintellect.com
อีกวิธีหนึ่งในการลดการเข้าถึงดิสก์คือเพิ่ม RAM แต่วิธีนี้จะช่วยได้เพียงช่วงเวลาหนึ่ง เพราะในที่สุด RAM ของคุณจะไม่รองรับขนาดข้อมูลได้
คำถามคือ เราจะจัดเก็บข้อมูลเทราไบต์หรือเพตาไบต์บนดิสก์ โปรแกรมแอปพลิเคชันที่เข้าถึงข้อมูลที่ถูกขอบ่อยครั้งในหน่วยความจำ และย้ายข้อมูลจากดิสก์ไปหน่วยความจำให้น้อยที่สุดได้อย่างไร?
หากคุณเข้าถึงข้อมูลทั้งหมดแบบสุ่มในเวลาจริง คำตอบคือคุณจะต้องการ RAM มากมาย อย่างไรก็ตาม แอปพลิเคชันส่วนใหญ่ไม่ทำงานแบบนี้ ข้อมูลล่าสุดถูกเข้าถึงบ่อยกว่าข้อมูลเก่า ผู้ใช้บางกลุ่มมีกิจกรรมมากกว่า และภูมิภาคบางแห่งมีลูกค้ามากกว่า แอปพลิเคชันที่เข้าข้อกำหนดนี้สามารถออกแบบให้เก็บเอกสารบางส่วนในหน่วยความจำและเข้าถึงดิสก่นานๆ ครั้งได้
เคล็ดลับที่ 5: เริ่ม MongoDB ตามปกติหลังจากฐานข้อมูล Crash
หากคุณรัน Journaling และระบบ Crash แบบกู้คืนได้ คุณสามารถรีสตาร์ทฐานข้อมูลตามปกติได้ ให้แน่ใจว่าคุณใช้ตัวเลือกปกติทั้งหมด โดยเฉพาะ --dbpath (เพื่อให้หาไฟล์ Journal ได้) และ --journal
MongoDB จะแก้ไขข้อมูลของคุณโดยอัตโนมัติก่อนที่จะเริ่มยอมรับการเชื่อมต่อ กระบวนการนี้อาจใช้เวลานานหลายนาทีสำหรับชุดข้อมูลขนาดใหญ่ แต่เร็วกว่าการรัน Repair บนชุดข้อมูลขนาดใหญ่มาก
ไฟล์ Journal จัดเก็บในไดเรกทอรี journal อย่าลบไฟล์เหล่านี้
เคล็ดลับที่ 6: Compact ฐานข้อมูลโดยใช้คำสั่ง Repair
คำสั่ง Repair โดยปฏิบัติแล้วทำการ mongodump แล้วตามด้วย mongorestore สร้างสำเนาข้อมูลที่สะอาด ในกระบวนการนี้ ยังลบ "รู" ว่างในไฟล์ข้อมูลออกไปด้วย
คำสั่ง Repair บล็อกการทำงาน และต้องการพื้นที่ดิสก์สองเท่าของขนาดฐานข้อมูลปัจจุบัน อย่างไรก็ตาม หากคุณมีเครื่องอื่น คุณสามารถทำกระบวนการเดียวกันด้วยตนเองโดยใช้ mongodump และ mongorestore
เพื่อทำกระบวนการด้วยตนเอง ใช้ขั้นตอนต่อไปนี้:
-
Step down เครื่อง Hyd1 และ
fsyncและlock:rs.stepDown() db.runCommand({fsync : 1, lock : 1}) -
Dump ไฟล์ไปที่ Hyd2:
Hyd2$ mongodump --host Hyd1 -
สร้างสำเนาไฟล์ข้อมูลใน Hyd1 เพื่อเก็บเป็นสำรอง แล้วลบไฟล์ข้อมูลต้นฉบับและรีสตาร์ท Hyd1 ด้วยข้อมูลว่าง
-
กู้คืนจาก Hyd2 เพื่อกู้คืนไฟล์ข้อมูล ให้พิมพ์คำสั่งต่อไปนี้:
Hyd2$ mongorestore --host Hyd1 --port 10000 # ระบุพอร์ตหากไม่ใช่ 27017
สรุป
การเปลี่ยนแปลงเหล่านี้เพิ่มประสิทธิภาพ MongoDB ของเราอย่างมีนัยสำคัญ หากคุณวางแผนใช้ MongoDB คุณอาจต้องการบุ๊กมาร์กบทความนี้ แล้วกลับมาตรวจสอบเคล็ดลับแต่ละข้อครั้งหน้าเมื่อเริ่มโครงการใหม่
ในภาคที่ 2 ของซีรีส์ 2 ส่วนนี้ เราจะแชร์เคล็ดลับบางประการที่ช่วยให้องค์กรขนาดใหญ่ออกแบบ เพิ่มประสิทธิภาพ และนำคุณสมบัติ MongoDB ที่มีประโยชน์ไปใช้ได้จริง
ใช้แท็บ Feedback เพื่อแสดงความคิดเห็นหรือถามคำถาม
