

ในบทความก่อนหน้า คุณรู้จัก SQL Server แบบสรุป และวิธีติดตั้ง SQL Server บนคอมพิวเตอร์ ในส่วนนี้เราจะเรียนรู้เกี่ยวกับสถาปัตยกรรมของ SQL Server
เราจะแบ่งสถาปัตยกรรมของ SQL Server ออกเป็นส่วนต่อไปนี้เพื่อความเข้าใจที่ง่ายขึ้น:
- General Architecture (สถาปัตยกรรมทั่วไป)
- Memory Architecture (สถาปัตยกรรมหน่วยความจำ)
- Data File Architecture (สถาปัตยกรรมไฟล์ข้อมูล)
- Log File Architecture (สถาปัตยกรรมไฟล์บันทึก)
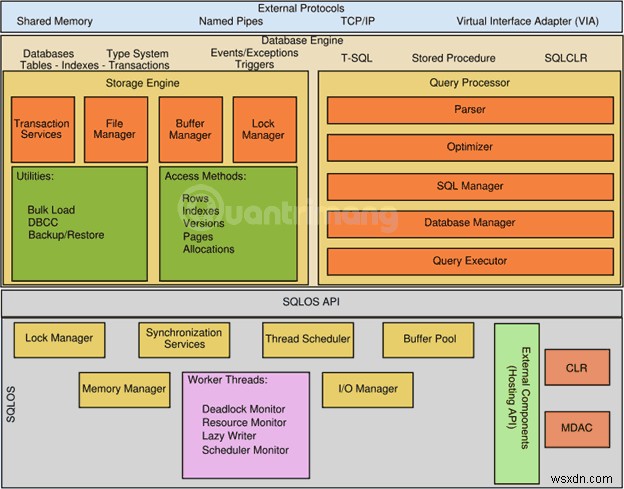
สถาปัตยกรรมทั่วไป (General Architecture)
- Client: จุดที่สร้างคำขอ (Request)
- Query: คำสั่ง SQL เป็นภาษาระดับสูง
- Logical Units: คีย์เวิร์ด นิพจน์ ตัวดำเนินการ ฯลฯ
- Network Packets: โค้ดที่เกี่ยวข้องกับเครือข่าย
- Protocols: ใน SQL Server มี 4 โปรโตคอล:
- Shared Memory: สำหรับการเชื่อมต่อในเครื่องเดียวและการแก้ไขปัญหา
- Named Pipes: สำหรับการเชื่อมต่อใน LAN
- TCP/IP: สำหรับการเชื่อมต่อใน WAN
- VIA (Virtual Interface Adapter): ต้องการฮาร์ดแวร์พิเศษ ไม่รองรับใน SQL 2012
- Server: ที่ติดตั้ง SQL Services และมีฐานข้อมูล
- Relational Engine: ที่ประมวลผลจริง ประกอบด้วย Query Analyzer, Query Optimizer, Query Runtime
- Query Parser (Command Parser) และ Compiler (Translator): ทั้งสองตัวรับผิดชอบตรวจสอบไวยากรณ์ของคำสั่ง และแปลงคำสั่งเป็นภาษาเครื่อง
- Query Optimizer: เตรียมผลลัพธ์เป็น Execution Plan โดยรับ Input เป็น Query, Statistics และ Algebrizer Tree
- Execution Plan: แผนผังเส้นทาง มีลำดับขั้นตอนที่นำไปสู่การประมวลผลคำสั่ง
- Query Executor: ที่ประมวลผลคำสั่งทีละขั้นตอน ด้วย Execution Plan และติดต่อ Storage Engine
- Storage Engine: รับผิดชอบจัดเก็บและดึงข้อมูลในระบบจัดเก็บ (Drives, SANs) จัดการข้อมูล Locking และ Transactions
- SQL OS: อยู่ระหว่างเครื่องโฮสต์ (Windows OS) และ SQL Server ทุกการดำเนินการบน Database Engine "ดูแล" โดย SQL OS SQL OS ให้บริการ OS ต่างๆ เช่น การจัดการหน่วยความจำด้วย Buffer Pool, Log Buffer, Deadlock Detection, ใช้โครงสร้าง Block และ Lock
- Checkpoint: กระบวนการภายใน เขียนหน้าที่ปรับเปลี่ยนแล้ว (Dirty Pages) จาก Buffer Cache ไปยังดิสก์จริง นอกจากนี้ยังเขียน Log จาก Log Buffer ไปยังไฟล์จริง การบันทึก Dirty Pages ลงดิสก์ เรียกว่า Hardening of dirty pages
- Lazy Writer: Lazy Writer จะผลัก Dirty Pages ไปยังฮาร์ดดิสก์ด้วยเหตุผลที่ต่างออกไป คือ เพื่อ釋放หน่วยความจำใน Buffer Pool เกิดขึ้นเมื่อ SQL Server ขาดหน่วยความจำ กระบวนการนี้ควบคุมโดย Internal process ไม่มีการตั้งค่า
SQL Server ตรวจสอบการใช้หน่วยความจำอย่างต่อเนื่องเพื่อประเมินความพร้อมของทรัพยากรและการแข่งขัน ให้แน่ใจว่ามีพื้นที่ว่างอยู่เสมอ เมื่อตรวจพบความขัดแย้งของทรัพยากร จะกระตุ้น Lazy Writer ย้าย Dirty Page บางส่วนไปยังดิสก์และปล่อยหน่วยความจำ ใช้演算法 Least Recently Used (LRU) เพื่อกำหนดว่าหน้าไหนจะถูกผลักไปฮาร์ดดิสก์ หาก Lazy Writer ทำงานตลอดอาจสร้างคอขวดด้านหน่วยความจำ
สถาปัตยกรรมหน่วยความจำ (Memory Architecture)
คุณสมบัติสำคัญของสถาปัตยกรรมหน่วยความจำ:
- เป้าหมายการออกแบบพื้นฐานของซอฟต์แวร์ฐานข้อมือทุกตัวคือลด Disk I/O เนื่องจากการอ่าน/เขียนดิสก์เป็นการกระทำที่ใช้ทรัพยากรมากที่สุด
- หน่วยความจำภายใน Windows เรียกว่า Virtual Address Space แบ่งปันระหว่าง Kernel Mode (โหมด OS) และ User Mode (แอปพลิเคชันอย่าง SQL Server)
- User Address Space ของ SQL Server แบ่งเป็น 2 ส่วน: MemToLeave และ Buffer Pool
- ขนาดของ MemToLeave (MTL) และ Buffer Pool (BPool) ถูกตัดสินใจโดย SQL Server ระหว่างกระบวนการบูท
- Buffer Management เป็นองค์ประกอบสำคัญหากต้องการประสิทธิภาพ I/O สูง ประกอบด้วย 2 กลไก: Buffer Manager เพื่อเข้าถึงและอัปเดตฐานข้อมูล และ Buffer Pool pages เพื่อตัด I/O ไฟล์เข้าไปในฐานข้อมูล
- Buffer Pool แบ่งเป็นหลายส่วน สำคัญที่สุดคือ Buffer Cache และ Procedure Cache Buffer Cache เก็บหน้าข้อมูลในหน่วยความจำ เพื่อให้ข้อมูลที่เข้าถึงบ่อยสามารถดึงจากแคชได้ กระบวนการแทนที่จะอ่านหน้าข้อมูลจากดิสก์ การอ่านข้อมูลจากแคชเพิ่มประสิทธิภาพโดยลดจำนวนการดำเนินการ I/O ซึ่งช้ากว่าการเข้าถึงข้อมูลจากหน่วยความจำ
- Procedure Cache เก็บ Stored Procedures และ Execution Plan เพื่อเพิ่มประสิทธิภาพจำนวนครั้งที่สร้าง Execution Plan คุณสามารถหาข้อมูลเกี่ยวกับความจุและการทำงานใน Procedure Cache โดยใช้คำสั่ง DBCC PROCCACHE
- ส่วนอื่นๆ ของ Buffer Pool รวมถึง:
- System-level data structures: มีข้อมูลระดับ Instance เกี่ยวกับฐานข้อมูลและ Locks
- Log Cache: ใช้เฉพาะสำหรับอ่าน/เขียนหน้าธุรกรรม
- Connection Context: แต่ละการเชื่อมต่อกับ Instance มีพื้นที่หน่วยความจำเล็กน้อยเพื่อบันทึกสถานะปัจจุบันของการเชื่อมต่อ รวมถึงพารามิเตอร์ Stored Procedures และ User-defined functions, ตำแหน่งเคอร์เซอร์ ฯลฯ
- Stack Space: Windows จัดสรร Stack Space สำหรับแต่ละ Thread ที่เริ่มต้นกับ SQL Server
สถาปัตยกรรมไฟล์ข้อมูล (Data File Architecture)
สถาปัตยกรรมนี้มีองค์ประกอบดังนี้:
File Group (กลุ่มไฟล์)
ไฟล์ฐานข้อมูลสามารถจัดกลุ่มรวมกันเป็น File Groups เพื่อวัตถุประสงค์ในการกระจายและจัดการ ไฟล์หนึ่งสามารถเป็นสมาชิกของ File Group ได้เพียงกลุ่มเดียว ไฟล์บันทึก (Log files) ไม่สามารถจัดกลุ่มเป็น File Group ได้ เนื่องจากขนาดไฟล์บันทึกถูกจัดการแยกจากปริมาณข้อมูล
มี 2 ประเภทของ File Group ใน SQL Server คือ Primary และ User-defined Primary ประกอบด้วยไฟล์ข้อมูลหลักและไฟล์ใดๆ ที่ไม่ได้ถูกกำหนดให้ File Group เฉพาะ ทุกหน้าสำหรับ System Table ถูกจัดสรรใน Primary User-defined คือ File Group ที่ผู้ใช้กำหนดเอง ระบุโดยใช้คีย์เวิร์ด filegroup ในคำสั่งสร้างฐานข้อมูลหรือลบฐานข้อมูล
File Group ในแต่ละฐานข้อมูลทำหน้าที่เป็น Default File Group เมื่อ SQL Server จัดสรรหน้าให้กับตารางหรือดัชนี (ไม่ได้อยู่ใน File Group ใดๆ ตอนสร้าง) หน้านั้นจะอยู่ใน Default File Group เพื่อเปลี่ยน Default File Group จาก File Group หนึ่งไปอีก File Group ต้องมีสิทธิ์ db_owner fixed database role
Primary เป็น Default File Group ผู้ใช้ต้องมี db_owner fixed database role เพื่อสำรองไฟล์และ File Group เฉพาะ
File (ไฟล์)
ฐานข้อมูลมี 3 ประเภทของไฟล์: Primary (ไฟล์ข้อมูลหลัก), Secondary (ไฟล์ข้อมูลรอง) และ Log (ไฟล์บันทึก) Primary เป็นจุดเริ่มต้นของฐานข้อมูลและชี้ไปยังไฟล์อื่นๆ ในฐานข้อมูล
แต่ละฐานข้อมูลมี Primary เพียงหนึ่งเดียว คุณสามารถตั้งค่าส่วนขยายสำหรับไฟล์ข้อมูลหลักได้ แต่แนะนำให้ใช้ .mdf Secondary data file คือไฟล์นอกเหนือจากไฟล์ข้อมูลหลัก ฐานข้อมูลอาจมีไฟล์ข้อมูลรองมากกว่าหนึ่งหรือไม่มีก็ได้ ส่วนขยายสำหรับไฟล์ข้อมูลเพิ่มเติมควรตั้งเป็น .ndf
Log files เก็บข้อมูลทั้งหมดที่ใช้กู้คืนฐานข้อมูล ฐานข้อมูลต้องมี Log file อย่างน้อยหนึ่งไฟล์ เราสามารถมี Log files หลายไฟล์สำหรับฐานข้อมูลเดียวกัน ส่วนขยายควรเป็น .ldf
ตำแหน่งของไฟล์ทั้งหมดในฐานข้อมูลถูกบันทึกในทั้ง Master database และ Primary file ของฐานข้อมูล ในกรณีส่วนใหญ่ เครื่องมือฐานข้อมูลใช้ตำแหน่งไฟล์จาก Master database
ไฟล์มี 2 ชื่อ: Logical และ Physical Logical ใช้เพื่ออ้างอิงไฟล์ในคำสั่ง T-SQL ทั้งหมด Physical name คือ OS_file_name ต้องปฏิบัติตามกฎของระบบปฏิบัติการ ไฟล์ข้อมูลและไฟล์บันทึกสามารถวางบนระบบไฟล์ FAT หรือ NTFS ได้ แต่ไม่สามารถวางบนระบบไฟล์ที่บีบอัดได้ สามารถมีไฟล์ได้สูงสุด 32,767 ไฟล์ในฐานข้อมูล
Extent (เอกซ์เทนต์)
Extent เป็นหน่วยพื้นฐานที่จัดสรรพื้นที่สำหรับแต่ละตารางและดัชนี แต่ละ Extent มี 8 หน้าติดกัน หรือ 64KB SQL Server มี 2 ประเภทของ Extent คือ Uniform และ Mixed Uniform ประกอบด้วยออบเจ็กต์เดียว Mixed ประกอบด้วยสูงสุด 8 ออบเจ็กต์
Page (หน้า)
Page (หน้า) เป็นหน่วยพื้นฐานในการจัดเก็บข้อมูลของ SQL Server ขนาดของหน้าคือ 8KB เริ่มต้นแต่ละหน้าคือ Header 96 ไบต์ ใช้เก็บข้อมูลระบบ เช่น ประเภทหน้า พื้นที่ว่างบนหน้า และ ID ของเจ้าของหน้า มี 9 ประเภทของหน้าข้อมูลใน SQL Server:
- Data: แถวข้อมูล พร้อมข้อมูลทั้งหมดจาก text, ntext และ image
- Index: รายการดัชนี
- Text/Image: ข้อมูลของ text, ntext และ image
- GAM (Global Allocation Map): ข้อมูลเกี่ยวกับ Extent ที่ระบุ
- SGAM (Shared Global Allocation Map): ข้อมูลเกี่ยวกับ Extent ที่จัดสรรระดับระบบ
- PFS (Page Free Space): ข้อมูลเกี่ยวกับพื้นที่ว่างที่มีอยู่บนหน้า
- IAM (Index Allocation Map): ข้อมูลเกี่ยวกับ Extent ที่ใช้โดยตารางหรือดัชนี
- BCM (Bulk Changed Map): ข้อมูล Extent ที่เปลี่ยนแปลงโดยการดำเนินการจำนวนมากตั้งแต่คำสั่งสำรองล่าสุด
- DCM (Differential Changed Map): ข้อมูลเกี่ยวกับ Extent ที่เปลี่ยนแปลงตั้งแต่คำสั่งสำรองฐานข้อมูลล่าสุด
สถาปัตยกรรมไฟล์บันทึก (Log File Architecture)
Transaction Logs บน SQL Server ทำงานอย่างถูกต้องเมื่อเป็นลำดับของ Log Records แต่ละ Log ถูกระบุโดย Log Sequence Number (LSN) ซึ่งประกอบด้วย ID ของธุรกรรมที่มันเป็นของ
Log Records บันทึกการแก้ไขข้อมูล หรือกิจกรรมที่ดำเนินการ หรือดึงภาพก่อนและหลังการแก้ไขข้อมูล ภาพก่อนหน้าคือสำเนาข้อมูลก่อนดำเนินการ ภาพหลังคือสำเนาข้อมูลหลังดำเนินการเสร็จ
ขั้นตอนในการกู้คืนการดำเนินการ ขึ้นอยู่กับประเภทของ Log
- Logical operation ถูกบันทึก
- เพื่อไปยัง Logical operation ก่อนหน้า การดำเนินการจะถูกทำซ้ำ
- เพื่อกลับไปยัง Logic operation ถัดไป Logic operation ย้อนกลับจะถูกดำเนินการ
- ภาพก่อนและหลังถูกบันทึก
- เพื่อไปยังการดำเนินการก่อนหน้า ภาพหลังจะถูกนำไปใช้
- เพื่อกลับไปยังการดำเนินการถัดไป ภาพก่อนจะถูกนำไปใช้
การดำเนินการต่างๆ ถูกบันทึกใน Transaction Log การดำเนินการต่อไปนี้จะมีอยู่ที่นั่น:
- เริ่มต้นและสิ้นสุดของแต่ละธุรกรรม
- การแก้ไขข้อมูลทั้งหมด (Insert, Update, Delete) รวมถึงการเปลี่ยนแปลง System Stored Procedures หรือคำสั่ง DDL (Data Definition Language) ไปยังตาราง รวมถึง System Table
- การจัดสรรและยกเลิกการจัดสรร Extent และ Page ทั้งหมด
- สร้างหรือลบตารางและดัชนี
Rollback operations ก็ถูกบันทึกเช่นกัน แต่ละธุรกรรมจะจองพื้นที่ใน Log เพื่อให้แน่ใจว่ามีพื้นที่ Log เพียงพอสำหรับ Rollback ในการดำเนินการคำสั่งหรือข้อความผิดพลาด พื้นที่นี้จะถูกปลดปล่อยเมื่อธุรกรรมเสร็จสิ้น
ส่วนของไฟล์ Log จาก Log แรก (ที่จำเป็นสำหรับกู้คืนฐานข้อมูลทั้งหมดสำเร็จ) ถึง Log สุดท้าย เรียกว่า Active Log หรือ Log Activity Section นี่คือส่วน Log ที่จำเป็นสำหรับการกู้คืนฐานข้อมูลเต็ม ไม่มีส่วนใดของ Active Log ถูกทำลาย LSN ของ Log Record แรก เรียกว่า Minimum Recovery LSN (Min LSN)
SQL Server Database Engine แบ่ง Physical log file แต่ละไฟล์ออกเป็นหลาย Virtual Log Files Virtual log file ไม่มีขนาดคงที่ และไม่มีจำนวนคงที่ของ virtual log files สำหรับแต่ละ physical log file
Database Engine เลือกขนาดของ virtual log file อัตโนมัติเมื่อสร้างหรือขยาย log file Database Engine พยายามรักษาจำนวน virtual files ให้น้อย ขนาดของ virtual log file ไม่สามารถกำหนดค่าหรือตั้งค่าโดยผู้ดูแลระบบได้ เฉพาะเมื่อ physical log file ถูกกำหนดขนาดเล็กและค่า growth_increment virtual log file จึงส่งผลต่อประสิทธิภาพระบบ
ค่า Size คือขนาดเริ่มต้นสำหรับ log file และ growth_increment คือปริมาณพื้นที่ที่เพิ่มเข้าไปในไฟล์ทุกครั้งที่ไฟล์ต้องการพื้นที่ใหม่ เมื่อ log file มีขนาดใหญ่เพราะมีการเพิ่มเล็กๆ หลายครั้ง จะมี virtual log files มาก ซึ่งอาจทำให้การเริ่มต้นฐานข้อมูล การสำรอง log และการกู้คืนช้าลง
คำแนะนำคือ ควรกำหนด log file ให้มีค่า Size ใกล้เคียงกับขนาดสุดท้ายที่ต้องการ และค่า growth_increment ที่ใหญ่พอสมควร SQL Server ใช้ Write-Ahead Log (WAL) ให้แน่ใจว่าไม่มีการแก้ไขข้อมูลที่เขียนลงดิสก์ก่อนที่ Log ที่เกี่ยวข้องจะถูกเขียนลงดิสก์ นี่ช่วยรักษาคุณสมบัติ ACID สำหรับธุรกรรม
Algebrizer ใน SQL
Algebrizer เป็นกระบวนการในกระบวนการประมวลผลคำสั่ง เริ่มทำงานหลัง Parser เมื่อ Query Parser พบคำสั่งที่ถูกต้อง จะส่งต่อให้ Algebrizer ทำงาน: Algebrizer รับผิดชอบตรวจสอบออบเจ็กต์และชื่อคอลัมน์ (ที่คุณระบุในคำสั่งหรือที่คำสั่งอ้างอิง) ตัวอย่างเช่น หากชื่อคอลัมน์เขียนผิดในคำสั่ง Algebrizer จะรับผิดชอบยืนยันและสร้างข้อผิดพลาด Algebrizer ยังระบุประเภทข้อมูลทั้งหมดที่กำลังประมวลผลในคำสั่งที่กำหนด Algebrizer ตรวจสอบว่า GROUP BY และคอลัมน์ที่รวมอยู่วางในตำแหน่งที่ถูกต้อง ตัวอย่างเช่น หากคุณเขียนคำสั่งต่อไปนี้และกดเพียง Ctrl+F5 เพื่อ parse จะไม่มีข้อผิดพลาด แต่หากกด F5 เพื่อรันคำสั่ง Algebrizer จะทำงานและส่งคืนข้อผิดพลาด
USE AdventureWorks
GO
SELECT MakeFlag, SUM(ListPrice)
FROM Production.Product
GROUP BY ProductNumber
Checkpoint ใน SQL Server
มี 4 ประเภทของ Checkpoint ใน SQL Server 2012:
- Automatic: ประเภทที่พบบ่อยที่สุด ทำงานเป็น Background process เพื่อให้แน่ใจว่า SQL Server Database สามารถกู้คืนได้ภายในเวลาที่ระบุโดย Recovery Interval ใน Server Configuration Option
- Indirect: Checkpoint นี้มีเฉพาะ SQL Server 2012 เป็น background process เช่นกัน แต่เฉพาะสำหรับผู้ใช้บางคนที่ระบุเวลากู้คืนสำหรับฐานข้อมูลเฉพาะใน Configuration Options เมื่อเลือก Target_Recovery_Time สำหรับฐานข้อมูลเฉพาะ จะทับซ้อน Recovery Interval ที่กำหนดให้ Server หลีกเลี่ยง Automatic checkpoint บนฐานข้อมูลนั้น
- Manual: Checkpoint นี้รันเหมือนคำสั่ง SQL อื่นๆ เมื่อคุณสร้างคำสั่ง checkpoint จะรันจนเสร็จสิ้น Checkpoint นี้รันเฉพาะฐานข้อมูลปัจจุบัน คุณสามารถระบุ Checkpoint_Duration ในตัวเลือกเพื่อระบุว่าต้องการให้ checkpoint ใช้เวลานานเท่าไร
- Internal: بصفผู้ใช้ คุณไม่สามารถควบคุมประเภทนี้ได้ในการดำเนินการเฉพาะเจาะจง เช่น:
- ปิด Checkpoint action บนทุกฐานข้อมูล ยกเว้นการปิดล้มเหลว ไม่ปกติ (ใช้ Shutdown with nowait command)
- เมื่อ Recovery Model เปลี่ยนจาก Full/Bulk-logged เป็น Simple
- ระหว่างการสำรองฐานข้อมูล
- หากฐานข้อมูลอยู่ใน Simple recovery mode กระบวนการ Checkpoint จะทำงานอัตโนมัติ หรือเมื่อ Log เต็ม 70% หรืออิงตาม Recovery Interval ของ Server
- คำสั่ง ALTER DATABASE เพื่อเพิ่มหรือลบ Log/Data files ก็จะเริ่ม Checkpoint
- Checkpoint ยังเกิดขึ้นเมื่อ Recovery Model เป็น Bulk-logged และมีการดำเนินการ Minimally logged operations
นี่อาจเป็นส่วนที่ "น่าสนใจที่สุด" ของ SQL Server แต่วิธีคิดในการเข้าใจสถาปัตยกรรมจะช่วยให้เข้าใจว่าทุกอย่างทำงานอย่างไร หากมีข้อผิดพลาด ก็จะแก้ไขได้ง่ายขึ้น ทำให้ทำงานกับฐานข้อมูลสะดวกขึ้น
ในส่วนต่อไป เราจะเรียนรู้เกี่ยวกับ Management Studio และค่อยๆ เข้าสู่คำสั่งพื้นฐานของ SQL Server
