

Redis ถูกพัฒนาโดยเน้นย้ำประสิทธิภาพ (performance) เราทำ כמיטב יכולתנו (do our best) ในทุก release เพื่อให้คุณได้ประสบการณ์กับผลิตภัณฑ์ที่เสถียรและเร็วที่สุด
อย่างไรก็ตาม หากคุณพบพื้นที่ปรับปรุงประสิทธิภาพของ Redis หรือกำลังสืบสวน performance regression คุณจะต้องการวิธีที่กระชับและเป็นระบบ (concise methodical way) ในการ monitor และ analyze ประสิทธิภาพของ Redis นี่คือเรื่องราวของการปรับปรุงหนึ่งครั้ง
ในที่สุด เราได้ปรับปรุง stream's ingest performance ประมาณ 20% ซึ่งคุณสามารถใช้ประโยชน์ได้แล้วใน Redis v7.0
มาตรฐาน SPEC มาตรฐาน
ก่อนจะเข้าสู่การปรับปรุง เราอยากให้ภาพรวมระดับสูง (high-level idea) ว่าเราไปถึงที่นี่อย่างไร
ตามที่กล่าวไว้ เราต้องการระบุ Redis performance regressions และ/หรือ on-CPU performance improvements ที่เป็นไปได้ เพื่อทำเช่นนั้น เรารู้สึกว่าจำเป็นต้องส่งเสริมชุดมาตรฐานข้ามบริษัทและข้ามชุมชน (cross-company and cross-community standards) ในทุกเรื่องที่เกี่ยวกับ performance และ observability requirements และ expectations
ในข้อความสรุป เรารัน SPEC's benchmarks ตลอดเวลา โดยแยกตาม branch/tag และตีความ performance data ที่ได้ รวมถึง profiler tools/probers outputs และ client outputs ในโหมด "zero-touch" fully automated
เครื่องมือที่ใช้ทั้งหมดเป็น open source และพึ่งพา tools/popular frameworks เช่น memtier_benchmark, redis-benchmark, Linux perf_events, bcc/BPF tracing tools, และ Brendan Greg's FlameGraph repo
ถ้าคุณสนใจรายละเอียดเพิ่มเติมเกี่ยวกับวิธีที่เราใช้ profilers กับ Redis เราแนะนำให้ดู "Performance engineering guide for on-CPU profiling and tracing" ซึ่งมีรายละเอียดอย่างลึกซึ้ง
หลีกเลี่ยงการคำนวณซ้ำ (Duplicate Computation) เพื่อเพิ่มประสิทธิภาพ
ทันทีที่ขั้นตอนแรกเสร็จ เราเริ่มตีความ profiler tools/probers outputs หนึ่งใน benchmarks ที่แสดงรูปแบบน่าสนใจคือ Streams' ingested benchmark ซึ่งเพียงแค่ ingest ข้อมูลเข้า stream ด้วยคำสั่งคล้ายด้านล่าง:
`XADD key * field value`
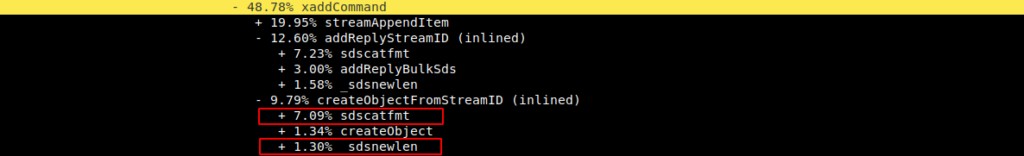
เราสังเกตว่าเมื่อเพิ่มข้อมูลลง stream โดยไม่มี ID จะสร้าง duplicate work ใน SDS creation/freeing/sdslen ที่ใช้ประมาณ 10% ของ CPU cycles ตามที่แสดงใน perf report prints ถัดไปสองรายการ
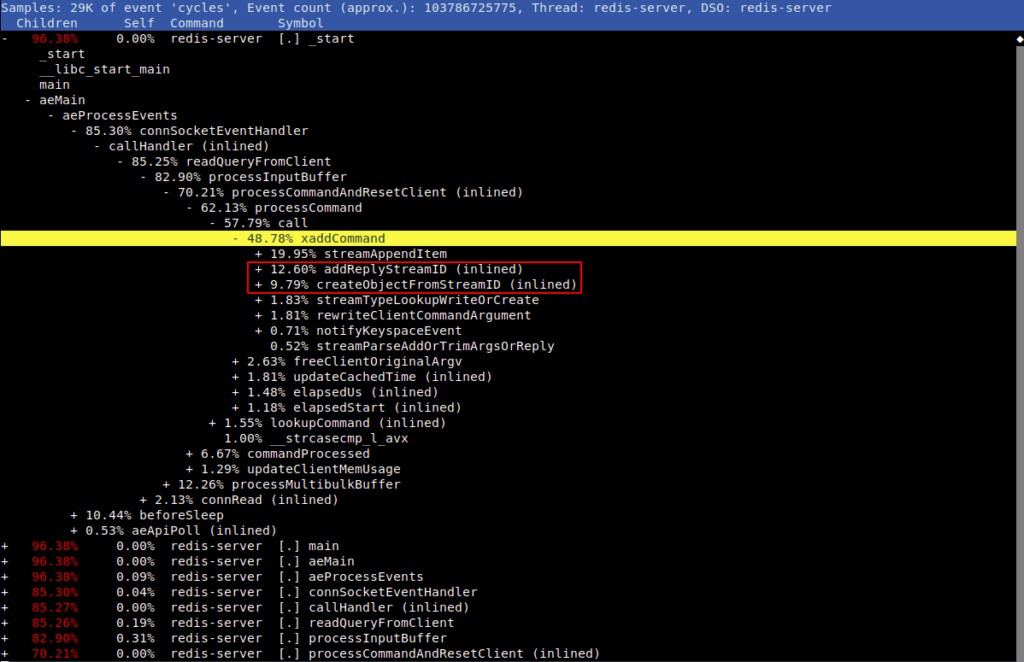
สำหรับ input เดียวกัน sdscatfmt และ _sdsnewlen ถูกเรียกสองครั้ง:
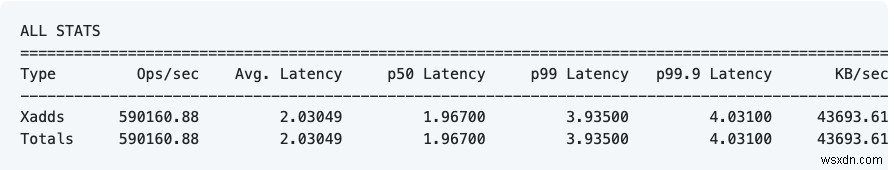
สิ่งนี้ทำให้เราสามารถปรับปรุง Streams ingestion ประมาณ 9-10% ตามที่ยืนยันจาก benchmark results:
Baseline on unstable branch (6b403f5) :
First commit of this PR (avoid dup work):
หลีกเลี่ยงการจัดสรรหน่วยความจำซ้ำ (Duplicate Allocations) เพื่อเพิ่มประสิทธิภาพ
โฟกัสเริ่มต้นของ use-case improvement นี้นำไปสู่การวิเคราะห์เพิ่มเติมจาก Oran (หนึ่งใน core-team members) ที่สังเกตเห็นอีกหนึ่งการสูญเสีย CPU cycles ครั้งนี้มาจาก non-optimal memory management ภายในบล็อกโค้ดเดียวกัน เราจัดสรร empty SDS แล้ว re-allocate มันอีกครั้ง การลดจำนวนการเรียกจะให้ speed improvement อีกครั้ง ตามที่แสดงด้านล่าง
Second commit (avoid reallocs):
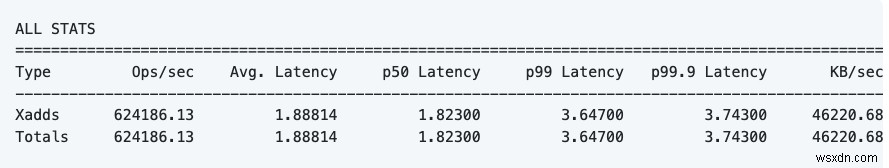
การวัด improvement ที่ได้
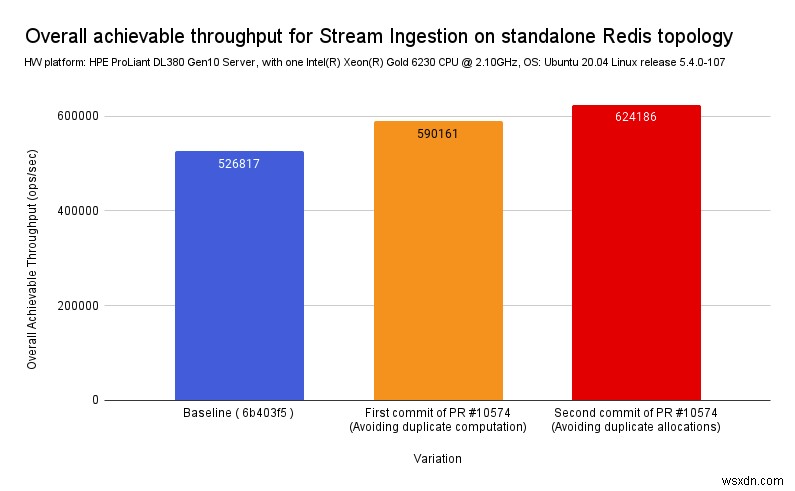
ตามคาด โดยเพียง reuse intermediate computation และลด redundant computation และ allocations ภายใน internal functions ที่ถูกเรียก เราวัดได้ reduction ใน overall CPU time ประมาณ ~= 20% ของ Redis Streams
เราเชื่อว่านี่เป็นตัวอย่างของการปรับปรุงที่เป็นระบบและเรียบง่ายสามารถนำไปสู่การเพิ่มประสิทธิภาพอย่างมีนัยสำคัญ แม้สำหรับโค้ดที่ optimized ลึกๆ อยู่แล้วอย่าง Redis
เป้าหมายของเราคือขยาย performance visibility ที่เรามีของ Redis และสมาชิกจากทั้งอุตสาหกรรมและวิชาการ รวมถึงองค์กรและบุคคล ได้รับการส่งเสริมให้มีส่วนร่วม หากเราไม่ measure มัน เราจะ improve มันไม่ได้
