

ที่ RedisDays NY 2022 เราได้ประกาศ public preview ของความสามารถ Vector Similarity Search (VSS) ใหม่ของเรา VSS เป็นส่วนหนึ่งของ RediSearch 2.4 และพร้อมใช้งานบน Docker, Redis Stack, และ Redis Enterprise Cloud's free และ fixed subscriptions
ในบทความนี้ ผาจะพาคุณผ่าน basics ของ vector similarity และ applications ของมัน และแชร์ resources เพื่อเริ่มต้นกับ Redis VSS!
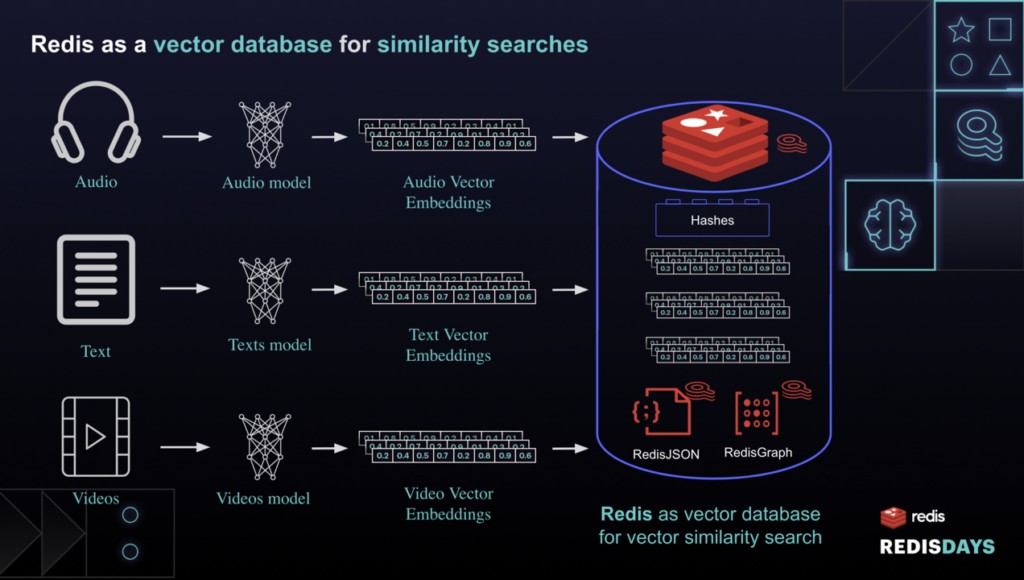
ในทางเรียบง่าย มันคือการวัดว่าเวกเตอร์สองตัวหรือมากกว่านั้น ต่างหรือคล้ายกันเพียงใด คิดถึง vector ว่าเป็น list ของตัวเลข
ที่หัวใจของมัน vector search อนุญาตให้ developers retrieve (ดึงข้อมูล) ข้อมูลโดยอิงจาก audio, natural language, images, video clips, voice recordings และอีกมากมายประเภทของข้อมูล การค้นหาข้อมูลที่ไม่มีโครงสร้าง (unstructured data) ทำให้ VSS กลายเป็น foundational technology สำหรับสร้าง advanced similarity search experiences
Vector เหล่านี้ถูกสร้าง (generated) สำหรับข้อมูลของฉันอย่างไร?ด้วยความก้าวหน้าของ AI data scientists สามารถสร้าง models ที่ transform เกือบทุก data "entity" ให้กลายเป็น vector representation ของมัน Entity ที่นี่อาจเป็น transaction, user profile, image, sound, long piece of text (ประโยคหรือย่อหน้า), time series, หรือ graph ทุกอย่างนี้สามารถเปลี่ยนเป็น "feature vector" หรือที่รู้จักในชื่อ "embedding" ได้
Embeddings เหล่านี้หมายถึงอะไร?Vector embeddings คือ numerical representations (ตัวแทนเชิงตัวเลข) ของข้อมูล พวกมัน capture (จับคุณสมบัติ) essential features (คุณสมบัติสำคัญ) ของ entity ในลักษณะที่ computers และ databases สามารถเปรียบเทียบได้ง่าย ส่วนน่าสนใจคือ ถ้า model สร้าง embeddings (vectors) ที่คล้ายกันสำหรับสอง entities คุณสามารถสรุปได้ว่า entity ทั้งสองต้นฉบับคล้ายกันในทางพื้นฐานบางอย่าง
ฉันต้องเป็น data scientist เพื่อสร้าง embeddings เหล่านี้หรือไม่?ไม่เลย! มี AI models และ libraries ที่ใช้ได้ฟรีหลายอย่าง ที่อนุญาตให้ developers สร้าง embeddings จาก text, image, หรือ time-series data ตัวอย่างเช่น คุณสามารถใช้ HuggingFace Sentence Transformers สร้าง embeddings สำหรับประโยค Img2Vec สร้าง embeddings สำหรับรูปภาพ และ Facebook Kats สร้าง embeddings สำหรับ time-series data AI/ML practitioners คุ้นเคยกับแนวคิดการสร้าง "dense" feature representations (a.k.a embeddings) สำหรับ data entities ของพวกเขา พวกเขาสามารถเก็บ feature vectors เหล่านี้ใน Redis และทำ similarity searches บนมันได้
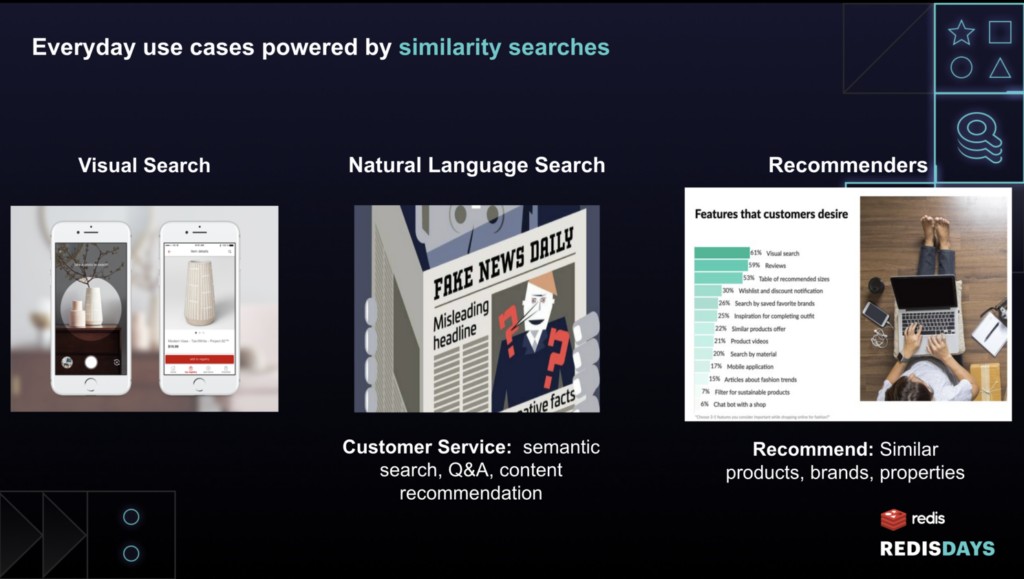
มี everyday applications หลายอย่างที่คุณโต้ตอบ ซึ่งพึ่งพา vector similarity search
จาก visual search บนเว็บไซต์ e-commerce ไปจนถึง automated chatbots / Q&A systems และหลายประเภทของ recommendation systems โดยทั่วไป คุณจะพบ VSS มีประโยชน์ในแอปใดๆ ที่ spotting similarity (การจับความคล้ายคลึง) แบบ real-time เป็นสิ่งจำเป็นในการปลดล็อกคุณค่า (unlocking value) Use cases ทั่วไปมีดังนี้:
– E-commerce recommendations: ใช้ visual similarity และ/หรือ semantic similarity เพื่อขับเคลื่อน advanced search experiences และ product recommendations
– Semantic similarity: สร้าง sophisticated search experiences, chatbots, หรือแม้แต่ question and answering systems
– Similarity ใน time-series data: ค้นพบ similarities ของ disease spread patterns หรือโอกาสเทรดจาก similarities ใน historical patterns
– Similarity ใน graph data: เปิดเผย similar patterns ของ connections ระหว่าง sets ของ actors หรือ networks ที่ต่างกัน (อาจ unrelated)
– Similarity ของ transactions: ตรวจจับ potential fraud หรือ threats จาก similarity กับ fraud/threat attempts ที่ตรวจพบก่อนหน้า
– Similarity ของ user profile หรือ products: สร้าง personalized recommendations; ปรับปรุง customer segmentation จาก patterns ที่ embeddings data เปิดเผย
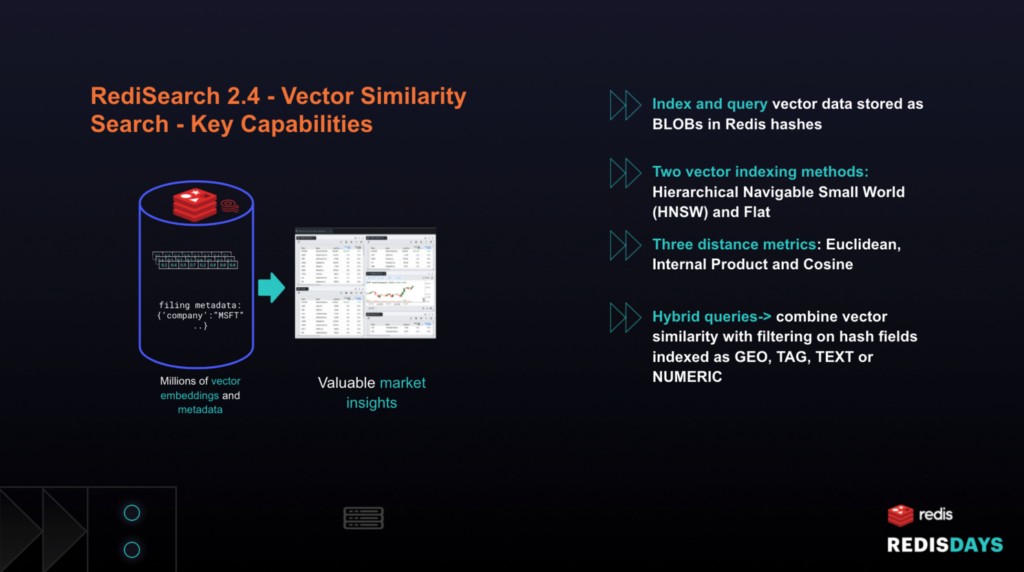
RediSearch เป็น Redis module ที่ให้ query ability, secondary indexing, และ full-text search สำหรับ Redis data ที่จัดเก็บเป็น Redis hashes หรือ JSON format ด้วย Redis 2.4 Redis นำเสนอการรองรับ vector similarity search
ด้วย RediSearch 2.4 Redis developers สามารถ:
– Index และ query vector data ที่จัดเก็บเป็น BLOBs ใน Redis hashes
– ใช้ indexing methods ยอดนิยมสองแบบ: FLAT และ HNSW
– ใช้ vector distance metrics สามแบบทั่วไป: cosine, internal product, และ euclidean distance
– ทำ hybrid queries ซึ่งรวม vector similarity กับ traditional RediSearch filtering capabilities บน GEO, NUMERIC, TAG, หรือ TEXT data ตัวอย่าง hybrid query ใน e-commerce setting คือ "find items visually similar to a given query image limited to items available in a GEO location and within a price range"
ถ้าคุณเก่ง Python ลองดูเหล่านี้:
– Visual and Semantic Similarity on a public Amazon Dataset
– Sentiment analysis and Semantic similarity in Financial News articles
สำหรับ Java คุณลอง basic demo นี้ซึ่งแสดงวิธีสร้าง index, โหลดข้อมูล, และ query
ลองดู replays ของสอง sessions RedisDays 2022 นี้:
– Keynote: Infuse Real-Time AI Into Your "Financial Services" Applications
– Behind the Scenes: Using AI to Reveal Trading Signals Buried in Corporate Filings
Sessions พร้อมดู on-demand แล้ว คุณยังสามารถเช็ค RediSearch documentation บน "Working with Vectors" ได้เสมอ
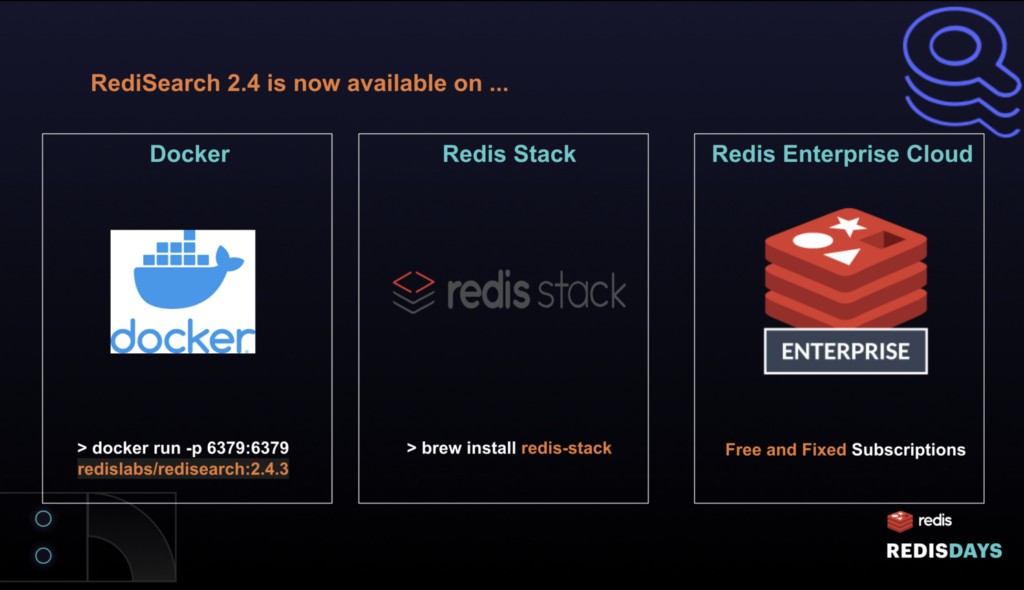
มีสามวิธีง่ายๆ ในการสร้าง Redis database พร้อม RediSearch 2.4
จาก Terminal คุณสามารถได้มันด้วยใดๆ ระหว่างนี้:
1) Docker – "docker run -p 6379:6379 redislabs/redisearch:2.4.5"
2) Redis Stack – "brew install redis-stack" (จาก Mac OS) สำหรับ OS อื่น ลอง "Getting started with Redis Stack"
3) สุดท้าย คุณยังสามารถสร้าง free subscription กับ Redis Enterprise Cloud ได้
ถ้าคุณไปทาง Redis Enterprise Cloud subscription route โปรดใช้ตัวเลือก "Redis Stack" เพราะมันรวม RediSearch 2.4 ไว้แล้ว
