

RediSearch โมดูลดัชนีรอง (secondary index) แบบเรียลไทม์พร้อมความสามารถ full-text search สำหรับ Redis เป็นหนึ่งในโมดูล Redis ที่สุกที่สุดและมีฟีเจอร์ครบครันที่สุด มันยังกลายเป็นที่นิยมมากขึ้นทุกวัน—ในช่วงไม่กี่เดือนที่ผ่านมา RediSearch Docker pulls เพิ่มขึ้น 500%! ความนิยมที่กระโดดสูงนี้นำไปสู่ลูกค้าที่มีกรณีการใช้งานน่าสนใจหลากหลาย ตั้งแต่การจัดการสินค้าคงคลังแบบเรียลไทม์ไปจนถึง ephemeral search
เพื่อขยายโมเมนตัมนี้ เรากำลังนำเสนอ public preview ของ RediSearch 2.0 ซึ่งออกแบบมาเพื่อ ปรับปรุงประสบการณ์นักพัฒนา (developer experience) และเป็น เวอร์ชัน Redisearch ที่ scalable ที่สุด RediSearch 2.0 รองรับเทคโนโลยี Active-Active geo-distribution ของ Redis สามารถขยายขนาดได้โดยไม่มี downtime และรวมการรองรับ Redis on Flash (ปัจจุบันอยู่ใน private preview) เพื่อบรรลุเป้าหมายเหล่านี้โดยไม่กระทบประสิทธิภาพอย่างลบ เราสร้างสถาปัตยกรรมใหม่ทั้งหมดสำหรับ RediSearch 2.0—และมันทำงาน: RediSearch 2.0 เร็วกว่า RediSearch 1.6 ถึง 2.4 เท่า
ภายในสถาปัตยกรรมใหม่ของ RediSearch 2.0
การมี query-and-aggregation engine ที่หลากหลายในฐานข้อมูล Redis ของคุณ เปิดโอกาสกรณีการใช้งานใหม่หลากหลายที่ขยายไปไกลกว่า caching RediSearch ให้คุณใช้ Redis เป็นฐานข้อมูลหลัก (primary database) ในสถานการณ์ที่คุณต้องเข้าถึงข้อมูลด้วยคิวรีที่ซับซ้อน แตกว่า มันรักษาความเร็วระดับโลก ความน่าเชื่อถือ และความสามารถในการขยายขนาดของ Redis และไม่จำเป็นต้องเพิ่มความซับซ้อนให้โค้ดเพื่อให้คุณอัปเดตและดัชนีข้อมูล
สำหรับ RediSearch 2.0 เรา re-architected วิธีที่ indices ถูกเก็บในสภาพ sync กับข้อมูล แทนที่จะต้องเขียนข้อมูลผ่านดัชนี (ใช้คำสั่ง FT.ADD) RediSearch ตอนนี้ follow ข้อมูลที่เขียนใน hashes และทำ indexing แบบ synchronous การ re-architecture นี้มาพร้อมกับการเปลี่ยนแปลงหลายอย่างใน API ซึ่งเราได้อภิปรายในโพสต์ก่อนหน้าเมื่อ RediSearch 2.0 Hit Its First Milestone
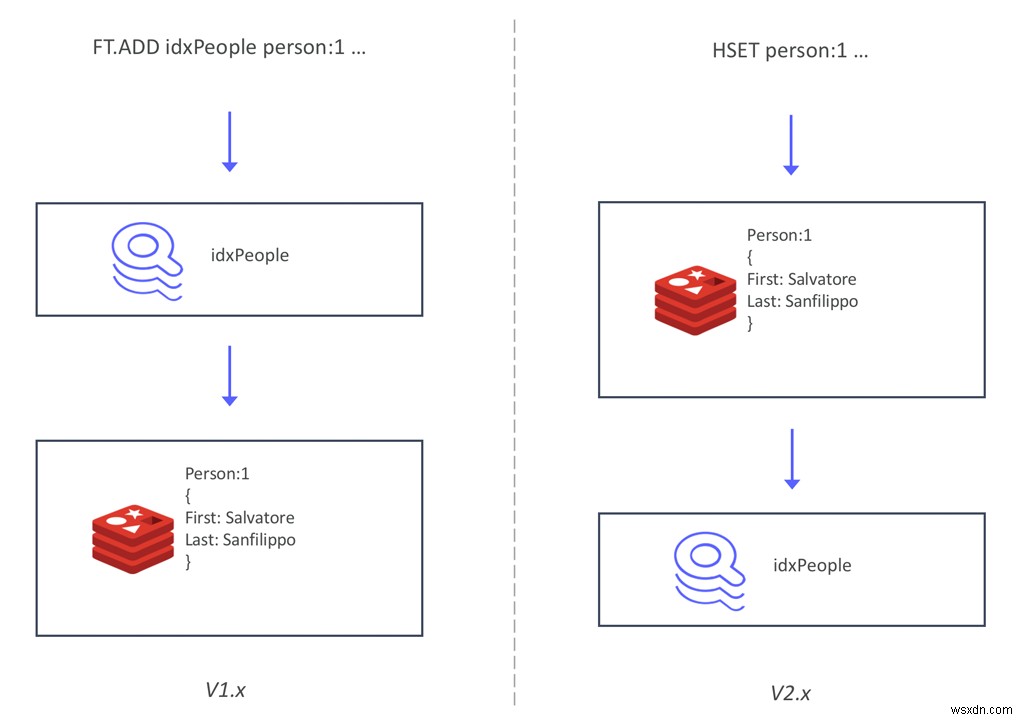
สถาปัตยกรรมใหม่นี้นำมาซึ่งประโยชน์หลัก 2 ข้อ ข้อแรก ตอนนี้ง่ายกว่าที่จะสร้าง secondary index บนข้อมูลที่มีอยู่ของคุณ คุณสามารถเพียง เพิ่ม RediSearch ลงในฐานข้อมูล Redis ที่มีอยู่ สร้างดัชนี และเริ่มสอบถามได้ทันที โดยไม่ต้องย้ายข้อมูลหรือใช้คำสั่งใหม่สำหรับเพิ่มข้อมูลลงดัชนี สิ่งนี้ลด learning curve สำหรับผู้ใช้ RediSearch ใหม่ลงมาก และให้คุณสร้างดัชนีบนฐานข้อมูล Redis ที่มีอยู่—โดยไม่ต้อง restart แม้แต่นิดเดียว
นอกจากการนำวิธีใหม่ในการดัชนีข้อมูลมาใช้ เรายังนำ index ออกจาก keyspace อีกด้วย นี่เปิดใช้งานเทคโนโลยี Active-Active ของ Redis Enterprise ซึ่งพัฒนาจาก conflict-free replicated data types (CRDTs) การ merge สอง inverted indices แบบ conflict-free เป็นเรื่องยาก แต Redis มีการปฏิบัติ CRDTs ของ Hashes ที่พิสูจน์แล้ว ดังนั้นประโยชน์ใหญ่ที่สองของ สถาปัตยกรรมใหม่นี้คือการทำให้ RediSearch 2.0 scalable ยิ่งขึ้น เนื่องจาก RediSearch ตอนนี้ follow Hashes และ index ถูกย้ายออกจาก keyspace คุณจึงสามารถรัน RediSearch ในฐานข้อมูล Active-Active geo-distributed ได้
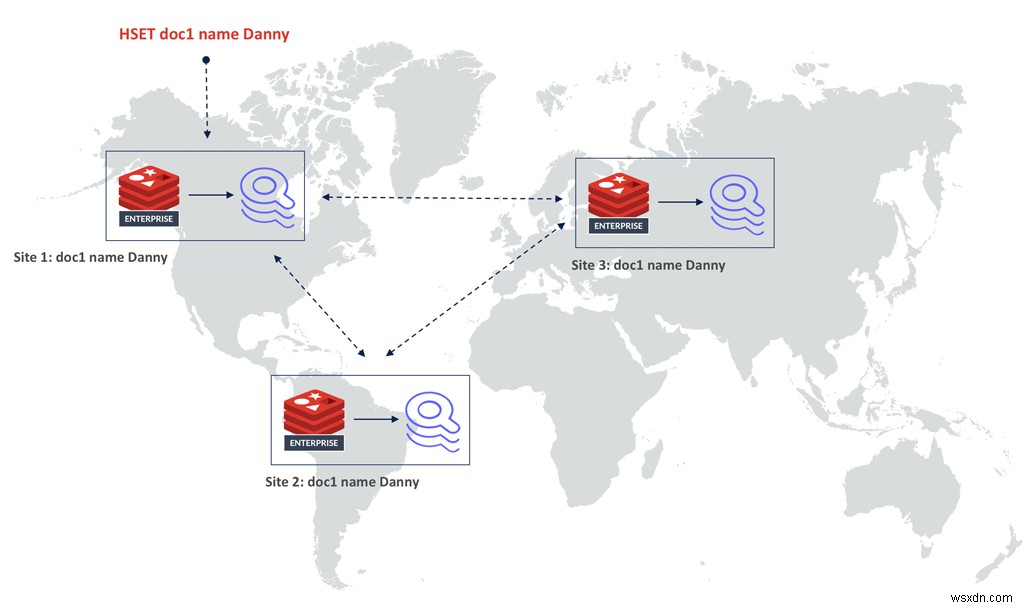
เอกสารจะถูกจำลองไปยังฐานข้อมูลทั้งหมดใน replication set อย่าง strongly eventual consistent ในแต่ละ replica RediSearch จะเพียง follow การอัปเดตทั้งหมดบน Hashes ซึ่งหมายความว่าดัชนีทั้งหมดก็เป็น strongly eventual consistent เช่นกัน
OSS cluster support สำหรับ open source Redis
เราไม่อยากจำกัดความสามารถในการเพิ่มความ scalable ให้เฉพาะผู้ใช้ Redis Enterprise ดังนั้นเราเพิ่มการรองรับการขยายดัชนีเดียวข้ามหลาย shards ด้วย open source Redis cluster API ก่อนหน้านี้ ดัชนี RediSearch เดียว และเอกสารของมัน ต้องอยู่บน shard เดียว หมายความว่า dataset size และ throughput สำหรับ OSS Redis ถูกจำกัดโดยสิ่งที่ Redis process เดียวจัดการได้ Redis Enterprise เสนอความสามารถในการกระจายเอกสารใน clustered database และรวมผลลัพธ์ที่เวลาสอบถาม การ fan-out และ aggregation นี้จัดการโดย component ที่เรียกว่า "coordinator" ซึ่งตอนนี้พร้อมใช้งานสาธารณะภายใต้ Redis Source Available License ดังนั้นจึงจะทำงานกับ open source Redis clusters และ Redis Enterprise ทั้งคู่ ผลลัพธ์คือเวอร์ชัน RediSearch ที่ scalable ที่สุดจนถึงตอนนี้
แสดงตัวเลขให้ดู!
เพื่อประเมินประสิทธิภาพการ ingest ของ RediSearch 2.0 เราขยาย full-text search benchmark (FTSB) suite ของเราด้วย NYC Taxi dataset ที่พร้อมใช้งานสาธารณะ ชุดข้อมูลนี้ใช้ทั่วอุตสาหกรรมเนื่องจากชุดประเภทข้อมูลที่หลากหลาย (text, tag, geographic และ numeric) และจำนวนเอกสารมาก
Benchmark นี้โฟกัสที่ write performance ใช้ข้อมูล trip-record ของการขับรถแท็กซี่สีเหลืองในนครนิวยอร์ก โดยเฉพาะสำหรับ benchmark นี้ เราใช้ dataset มกราคม 2015 ซึ่งโหลดมากกว่า 12 ล้านเอกสาร ขนาดเฉลี่ย 500 ไบต์ต่อเอกสาร สำหรับ benchmark specification เต็ม โปรดอ้างอิง FTSB บน GitHub
ทุกการเปลี่ยนแปลงของ benchmark รันบน Amazon Web Services instances ที่จัดหาผ่าน benchmark-testing infrastructure ของเรา Tests รันบน 3-node cluster พร้อม 15 shards ด้วย RediSearch Enterprise versions 1.6 และ 2.0 ทั้ง benchmarking client และ 3 โนดที่ประกอบฐานข้อมูลกับ RediSearch enabled รันบน c5.9xlarge instances แยกกัน
เนื่องจาก RediSearch 2.0 มาพร้อมความสามารถในการ follow การเปลี่ยนแปลงใน Hashes ใน Redis และทำ indexing อัตโนมัติ เราเพิ่ม variants สำหรับคำสั่ง FT.ADD และ HSET เพื่อให้การอัปเกรดง่ายขึ้น เรา remap คำสั่ง FT.ADD ที่ deprecated แล้ว ไปยังคำสั่ง HSET ใน RediSearch 2.0 สองแผนภูมิด้านล่างแสดง overall ingestion rate และ latency สำหรับ RediSearch 1.6 และ RediSearch 2.0 ทั้งคู่ ในขณะที่รักษา latency ยังคง sub-millisecond
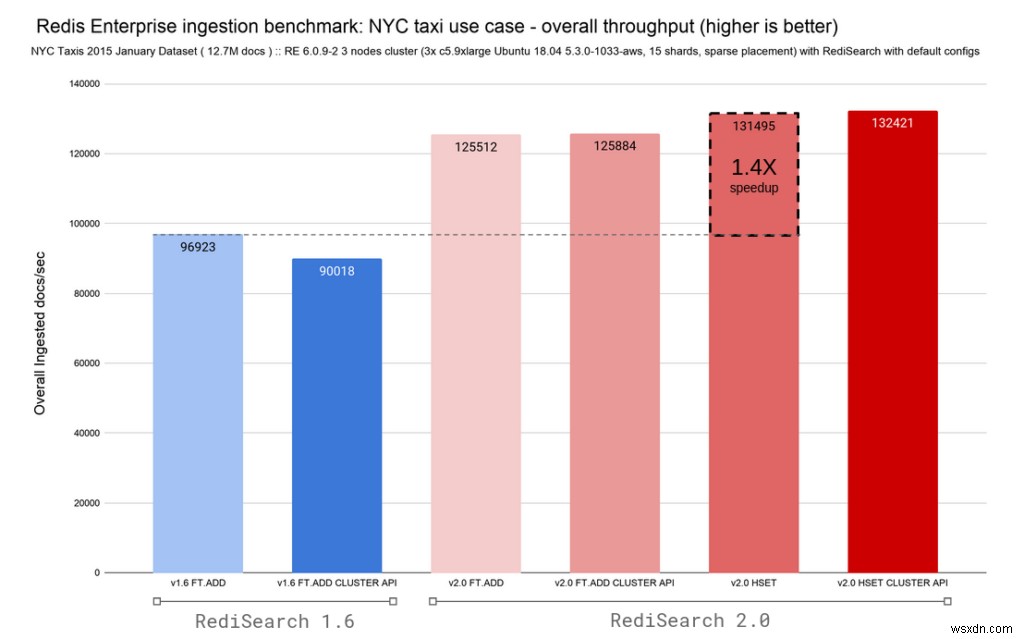
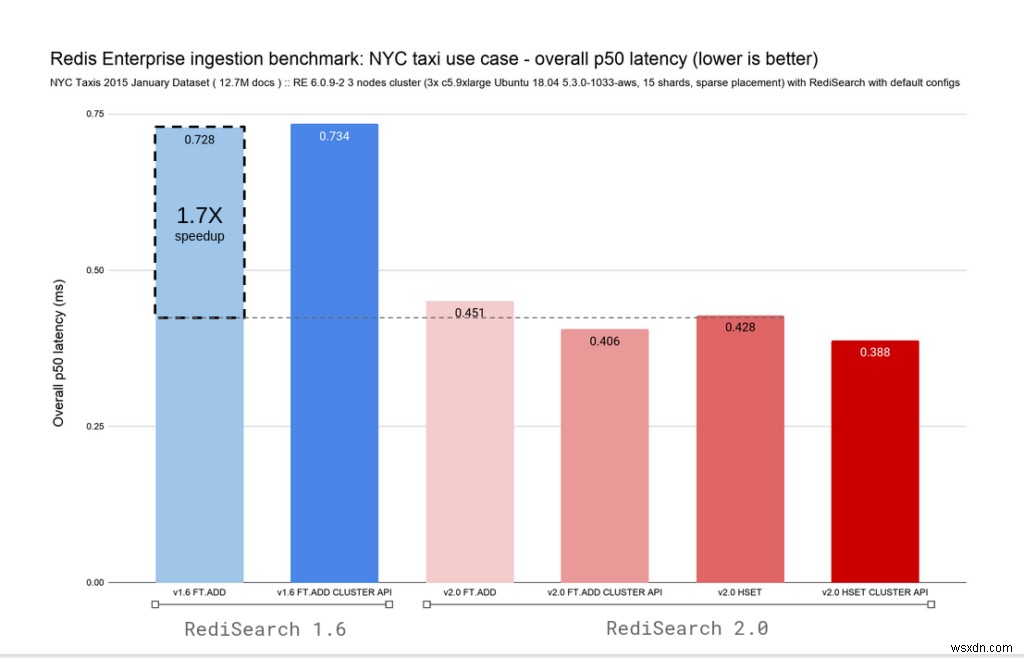
RediSearch เคยเร็วมากแล้ว แต่ด้วยการเปลี่ยนแปลงสถาปัตยกรรมนี้ เราเคลื่อนย้ายจากการ indexing 96K documents ต่อวินาที เป็น 132K docs/sec ที่ overall p50 ingestion latency 0.4ms ปรับปรุง write scaling อย่างมาก
คุณไม่ได้แค่ได้ประโยชน์จากการเพิ่ม throughput แต่แต่ละการ ingest ก็กลายเป็นเร็วขึ้น นอกจากการปรับปรุง ingestion ทั้งหมดเนื่องจากการเปลี่ยนแปลงสถาปัตยกรรม คุณตอนนี้ยังสามารถพึ่งพา OSS Redis Cluster API capabilities เพื่อ linearly scale การ ingest ของ search database ของคุณได้
รวมการปรับปรุง throughput และ latency RediSearch 2.0 ให้ speedup สูงสุด 2.4 เท่า เทียบกับ RediSearch 1.6
อะไรจะเป็นต่อไปสำหรับ RediSearch 2.0
สรุปคือ RediSearch 2.0 เป็นเวอร์ชันที่เร็วที่สุดและ scalable ที่สุดสำหรับผู้ใช้ Redis ทุกคนที่เราเคยเผยแพร่ นอกจากนี้ สถาปัตยกรรมใหม่ของ RediSearch 2.0 ปรับปรุง developer experience ในการสร้างดัชนีสำหรับข้อมูลที่มีอยู่ใน Redis อย่างราบรื่น และกำจัดความจำเป็นต้องย้ายข้อมูล Redis ของคุณไปยังฐานข้อมูล RediSearch-enabled อื่น สถาปัตยกรรมใหม่นี้อนุญาตให้ RediSearch follow และ auto-index โครงสร้างข้อมูลอื่นๆ เช่น Streams หรือ Strings ในการเผยแพร่ข้างหน้า จะให้คุณทำงานกับโครงสร้างข้อมูลเพิ่มเติม เช่น nested data structure ใน RedisJSON
เราวางแผนที่จะเพิ่มฟีเจอร์มากขึ้นเพื่อปรับปรุง developer experience อีก ต่อไป ค้นหาคำสั่งใหม่ที่อนุญาตให้คุณ profile คิวรีการค้นหาของคุณ เพื่อเข้าใจดียิ่งขึ้นว่า performance bottlenecks เกิดขึ้นที่ไหนในระหว่าง query execution
พร้อมเริ่มต้นแล้ว? ดูบล็อกของ Tug Grall เกี่ยวกับ … Getting Started with RediSearch 2.0! จากนั้นทำตามขั้นตอนใน tutorial นี้บน GitHub หรือสร้างฐานข้อมูลฟรีใน Redis Enterprise Cloud Essentials (โปรดทราบว่า public preview ของ RediSearch 2.0 พร้อมใช้งานใน 2 ภูมิภาค Redis Enterprise Cloud Essentials: Mumbai และ Oregon)
