

พอร์ตโฟลิโอเป็นรากฐานของอุตสาหกรรมการจัดการทรัพย์สินและการลงทุน ตั้งแต่ Harry Markowitz สร้างทฤษฎีพอร์ตโฟลิโอสมัยใหม่ ผู้เชี่ยวชาญด้านการจัดการทรัพย์สินและการลงทุนจึง 집착 กับการเพิ่มผลตอบแทนสูงสุดสำหรับระดับความเสี่ยงที่กำหนด วันนี้ ผู้เชี่ยวชาญในอุตสาหกรรมได้ร่วมกับนักลงทุนรายย่อยหลายล้านคน ซึ่งเปลี่ยนภูมิทัศน์การลงทุนอย่างสมบูรณ์ ผู้เข้ามาใหม่เหล่านี้สร้างผลกระทบใหญ่ต่อเทคโนโลยีที่รองรับโครงสร้างพื้นฐานการเทรดของบริษัทหลักทรัพย์รายย่อย ตลาดแลกเปลี่ยน และ clearing houses
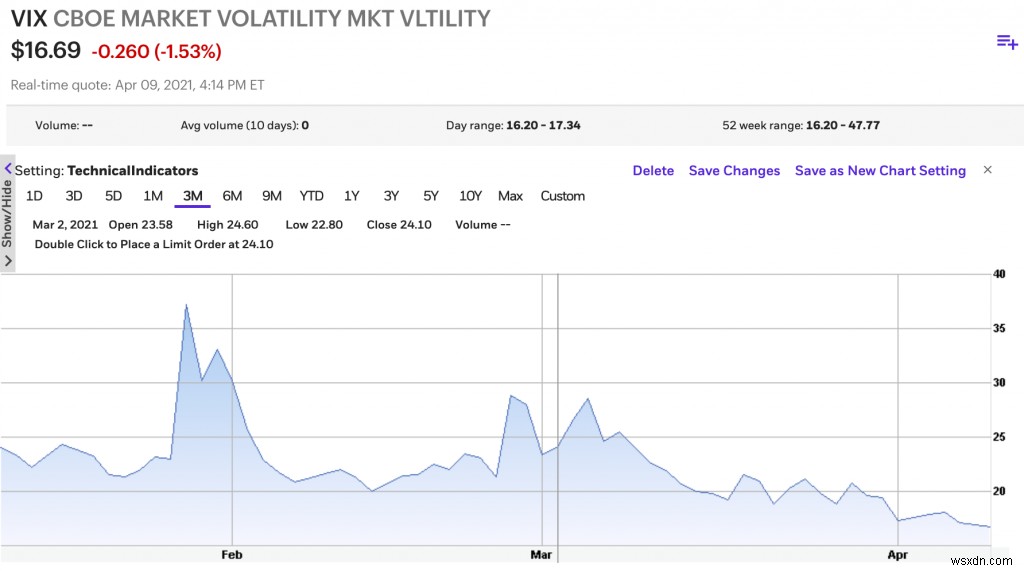
ตัวอย่างเช่น ความหyped หุ้น GameStop มกราคม 2021 นักลงทุนรายย่อยเทรดหุ้น GameStop ระดับสถิติ พวกเขายังแทรกตัวเข้าหุ้น meme อื่นๆ เช่น AMC Entertainment ทำให้ความผันผวนของตลาดโดยรวมเพิ่มขึ้นมากกว่า 76% ในเพียงไม่กี่วันซื้อขาย ตามวัดโดย VIX ความผันผวนนี้นำไปสู่แรงกดดันราคาบนหลายพันหลักทรัพย์ ล้านล้านนักลงทุนพยายามเข้าถึงพอร์ตโฟลิโอพร้อมกัน แต่เจอแอปที่ตอบสนองไม่ทัน ความอดทนของนักลงทุนต่อบริษัทที่แอปทำงานไม่ดีเมื่อต้องการมากที่สุด ต่ำมาก
ในช่วงเวลาที่วุ่นวายเหล่านี้ นักลงทุนส่วนใหญ่หาข้อมูล 2 จุดเกี่ยวกับพอร์ตโฟลิโอที่ต้องเข้าถึงตลอดเวลา:
- มูลค่ารวมของพอร์ตโฟลิโอในขณะนั้นคือเท่าไหร่?
- กำไรหรือขาดทุนของหลักทรัพย์เฉพาะในพอร์ตโฟลิโอเป็นอย่างไร?
คำตอบของคำถามเหล่านี้อาจนำนักลงทุนไปซื้อ ขาย หรือถือหลักทรัพย์เฉพาะ ในตลาดที่เคลื่อนไหวเร็ววันนี้ การล่าช้าสั้นๆ ก็อาจหมายถึงโอกาสและกำไรที่สูญเสียไป คุณต้องการการเข้าถึงราคาแบบเรียลไทม์เพื่อตอบคำถามเหล่านี้—แต่มี 2 ชะลอหลัก:
- อัปเดตราคาหลายพันหลักทรัพย์พร้อมกัน
- ตอบคำขอจากลูกค้าหลายล้านคำพร้อมกัน
ราคาหลักทรัพย์เปลี่ยนแปลงได้เร็ว ตามปริมาณการเทรด ความผันผวนของหลักทรัพย์เฉพาะ และความผันผวนของตลาด ด้านอื่น บริษัทหลักทรัพย์อาจมีลูกค้าหลายล้านคน แต่ละคนมีหลักทรัพย์หลายสิบตัวในพอร์ตโฟลิโอ ทันทีที่ลูกค้าเข้าสู่ระบบ พอร์ตโฟลิโอต้องอัปเดตราคาล่าสุด—และคงอัปเดตต่อไปเมื่อบริษัทได้รับราคาจากตลาดแลกเปลี่ยน
โดยพื้นฐาน เรากำลังสร้างกราฟหุ้นแบบเรียลไทม์ แอปบริษัทหลักทรัพย์หลายแห่งไม่พยายามทำในระดับ scale นี้ แทนที่จะ push ราคาไปยังลูกค้าหลายล้าน พวกเขา pull ราคาล่าสุด ตัวอย่างอาจมีปุ่ม refresh บนหน้าพอร์ตโฟลิโอ
ชะลอเหล่านี้ในรุ่นใหม่ ไม่ได้เป็นเรื่องจริง และแก้ไขได้ยากด้วยฐานข้อมูล disk-based ที่ไม่ได้ออกแบบมาจัดการล้าน operations ต่อวินาที ความต้องการของอุตสาหกรรมการเงินต้องการฐานข้อมูลที่ขยายได้ง่าย และจัดการร้อยล้าน operations ต่อวินาที Redis Enterprise แพลตฟอร์มฐานข้อมูล in-memory มีศักยภาพแก้ไขชะลอเหล่านี้
นี่คือบล็อกแรกในชุดครอบคลุม use cases เรียลไทม์ต่างๆ ในโลกการเงิน เราจะครอบคลุมรายละเอียดและชะลอทางธุรกิจของแต่ละ use case และบทบาทของ Redis Enterprise ในการแก้ไข พร้อมตัวอย่างการออกแบบ โมเดลข้อมูล และโค้ดサンプル เราจะอภิปราย pros และ cons ของแต่ละแนวทาง
ในบล็อกนี้เราจะครอบคลุม:
- การ implement ตัวอย่างของโมเดลข้อมูลพอร์ตโฟลิโอหลักทรัพย์ประสิทธิภาพสูงและขยายได้บน Redis Enterprise
- อัปเดตราคาหลักทรัพย์ในพอร์ตโฟลิโอแบบเรียลไทม์ เมื่อบริษัทได้รับราคาล่าสุดจากตลาดแลกเปลี่ยน
เมื่อแอปไคลเอ็นต์ดึงพอร์ตโฟลิโอและได้รับราคาล่าสุดแล้ว สามารถ:
- คำนวณมูลค่ารวมของพอร์ตโฟลิโอ
- คำนวณกำไรหรือขาดทุนของแต่ละ holding ในพอร์ตโฟลิโอ
โมเดลข้อมูลพอร์ตโฟลิโอหลักทรัพย์
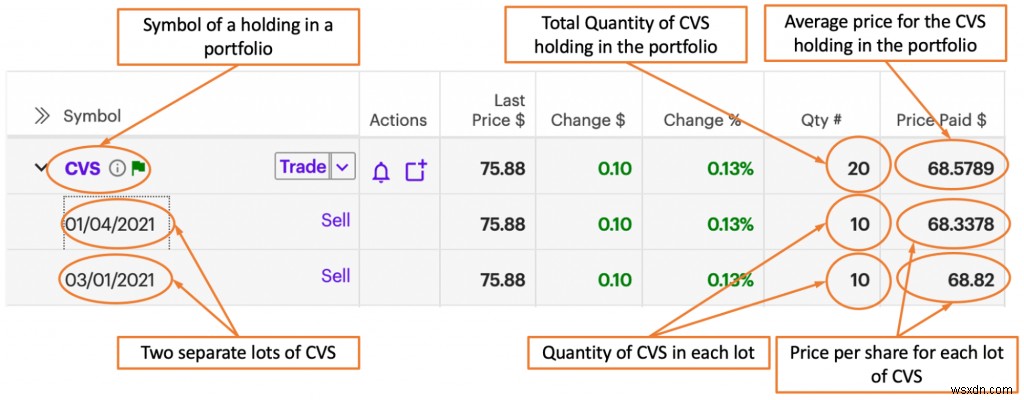
เริ่มจากการสร้างโมเดล holding ในพอร์ตโฟลิโอ ในภาพประกอบด้านล่าง CVS Health Corp. (NYSE: CVS) เป็นหนึ่งใน holding ตัวอย่าง มี 2 lot แยกกันของ CVS—lot แรกซื้อเมื่อ 4 มกราคม 2021 และ lot ที่สองเมื่อ 1 มีนาคม 2021 จำนวนหุ้นเท่ากันถูกซื้อในการ trade buy สำหรับแต่ละ lot ทั้งคู่ 10 หุ้น แต่ราคาต่อหุ้น ต่างกัน—$68.3378 สำหรับ lot แรก และ $68.82 สำหรับ lot ที่สอง จำนวนหุ้นรวมของ holding CVS ในพอร์ตโฟลิโอคือ 20 ด้วยต้นทุนเฉลี่ยคำนวณดังนี้: (($68.3378 * 10) + ($68.82 * 10))/20 = $68.5789 ต่อหุ้น
การ implement ความต้องการ
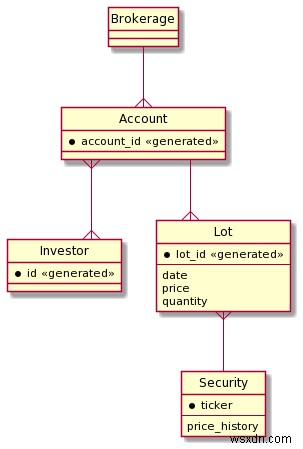
การแสดงข้อมูลของ Redis เป็นแบบแบน—ไม่สามารถ embed Sets ภายใน Set อีกได้ ดังนั้น โมเดลข้อมูลตาม ER diagram ไม่จำเป็นต้อง implement โดยตรง การ implement Entity Model โดยตรงอาจไม่มีลักษณะประสิทธิภาพที่ต้องการ จึงต้องคิดแตกต่างเล็กน้อยเมื่อลงมือ implement ในส่วนนี้เราจะครอบคลุมหลักการออกแบบพื้นฐานบางอย่างที่จำเป็นเมื่อออกแบบ implementation ประสิทธิภาพสูงและขยายได้ด้วย Redis
โมเดลข้อมูลที่นี่กล่าวถึง entity ต่อไปนี้:
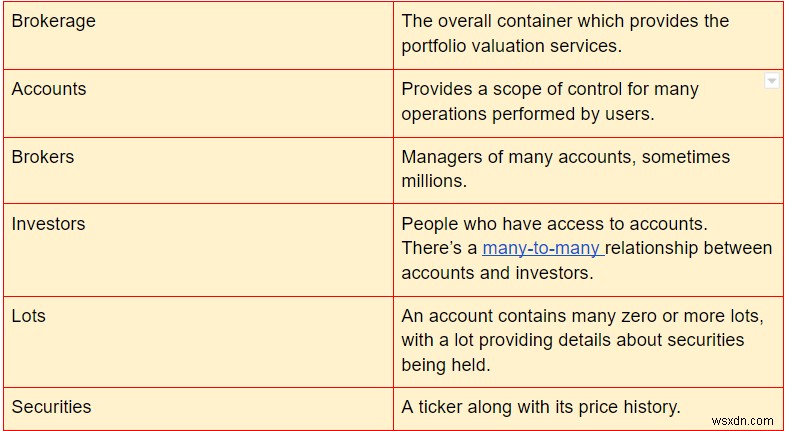
ER diagram ให้การแสดงภาพช่วยเห็นภาพรวม
สิ่งที่ขาดจาก diagram ด้านบนคือชุดราคาเข้า แม้จะบันทึกในประวัติราคาของหลักทรัพย์—และการคำนวณ มูลค่าและกำไรทันที เมื่อราคาเปลี่ยน ดังนั้น ER diagram แสดงข้อมูลค่อนข้าง static ที่เป็นบริบทในการประเมินมูลค่าพอร์ตโฟลิโอ
สถาปัตยกรรมโดยรวม
จุดสำคัญที่ต้องพิจารณาเกี่ยวกับระบบนี้:
- ความทันใจ (latency) เป็นสำคัญที่สุด นี่คือคุณสมบัติขับเคลื่อนโดยรวม
- การคำนวณมูลค่าพอร์ตโฟลิโอรวมข้อมูลเฉพาะบัญชี (ข้อมูล lot) กับข้อมูลร่วมระหว่างบัญชี (ราคาหลักทรัพย์) ข้อมูลเฉพาะบัญชีจึงเป็นบริบทที่ใช้ข้อมูลร่วม
- มูลค่าพอร์ตโฟลิโอต้องคำนวณเฉพาะบัญชีที่นักลงทุนออนไลน์ (สัดส่วนน้อยของบัญชีทั้งหมด)
- ข้อมูลไหลผ่านระบบ จากตลาดแลกเปลี่ยนที่ผลิตราคา ไปยังเครื่องไคลเอ็นต์ (browser, mobile apps) แสดงมูลค่าพอร์ตโฟลิโอให้นักลงทุนออนไลน์
- พื้นที่ที่มีความไดนามิกสูง รวมถึงอัตราการไหลของข้อมูลเข้า และจำนวนนักลงทุนออนไลน์
จากจุดเหล่านี้ แนวทางทั่วไปมีดังนี้:
- พึ่งพาสถาปัตยกรรม in-memory ของ Redis สำหรับการเข้าถึงข้อมูล static และ dynamic ด้วย low latency
- เพิ่มประสิทธิภาพโมเดลข้อมูลด้วยโครงสร้างข้อมูล Redis เพื่อการเข้าถึงข้อมูลบริบทที่เปลี่ยนแปลงช้าได้อย่างรวดเร็ว
- ใช้โครงสร้างการสื่อสารของ Redis (Streams, Consumer Groups, Pub/Sub) จัดการความต้องการข้อมูลไดนามิก
- ลดการจัดเก็บข้อมูลเหลือแค่สิ่งที่จำเป็นโดยไม่กระทบประสิทธิภาพโดยรวม
- implement การคำนวณเฉพาะไคลเอ็นต์บนไคลเอ็นต์เอง ขยายได้ตามธรรมชาติและอัตโนมัติพร้อมจำนวนนักลงทุนออนไลน์ ลดภาระ scale อย่างมาก
นี่คือส่วนประกอบการคำนวณหลักและ data flow:
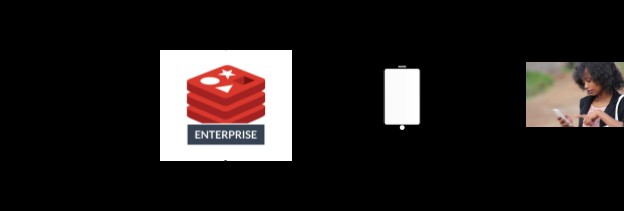
โปรดทราบ Redis Enterprise ประกอบด้วยหนึ่งหรือหลายโหนดข้ามเครื่องจักรหลายเครื่อง—ปรับใช้ on-premises, Kubernetes, hybrid cloud, managed service หรือ native first-party cloud service—และจะมีนักลงทุนออนไลน์หลายแสนร้อยพร้อมไคลเอ็นต์ที่เลือก
ส่วนประกอบ Redis Enterprise
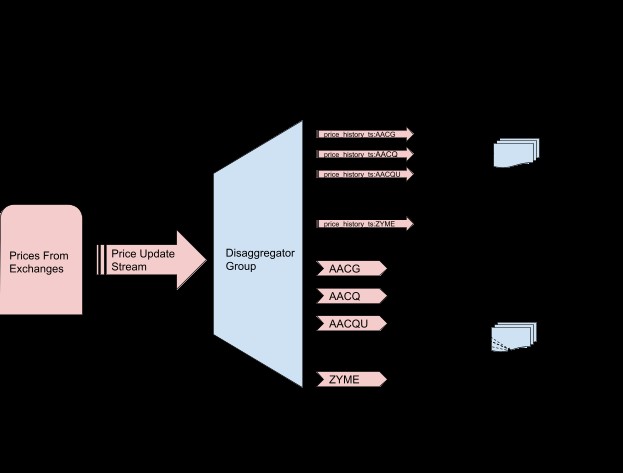
การอัปเดตราคาหลักทรัพย์จะถูกดูดซับโดย Redis Streams อัปเดตสำหรับหลักทรัพย์จะผสมกันใน stream นี้ และต้อง disaggregated เพื่อให้ข้อมูลมีประโยชน์ Consumer group จะใช้ทำ disaggregation นั้น และประมวลผลข้อมูลเข้า 2 โครงสร้าง ต่อหลักทรัพย์:
- RedisTimeSeries database เพื่อติดตามประวัติการเปลี่ยนแปลงราคา (และบันทึกราคาล่าสุดสำหรับไคลเอ็นต์ที่เพิ่งเชื่อมต่อ)
- Pub/Sub broker channel เพื่อ push การแจ้งเตือนการเปลี่ยนแปลงราคาไปยังไคลเอ็นต์ที่ subscribe channel นั้น (นักลงทุนที่พอร์ตโฟลิโอรวมหลักทรัพย์ตัวนั้น)
แผนภาพต่อไปรายละเอียดส่วนนี้ของสถาปัตยกรรม:
ปัจจัยสำคัญที่สุดในโมเดลของเราคือข้อมูลเฉพาะบัญชีที่แสดง lot และหลักทรัพย์ที่เกี่ยวข้อง เราจะเปรียบเทียบ 2 implementations เป็นตัวอย่างการคิดเกี่ยวกับการสร้างโมเดลข้อมูลใน Redis โดยเน้นประสิทธิภาพ Implementations อื่นๆ ก็เป็นไปได้—เป้าหมายคือแนะนำหลักการออกแบบโดยรวมและกระบวนการคิดเมื่อ implement ข้อมูลใน Redis
เราจะใช้ข้อมูลต่อไปนี้เป็นตัวอย่างที่เป็นจริง:
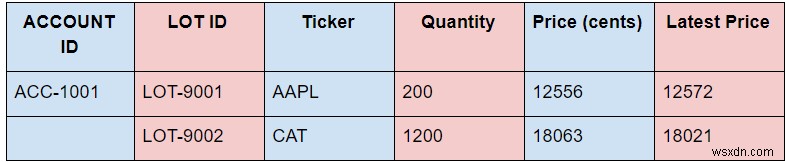
เราตั้งราคาในหน่วยสกุลเงินต่ำสุด เพื่อหลีกเลี่ยง floats และเก็บทุกอย่างเป็น integers ให้ไคลเอ็นต์จัดการแปลงเป็นดอลลาร์และเซนต์ ในตัวอย่างนี้ ใช้ราคาความแม่นยำ 2 ตำแหน่งทศนิยม
Data Model A
Implementation แรก บันทึก id ของ lot ทั้งหมดในบัญชีโดยใช้ SET ระบุด้วย account id แล้วใช้ Redis HASH หนึ่งต่อ LOT ระบุด้วย LOT ID มี field เป็น ticker, quantity และ purchase price กล่าวคือ ใช้ HASH สร้างโมเดลโครงสร้าง LOT entity โดยแต่ละ attribute ของ LOT entity เป็น field ใน Redis HASH
ด้วยโมเดลข้อมูลนี้ มี key สำหรับแต่ละบัญชี และ value ที่มี LOT IDs ทั้งหมดของบัญชีนั้นเก็บเป็น Redis SET:
lotids:<ACCOUNT_ID> SET <LOTID>
นอกจากนี้ สำหรับแต่ละ lotid จะมี HASH ที่ field เป็น ticker, quantity และ purchase price:
lot:<LOTID> HASH <ticker TICKER> <quantity INTEGER> <price INTEGER>
อย่างเฉพาะเจาะจง สร้าง key ดังนี้:
127.0.0.1:6379> SADD lotids:ACC-1001 LOT-9001 LOT-9002 (integer) 2
127.0.0.1:6379> HMSET lot:LOT-9001 ticker AAPL quantity 200 price 12556 OK
127.0.0.1:6379> HMSET lot:LOT-9002 ticker CAT quantity 1200 price 18063 OK
โมดูล RedisTimeSeries อนุญาตให้จัดเก็บและดึงคู่เวลาและค่าที่เกี่ยวข้อง พร้อม high-volume inserts และ low-latency reads เราจะได้ราคาล่าสุดสำหรับ ticker ที่ไคลเอ็นต์สนใจ โดยเข้าถึง time series keys ที่ตรงกัน:
price_history:<TICKER> TIMESERIES <price INTEGER>
127.0.0.1:6379> TS.GET price_history:APPL
1) (integer) 1619456853061
2) 12572
127.0.0.1:6379> TS.GET price_history:CAT
1) (integer) 1619456854120
2) 18021
และ subscribe channel ราคาสำหรับอัปเดต:
<TICKER> SUBSCRIPTION_CHANNEL
เพื่อดึงข้อมูลทั้งหมด ไคลเอ็นต์จะทำ operations ต่อไปนี้:
- 1 ครั้ง SMEMBERS บน key lotids — time complexity O(N) โดย N คือจำนวน lot
- N ครั้ง HGETALL บน key lot — time complexity N × O(1)
- T ครั้ง TS.GET บน key price_history — time complexity T × O(1) โดย T คือจำนวน ticker
- 1 ครั้ง SUBSCRIBE บน channel <TICKER> — time complexity O(T) (subscribe ทุก channel ในครั้งเดียวได้)
Time complexity โดยรวมคือ O(N + T)
อย่างเฉพาะเจาะจง Operations 1 และ 2 จะเป็น:
127.0.0.1:6379> SMEMBERS lotids:ACC1001
1) "LOT-9001"
2) "LOT-9002"
127.0.0.1:6379> HGETALL lot:LOT-9001
1) "ticker"
2) "AAPL"
3) "quantity"
4) "200"
5) "price"
6) "12556"
127.0.0.1:6379> HGETALL lot:LOT-9002
1) "ticker"
2) "CAT"
3) "quantity"
4) "1200"
5) "price"
6) "18063"
สามารถลด network latency ด้วย pipelining (รูปแบบ batching ฝั่งไคลเอ็นต์) และ/หรือใช้ LUA scripts ซ้ำๆ (ใช้ SCRIPT LOAD & EVALSHA) หมายเหตุ: Transactions implement ด้วย pipelines ได้ และลด network latency แต่เฉพาะฝั่งไคลเอ็นต์ และเป้าหมายคือ atomicity บนเซิร์ฟเวอร์ จึงไม่แก้ปัญหา network latency จริงๆ Pipelines ประกอบคำสั่งที่ input และ output ต้อง independent กัน LUA scripts ต้องระบุ keys ทั้งหมดล่วงหน้า และ keys ทั้งหมดต้อง hash ไป slot เดียวกัน (ดูรายละเอียดในเอกสาร Redis Enterprise)
จากข้อจำกัดเหล่านี้ การจัด operations ให้ pipelines คือ:
- pipeline 1: คำสั่งเดียวของ operation #1
- pipeline 2: คำสั่งทั้ง N ของ operation #2
- pipeline 3: คำสั่งทั้ง N ของ operations #3 และ #4
และใช้ LUA scripts ไม่ได้ เพราะแต่ละ operation ใช้ keys ต่างกัน และ keys ไม่มีส่วนร่วมที่ hash ไป slot เดียวกันได้
ในการใช้โมเดลนี้ มี time complexity O(N+T) และ 3 network hops
Data Model B
โมเดลทางเลือกคือ flatten โครงสร้าง LOT entity และแทน attribute แต่ละตัวด้วย key ระบุด้วย account id — key หนึ่งต่อ attribute (quantity, ticker, price) ของ lot Fields ในแต่ละ HASH จะเป็น LOT ID และค่าที่ตรงกับ quantity, ticker หรือ price ดังนั้นจะมี keys:
tickers_by_lot: <ACCOUNT_ID> HASH <LOTID TICKER>
quantities_by_lot:<ACCOUNT_ID> HASH <LOTID INTEGER>
prices_by_lot:<ACCOUNT_ID> HASH <LOTID INTEGER>
Hashes นี้จะแทนที่ LOTID และ LOT keys จาก Data Model A ในขณะที่ price_history และ <TICKER> keys คงเดิม
สร้าง keys:
HSET tickers_by_lot:ACC-1001 LOT-9001 AAPL LOT-9002 CAT
HSET quantities_by_lot:ACC-1001 LOT-9001 200 LOT-9002 1200
HSET prices_by_lot:ACC-1001 LOT-9001 125.56 LOT-9002 180.63
ดึงค่า:
127.0.0.1:6379> HGETALL tickers_by_lot:ACC-1001
1) "LOT-9001"
2) "AAPL"
3) "LOT-9002"
4) "CAT"
127.0.0.1:6379> HGETALL quantities_by_lot:ACC-1001
1) "LOT-9001"
2) "200"
3) "LOT-9002"
4) "1200"
127.0.0.1:6379> HGETALL prices_by_lot:ACC-1001
1) "LOT-9001"
2) "12556"
3) "LOT-9002"
4) "18063"
Operations ที่ไคลเอ็นต์ต้องการตอนนี้:
- 1 ครั้ง HGETALL บน key lot_quantity — time complexity N × O(1)
- 1 ครั้ง HGETALL บน key lot_ticker — time complexity N × O(1)
- 1 ครั้ง HGETALL บน key lot_price — time complexity N × O(1)
- T ครั้ง TS.GET บน key price_history — time complexity T × O(1) โดย T คือจำนวน ticker
- 1 ครั้ง SUBSCRIBE บน channel <TICKER> — time complexity 1 × O(T)
Time complexity โดยรวม O(N+T) — เหมือนเดิม
มุมมอง pipeline กลายเป็น:
- Pipeline one — คำสั่งทั้งหมดของ operations #1, #2, และ #3
- Pipeline two — คำสั่งทั้ง T ของ operations #4 และ #5
ดังนั้น ลด network hops ลง 1 hop — ไม่น่ามากใน absolute terms แต่ 33% ใน relative terms
นอกจากนี้ ใช้ LUA ได้ง่าย เพราะรู้ keys และ map keys ทั้งหมดสำหรับบัญชีเฉพาะไป slot เดียวกัน ด้วยความเรียบง่ายของ operations เราจะไม่ขุดลึก LUA แต่บันทึกไว้ว่าการออกแบบนี้ทำให้เป็นไปได้!
ใน benchmark เรียบง่าย Data Model B เร็วกว่า 4.13 ms (benchmark รอบพันๆ) เนื่องจากรันแค่ครั้งเดียวตอน initialize client สำหรับบัญชี จึงไม่น่าส่งผลต่อประสิทธิภาพโดยรวม
สรุป
ในบล็อกนี้ เราแสดง 2 implementations ที่เป็นไปได้ของ Entity model ใช้ Redis data types เรายังแนะนำการวิเคราะห์ time complexity ที่ควรทำเมื่อเลือก Redis data type พร้อมพิจารณาการเพิ่มประสิทธิภาพ network — ขั้นตอนสำคัญเมื่อต้องการ scale ใหญ่และประสิทธิภาพสูง ในบล็อกต่อไป เราจะขยายแนวคิดเหล่านี้ต่อไปเมื่อโมเดลข้อมูลขยายตัว
เราได้แนะนำชะลอทางธุรกิจในการจัดการพอร์ตโฟลิโอหลักทรัพย์ในระดับ scale และแสดงดังต่อไปนี้:
- โมเดลข้อมูล Redis สำหรับ implement พอร์ตโฟลิโอหลักทรัพย์แบบเรียลไทม์และขยายได้
- ระบบอัปเดตราคาแบบเรียลไทม์ประสิทธิภาพสูง ใช้คำนวณมูลค่ารวมพอร์ตโฟลิโอและกำไร/ขาดทุนของแต่ละ holding
ด้วย 2 ฟีเจอร์สำคัญนี้ แอปไคลเอ็นต์บริษัทหลักทรัพย์สามารถให้อัปเดตพอร์ตโฟลิโอแบบเรียลไทม์ที่ perform และ scale จัดการหลายล้านบัญชี ได้ โมเดลข้อมูลและสถาปัตยกรรมนี้ยังประยุกต์ใช้กับ use cases อื่นนอกจากหลักทรัพย์ ได้ เช่น crypto, ad exchanges ฯลฯ
