

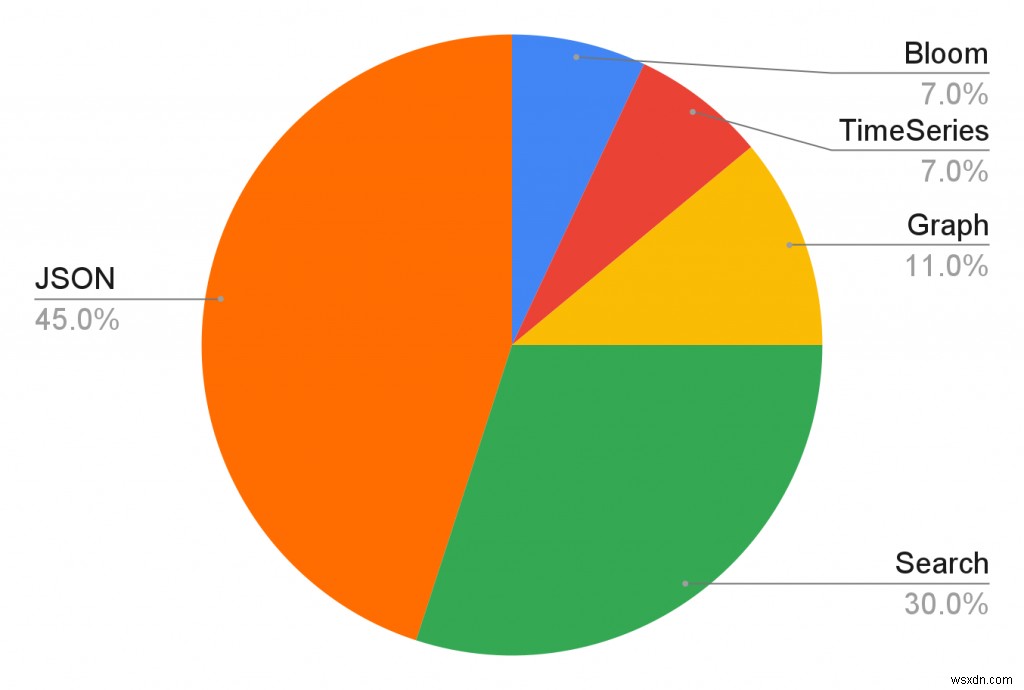
RedisJSON และ RediSearch เป็นโมดูล Redis ยอดนิยมที่สุดในคลาวดของเรา (ดู Fig. 1) Docker images ของ RedisJSON และ RediSearch (รวมกับ Redis) ถูก pull มากกว่า 2000 ครั้งทุกวัน นี่คือเหตุผลที่เราคิดว่า Itamar Haber technology evangelist ที่ Redis เป็นผู้มีวิสัยทัศน์เมื่อเขาเขียนเวอร์ชันแรก 4 ปีก่อน ในเดือนเมษายน เราประกาศหลายอย่างที่ RedisConf เกี่ยวกับ JSON, indexing และความสามารถ full-text search วันนี้เรายินดีประกาศ private preview ของความสามารถเหล่านี้
ในบล็อกนี้ เราจะให้ภาพรวมความสามารถ RedisJSON ปัจจุบัน หลังจากนั้นจะเจาะลึกส่วนความสามารถใหม่ของ private preview นี้ ความสามารถในการจัดดัชนี สอบถาม และใช้ full-text search บนเอกสาร JSON ด้วย RediSearch เป็นฟีเจอร์ใหม่ที่น่าสนใจที่สุดของ release นี้ สุดท้ายเราจะแสดงวิธีเริ่มต้นอย่างรวดเร็ว
ความสามารถ JSON
เมื่อคุณไม่มี RedisJSON คุณสร้างแบบจำลอง nested documents ใน Redis โดยใช้โครงสร้างข้อมูล String
แต่ถ้าเราต้องอัปเดต subpart ของเอกสารล่ะ?
เพื่อรักษา atomicity ของการดำเนินการ เราจะต้อง:
- WATCH เอกสาร
- อ่านเวอร์ชันก่อนหน้าและ deserialize
- ฝังการอัปเดตใน Redis transaction
- Serialize เป็น JSON และอัปเดตเอกสาร
- Execute transaction
เราอาจต้อง retry ทุกขั้นตอนนี้ถ้าลูกค้าอื่นอัปเดตเอกสารระหว่างกระบวนการนี้
อย่างไรก็ตาม ด้วย RedisJSON เราสามารถอัปเดตได้ ด้วย transaction แบบ atomic เพียงครั้งเดียว:
มาดูตัวอย่างอีกอย่าง ที่คุณมี JSON ใหญ่ แต่ต้องการแค่ subpart ของเอกสารนั้นในแอปพลิเคชันของคุณ
โดยไม่มี RedisJSON:
คุณต้อง:
- ดึง JSON string ทั้งหมด ที่ serialized เป็น string
- Deserialize JSON
- Extract subpart ที่คุณต้องการ
ด้วย RedisJSON คุณสามารถดึงข้อมูลที่ต้องการเพียงส่วนเดียวด้วยคำสั่งเดียว ลด CPU cycles, network overhead และสำคัญที่สุดคือ latency
เห็นได้ว่า RedisJSON ทำให้การจัดการเอกสาร JSON ง่ายขึ้น เวอร์ชัน GA ปัจจุบันของ RedisJSON (v1.0) คือเวอร์ชันที่ชุมชนใช้กันอย่างกว้างขวางและแก้ปัญหาข้อบกพร่องของการสร้างโมเดลโครงสร้างซ้อนกันด้วยโครงสร้างข้อมูล String นี่คือภาพรวมความสามารถหลักบางอย่าง
จัดเก็บ (หรืออัปเดต) เอกสาร JSON ที่เชื่อมโยงกับ key ใน Redis
แทนที่ subpart (เช่นค่า string ของ key)
เพิ่มรายการเข้า collection หรือ map
Extract เอกสารทั้งหมด
Extract ส่วนหนึ่งโดยใช้ subset ของ JSONPath
RedisJSON 2.0: Private Preview release
เราประกาศเวอร์ชันนี้ที่ RedisConf 2021 และวันนี้เรายินดีประกาศว่ามีให้เป็น private preview สำหรับกลุ่มลูกค้า Redis Enterprise เล็กๆ —และเป็น release candidate ให้ชุมชน เวอร์ชันนี้มี 3 ฟีเจอร์หลัก ได้แก่ รองรับ JSONPath expression เต็มรูปแบบ รองรับ Active-Active (กับ Redis Enterprise) และความสามารถในการจัดดัชนี สอบถาม และใช้ full-text search บนเอกสาร JSON กับ RediSearch แต่มันไม่มีแค่นั้น! มาเจาะลึกสิ่งดีๆ ใหม่ๆ
เขียนใหม่ด้วย RUST
System programming languages เป็นตระกูลภาษาที่เน้นประสิทธิภาพ โปรแกรมที่เขียนด้วยภาษาเหล่านี้มักเบาและให้ประสิทธิภาพดีที่สุด นี่คือเหตุผลที่ Redis ถูกเขียนด้วย C ตลอดมา มันยังอธิบายได้ว่า Redis ทำไมถึงทำ latency ต่ำมากและ throughput สูงได้ ส่วนใหญ่ของ Redis modules เขียนด้วย C, C++, หรือ Rust ซึ่งเป็นภาษาในตระกูลเดียวกัน
JSON ได้รับการให้บริการอย่างดีโดยชุมชน Rust รวมถึง JSON serialization และ JSONPath implementation ที่เร็วและมีประสิทธิภาพ การนำประโยชน์ของ implementations นั้นมาให้ผู้ใช้ Redis เป็นเรื่องชัดเจน และเพียงต้องการ mapping ระหว่าง Redis module API และ Rust
รองรับ JSONPath เต็มรูปแบบ
นี่คือประโยชน์ของการเขียนใหม่ด้วย RUST เวอร์ชันใหม่นี้รวมการรองรับ JSONPath อย่างครอบคลุม ตอนนี้สามารถใช้ความ rich ของ JSONPath expressions ได้ทั้งหมด
โดยที่มีเอกสาร JSON
Wildcards (ก่อนหน้านี้จำกัดแค่รายการแรก)
Extract slices
ตัวอย่างขั้นสูงกับ filter expressions
รองรับ Active-Active
Active-Active เป็นฟีเจอร์ที่ Redis Enterprise ให้ Active-Active ให้คุณจำลองฐานข้อมูลของคุณเข้าไปในหลายๆ Redis Enterprise clusters ที่กระจายทางภูมิศาสตร์ ผู้ใช้สามารถเชื่อมต่อกับ cluster ที่ใกล้ที่สุดด้วย latency การอ่านและเขียนในท้องถิ่น
การนำไปใช้พัฒนาจากเทคโนโลยี Conflict-free Replicated Data-Type (CRDT) ในขณะที่นำไปใช้สำหรับโครงสร้างข้อมูลหลักส่วนใหญ่ที่ Redis รองรับ Redis พัฒนาความรู้และประสบการณ์ที่แข็งแกร่งยืนยันโดยการนำไปใช้ใหม่นี้สำหรับ JSON
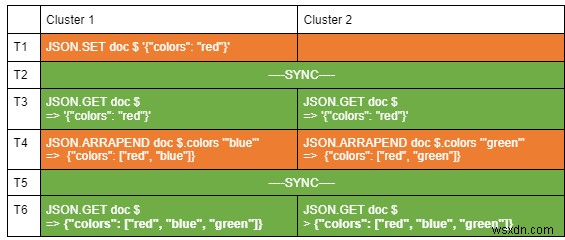
นักพัฒนาแอปพลิเคชันตอนนี้สามารถพึ่งพาได้เพื่อสร้างแอปพลิเคชัน geo-distributed ใช้เอกสาร JSON นี่คือตัวอย่างลำดับการดำเนินการในสภาพแวดล้อม active-active ที่มี 2 clusters:
มาเห็นรายละเอียดของแต่ละการดำเนินการ:
- T1: Client ตั้งค่าเอกสาร JSON บน Cluster 1
- T2: กระบวนการซิงโครไนซ์ จำลองเอกสารบน Cluster 2
- T3: ทั้งสอง clusters มีเอกสารเดียวกัน
- T4: Client เพิ่มสีฟ้าเข้า colors array ใน Cluster 1 และพร้อมกันอีก client เพิ่มสีเขียวเข้า array เดียวกันใน Cluster 2
- T5: กระบวนการซิงโครไนซ์ merge การดำเนินการและอัปเดตเอกสารบนทั้งสอง clusters
- T6: ทั้งสอง clusters มีเอกสารเดียวกัน
เราจะขยายรายละเอียดทุก flow การซิงโครไนซ์เมื่อความสามารถนี้อยู่ใน Public Preview แต่ถ้าคุณสนใจความสามารถนี้ อย่าลังเลติดต่อเราที่ support@redis.com
RediSearch 2.2: Private Preview release
บล็อกนี้ยังประกาศความพร้อมของ private preview สำหรับ RediSearch 2.2 (เป็น private preview สำหรับกลุ่มลูกค้า Redis Enterprise เล็กๆ และ release candidate ให้ชุมชน)
ในส่วนนี้เราจะอธิบายฟีเจอร์ใหม่ที่เวอร์ชันใหม่นี้ของ RediSearch ให้ แต่ก่อน มีเหตุผลว่าทำไมเราปล่อยโมดูลยอดนิยมสองตัวนี้พร้อมกัน:
การจัดดัชนี สอบถาม และ full-text search ของเอกสาร JSON
ฟีเจอร์ใหม่นี้จะนำความสามารถ JSON ของ Redis สู่ระดับใหม่ทั้งหมด ไปไกลกว่าเป็น Key-Value store จนถึงตอนนี้ RediSearch ให้ความสามารถ indexing และ search บน hashes ภายใต้ฝาผ้า RedisJSON 2.0 เปิดเผย internal public API Internal เพราะ API นี้ exposed ให้โมดูลอื่นๆ ที่รันภายใน Redis node Public เพราะโมดูลไหนก็ตามสามารถ consume API นี้ได้ RediSearch 2.2 ก็เช่นกัน!
โดยการเปิดเผยความสามารถให้โมดูลอื่นๆ RedisJSON ให้ RediSearch สามารถจัดดัชนีเอกสาร JSON ได้ ทำให้ผู้ใช้ค้นหาเอกสารโดยจัดดัชนีและสอบถามเนื้อหา โมดูลรวมกันนี้ให้คุณ ฐานข้อมูลเอกสาร JSON-oriented ที่ทรงพลัง latency ต่ำ!
มาดูว่ามันจะเป็นอย่างไร
เราควร populate ฐานข้อมูลด้วยเอกสาร JSON โดยใช้คำสั่ง JSON.SET ก่อน
เพื่อสร้าง index ใหม่ เราใช้คำสั่ง FT.CREATE schema ของ index ตอนนี้รับ JSONPath expressions ผลลัพธ์ของ expression ถูกจัดดัชนีและเชื่อมโยงกับ attribute (ที่นี่: title)
ตอนนี้เราสามารถค้นหา query และหาเอกสาร JSON ของเราโดยใช้ FT.SEARCH:
Aggregation บนเอกสาร JSON
Aggregation เป็นฟีเจอร์ทรงพลังของ RediSearch ที่ใช้สร้างรายงานเชิงวิเคราะห์ หรือทำ faceted search style queries ตอนนี้ RediSearch เข้าถึงเอกสาร JSON ได้แล้ว มันจึงเป็นไปได้ที่จะ load ค่าใดๆ จากเอกสาร JSON โดยใช้ JSONPath expression และใช้ใน pipeline ไม่ว่าค่านั้นจะถูกจัดดัชนีหรือไม่
มาสร้าง index:
เพิ่มเอกสาร JSON เข้าฐานข้อมูล:
และทำการคำนวณง่ายๆ โดยใช้ค่าตัวเลข 2 ค่าที่ extract จากเอกสาร JSON:
ความยืดหยุ่นมากขึ้นในกลยุทธ์การจัดดัชนี
ด้วยเวอร์ชันใหม่ของ RediSearch ตอนนี้สามารถจัดดัชนีค่าเดียวกัน (field บน hashes หรือ JSON Values จากเอกสาร JSON) ด้วยพารามิเตอร์ที่ต่างกัน นี่คือ use case ทั่วไปที่ฟีเจอร์ใหม่นี้แก้ไข:
ลองมีฐานข้อมูลที่มีเอกสารที่อยู่ในหมวดหมู่
ใช้ TAG type คุณสามารถกรองผลลัพธ์การค้นหาบนหมวดหมู่ใดๆ ได้ง่าย:
แต่ถ้าคุณอยากทำ full-text search บนหมวดหมู่ด้วยล่ะ?
จนถึงตอนนี้ ด้วย hashes คุณต้อง duplicate ค่าเข้าไปใน 2 fields ซึ่งจะใช้หน่วยความจำสองเท่า
นี่คือที่ที่ FT.CREATE…AS กลายเป็น handy มาก กลับมาที่เอกสารที่เรียบง่ายดีของเรา:
…และใช้ฟีเจอร์ AS ใหม่:
…และ…
Bingo! ตอนนี้เราสามารถกรองด้วย tag และทำ full text search ใน field เดียวกันได้ โดยไม่ต้อง duplicate ข้อมูล
Query profiling
Time complexity ของคำสั่ง Redis ส่วนใหญ่มีเอกสารประกอบดี ตัวอย่าง HMGET มาพร้อม complexity O(N) “where N is the number of fields being requested” กับ RediSearch สามารถเขียน advanced queries ได้ Complexity ของ FT.SEARCH และ FT.AGGREGATE commands แต่ขึ้นอยู่กับความซับซ้อนของ query
เราอยากให้คุณเครื่องมือเข้าใจว่ากำลังเกิดอะไรขึ้นใต้ฝ้าเมื่อ query ถูก execute เพื่อหาว่าเวลาถูกใช้ที่ไหน และ query สามารถ optimize ได้อย่างไร คำสั่ง FT.PROFILE ใหม่ คืนค่า tree แสดงขั้นตอนหลักที่ RediSearch ใช้ execute query สำหรับแต่ละขั้นตอน ให้ข้อมูลเวลา
เกิดอะไรขึ้นใน RediSearch เมื่อเราทำ query ด้วย fuzzy search?
มาดูตัวอย่าง:
เราพร้อมที่จะ profile query ของเรา มา run profiling และแยกวิเคราะห์ผล profiling
redis.cloud:6379> FT.PROFILE idx SEARCH LIMITED QUERY "%hello%"
ก่อนอื่นเราได้ผลลัพธ์ มีประโยชน์สำหรับตรวจสอบว่า profiling query คืนค่าที่คาดหวัง
นี่คือเวลาทั้งหมด เรียกว่า “profile time” เพราะรวมเวลาที่ใช้เก็บข้อมูล profile
เวลาที่ใช้ในการ parse query และสร้าง execution plan:
นี่คือเวลาที่ใช้หา fuzzy matches ใน dictionary:
และสุดท้าย คุณเคยสงสัยไหมว่าการสร้าง search result หมายถึงอะไร? เราต้องคำนวณ full-text score สำหรับแต่ละเอกสาร เรียงลำดับตาม score และสุดท้าย load fields ด้วยข้อมูลนี้ คุณสามารถระบุ bottlenecks ทำให้ query เร็วขึ้น และปรับปรุงประสิทธิภาพของเซิร์ฟเวอร์
วิธีเริ่มต้น
เราเชื่อว่าความสามารถใหม่เหล่านี้เป็น game changers สำหรับนักพัฒนาแอปพลิเคชันและชุมชน Redis นี่คือวิธีเริ่มต้น
ใช้ docker image ของ preview
เพื่อเริ่มต้น คุณสามารถ pull docker image ต่อไปนี้ด้วย tag :preview:
docker run -p 6379:6379 redis/redismod:previewทางเลือกอื่น คุณสามารถ compile จาก RC1 release tags (v2.2.0 สำหรับ RediSearch, v2.0.0 สำหรับ RedisJSON) บน repositories ทั้งสอง และ load เข้า Redis
เมื่อรันแล้ว คุณสามารถลองคำสั่งทั้งหมดด้านบน หรือกับ quickstart guide นี้ เราจะเปิดตัวชุดบล็อกเกี่ยวกับ RedisMart แอปพลิเคชันรีเทลออนไลน์ที่เราแสดงใน keynote ของ RedisConf 2021 RedisMart ใช้ประโยชน์จาก RediSearch และ RedisJSON ที่ deploy แบบ geo-distributed เพื่อส่งมอบประสบการณ์รีเทลออนไลน์ที่ดีที่สุด ในชุดนี้ เราจะเดินคุณทีละขั้นตอนว่าสร้างแอปพลิเคชันนี้อย่างไร
พัฒนาด้วยเวอร์ชันล่าสุดของ compatible clients
รายการ clients ต่อไปนี้กำลังอัปเกรดอยู่ เพื่อให้คุณใช้ฟีเจอร์ใหม่กับ developer experience ที่ดี ตรวจสอบ latest releases และ/หรือ pull requests (ตอนนี้ส่วนใหญ่รองรับ preview version บน master branches)
| RedisJSON | RediSearch | |
| Node.js | redis-modules-sdk | redis-modules-sdk |
| Java | JredisJSON | JRediSearch |
| .NET | NRedisJSON | NRediSearch |
| Python | redisjson-py | redisearch-py |
ร่วมชุมชน
เรายินดีต้อนรับ feedback, bug reports, feature requests ขณะที่เราทำงานไปสู่ General Availability ให้ feedback บนเว็บไซต์เอกสาร หรือใน github repositories ของ RediSearch (บน Github) หรือ RedisJSON (บน Github) หรือติดต่อเราบน Discord
