

บทความนี้เป็นการต่อเนื่องจากโพสต์บล็อกที่เผยแพร่ในเดือนเมษายน 2021
เราสร้างแอปพลิเคชันตัวอย่างเพื่อเปรียบเทียบประสิทธิภาพของฐานข้อมูล Serverless ชั้นนำ โดยใช้กรณีการใช้งานเว็บทั่วไปและฟังก์ชัน Serverless ฐานข้อมูลที่ทดสอบได้แก่ DynamoDB, MongoDB (Atlas), Firestore, Cassandra (Datastax Astra), FaunaDB และ Redis (Upstash)
ดู แอปพลิเคชัน และ โค้ดต้นฉบับ
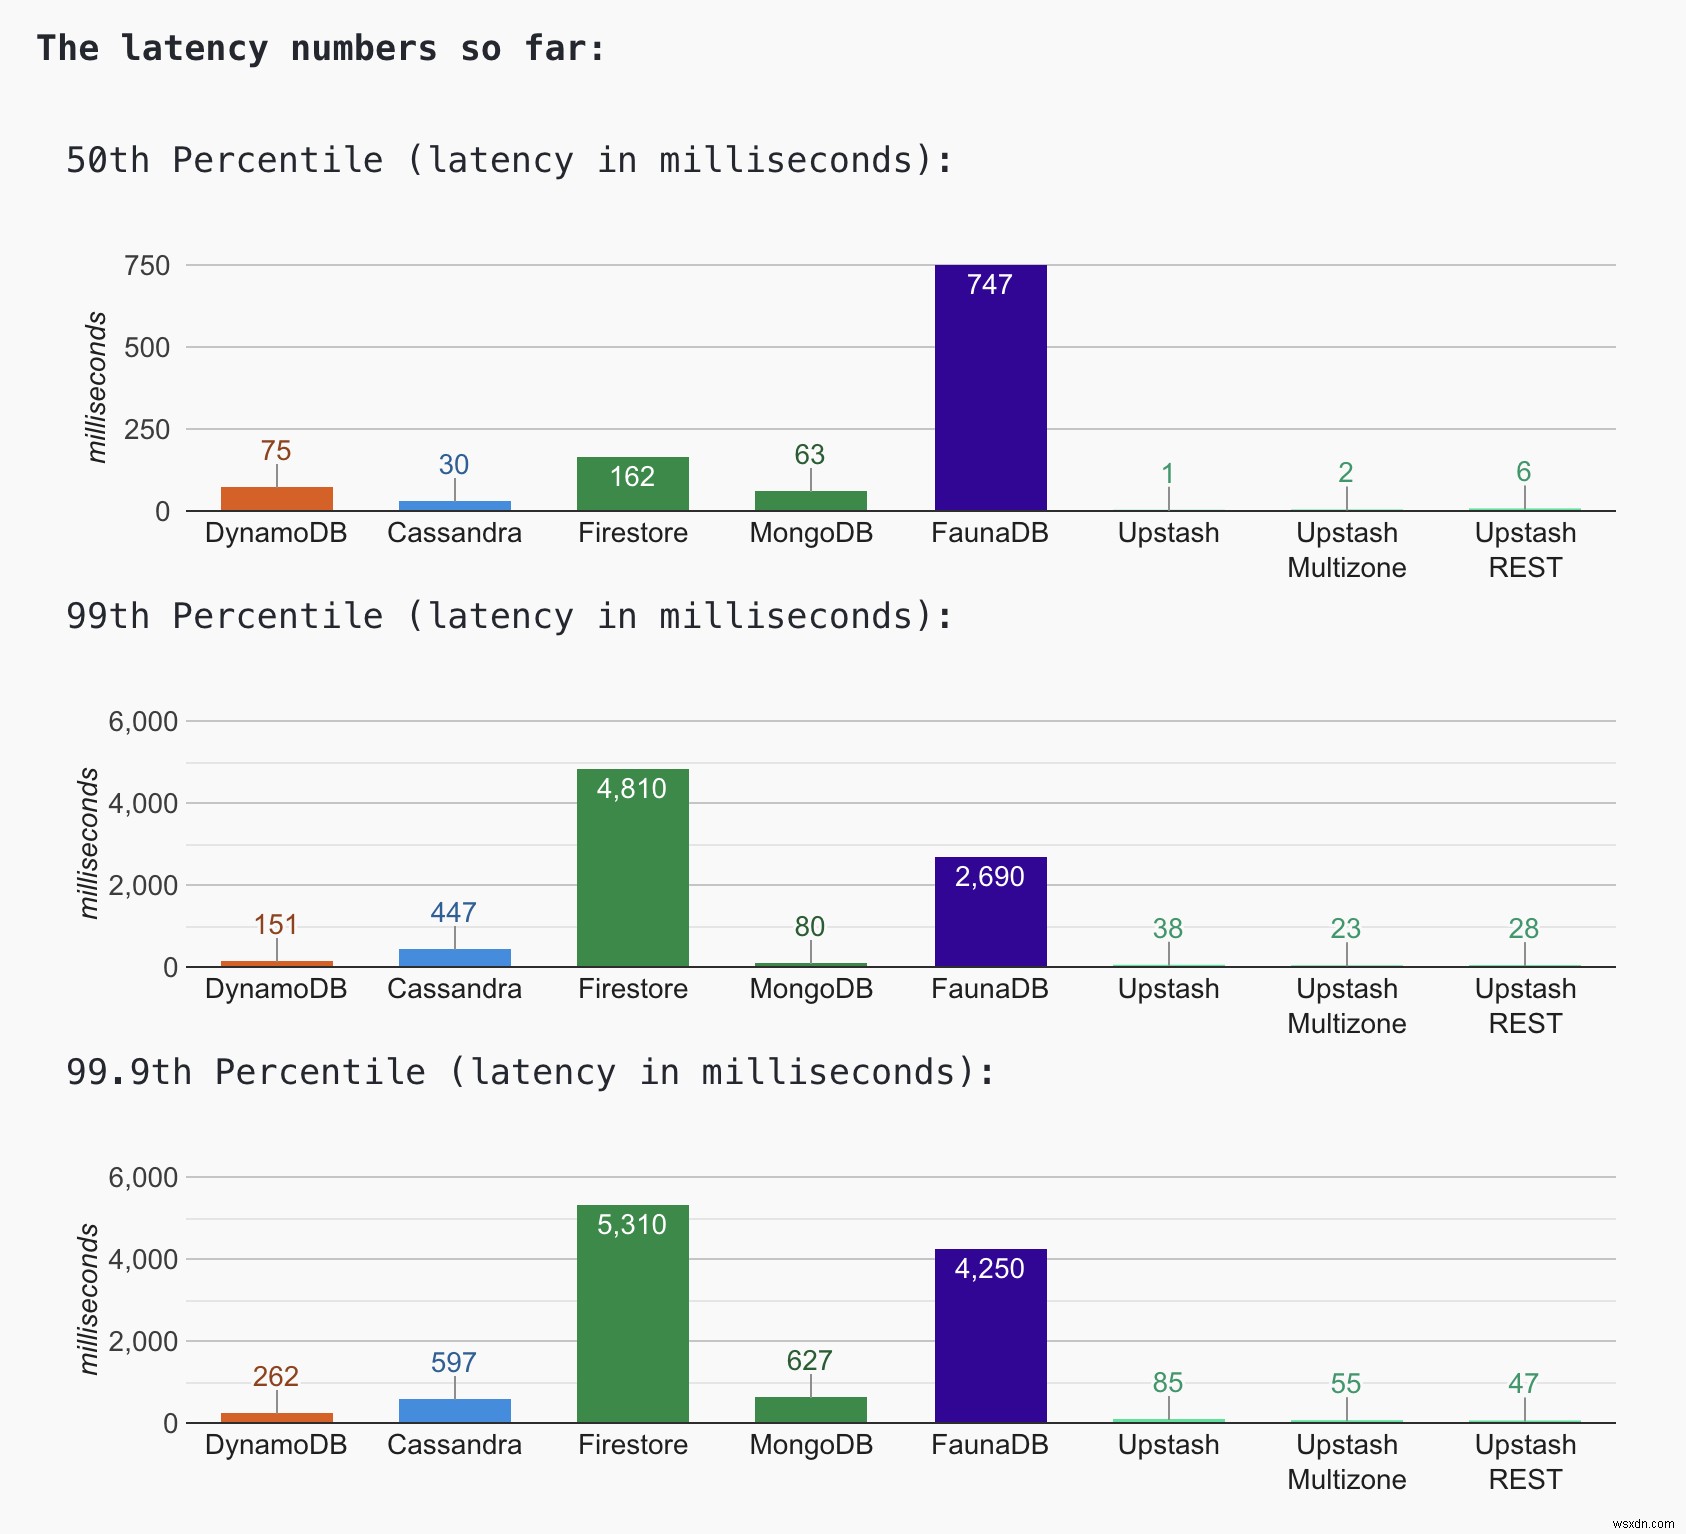
สิ่งที่เราเปรียบเทียบคือ Latency (เวลาในการตอบสนอง) ของการดึงข่าว 10 อันดับแรกจากแต่ละฐานข้อมูล ชุดข้อมูลทั้งหมดคือ 7,001 บทความข่าวจริงจาก New York Times API คิวรีที่เราวัด Latency มีดังนี้:
select * from news where section = "World" order by view_count desc limit 10แบ็กเอนด์ถูกนำไปใช้เป็นฟังก์ชัน Serverless บน AWS Lambda (Google Cloud Function สำหรับ Firestore) เราวางฟังก์ชัน Serverless และฐานข้อมูลไว้ในภูมิภาคเดียวกัน (เมื่อเป็นไปได้) เพื่อลด Latency ให้น้อยที่สุด
เราไม่นำเวลาเชื่อมต่อฐานข้อมูลมาคำนวณใน Latency และบันทึก Timestamp ก่อนและหลังการคิวรีโดยตรง Latency ถูกวัดและบันทึกที่แบ็กเอนด์ (ภายในฟังก์ชัน Serverless) จึงไม่รวม Latency เครือข่ายระหว่างเบราว์เซอร์และเซิร์ฟเวอร์ Latency ยังไม่ได้รับผลกระทบจาก Cold Start ของฟังก์ชัน Serverless อีกด้วย
เพื่อจำลองข้อมูลโลกจริงที่เปลี่ยนแปลงตลอดเวลา เรากำหนดค่า view_count แบบสุ่มให้กับ 10 บทความอันดับหน้า ทำให้ฐานข้อมูลต้องคืนชุดบทความที่ต่างกันทุกครั้ง เพื่อป้องกันไม่ให้ใช้แคช การอัปเดตข้อมูลไม่ได้รวมอยู่ในการคำนวณ Latency
นี่คือตัวเลข Latency ณ วันที่ 25 สิงหาคม
ด้านล่างนี้คือการตั้งค่าเฉพาะที่ใช้สำหรับแต่ละฐานข้อมูล:
DynamoDB
ภูมิภาค: US-West-1
ความจุอ่าน/เขียน: 50 (ค่าเริ่มต้นคือ 5)
ดัชนี: GSI ด้วย Partition Key เป็น section (String) และ Sort Key เป็น view_count (Number)
หมายเหตุ: Global Tables ไม่ได้เปิดใช้งาน เนื่องจากไคลเอ็นต์อยู่ในภูมิภาคเดียวกันแล้ว (US-West-1)
ดู โค้ด
MongoDB (Atlas)
ภูมิภาค: AWS N. Virginia (us-east-1)
ระดับคลัสเตอร์: M5 (General)
ดัชนี: Compound Index บน section และ view_count
หมายเหตุ: ผมอยากลอง MongoDB Serverless แต่ไม่มี Node.js Driver แต่ควรไม่เป็นปัญหาเพราะผมเก็บการเชื่อมต่อ DB ไว้นอกส่วนที่คำนวณ Latency
ดู โค้ด
Firestore
ภูมิภาค: GCP US-Central
โหมด: Datastore
ดัชนี: Composite Index บน section (ascending) และ view_count (descending)
ดู โค้ด
Cassandra (Datastax Astra)
ภูมิภาค: AWS US-East-1
แผน: Pay as you go
ดัชนี: PRIMARY KEY (section, view_count, id)
API: REST API
ดู โค้ด
FaunaDB
แผน: Individual ($25 ต่อเดือน)
ดัชนี: term=section, value=view_count
API: FQL
ดู โค้ด
Redis (Upstash)
ภูมิภาค: AWS US-West-1
แผน: Pay as you go
ดัชนี: ใช้ SortedSet
หมายเหตุ: ทดสอบฐานข้อมูล Single Zone และ Multi Zone แยกกัน
ดู โค้ด
หมายเหตุพิเศษ
- FaunaDB: มีการטיחความสอดคล้อง (Consistency) ที่ดีกว่าและ Global Replication โดยค่าเริ่มต้น ไม่ให้เลือกภูมิภาคการปรับใช้ได้ สิ่งเหล่านี้อาจเป็นเหตุผลที่ทำให้ประสิทธิภาพต่ำกว่า
- Firestore: ประสิทธิภาพคล้ายกับฐานข้อมูลอื่นแต่มี Variance (ความแปรปรวน) สูงกว่า อาจเพราะมี Overhead ของ Cold Connections ผมหาวิธีเก็บ Connection ให้คงอยู่ไม่ได้ หากมีไอเดียแจ้งมาได้เลย
- Cassandra: ไม่อนุญาตให้อัปเดตฟิลด์ Primary Key Secondary Index ไม่แนะนำหากจะอัปเดตดัชนีบ่อย ดังนั้นจึงไม่สามารถอัปเดต view_count ได้ ซึ่งอาจส่งผลให้ประสิทธิภาพดูดีขึ้น
- Upstash Single Zone: ดูเร็วกว่า Multi Zone เล็กน้อย แต่ความต่างไม่มากนัก REST API มีประสิทธิภาพใกล้เคียง Native API ใน Percentiles สูง
โปรดทราบว่านี่เป็นความพยายามต่อเนื่อง เราจะยังคงปรับโค้ดเพื่อปรับปรุงคุณภาพ Benchmark เมื่อเรา Refactor โค้ดของผลิตภัณฑ์ใด เราจะ Reset Histogram ของมัน โปรดตรวจสอบโค้ดและแจ้งให้เราทราบหากมีสิ่งที่ควรปรับปรุง ติดต่อเราได้ที่ Twitter และ Discord
