

บทนำ
- แพลตฟอร์มแบ่งกลุ่มมีบทบาทสำคัญในการเข้าใจและจัดหมวดหมู่ลูกค้า ผลิตภัณฑ์ และข้อมูลที่เกี่ยวข้องอื่นๆ
- การแบ่งกลุ่ม (Segmentation) คือการแบ่งกลุ่มใหญ่ออกเป็นกลุ่มย่อยที่สม่ำเสมอง่ายกว่า ตามเกณฑ์บางประการ
- ตัวอย่างแพลตฟอร์มแบ่งกลุ่มในโดเมนต่างๆ เช่น แบ่งกลุ่มลูกค้าสำหรับกลยุทธ์การตลาดแบบเฉพาะบุคคล โปรโมชั่นเป้าหมาย และประสบการณ์ช้อปปิ้งที่ปรับแต่งได้
สารบัญ
- ทำความเข้าใจข้อกำหนด
- สถาปัตยกรรมพื้นฐาน
- ส่วนประกอบสถาปัตยกรรม
- ความท้าทายในการออกแบบ
- โซลูชันที่เสนอ
- บันทึกปิดท้าย
1. ทำความเข้าใจข้อกำหนด
การออกแบบแพลตฟอร์มแบ่งกลุ่มลูกค้าในอีคอมเมิร์ซที่มีความหน่วงต่ำ (low-latency) นำเสนอความท้าทายเฉพาะทางเกี่ยวกับการประมวลผลแบบเรียลไทม์ ประสบการณ์ผู้ใช้ และลักษณะพฤติกรรมลูกค้าที่เปลี่ยนแปลงตลอดเวลา นี่คือความท้าทายบางประการที่อาจพบ:
-
ชุดข้อมูลขนาดใหญ่และไดนามิก
- แพลตฟอร์มอีคอมเมิร์ซจัดการกับชุดข้อมูลขนาดใหญ่ที่เปลี่ยนแปลงตลอดเวลา รวมถึงโปรไฟล์ลูกค้า แคตตาล็อกสินค้า และประวัติธุรกรรม
- การจัดการและประมวลผลชุดข้อมูลมหาศาลนี้แบบเรียลไทม์พร้อมรักษาความหน่วงต่ำ เป็นความท้าทายอย่างมาก
-
ความสามารถในการปรับขนาด (Scalability)
- การออกแบบเพื่อ scalability จำเป็นสำหรับรับมือกับ workload ที่เปลี่ยนแปลง ต้องแน่ใจว่าระบบ scale horizontally โดยเพิ่มหน่วยประมวลผลได้โดยไม่เสียสละ latency ต้องวางแผนสถาปัตยกรรมอย่างรอบคอบ
-
การประมวลผลแบบอะซิงโครนัส
- การใช้ asynchronous processing ช่วยแยก components และปรับปรุงความตอบสนองของระบบโดยรวม แต่การจัดการการสื่อสารแบบ async โดยไม่เพิ่มความซับซ้อนหรือความล่าช้า ต้องออกแบบอย่างระมัดระวัง
Data Flow และ Pipelines
- การออกแบบ data flow และ processing pipeline ที่มีประสิทธิภาพ สำคัญสำหรับระบบ low-latency
- การลดเวลาที่ข้อมูลใช้ในการเคลื่อนที่ระหว่าง components และเพิ่มประสิทธิภาพลำดับขั้นตอนการประมวลผล สามารถส่งผลต่อ latency โดยรวมได้มาก
-
สถาปัตยกรรม Microservices
- Microservices architecture ช่วยเพิ่ม scalability และ flexibility แต่การรับรองการสื่อสารระหว่าง microservices ราบรื่นโดยไม่เพิ่ม latency อาจท้าทายได้
- การออกแบบ API ที่มีประสิทธิภาพและจัดการ inter-service communication เป็นสิ่งสำคัญ
2. สถาปัตยกรรมพื้นฐาน
Segmentation Platform ประกอบด้วย 3 subsystem หลัก: 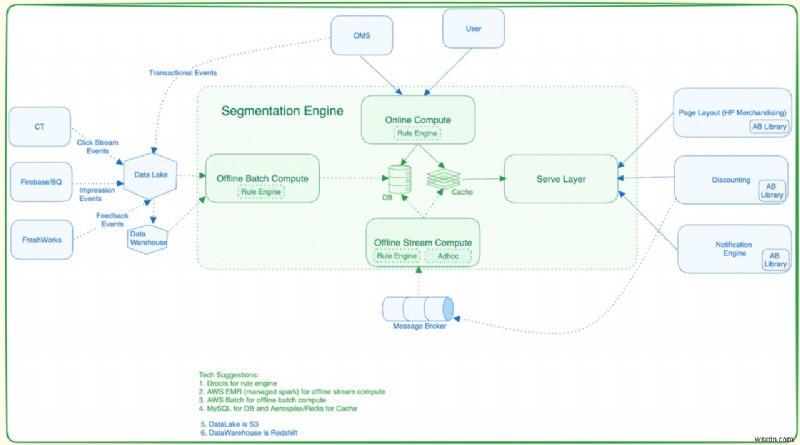
-
Compute Service (Offline Batch Compute/Online Compute):
- ดึง user segments จาก raw data โดยใช้ Spark Jobs
- Spark job ดึงข้อมูล ทำความสะอาด และ validate จาก data lake
- ส่งข้อมูลผลลัพธ์ไปยัง serving sub-system
-
Ingestion Service:
- ถ่ายโอน segments ที่คำนวณได้จาก compute service ไปยัง segmentation service
- จัดการการรวมและ Ausschluss (การตัดออก) ของผู้ใช้ภายใน segments
-
Segment Service (Serve Layer):
- ให้ user segments ตามความต้องการเฉพาะสำหรับ user service หรือ discount service
- Discount service อาจ query ตาม user ID และคำนวณส่วนลดที่ใช้ได้
User ID Segment ID Created At 2521 Segment X Dec 3, 2023 2788 Segment Y Dec 3, 2023 3943 Segment Z Dec 3, 2023
3. ส่วนประกอบสถาปัตยกรรม
Segmentation platform ประกอบด้วย major components ต่อไปนี้: 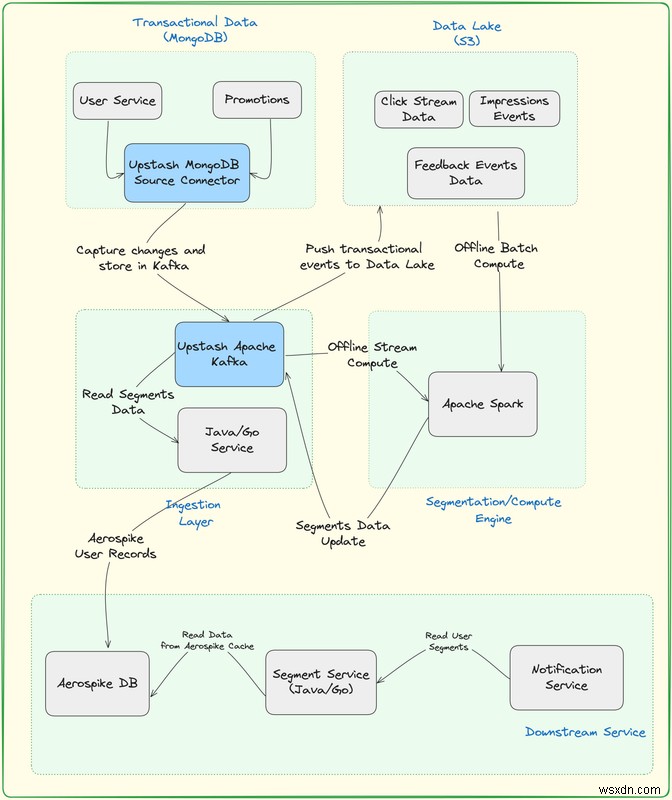
-
Data Lake - S3
- S3 เป็นตัวเลือกที่ได้รับการยอมรับกว้างขวางและหลากหลายสำหรับทำหน้าที่ data lake ความสามารถ object storage ที่ scalable และ durable ทำให้เหมาะสำหรับเก็บและจัดการข้อมูลปริมาณมากหลากหลายประเภท
- การใช้ S3 เป็น data lake ให้ประโยชน์จากฟีเจอร์ที่แข็งแกร่งสำหรับ storage, retrieval และ management ทำให้เป็นตัวเลือกยอดนิยมในแอปพลิเคชันและสถาปัตยกรรมที่เน้นข้อมูล
-
Transactional Database MongoDB
- Document-oriented model ของ MongoDB เหมาะกับ transactional use cases เพราะเก็บโครงสร้างข้อมูลซับซ้อนในรูปแบบคล้าย JSON ได้ ความยืดหยุ่นนี้มีประโยชน์โดยเฉพาะสำหรับแอปที่โครงสร้างข้อมูลอาจเปลี่ยนแปลงตามเวลา
-
Upstash Kafka Cluster
- สามารถสตรีม traffic (click) events จากเว็บแอปไปยัง Upstash Kafka แล้วเก็บไว้ใน data lake เพื่อประมวลผลต่อ
- Upstash Kafka เป็น Serverless Kafka อันแรกของโลก ด้วยโมเดล pay-per-request สามารถมี Kafka cluster ที่จัดการเต็มรูปแบบโดยไม่ต้องจ่ายหลายร้อยดอลลาร์ ด้วย free tier สร้าง Kafka cluster ได้ในวินาทีโดยไม่ต้องใส่บัตรเครดิต ทีม Upstash ดูแล availability, maintenance, scaling, upgrades และงานน่าเบื่ออื่นๆ ขณะที่คุณโฟกัสที่แอป
-
Upstash MongoDB Source Connector
- MongoDB Source Connector เป็น component ใน data integration และ streaming platforms เช่น Apache Kafka Connect ใช้เชื่อมต่อ MongoDB database และ capture changes หรือ events แบบเรียลไทม์
- Upstash MongoDB Source connector ช่วยการเคลื่อนย้ายข้อมูลจาก MongoDB ไปยังระบบหรือแพลตฟอร์มอื่น ทำให้ data integration และ analytics ราบรื่น
-
Apache Spark
- Apache Spark เป็น multi-language engine สำหรับ data engineering, data science และ machine learning บน single-node หรือ clusters
- ผสาน Upstash Kafka กับ Apache Spark (มี out-of-the-box ใน Upstash) สตรีม traffic events จากเว็บแอปไป Kafka แล้ววิเคราะห์ real-time
- Spark จะรับผิดชอบประมวลผล updates ของ user segments updates นี้จะเขียนไป Upstash Kafka ก่อน propagate ไป update Aerospike database
4. ความท้าทายในการออกแบบ
การใช้งาน segmentation engine ที่เพิ่มขึ้นอาจนำความท้าทายบางอย่างมาให้ระบบ:
- Write QPS Bottleneck: การสร้าง segments มากขึ้นและใหญ่ขึ้น อาจนำไปสู่ bottleneck ใน write QPS ทำให้รอนานสำหรับการสร้าง segment
- Lower Latency Request: การบรรลุ latency ต่ำมาก สำคัญสำหรับการส่ง communication บางประเภท โดยเฉพาะการตัดสินใจว่าผู้ใช้อยู่ใน segment ไหน
-
Read Latency
- แม้ platform จะพัฒนาไป แม้จะมี latency < 50ms สำหรับ reads อาจยังไม่พอสำหรับ services บางตัวและ use cases ในอนาคต
- เช่น notification service คาดว่าจะต้องตรวจสอบ user segment membership อย่างรวดเร็วก่อนส่ง communication การเพิ่ม latency ต่อแต่ละ request คาดว่าจะ不可接受ในอนาคต
-
การจัดการ Kafka Infrastructure
- การจัดการ millions of events ต่อนาทีจาก transactional sources อาจท้าทายเมื่อใช้ Kafka infrastructure ต้องพิจารณาปัจจัยต่างๆ อย่างรอบคอบ
- Performance testing และ optimization เป็นกุญแจสำคัญสำหรับ high-throughput Kafka infrastructure
-
MongoDB Change Data Capture
- การรวม events จากเว็บแอป โดยเฉพาะที่เก็บใน traditional transactional databases เช่น MongoDB แล้ว push ไป data lake อาจต้องใช้ความพยายาม
- ใช้ change data capture mechanisms ของ MongoDB หรือ implement custom solution เพื่อ capture การเปลี่ยนแปลงใน database
5. โซลูชันที่เสนอ
-
Distributed cache Aerospike เพื่อปรับปรุง read latency
- Aerospike จะเก็บ segments ของ user โดย user ID เป็น primary key สำหรับเข้าถึง user segments
- ยัง implement secondary indexes บน segment IDs ได้ ทำให้ดึง users ของ segment ได้ง่ายขึ้น ไม่ต้องเก็บ segment users แยก
- Design นี้ aims to meet latency requirements อาจทำหน้าที่เป็น cache แทน Redis ได้
- การแทนที่ Aerospike ด้วย Upstash Redis จะต้องจัดการ 2 ชุดข้อมูล: segment users และ user segments
-
Serverless Upstash Kafka เพื่อจัดการ Kafka infrastructure
- Upstash Kafka = fully managed service Upstash ดูแล server provisioning, scaling, maintenance ทั้งหมด
- ลดภาระ setup infrastructure, ทำให้ทำงานถูกต้อง และ maintain ตลอดเวลา
- โฟกัสที่การใช้ Kafka สำหรับความต้องการเฉพาะ โดยไม่ต้องกังวล infrastructure
- Price scales to zero: Serverless จริงไม่คิดค่าใช้จ่ายถ้าไม่ใช้งาน Price-per-request เป็นฟีเจอร์เด่น ต้อง minimize fixed costs ซึ่งยากสำหรับ Kafka
- No operational burden: User สร้าง topic เริ่มใช้ได้ HA, scalability, upgrades, backups... เป็นความรับผิดชอบของ Upstash
- Connectionless: Serverless functions ไม่ hold state ควรเข้าถึงข้อมูลด้วย stateless connection Upstash Kafka รองรับ Kafka TCP protocol (Kafka clients ทั้งหมดทำงานได้) และมี built-in REST API สำหรับ connectionless environments เช่น AWS Lambda หรือ Cloudflare Workers
-
MongoDB CDC ด้วย Upstash MongoDB Source Connector
- Kafka Connect = tool สตรีมข้อมูลระหว่าง Apache Kafka และระบบอื่นๆ โดยไม่เขียนโค้ด Kafka Sink Connectors export ไป storage อื่น Kafka Source Connectors pull data มา Kafka topics จากระบบอื่น
- Kafka Connectors self-hosted ได้ แต่ต้อง setup/maintain extra processes/machines Upstash ให้ hosted versions ของ connectors สำหรับ Kafka cluster ของคุณ ลดภาระ maintain ระบบเพิ่ม และ performant กว่าเพราะอยู่ใกล้ cluster
6. บันทึกปิดท้าย
บล็อกนี้สำรวจหลักการออกแบบแพลตฟอร์มแบ่งกลุ่ม low-latency ด้วยเทคโนโลยีจาก Upstash Infrastructure วิศวกรรมมาให้ scale ได้ราบรื่น รองรับล้านๆ users และจัดการ terabytes ของข้อมูลใน data lake
