

ในบล็อกเกี่ยวกับ Big Data เราได้พูดถึง Functional Layers ของ Big Data และในบล็อกก่อนหน้า ผมได้รายการ Top 11 Cloud Data Storage Tools ขั้นตอนต่อไปหลังการจัดเก็บคือกระบวนการทำความสะอาดข้อมูล (Data Cleansing Process)
เมื่อพูดถึง Big Data มันชัดเจนว่าข้อมูลเติบโตในอัตราที่น่ากลัว ไม่ว่าจะเป็นข้อมูลธุรกิจหรือส่วนบุคคล หากอ้างอิงข้อเท็จจริง ทุกวันมีข้อมูลสร้างขึ้น 2.5 ควินติลลิออน ไบต์ (Quintillion Bytes) ข้อมูลนี้ยังมีบันทึกซ้ำซ้อนและผิดพลาด ซึ่งเราต้องกำจัดก่อนการทำเหมืองข้อมูล (mining) เพื่อหาข้อมูลเชิงลึก (insights) ข้อมูลที่ไม่แม่นยำ นำไปสู่สมมติฐานและการวิเคราะห์ที่ผิด ทำให้โครงการล้มเหลว
Data Cleansing (การทำความสะอาดข้อมูล) คือชื่อของกระบวนการแก้ไขและกำจัด (หากจำเป็น) บันทึกที่ไม่แม่นยำจากฐานข้อมูลเฉพาะเจาะจง วัตถุประสงค์คือตรวจจับ "Dirty Data" (ข้อมูลสกปรก) เพื่อแก้ไขหรือลบ เพื่อให้ชุดข้อมูลที่กำหนดแม่นยำและสอดคล้องกับชุดข้อมูลอื่นๆ ในระบบ
มีเครื่องมือทำความสะอาดข้อมูลหลากหลาย เครื่องมือที่ดีช่วยทำความสะอาดฐานข้อมูลของคุณจากข้อมูลซ้ำ รายการที่ผิด และข้อมูลไม่ถูกต้อง เครื่องมือเหล่านี้แบ่งได้ตามสภาพแวดล้อมที่ใช้:
- Offline Data Cleaning Tools (เครื่องมือทำความสะอาดข้อมูลออฟไลน์)
- Cloud Based Data Cleaning tools (เครื่องมือทำความสะอาดข้อมูลบนคลาวด์)
- Data Cleaning tools for Salesforce Data (เครื่องมือสำหรับข้อมูล Salesforce)
บล็อกนี้จะแนะนำเครื่องมือ Offline Data Cleaning Tools ที่ดีบางตัว
1. Drake
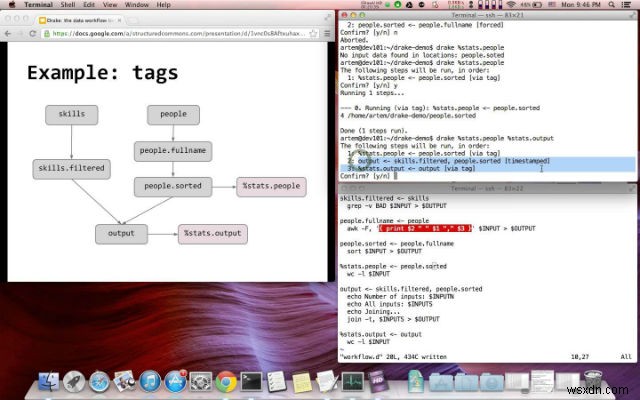
Drake เป็นเครื่องมือ workflow ข้อมูลแบบข้อความ (text-based) ที่ใช้ง่าย ขยายได้ (extensible) จัดระเบียบการรันคำสั่งรอบข้อมูลและ dependencies ขั้นตอนการประมวลผลข้อมูลถูกกำหนดพร้อมกับ inputs และ outputs มัน resolve dependencies อัตโนมัติ และให้ตัวเลือกหลากหลายสำหรับควบคุม workflow รองรับ multiple inputs/outputs และมี HDFS support built-in
2. OpenRefine
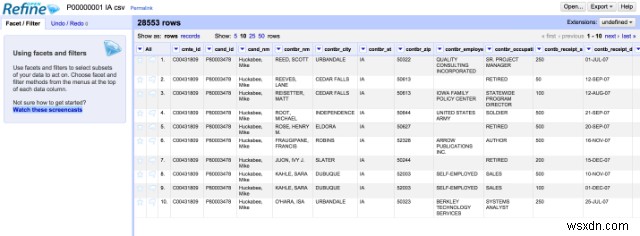
OpenRefine (ก่อนหน้านี้เรียกว่า Google Refine) เป็นแอปพลิเคชันเดสก์ท็อป standalone open source ที่ทรงพลังสำหรับทำงานกับข้อมูลที่وضحل (messy data) มีฟีเจอร์ Data Wrangling คือ ทำความสะอาดข้อมูลและแปลงข้อมูลจากรูปแบบหนึ่งไปอีกรูปแบบหนึ่ง คล้ายกับแอปพลิเคชันสเปรดชีต แต่ทำงานคล้ายฐานข้อมูลมากกว่า
ทำงานกับข้อมูลคล้ายตาราง relational database คือ ทำงานบนแถว (rows) ที่มีเซลล์ (cells) ภายใต้คอลัมน์ (columns) หนึ่งโปรเจกต์ OpenRefine คือหนึ่งตาราง ผู้ใช้สามารถเปลี่ยนการแสดงแถวได้ด้วยเกณฑ์การกรองต่างๆ ทุกการกระทำบนชุดข้อมูลจะถูกเก็บในโปรเจกต์และสามารถ replay บนชุดข้อมูลอื่นได้
3. Trifacta Wrangler
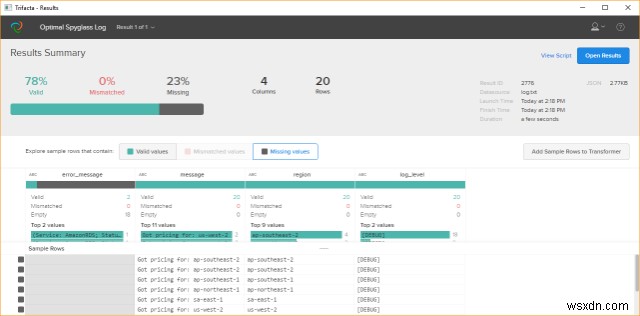
เครื่องมือนี้ช่วยในกระบวนการ Data Wrangling Data wrangling ถูกนิยามแบบหลวมๆ ว่า กระบวนการแปลงหรือแมปข้อมูลด้วยตนเองจากรูปแบบดิบ (raw form) ไปสู่รูปแบบอื่นที่ทำให้การบริโภคข้อมูลง่ายขึ้น ด้วยช่วยเหลือจาก semi-automated tools
Wrangler ปรับปรุงอย่างมากวิธีที่องค์กรสร้างคุณค่าจากข้อมูลหลากหลาย ด้วย Trifacta Wrangler แนวทางใหม่ถูกนำมาใช้ในวิธีที่นักวิเคราะห์ทำให้ข้อมูลมีประโยชน์ โดยใช้เทคนิคล่าสุดในการจินตนาการข้อมูล (data visualization) machine learning, human-computer interaction และการประมวลผลข้อมูล พวกเขามีเป้าหมายง่ายๆ: ใช้เวลาน้อยลงในการจัดรูปแบบ และมากขึ้นในการวิเคราะห์ข้อมูล อนุญาตให้ interactive transformation ของข้อมูลจริงที่وضحل (messy, real-world data) กลายเป็นตารางข้อมูลสำหรับเครื่องมือวิเคราะห์
4. DataCleaner
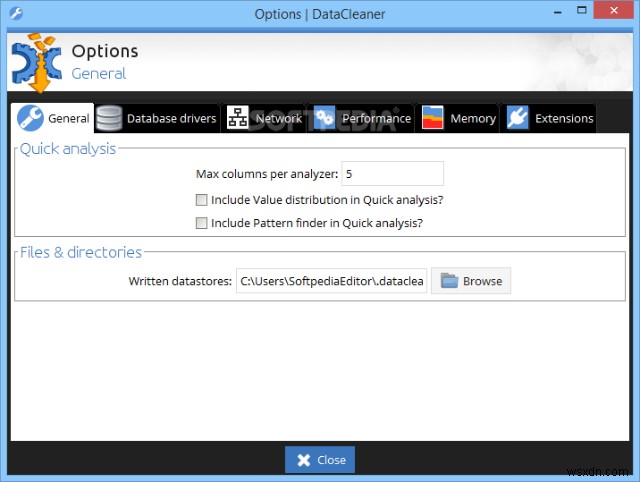
Data Cleaner เป็นแอปพลิเคชันวิเคราะห์คุณภาพข้อมูล (data quality analysis) และแพลตฟอร์มโซลูชันสำหรับ Data Quality Solutions หัวใจหลักคือ profiling engine ที่แข็งแกร่ง ซึ่งขยายได้ (extensible) และเพิ่มการทำความสะอาดข้อมูล การแปลงข้อมูล การเพิ่มคุณค่า (enrichment) การลบซ้ำ (deduplication) การจับคู่ (matching) และการรวม (merging) ฟีเจอร์บางอย่าง:
- ค้นหา patterns, missing values, character sets และลักษณะอื่นๆ ของค่าข้อมูล
- ทำความสะอาดรายละเอียดติดต่อด้วยการตรวจสอบชื่อและที่อยู่
- ตรวจจับ duplicates โดยใช้ fuzzy logic และ weights/thresholds ที่กำหนดได้ และสร้าง single version
- สร้าง cleansing rules ของตัวเอง และ compose เข้ากับ scenario หลายๆ กรณีและ target databases
5. Winpure Clean and Match
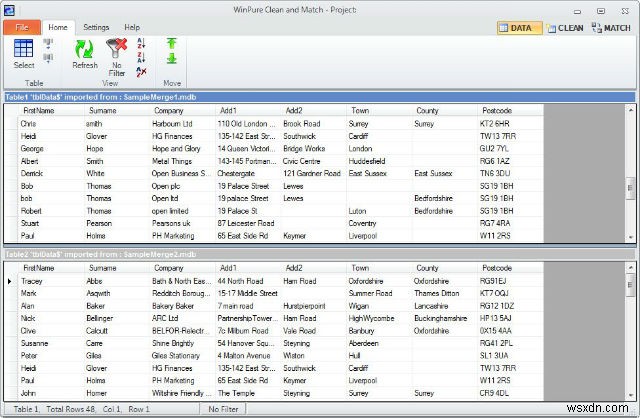
Data Quality control เป็นปัจจัยสำคัญที่สุดด้านหลังความสำเร็จของโครงการหรือแคมเปญ เป็นชุดทำความสะอาดและจับคู่ข้อมูล (data cleansing and matching suite) ออกแบบมาเพื่อเพิ่มความแม่นยำของข้อมูลธุรกิจหรือผู้บริโภค เป็นซอฟต์แวร์ชุดที่ได้รับรางวัล เหมาะสำหรับทำความสะอาด แก้ไข และลบซ้ำ (deduplicate) mailing lists, databases, spreadsheets และ CRMs ใช้ได้กับฐานข้อมูล Access, Dbase, SQL Server และตาราง Excel และไฟล์ Txt
6. TIBCO Clarity
TIBCO Clarity เป็นเครื่องมือเตรียมข้อมูล (data preparation tool) ที่เสนอ on-demand software services จากเว็บในรูปแบบ Software-as-a-Service สามารถใช้เพื่อ discover, profile, cleanse, และ standardize raw data ที่รวบรวมจากแหล่งต่างๆ (disparate sources) และให้ข้อมูลคุณภาพดีสำหรับการวิเคราะห์ที่แม่นยำและการตัดสินใจที่ฉลาด ฟีเจอร์ของ TIBCO Clarity สำหรับจัดการ raw data:
- Seamless Integration
- Data Discovery and Profiling
- De-duplication
- Address Standardization
- Data Transformation
7. Data Ladder
Data Ladder Company เป็นบริษัทซอฟต์แวร์คุณภาพข้อมูล (data quality software company) วัตถุประสงค์คือช่วยให้ผู้ใช้ธุรกิจได้ประโยชน์สูงสุดจากข้อมูลของพวกเขาผ่าน data matching, profiling, de-duplication, และ enrichment tools The Data Match Enterprise suite เป็นแอปพลิเคชันทำความสะอาดข้อมูลเดสก์ท็อปที่มีภาพชัดเจน (highly visual) ออกแบบมาเฉพาะเพื่อแก้ไขปัญหาคุณภาพข้อมูลลูกค้าและติดต่อ Data Match Enterprise รวมอัลกอริทึม proprietary และมาตรฐานหลายตัวสำหรับตรวจจับ phonetic, fuzzy, miskeyed, และ abbreviated variations
Data Deduplication Software เสนอโซลูชันครบวงจรสำหรับคุณภาพข้อมูล การทำความสะอาด การจับคู่ และ de-duplication ในชุดซอฟต์แวร์เดียวที่ใช้ง่าย
8. Star DQ Pro
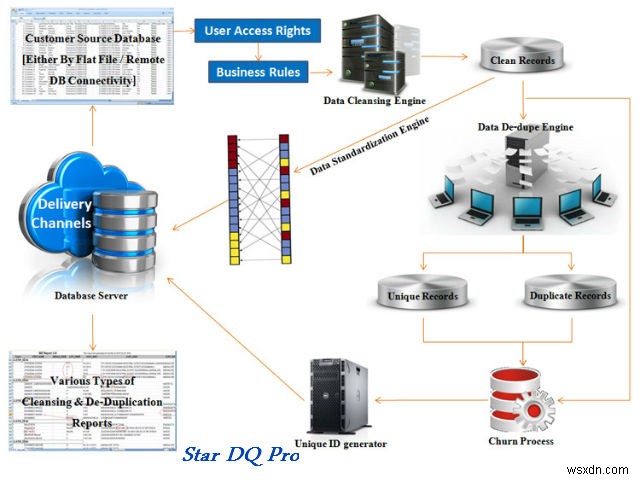
ให้แน่ใจว่าข้อมูลของคุณแม่นยำ แท้จริง และทันสมัย มันตอบสนองความต้องการหลักของคุณภาพข้อมูล เช่น accuracy, completeness, consistency, timelines, uniqueness และ validity ฟีเจอร์ที่เสนอ:
- Cleansing – กำหนดประเภทข้อบกพร่อง สร้าง log ของข้อมูลไม่สะอาดพร้อมความคิดเห็น
- De-duping – การจัดกลุ่มและ clustering, ระบุ misrepresents, ongoing incremental de-duping
- Monitoring – transaction log, process status alert ผ่านอีเมล/SMS, user authentication
การทำความสะอาดข้อมูลมีความสำคัญยิ่งเมื่อจัดเก็บข้อมูลปริมาณมาก เป้าหมายของการดำเนินการแก้ไขข้อมูลสกปรกคือทำให้ข้อผิดพลาดน้อยที่สุดเท่าที่จะเป็นไปได้ หากไม่ทำความสะอาดข้อมูลเป็นประจำ ข้อผิดพลาดอาจสะสมและนำไปสู่การลดประสิทธิภาพการทำงาน ในบล็อกถัดไปเกี่ยวกับ Big Data ผมจะรายการ cloud based data cleansing tools และ tools สำหรับฐานข้อมูล Salesforce
