

คุณน่าจะเคยเห็น Ruby exception อย่าง UndefinedConversionError หรือ IncompatibleCharacterEncodings น่าจะน้อยกว่าที่เข้าใจว่า exception มันหมายถึงอะไร บทความนี้จะช่วย คุณจะเรียนรู้ character encodings ทำงานอย่างไร และ implement ใน Ruby ยังไง จบแล้ว คุณจะเข้าใจและแก้ errors เหล่านี้ได้ง่ายขึ้นมาก
Character encoding คืออะไร?
ในทุกภาษาโปรแกรมมิ่ง คุณทำงานกับ strings บางครั้ง process เป็น input บางครั้ง display เป็น output แตคอมพิวเตอร์ไม่เข้าใจ "strings" มันเข้าใจแค่ bits: 1 และ 0 กระบวนการแปลง strings เป็น bits เรียกว่า character encoding
แต่ character encoding ไม่ได้เป็นของคอมพิวเตอร์อย่างเดียว เราเรียนรู้จากกระบวนการง่ายก่อนมีคอมพิวเตอร์: Morse code
Morse code
Morse code เรียบง่ายในนิยาม มี 2 symbols หรือวิธีสร้างสัญญาณ (สั้นและยาว) ด้วย 2 symbols นี้ represent อัลฟาเบตอังกฤษง่ายๆ เช่น:
- A คือ .- (one short mark และ one long mark)
- E คือ . (one short mark)
- O คือ --- (three long marks)
ระบบนี้ประดิษฐ์ราว 1837 อนุญาตให้ encode อัลฟาเบททั้งหมดด้วยแค่ 2 symbols
ลองเล่น translator ออนไลน์ได้ที่นี่
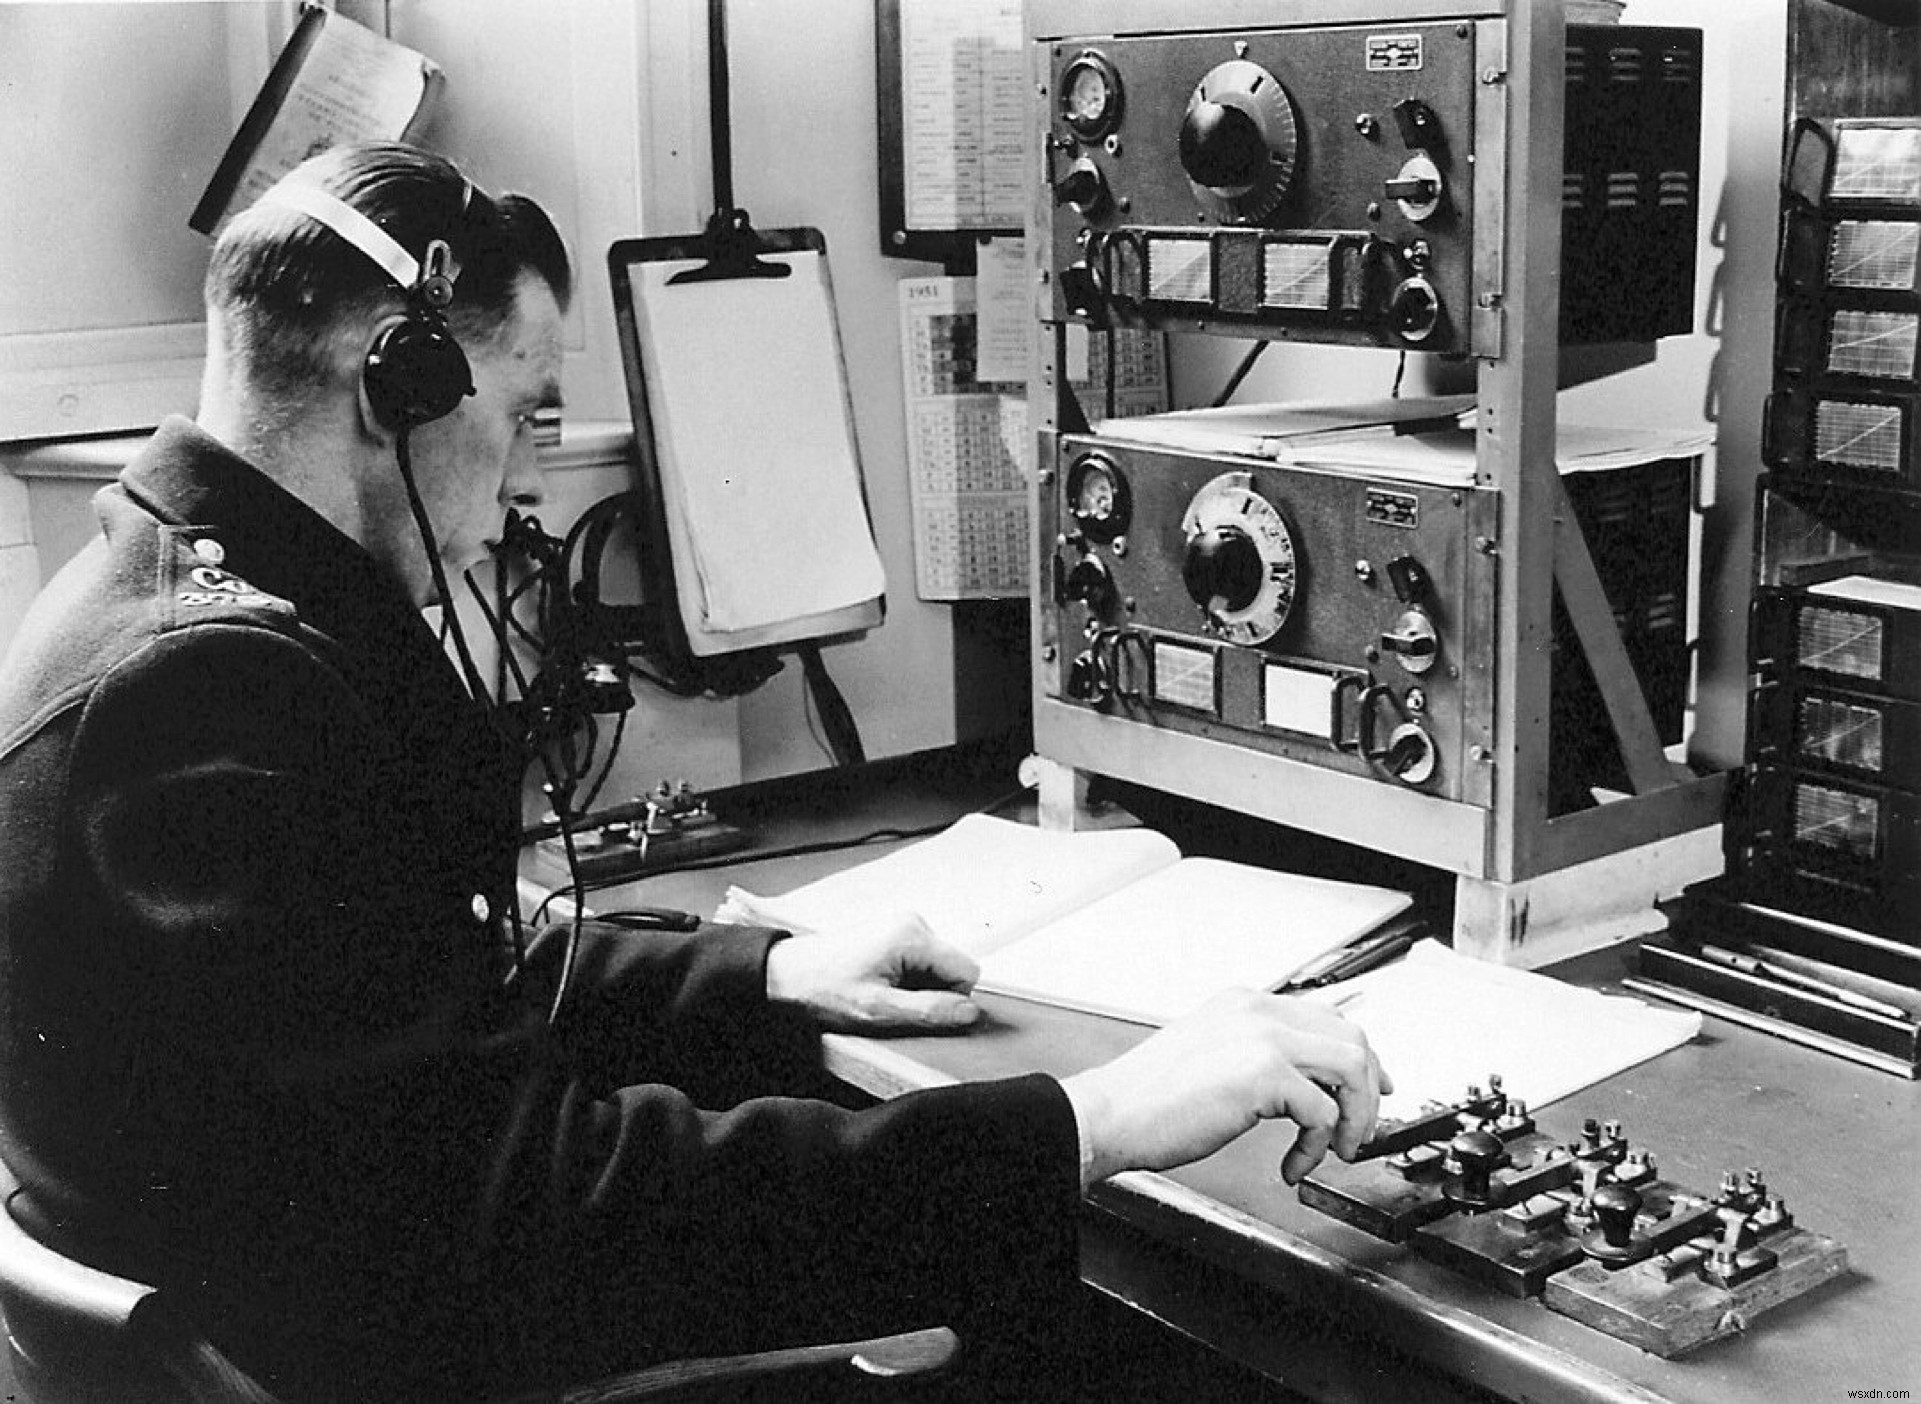
ในรูปเห็น "encoder" คนที่ encode และ decode ข้อความ เร็วๆ นี้จะเปลี่ยนด้วยคอมพิวเตอร์
จาก manual ไป automatic encoding
encode message ต้องมีคนแปลง characters เป็น symbols ตาม Morse code algorithm
คล้าย Morse code คอมพิวเตอร์ใช้ 2 "symbols": 1 และ 0 เก็บ sequence ของพวกมัน และตอนอ่าน ต้อง interpret ให้มีความหมายให้ผู้ใช้
กระบวนการทำงานเหมือนกันทั้งคู่:
Message -> Encoding -> Store/Send -> Decoding -> MessageSOS ใน Morse code:
SOS -> Encode('SOS') -> ...---... -> Decode('...---...') -> SOS
----------------------- --------------------------
Sender                    Receiver
การเปลี่ยนแปลงใหญ่กับคอมพิวเตอร์และเทคโนโลยีคือ encoding/decoding กลายเป็น automated ไม่ต้องคนแปลแล้ว
ตอนคอมพิวเตอร์ประดิษฐ์ มาตรฐาน early สำหรับแปลง characters เป็น 1 และ 0 อัตโนมัติ (ไม่ใช่ตัวแรก) คือ ASCII
ASCII ย่อมาจาก American Standard Code for Information Interchange ส่วน "American" เล่นบทบาทสำคัญในการทำงานของคอมพิวเตอร์กับข้อมูลสักระยะ เราจะเห็นในส่วนต่อไป
ASCII (1963)
บนพื้นฐาน telegraphic codes อย่าง Morse code และคอมพิวเตอร์ยุคแรก มาตรฐาน encode/decode characters ในคอมพิวเตอร์สร้างขึ้นราว 1963 ระบบง่ายเพราะครอบคลุม 127 characters ตั้งแต่แรก อัลฟาเบตอังกฤษบวก symbols เพิ่ม
ASCII ทำงานโดย associate แต่ละ character กับ decimal number แปลงเป็น binary code ได้ มาดูตัวอย่าง:
"A" คือ 65 ใน ASCII แปลง 65 เป็น binary code
ถ้าไม่รู้วิธี นี่คือวิธีเร็ว: หาร 65 ด้วย 2 ต่อจนได้ 0 ถ้าหารไม่ลงตัว ใส่ 1 เป็น remainder:
65 / 2 = 32 + 1
32 / 2 = 16 + 0
16 / 2 = 8 + 0
8 / 2 = 4 + 0
4 / 2 = 2 + 0
2 / 2 = 1 + 0
1 / 2 = 0 + 1
นำ remainders เรียงกลับ:
1000001ดังนั้น "A" เก็บเป็น "1000001" ด้วย ASCII encoding ต้นฉบับ ตอนนี้ US-ASCII ปัจจุบันคอมพิวเตอร์ 8-bit มันจะเป็น 01000001 (8 bits = 1 byte)
ทำซ้ำทุก character ด้วย 7 bits เก็บได้สูงสุด 2^7 = 127 characters
ตารางเต็ม:
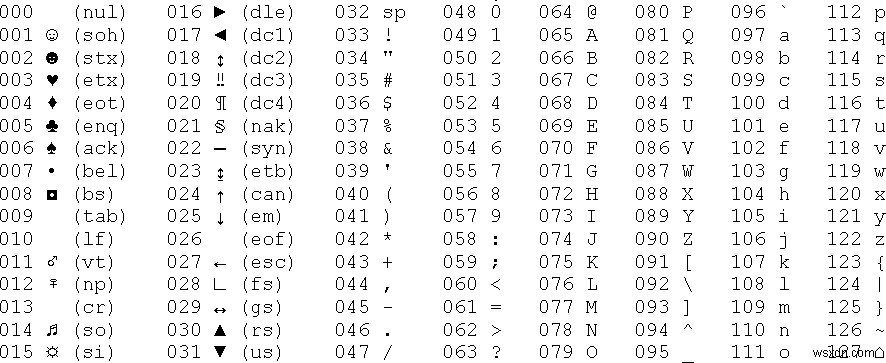 (From https://www.plcdev.com/ascii_chart)
ปัญหาของ ASCII
จะเกิดอะไรถ้าอยากเพิ่ม character อื่น เช่น ç (ฝรั่งเศส) หรือ 大 (ญี่ปุ่น)?
ใช่ จะมีปัญหา
หลัง ASCII คนพยายามแก้โดยสร้าง encoding systems เอง ใช้ bits มากขึ้น แต่ก็ก่อให้เกิดปัญหาอีกอย่าง
ปัญหาหลักคือตอนอ่านไฟล์ ไม่รู้ว่าเป็น encoding system ไหน พยายาม interpret ด้วย encoding ผิด ได้ gibberish อย่าง "" หรือ "Ã,ÂÂÂÂ"
วิวัฒนาการ encoding systems ใหญ่และกว้าง ขึ้นกับภาษา ระบบต่างกัน ภาษาที่มี characters มาก เช่น จีน ต้องพัฒนาระบบซับซ้อนกว่า
หลายปีต่อสู้กับนี้ มาตรฐานใหม่สร้างขึ้น: Unicode มาตรฐานนี้กำหนดวิธีคอมพิวเตอร์สมัยใหม่ encode/decode ข้อมูล
Unicode (1988)
เป้าหมาย Unicode เรียบง่าย ตาม official site: "ให้ unique number สำหรับทุก character ไม่ว่า platform, program, หรือ language"
แต่ละ character ในภาษามี unique code assigned เรียกว่า code point ปัจจุบันมีมากกว่า 137,000 characters
ส่วนหนึ่งของ Unicode standard มีวิธี encode ค่า/code points ต่างๆ แต UTF-8 กว้างที่สุด
คนสร้าง Go programming language, Rob Pike และ Ken Thompson สร้าง UTF-8 ประสบความสำเร็จเพราะ efficient และฉลาดในการ encode ตัวเลขเหล่านี้ มาดูว่าทำไม
UTF-8: Unicode Transformation Format (1993)
UTF-8 คือ de facto encoding สำหรับเว็บไซต์ (94%+ ใช้ encoding นี้) เป็น default encoding สำหรับภาษาโปรแกรมและไฟล์มากมาย ทำไมจึงสำเร็จและทำงานอย่างไร?
UTF-8 เหมือน encoding systems อื่น แปลงตัวเลขที่ Unicode กำหนดเป็น binary เก็บในคอมพิวเตอร์
มี 2 ด้านสำคัญของ UTF-8: - efficient ตอนเก็บ bits เนื่องจาก character ใช้ 1 ถึง 4 bytes - ด้วย Unicode และ dynamic bytes เข้ากันได้กับ ASCII เพราะ 127 characters แรกใช้ 1 byte หมายความว่าคุณเปิด ASCII file เป็น UTF-8 ได้
มาแยกวิเคราะห์ UTF-8 ทำงานอย่างไร
UTF-8 ด้วย 1 byte
ขึ้นกับค่าใน Unicode table UTF-8 ใช้จำนวน characters ต่างกัน
กับ 127 ตัวแรก ใช้ template: 0_______
0 จะอยู่เสมอ ตามด้วย binary number แทนค่าใน Unicode (ซึ่งก็คือ ASCII) เช่น: A = 65 = 1000001
เช็คด้วย Ruby ด้วย unpack method ใน String:
'A'.unpack('B*').first # 01000001B หมายถึง binary format most significant bit first ในบริบทนี้คือ bit ที่มีค่าสูงสุด asterisk บอก Ruby ทำต่อจนไม่มี bits เหลือ ถ้าใช้ตัวเลข จะได้ bits จนถึงตัวเลขนั้น:
'A'.unpack('B4').first # 01000UTF-8 ด้วย 2 bytes
ถ้า character มีค่า/code point ใน Unicode เกิน 127 ถึง 2047 ใช้ 2 bytes template:
110_____ 10______มี 11 empty bits สำหรับค่าใน Unicode ตัวอย่าง:
À คือ 192 ใน Unicode binary คือ 11000000 8 bits ไม่เข้า template แรก ใช้ template ที่ 2:
110_____ 10______เติมจากขวาไปซ้าย:
110___11 10000000empty bits ใส่ 0 ผลลัพธ์: 11000011 10000000
เริ่มเห็น pattern ถ้าอ่านซ้ายไปขวา group 8 bits แรกมี 1 สองตัวนำหน้า หมายถึง character ใช้ 2 bytes:
11000011 10000000 --เช็คด้วย Ruby:
'À'.unpack('B*').first # 1100001110000000Tip: format output ให้อ่านง่าย:
'À'.unpack('B8 B8').join(' ') # 11000011 10000000ได้ array จาก 'À'.unpack('B8 B8') join ด้วย space ได้ string 8s ใน unpack parameter บอก Ruby ให้ 8 bits 2 groups
UTF-8 ด้วย 3 bytes
ถ้าค่า Unicode ไม่เข้า 11 bits ใน template ก่อน ต้อง byte เพิ่ม:
1110____ 10______ 10______สาม 1s นำหน้า template บอกว่า character 3-byte
กระบวนการเดียวกัน แปลง Unicode value เป็น binary เติม slots จากขวาซ้าย เหลือเว้น ใส่ 0s
UTF-8 ด้วย 4 bytes
ค่าบางอย่างใช้มากกว่า 16 empty slots ใน template 3-byte ตัวอย่าง emoji 🙂 ซึ่ง Unicode เห็นเป็น character เหมือน "a" หรือ "大"
"🙂" code point ใน Unicode คือ 128578 binary: 11111011001000010 17 bits ไม่เข้า 3-byte template (16 slots) ต้องใช้ template 4 bytes:
11110___ 10______ 10______ 10______เติม binary อีกครั้ง: 11110___ 10_11111 10011001 10000010
เติม 0s: 11110000 10011111 10011001 10000010
ดูใน Ruby:
รู้ว่า 4 bytes optimize readability:
'🙂'.unpack('B8 B8 B8 B8').join(' ') # 11110000 10011111 10011001 10000010ถ้าไม่รู้ ใช้:
'🙂'.unpack('B*')ใช้ "bytes" string method ดึง bytes เป็น array:
"🙂".bytes # [240, 159, 153, 130]map elements เป็น binary:
"🙂".bytes.map {|e| e.to_s 2} # ["11110000", "10011111", "10011001", "10000010"]อยากได้ string ใช้ join:
"🙂".bytes.map {|e| e.to_s 2}.join(' ') # 11110000 10011111 10011001 10000010UTF-8 มีพื้นที่มากกว่าที่ Unicode ต้องการ
ด้านสำคัญของ UTF-8 คือรองรับ Unicode values (code points) ทั้งหมด — ไม่ใช่แค่ที่มีอยู่ตอนนี้ แต่วันที่จะมีในอนาคตด้วย
เพราะใน UTF-8 ด้วย 4-byte template มี 21 slots เก็บได้สูงสุด 2^21 (= 2,097,152) values มากกว่าที่ Unicode standard จะมีประมาณ 1.1 million
หมายความว่าใช้ UTF-8 ได้ด้วยความมั่นใจว่าไม่ต้องเปลี่ยน encoding system ในอนาคตเพื่อ allocate characters หรือภาษาใหม่
ทำงานกับ encodings ต่างๆ ใน Ruby
ใน Ruby ดู encoding ของ string ทันทีได้:
'Hello'.encoding.name # "UTF-8"encode string ด้วย encoding อื่นได้:
encoded_string = 'hello, how are you?'.encode("ISO-8859-1", "UTF-8")
encoded_string.encoding.name # ISO-8859-1
ถ้า transformation ไม่ compatible error โดย default ลองแปลง "hello 🙂" จาก UTF-8 เป็น ASCII emoji 🙂 ไม่เข้า ASCII:
"hello 🙂".encode("ASCII", "UTF-8")
# Encoding::UndefinedConversionError (U+1F642 from UTF-8 to US-ASCII)
แต่ Ruby อนุญาต exceptions ถ้า character ไม่ encode ได้ แทนที่ด้วย "?":
"hello 🙂".encode("ASCII", "UTF-8", undef: :replace) # hello ?ยังมี option แทนที่ characters บางตัวด้วย valid character ใน encoding ใหม่:
"hello 🙂".encode("ASCII", "UTF-8", fallback: {"🙂" => ":)"}) # hello :)ตรวจสอบ encoding ของ script file ใน Ruby
ดู encoding ของ script file .rb ที่ทำงานอยู่:
__ENCODING__ # แสดง "#<Encoding:UTF-8>" ในกรณีของผมRuby 2.0 ขึ้นไป default encoding สำหรับ scripts คือ UTF-8 แตเปลี่ยนได้ด้วย comment บรรทัดแรก:
# encoding: ASCII
__ENCODING__ # #<Encoding:US-ASCII>
แต่ควรยึด UTF-8 standard เว้นแต่มีเหตุผลแน่ชัด
เคล็ดลับทำงานกับ encodings ใน Ruby
ดู list supported encodings ทั้งหมดด้วย Encoding.name_list จะได้ array ใหญ่:
["ASCII-8BIT", "UTF-8", "US-ASCII", "UTF-16BE", "UTF-16LE", "UTF-32BE", "UTF-32LE", "UTF-16", "UTF-32", "UTF8-MAC"...]ด้านสำคัญอีกอย่าง character ภาษาต่างประเทศ ก่อน Ruby 2.4 methods อย่าง upcase หรือ reverse ไม่ทำงาน ตัวอย่าง Ruby 2.3 upcase ไม่ทำงาน:
# Ruby 2.3
'öıüëâñà'.upcase # 'öıüëâñà'
Workaround ใช้ ActiveSupport จาก Rails หรือ gem ภายนอก แต่ Ruby 2.4 ขึ้นไปมี full Unicode case mapping:
# From Ruby 2.4 and up
'öıüëâñà'.upcase # 'ÖIÜËÂÑÀ'
สนุกกับ emojis
ดู emojis ทำงานใน Unicode และ Ruby อย่างไร:
'🖖'.chars # ["🖖"]นี่คือ "Raised Hand with Part Between Middle and Ring Fingers" หรือ "Vulcan Salute" emoji ถ้า emoji เดียวกันแต skin tone อื่นที่ไม่ใช่ default เกิดอะไรน่าสนใจ:
'🖖🏾'.chars # ["🖖", "🏾"]แทนที่จะเป็น 1 character มี 2 characters สำหรับ emoji เดียว
เกิดอะไรขึ้น?
Characters บางตัวใน Unicode ถูกกำหนดเป็น combination ของ characters หลายตัว ในกรณีนี้ ถ้าคอมพิวเตอร์เห็น 2 characters นี้ร่วมกัน มันแสดงแค่ตัวเดียวกับ skin tone applied
อีกตัวอย่างสนุกกับ flags:
'🇦🇺'.chars # ["🇦", "🇺"]ใน Unicode flag emojis แทนภายในด้วย abstract Unicode characters เรียกว่า "Regional Indicator Symbols" อย่าง 🇦 หรือ 🇿 มักไม่ใช้นอก flags และตอนคอมพิวเตอร์เห็น 2 symbols ร่วมกัน มันแสดง flag ถ้ามี combination นั้น
ลองเอง copy นี้ ลบ comma ใน text editor หรือ field:
🇦,🇺สรุป
หวังว่าการทบทวน Unicode และ UTF-8 ทำงานอย่างไร และเกี่ยวข้องกับ Ruby และ errors ที่อาจเกิดขึ้น มีประโยชน์
บทเรียนสำคัญที่สุด: จำไว้ว่าตอนทำงานกับ text ใดๆ คุณมี encoding system ที่เกี่ยวข้อง และสำคัญที่จะจำไว้ตอนเก็บหรือเปลี่ยน ถ้าได้ ใช้ modern encoding system อย่าง UTF-8 เพื่อไม่ต้องเปลี่ยนในอนาคต
หมายเหตุเกี่ยวกับ Ruby releases
ผมใช้ Ruby 2.6.5 สำหรับตัวอย่างทั้งหมด ลองใน online REPL หรือ local โดยรัน irb ใน terminal ถ้าติดตั้ง Ruby
เนื่องจาก Unicode support ปรับปรุงใน releases ล่าสุด ผมเลือก latest เพื่อบทความนี้ relevant นานขึ้น กรณีไหน Ruby 2.4 ขึ้นไป ตัวอย่างทุกอย่างควรทำงานเหมือนที่แสดง
