

มีสมัยที่ไม่มีอะไรทำให้ผมกลัวมากเท่าคำถาม "Big-O notation สำหรับอันนั้นคืออะไร?" ผมจำได้จากโรงเรียน แต่เพราะเกี่ยวกับคณิตศาสตร์ (วิชาที่ผมไม่เก่ง) ผมบล็อกมันไว้
แต่ว่าจบแล้ว ในช่วงอาชีพก้าวหน้า ผมพบตัวเอง:
-
ดู performance charts
พยายาม debug slow queries
ถูกถามว่าผมเคยคิดไหมว่าโค้ดจะทนได้ไหมถ้า load เพิ่มขึ้น
ตอนตัดสินใจกลับมาเรียนรู้ Big-O (get it? circle back) ผมประหลาดใจที่ความเรียบง่ายระดับสูง ผมแบ่งปันสิ่งที่เรียนรู้ในบทความนี้ เพื่อเพื่อนวิศวกรๆ ไม่แค่สอบผ่านสัมภาษณ์ได้ลีกล้ำ แต่สร้าง performant, scalable systems ด้วย
สัญญาว่า Big-O ไม่ไหวหวาดๆ ตามที่คิด เห็นมันชัดแล้ว คุณจะดู algorithm แล้วแยกประสิทธิภาพได้ง่าย โดยไม่ต้องรัน profiling tool!
Big-O notation คืออะไร?
Big-O notation คือ fancy way ที่พูดว่า "เฮ้ worst-case performance สำหรับ algorithm นี้คืออะไร?" อาจเห็น function described as O(n) หรือ O(1) หมายถึง:
- O(n) - Worst-case run time เพิ่มขึ้น linearly ตาม input size (n) เพิ่ม
- O(1) - Worst-case run time constant สำหรับ input size ใดๆ
...และเพื่อเข้าใจจริง เราต้องเรียนรู้ asymptotes
Asymptotes (เส้นพี้นะเส้น)?
กลับไปสู่อัลจีบระดับมัธยม ตักหนังสือเรียน มาที่ chapters limits และ asymptotes
- Limit analysis: ดูว่าฟังก์ชันเกิดอะไรขึ้นเมื่อเข้าใกล้ค่าบางค่า
- Asymptotic analysis: ดูว่าฟังก์ชันเกิดอะไรเมื่อ f(x) เข้าใกล้ infinity
ตัวอย่าง ฟังก์ชัน f(x) = x^2 + 4x
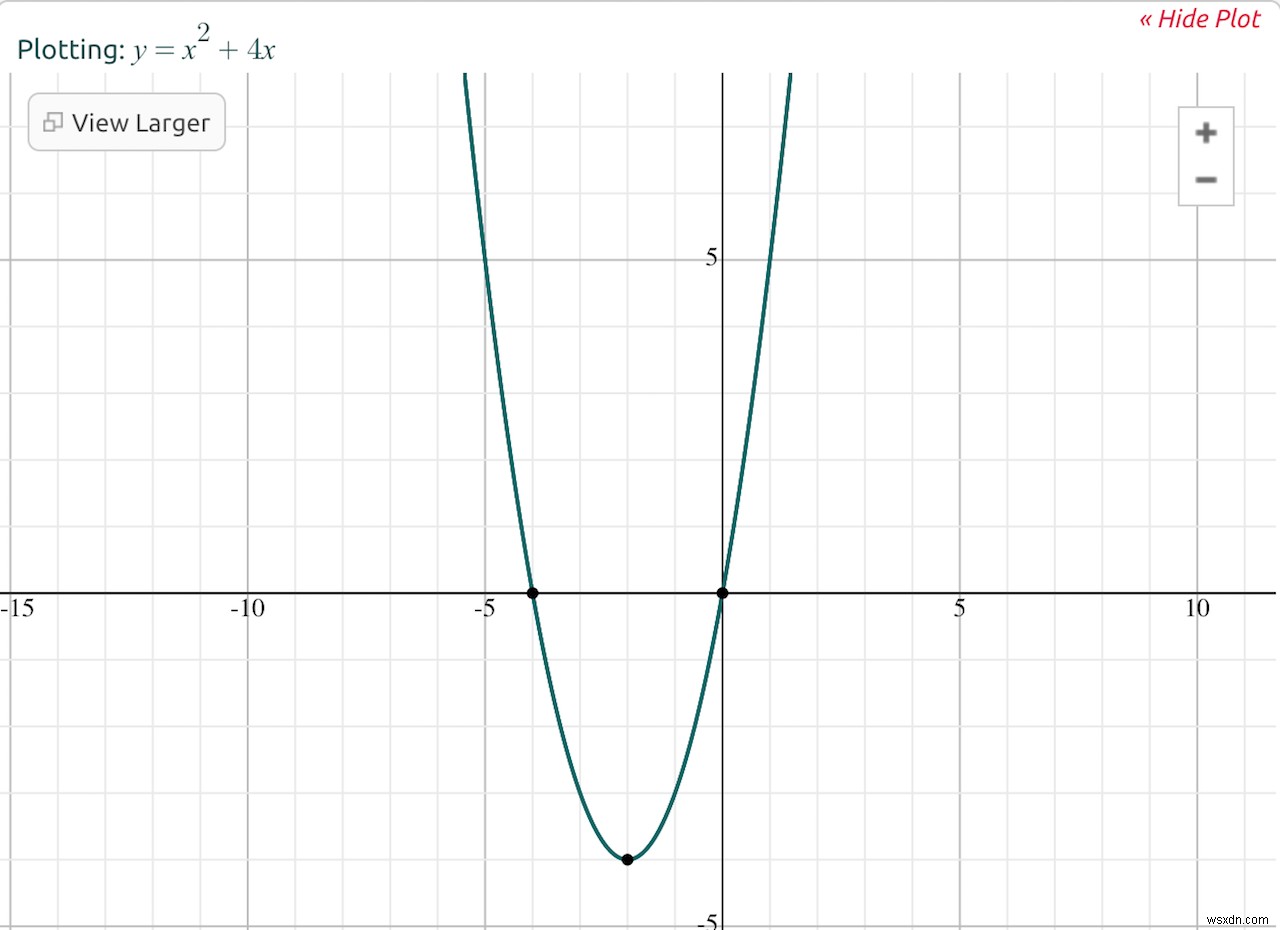
เราสามารถวิเคราะห์ได้: - Limit analysis: เมื่อ x เพิ่ม f(x) เข้าใกล้ infinity limit of f(x) = x^2 + 4x เมื่อ x → infinity คือ infinity - Asymptotic analysis: เมื่อ x ใหญ่มาก 4x term กลายเป็น insignificant เทียบกับ x^2 term ดังนั้น f(x) = x^2 + 4x เกือบเทียบเท่า f(x) = x^2 สำหรับ x → infinity
เพื่อเข้าใจว่าทำไมส่วนของฟังก์ชันกลายเป็น "insignificant" ลองใส่ตัวเลขต่างๆ ในฟังก์ชันเดิม ตอน x = 1 ฟังก์ชันคืน 1 + 4 = 5 แต่ x = 2,000 คืน 4,000,000 + 8,000 = 4,008,000 — x^2 term contribute มากกว่า 4x มาก
Big-O notation เป็นหนึ่งวิธีอธิบายว่า algorithm's run time เปลี่ยนอย่างไรเมื่อ input size เปลี่ยน
อะไรกำหนด run time ของ algorithm?
ถ้าผมถามว่าจะใช้เวลานานแค่ไหนหาเข็มในกองหญ้า คุณคงอยากรู้ว่ามีหญ้ามากแค่ไหน ถ้าผมตอบ "10 ชิ้น" คุณมั่นใจหาได้ใน 1-2 นาที แต่ถ้า "1,000 ชิ้น" คุณคงไม่ค่อย excited
มีข้อมูลอีกชิ้น ต้องการรู้ว่าการเพิ่มหญ้าแต่ละชิ้น ใช้เวลานานขึ้นแค่ไหน และเกิดอะไรเมื่อหญ้าเข้าใกล้ infinity?
นี่คล asymptotic analysis ตัวอย่างก่อน มาดูอีกตัวอย่าง確保ว่าเข้าใจ ฟังก์ชัน f(x) = 5x^2 + 100x + 50 เรา plot สองส่วนแยกกัน:
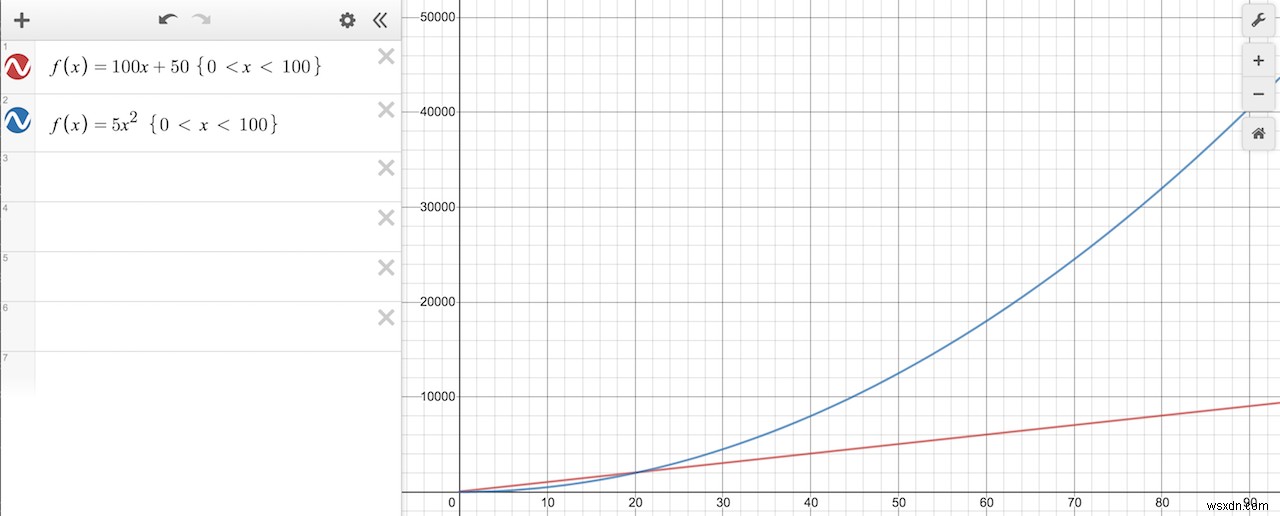
เหมือนตัวอย่างก่อน 5x^2 term กลายใหญ่กว่า 100x + 50 terms ในที่สุด เรา drop พวกมันและบอกว่า runtime ของ f(x) = 5x^2 + 100x + 50 เติบโตเป็น x^2
มี factors อื่นส่งผล per runtime เช่น ความเร็วคอมพิวเตอร์จริง และภาษาที่ใช้
หา Big-O สำหรับ linear search
มาทำ Big-O analysis ของ linear search algorithm Linear search เริ่มต้น dataset ตรงหน้าและ traverse จนเจอ target element
Implementation ใน Ruby:
def find_number_via_linear_search(array, target)
  counter = 0
  # iterate through the given array starting
  # at index 0 and continuing until the end
  while counter < array.length
    if array[counter] == target
      # exit if target element found
      return "linear search took: #{counter} iterations"
    else
      counter += 1
    end
  end
  return "#{target} not found"
end
ลองใช้ method นี้:
# สร้าง array 50 integers
# แล้ว shuffle ให้สนุกขึ้น
array = [*1..50].shuffle
find_number_via_linear_search(array, 24)
รันหลายครั้ง ได้ผล:
=> "linear search took: 10 iterations"
=> "linear search took: 11 iterations"
=> "linear search took: 26 iterations"
เวลา analyze Big-O เรיכפתแค่ worst-case scenario (upper asymptotic bound)
คิด intuitive smallest iterations คือ 1 เกิดตอน target อยู่ index 0 largest iterations (worst-case) คือ 50 เกิดตอน target ไม่อยู่ใน array
ถ้า array 100 elements worst-case 100 iterations 200 elements? 200 iterations ดังนั้น Big-O สำหรับ linear search คือ O(n) โดย n คือจำนวน elements
ตัวอย่างซับซ้อนกว่า: binary search!
มาพิจารณา binary search วิธี binary search pre-sorted array:
1. หา middle element
2. ถ้า element == target จบ
3. ถ้า element > target ทิ้งคราบนصفบน
4. ถ้า element < target ทิ้งคราบนصفล่าง
5. เริ่มใหม่ step 1 กับ array ที่เหลือ
Note: ถ้าคุณ Rubyist มี built-in b-search method implement algorithm นี้ให้แล้ว!
ตัวอย่าง มี dictionary อยากหา "pineapple" ไปหน้ากลาง ถ้ามี "pineapple" จบ! แต่กลาง dictionary อาจไม่ใช่ "p" หาเจอ "llama" "L" มาก่อน "P" ทิ้งคราบนصفล่างทั้งหมด ทำซ้ำกับที่เหลือ
เหมือน linear search best-case runtime คือ 1 iteration แต่ worst case คืออะไร? ตัวอย่าง array 16 elements หาเลข 23:
[2, 3, 15, 18, 22, 23, 24, 50, 65, 66, 88, 90, 92, 95, 100, 200]Step 1 มอง index 7 = 50 50 > 23 ทิ้งขวา Array กลายเป็น:
[2, 3, 15, 18, 22, 23, 24, 50]Middle element ตอนนี้ 18 < 23 ทิ้งซ้าย:
[22, 23, 24, 50]กลายเป็น
[22, 23]สุดท้าย
[23]รวม divide array ครึ่ง 4 ครั้ง เพื่อหาเลขเป้าหมายใน array length 16
Generalize ได้ว่า worst case สำหรับ binary search = จำนวนครั้งสูงสุดที่ divide array ครึ่งได้
ในคณิตศาสตร์ ใช้ logarithms ตอบ "คูณเลขนี้กี่ครั้งได้เลขนั้น?" นี่คือการนำไปใช้:
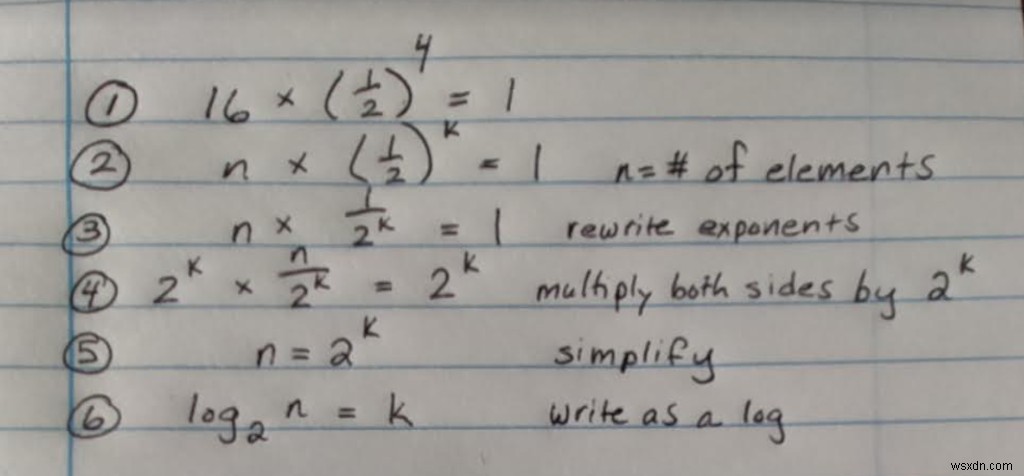
เราบอกได้ว่า Big-O หรือ worst-case run time สำหรับ binary search คือ log(base 2) n
สรุป
Big-O notation คือ fancy way พูดว่า "เฮ้ worst case สำหรับอันนี้คืออะไร?" ตัวอย่างจริง ถ้าถามช่างประปาว่าซ่อมก๊อกน้ำราคาเท่าไหร่ อาจตอบ "รับประกันไม่เกิน $2,000" นี่คือ upper bound แม้ไม่ช่วยมาก
เพราะนี้ Big-O notations อื่นๆ ถูกใช้ เช่น Big-Theta ใส่ใจ lower bound และ upper bound ช่างประปาจะตอบ "ไม่น้อยกว่า $1,000 แต่น้อยกว่า $2,000" useful มากกว่า
ขอบคุณที่อ่าน และหวังว่าบทความนี้ช่วยทำให้ Big-O notation ไม่น่ากลัวเหมือนเดิม!
