

ต้นปีนี้เราย้ายจาก Dedicated Server Hosting Facility ไป AWS และเรายินดีมากที่ทำเช่นนั้น เรามี Automation มากมาย ซึ่งช่วยให้เราใช้เวลาน้อยลงกับการจัดการเซิร์ฟเวอร์ บทความนี้อธิบายสิ่งที่เกิดขึ้นใน Infrastructure ของเราเมื่อมีการเปลี่ยนแปลงปริมาณ Error Notifications ที่เรากำลังประมวลผล
เรา Scale ยังไง?
Processing Pipeline ของเราพึ่งพา Sidekiq มาก ซึ่งทำงานได้มั่นคงมาก ส่วนใหญ่ของงานใน Pipeline ถูกจัดการโดย Instances ที่อยู่ใน Autoscaling Group เมื่อ Sidekiq Backlog เพิ่มขึ้น CloudWatch Alarm จะ Trigger ให้เริ่ม Instance ใหม่ใน Group นี้ เมื่อ Traffic ลดลงและ Backlog หายไป Instances จะถูก Terminate
เรา Scale ด้วยสไตล์
จุดอ่อนเดียวของ Setup นี้คือเราต้องการให้แน่ใจว่า Sidekiq Workers ทำงานเสร็จสิ้นก่อนที่ Instance จะถูก Terminate แม้ Sidekiq จะรองรับการ Reschedule Jobs ที่ถูก Terminate ก่อนเสร็จ แต่เราชอบหลีกเลี่ยงมันถ้าทำได้ — ดีกว่าใช้เวลาอีกไม่กี่วินาทีเพื่อเสร็จ Job แทนที่จะให้ Rescheduled และ Restarted โชคดีที่ Sidekiq มีเมธอดบอก Worker Processes ให้หยุดรับงานใหม่หลังจาก Job ปัจจุบันเสร็จ ทำให้ง่ายต่อการ Drain Workers เตรียมพร้อม Termination ทริคคือการให้ Workers รู้ว่าต้องเริ่ม Drain — และเราใช้การผสมผสานของ Lifecycle Hooks, CloudWatch Events + Lambda, EC2 Simple Systems Manager (SSM) และโค้ดเล็กน้อย
ส่วนที่เหลือของบทความจะแสดงวิธี Copy Setup ของเรา เพื่อให้ได้ Instances ที่ "ไปอย่างสงบสุข" (Go gently into that good night)
ข้อกำหนดเบื้องต้น
โดยธรรมชาติ คุณต้องมี Autoscaling Group ที่มี Scaling Policy ที่ Terminate Instances ตามกฎที่คุณกำหนด นอกจากนี้ คุณต้องมี Instances ที่ตั้งค่ารัน SSM Agent และรันใน Role ที่มี SSM Access Instances เหล่านี้ยังต้องมี Permissions เรียก Autoscaling API นี่คือ Policy Document สำหรับ Instance Role:
โค้ด
เมื่อรายการเหล่านี้พร้อมแล้ว คุณสามารถเริ่มเชื่อมชิ้นส่วนต่างๆ ได้ เราจะเริ่มจากท้ายกระบวนการ — Scripts ที่จะอยู่บน Instance และจัดการ Sidekiq Draining — และย้อนกลับมาก่อนหน้า ก่อนอื่น โค้ด Ruby ที่จะ Quiet Workers และรอให้เสร็จงาน:
เราได้รายการ Sidekiq Processes ที่รันบน Instance ปัจจุบันผ่าน Sidekiq API บอกพวกมันหยุดรับงานใหม่ แล้วรอจนกว่า Processes ทั้งหมดจะไม่มี Active Jobs
นี่คือ Shell Script ที่จะ Trigger Script นั้นเมื่อถึงเวลา Terminate Instance:
มี Setup มาก แต่เนื้อหาสำคัญเริ่มบรรทัด 8 ก่อนเราส่งสัญญาณให้ Autoscaling Group ว่ากำลังทำงานบน Lifecycle Hook นี่มี Side-effect เป็น Guard — ถ้า Instance นี้ไม่ได้ถูก Scheduled สำหรับ Termination โดย Autoscaling Group คำสั่งนี้จะ Fail และ Worker Shutdown Script จะไม่ถูก Invoke Script นี้ไม่ควรถูกเรียกหาก Instance ไม่ได้ถูก Scheduled Terminate แต่การป้องกันเพิ่มเติมไม่ได้ทำอะไรเสีย :) สมมติเราไปต่อ เรา Shutdown Workers แล้วบอก Autoscaling Group ให้ดำเนินการ Terminate ต่อไป ถ้าเราไม่ทำ API Call นี้ Instance จะคงรันจนกว่า Hook Timeout จะหมดอายุ (เราจะพูดถึงในไม่ช้า)
SSM Document
ตอนนี้เราต้องการสิ่งที่จะ Trigger Shell Script นี้ นี่คือที่มาของ SSM Agent มันรันใน Background รอ Document ผ่าน SendCommand เพื่อบอกว่าต้องทำอะไร Document ของเราสั่งให้ Agent รัน Termination Script:
คุณสามารถสร้าง Document ได้โดยคลิกลิงก์ Documents ในส่วน Systems Manager Shared Resources ของ EC2 Console (ใกล้ด้านล่าง Sidebar) คลิกปุ่ม Create Document และวาง JSON นั้นลงใน Content Box
Lambda Function
เมื่อ Document พร้อมแล้ว สร้าง Lambda Function ที่จะรันมันบน Target Instance เมื่อถึงเวลา Terminate Instance นี่คือโค้ดสำหรับนั้น:
คุณต้องแทนที่ PrepInstanceForTermination ด้วยชื่อที่คุณเลือกให้ Document แต่ไม่นั้น โค้ดนี้ Copy-paste ได้เลย
Lambda Function นี้ต้องการ Permissions สองอัน (นอกจาก Lambda Permissions ปกติ) นี่คือ IAM Policy Document สำหรับนั้น:
อีกครั้ง คุณอาจต้องแทนที่ชื่อ Document
Hook และ Event Rule
อดทนซักพัก — เราเกือบเสร็จ! เหลือสองอย่างต้องทำ: สร้าง CloudWatch Event และ Lifecycle Hook ก่อน Event:
ใน CloudWatch Management Console คลิก Events ใน Sidebar แล้วคลิกปุ่ม Create rule นี่คือสิ่งที่จะ Trigger Lambda Function ที่คุณเพิ่งสร้าง
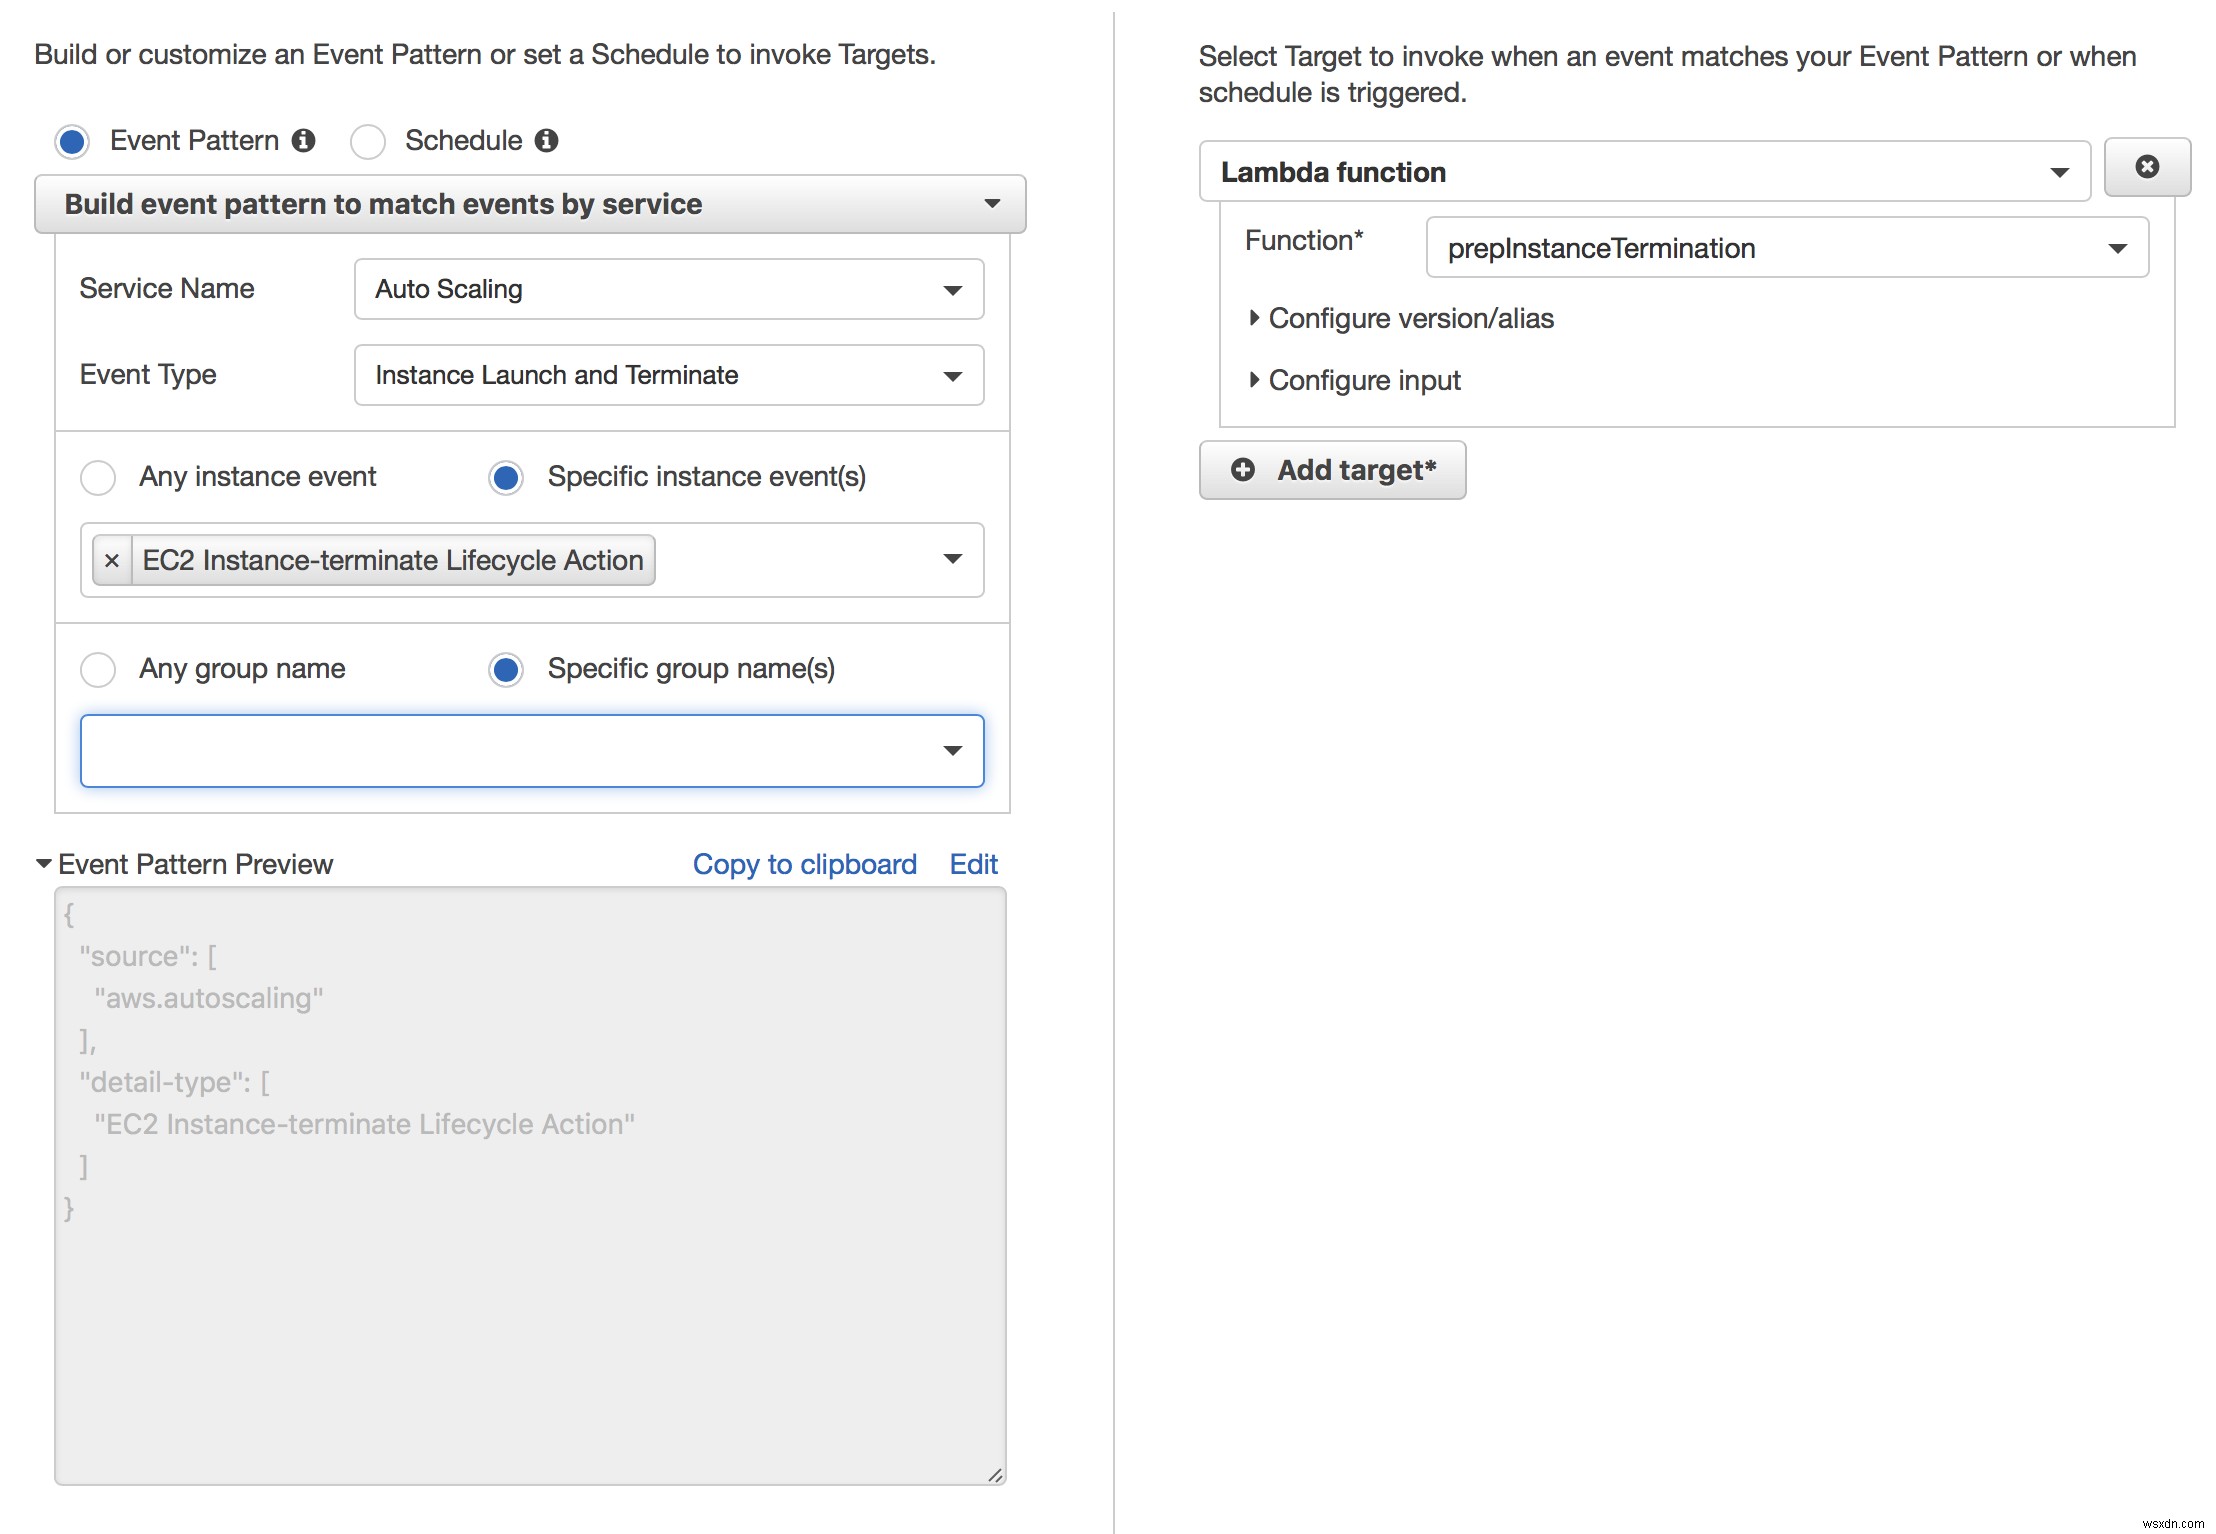
ด้านซ้ายคุณเลือก Event ที่ต้องการ Watch และลักษณะเพิ่มเติมของ Event (เช่น จำกัด Autoscaling Groups ไหนที่จะ Trigger Eventนี้) ด้านขวาคุณเลือก Target ของ Rule — ในกรณีของเราคือ Lambda Function ที่สร้างไว้ก่อนหน้า คุณไม่ต้องเปลี่ยน Defaults สำหรับ Lambda Function Target
เมื่อเสร็จแล้ว กลับไปที่ EC2 Management Console ไปที่ Autoscaling Group ที่มี Instances ที่คุณต้องการจัดการ หลังคลิกแท็บ Lifecycle Hooks คุณจะสามารถสร้าง Hook ได้ ของเราเป็นแบบนี้:
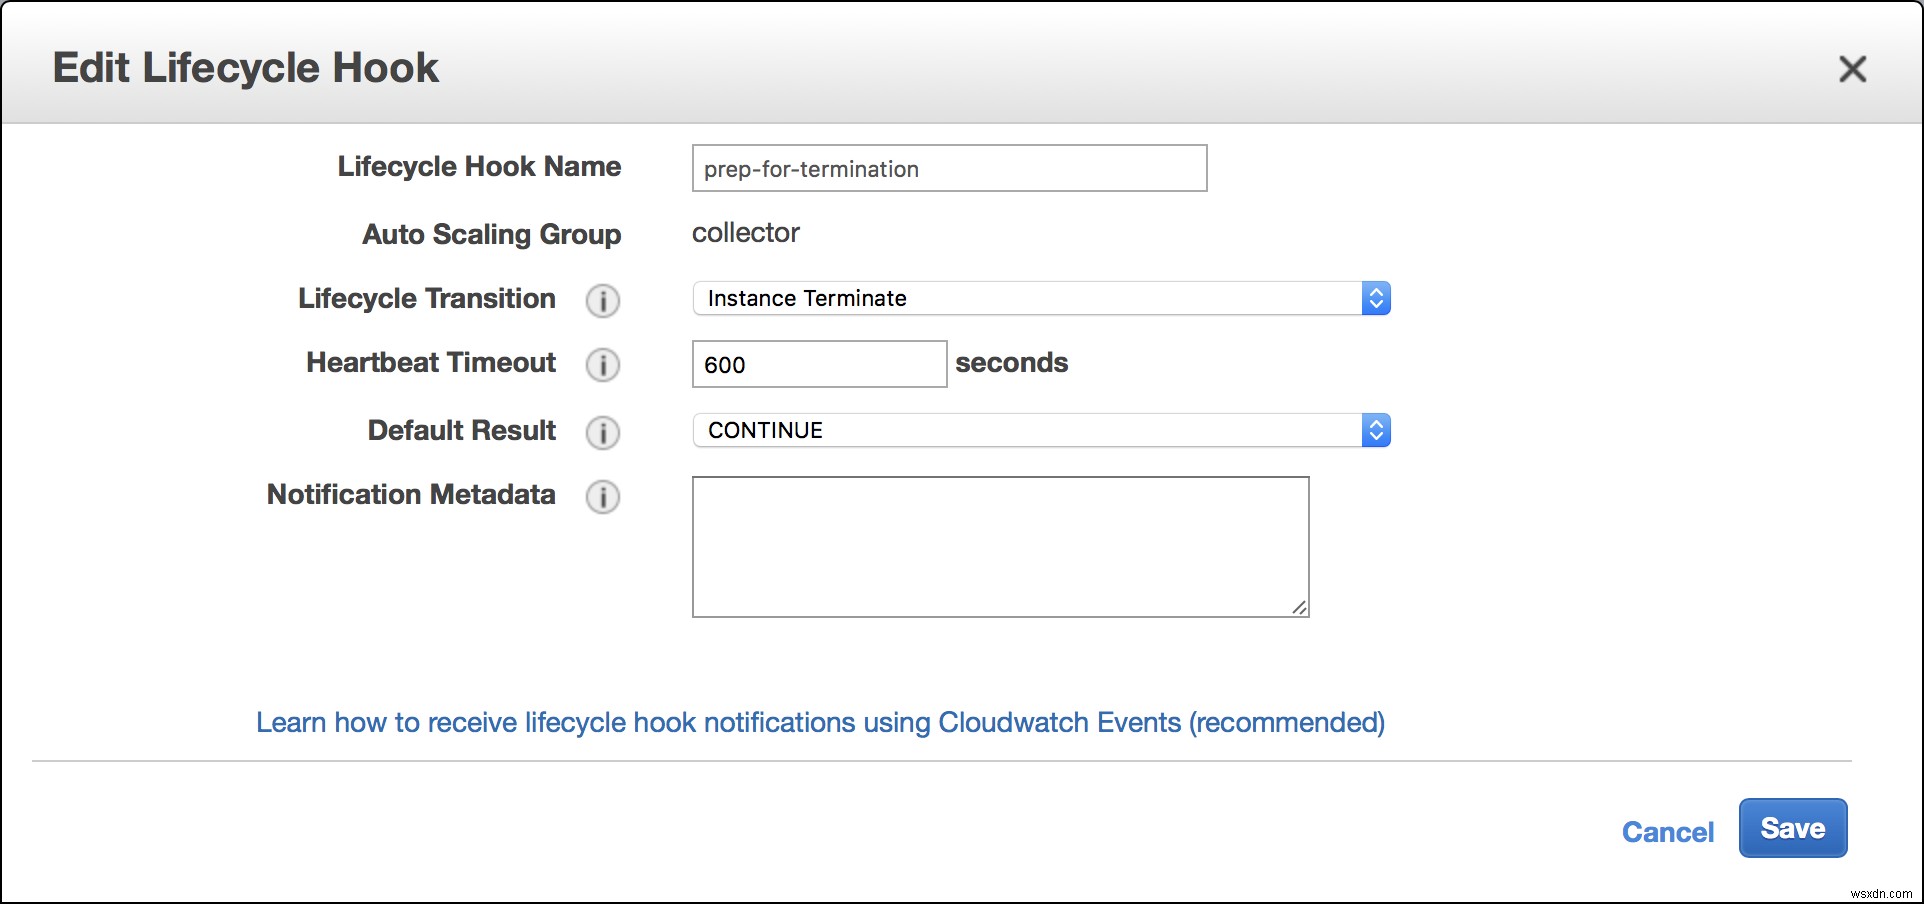
Terminate คือ Transition ที่เราสนใจ และเราอยากให้ Termination ดำเนินต่อไป (Default Result: CONTINUE) ถ้ากลางทาง API Call ไม่เกิดขึ้นใน Shell Script หลังจาก 600 วินาที (Heartbeat Timeout) นี่จะทำให้ Instances ของเราถูก Terminate ทางหนึ่งทางหนึ่ง แม้ Sidekiq Workers จะยังไม่เสร็จ หลังจาก 10 นาที
จบแล้ว
คุณทำได้! ตอนนี้คุณมี Autoscaling Group ที่สามารถ Terminate Sidekiq Instances ได้อย่างมนุษยธรรม Enjoy!
P.S.: Credit ไปที่ awslabs สำหรับ Tutorial ที่ช่วยมากในการรวมชิ้นส่วนบางส่วนเข้าด้วยกัน
