

ซอร์สโค้ดเต็มบน GitHub
การใช้งานภาษาโปรแกรมมิ่ง Stoffle แบบสมบูรณ์พร้อมใช้งานได้ที่ GitHub การใช้งานอ้างอิงนี้มีคอมเมนต์มากมายเพื่อช่วยให้อ่านโค้ดง่ายขึ้น โปรดเปิด Issue หากพบบั๊กหรือมีคำถาม
ในบทความบล็อกนี้ เราจะมาสร้าง Parser สำหรับ Stoffle ซึ่งเป็นภาษาโปรแกรมมิ่งเล็กๆ ที่สร้างขึ้นทั้งหมดด้วย Ruby คุณสามารถอ่านเพิ่มเติมเกี่ยวกับโปรเจกต์นี้ได้ในส่วนแรกของชุดบทความนี้
การสร้าง Parser จากศูนย์ทำให้ผมได้ข้อมูลเชิงลึกและความรู้ที่ไม่คาดคิด ผมคิดว่าประสบการณ์นี้อาจแตกต่างไปในแต่ละบุคคล แต่ผมเชื่อว่าหลังจากอ่านบทความนี้ คุณจะได้รับหรือลึกซึ้งความรู้อย่างน้อยหนึ่งในหัวข้อต่อไปนี้:
- คุณจะเริ่มมองโค้ดต้นฉบับ (source code) แบบต่างออกไป และสังเกตโครงสร้างแบบ ต้นไม้ (tree-like structure) ที่แฝงอยู่ได้ง่ายขึ้นมาก;
- คุณจะเข้าใจ Syntactic Sugar (รูปแบบสะดวกในการเขียนโค้ด) อย่างลึกซึ้ง และจะเริ่มเห็นมันทุกที่ ไม่ว่าจะเป็นใน Stoffle, Ruby หรือแม้แต่ภาษาโปรแกรมมิ่งอื่นๆ
ผมรู้สึกว่า Parser เป็นตัวอย่างที่สมบูรณ์แบบของหลักการ Pareto (กฎ 80/20) ปริมาณงานที่ต้องใช้เพื่อสร้างฟีเจอร์เสริมที่น่าสนใจ เช่น ข้อความแสดงข้อผิดพลาดที่น่าทึ่ง ชัดเจนว่าเยอะกว่าและไม่สัมพันธ์กับความพยายามที่ใช้เพื่อให้ส่วนพื้นฐานทำงานได้ เราจะเน้นที่ส่วนสำคัญและทิ้งการปรับปรุงเป็นการท้าทายให้คุณอ่านทุกท่าน เราอาจจะจัดการกับส่วนเสริมที่น่าสนใจบางส่วนในบทความต่อไปของชุดนี้ก็ได้
Syntactic Sugar (รูปแบบสะดวกในการเขียนโค้ด)
Syntactic Sugar เป็นคำที่ใช้เรียกโครงสร้างที่ทำให้ภาษาใช้งานง่ายขึ้น แต่มันไม่ทำให้ภาษานั้นสูญเสียฟังก์ชันการทำงานหากถูกลบออก ตัวอย่างที่ดีคือคำสั่ง
elsifของ Ruby ใน Stoffle เราไม่มีโครงสร้างแบบนี้ ดังนั้นเพื่อแสดงความหมายเดียวกัน เราจึงต้องเขียนแบบยาวๆ (verbose) มากขึ้น:if some_condition # ... else # oops, ไม่มี elsif ให้ใช้ if another_condition # ... end end
Parser คืออะไร?
เราเริ่มต้นจากโค้ดต้นฉบับ ซึ่งเป็นลำดับของตัวอักษรดิบ (raw sequence of characters) ตามที่แสดงในบทความก่อนหน้าของชุดนี้ Lexer จะจัดกลุ่มตัวอักษรเหล่านี้เป็นโครงสร้างข้อมูลที่มีความหมายเรียกว่า Tokens อย่างไรก็ตาม เรายังคงมีข้อมูลที่แบนแบน (flat) อยู่ ซึ่งยังไม่ได้แสดงลักษณะซ้อนกัน (nested nature) ของโค้ดต้นฉบับอย่างเหมาะสม ดังนั้นหน้าที่ของ Parser คือการสร้างต้นไม้ (tree) จากลำดับตัวอักษรนี้ เมื่อเสร็จสิ้น เราจะได้ข้อมูลที่สามารถแสดงได้ว่าแต่ละส่วนของโปรแกรมซ้อนและเชื่อมโยงกันอย่างไร
ต้นไม้ที่ Parser สร้างขึ้น เรียกทั่วไปว่า Abstract Syntax Tree (AST) ตามที่ชื่อบ่งชี้ เราจัดการกับโครงสร้างข้อมูลแบบต้นไม้ โดยราก (root) แทนโปรแกรมทั้งหมด และลูก (children) ของโหนดโปรแกรมนี้คือ Expression ต่างๆ ที่ประกอบเป็นโปรแกรมของเรา คำว่า Abstract ใน AST หมายถึงความสามารถในการ abstract away (ซ่อน/ข้าม) ส่วนที่ในขั้นตอนก่อนหน้านี้มีอยู่จริง ตัวอย่างที่ดีคือ Expression Terminators (ขึ้นบรรทัดใหม่ในกรณีของ Stoffle) พวกมันถูกพิจารณาเมื่อสร้าง AST แต่เราไม่จำเป็นต้องมีโหนดเฉพาะเพื่อแทน Terminator อย่างไรก็ตาม จำไว้ว่าเรามี Token แบบชัดเจน (explicit token) สำหรับแทน Terminator อยู่แล้ว
การมีภาพแสดงตัวอย่าง AST จะมีประโยชน์ไหม? ปรารถนาของคุณคือคำสั่งของผม! ด้านล่างคือโปรแกรม Stoffle เรียบง่าย ซึ่งเราจะ Parse แบบขั้นตอนต่อขั้นตอนภายหลังในโพสต์นี้ และ AST ที่สอดคล้องกัน:
fn double: num num * 2 end 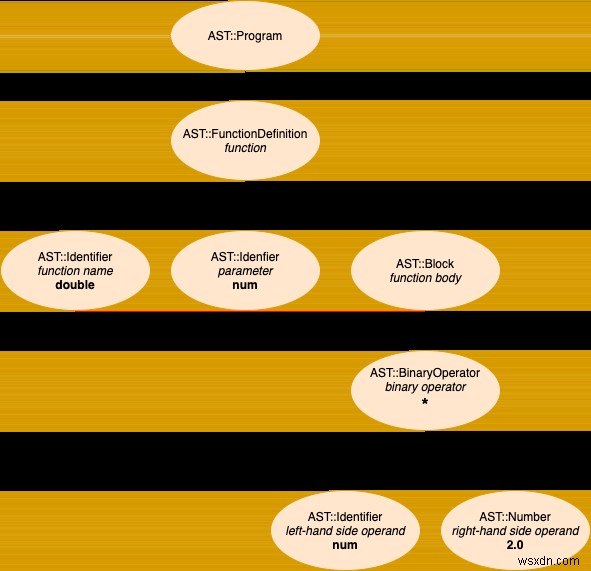
จาก Source ไปสู่ AST: ตัวอย่างแรก
ในส่วนนี้ เราจะสำรวจทีละขั้นตอนว่า Parser ของเราจัดการกับโปรแกรม Stoffle ที่ เรียบง่ายมาก ซึ่งประกอบด้วยบรรทัดเดียวที่แสดง Variable Binding (คือการกำหนดค่าให้ตัวแปร) นี่คือ Source, การแทน Tokens แบบง่ายๆ ที่ Lexer สร้างขึ้น (Tokens เหล่านี้คือ Input ที่ Parser รับ) และสุดท้ายคือภาพแสดง AST ที่เราจะสร้างขึ้นเพื่อแทนโปรแกรม:
Source
my_var = 1 Tokens (Output ของ Lexer, Input สำหรับ Parser)
[:identifier, :'=', :number] ภาพแสดง Output ของ Parser (Abstract Syntax Tree)
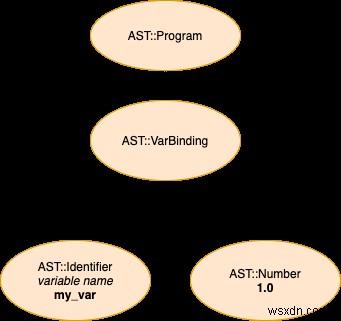
ซึ่งคุณนึกออกแล้ว ส่วนหลัก (core) ของ Parser ของเราคล้ายกับ Core ของ Lexer มาก ในกรณีของ Lexer เรามีชุดตัวอักษรให้ประมวลผล ตอนนี้เรายังต้องวนลูป (iterate) ผ่าน Collection แต่ในกรณีของ Parser เราจะวนผ่าน List ของ Tokens ที่ Lexer สร้างขึ้น เรามี Pointer เดียว (@next_p) เพื่อติดตามตำแหน่งใน Collection ของ Tokens Pointer นี้บอกถึง Token ถัดไป ที่จะถูกประมวลผล แม้เราจะมี Pointer เดียว แต่เรามี "Virtual Pointers" อื่นๆ อีกมากมายที่ใช้ได้ตามต้องการ จะปรากฏขึ้นเมื่อเราไปต่อ ตัวอย่างหนึ่งคือ current (โดยพื้นฐานคือ Token ที่ @next_p - 1)
#parse คือเมธอดที่เรียกเพื่อให้ Tokens ถูกแปลงเป็น AST ซึ่งจะพร้อมใช้งานที่ Instance Variable @ast การใช้งาน #parse นั้นตรงไปตรงมา เราดำเนินการต่อผ่าน Collection โดยเรียก #consume และเลื่อน @next_p จนกว่าจะไม่มี Tokens เหลือให้ประมวลผล (คือ while next_p < tokens.length) #parse_expr_recursively อาจคืนค่า AST Node หรือไม่คืนค่าก็ได้ จำไว้ว่าเราไม่ต้องแทน Terminators ใน AST เช่น ตัวอย่าง ถ้า Node ถูกสร้างในรอบลูปปัจจุบัน เราจะเพิ่มเข้า @ast ก่อนต่อไป สำคัญที่ต้องจำว่า #parse_expr_recursively ก็ยังเลื่อน @next_p อยู่เหมือนกัน เนื่องจากเมื่อเจอ Token ที่บ่งชี้ต้นทางของ Construct เฉพาะเจาะจง เราต้องก้าวไปหลายครั้งจนกว่าจะสร้าง Node ที่แทนสิ่งที่กำลัง Parse อยู่ได้ครบถ้วน ลองนึกภาพดูว่าต้อง Consume Tokens กี่ตัวเพื่อสร้าง Node แทน if
module Stoffle class Parser attr_accessor :tokens, :ast, :errors # ... def initialize(tokens) @tokens = tokens @ast = AST::Program.new @next_p = 0 @errors = [] end def parse while pending_tokens? consume node = parse_expr_recursively ast << node if node != nil end # ... end end ในสนิปเป็ตด้านบน เป็นครั้งแรกที่เราได้เห็นหนึ่งในประเภท AST Node หลายประเภทที่เป็นส่วนหนึ่งของ Parser Implementation เรามี Source Code เต็มสำหรับ Node Type AST::Program ด้านล่าง ซึ่งคุณคาดเดาได้ นี่คือ Root ของต้นไม้ของเรา แทนโปรแกรมทั้งหมด มาดูรายละเอียดที่น่าสนใจของมัน:
- โปรแกรม Stoffle ประกอบด้วย
@expressions; นี่คือ#childrenของ NodeAST::Program; - เหมือนที่คุณจะเห็นอีก ทุก Node Type implement เมธอด
#==ดังนั้น จึงเปรียบเทียบ Node เรียบง่ายสองตัว หรือแม้แต่โปรแกรมทั้งสองโปรแกรมได้ง่าย! เมื่อเปรียบเทียบสองโปรแกรม (หรือ Node 複雜สองตัว) ความเท่าเทียมจะถูกกำหนดโดยความเท่าเทียมของทุก Children, ความเท่าเทียมของทุก Children ของทุก Children, และต่อไป กลยุทธ์ที่เรียบง่ายแแรงของ#==นี้มีประโยชน์มากสำหรับการทดสอบ Implementation ของเรา
class Stoffle::AST::Program attr_accessor :expressions def initialize @expressions = [] end def <<(expr) expressions << expr end def ==(other) expressions == other&.expressions end def children expressions end end Expressions vs. Statements
ในบางภาษา หลาย Constructs ไม่สร้างค่า (produce a value) เช่น Conditional เป็นตัวอย่างคลาสสิก เรียกว่า Statements Constructs อื่นๆ แล้ว Evaluate เป็นค่าได้ (เช่น Function Call) เรียกว่า Expressions ในภาษาอื่นๆ ทุกอย่างเป็น Expression และสร้างค่า Ruby เป็นตัวอย่างของแนวทางนี้ ลองพิมพ์สนิปเป็ตนี้ใน IRB เพื่อดูว่า Method Definition Evaluate เป็นค่าอะไร:
irb(main):001:0> def two; 2; endถ้าคุณไม่สะดวกเปิด IRB ผมบอกให้: ใน Ruby Method Definition Expression Evaluate เป็น Symbol (ชื่อเมธอด) เนื่องจาก Stoffle ได้แรงบันดาลใจมาจาก Ruby มาก ดังนั้นในภาษาเล็กของเรา ทุกอย่างก็เป็น Expression เช่นกัน
จำไว้ว่านิยามเหล่านี้เพียงพอสำหรับการใช้งานจริง แต่ไม่มี Consensus จริงๆ และคุณอาจเห็นคำว่า Statement และ Expression ถูกนิยามต่างกันที่อื่น
เจาะลึก: เริ่มต้น Implementation ของ #parse_expr_recursively
เหมือนที่เราเห็นในสนิปเป็ตก่อนหน้า #parse_expr_recursively คือเมธอดที่เรียกเพื่อสร้าง AST Node ใหม่ได้ #parse_expr_recursively ใช้เมธอดย่อยอีกมากมายในกระบวนการ Parse แต่เราบอกได้สบายใจว่าเป็น "เครื่องยนต์จริง" ของ Parser เรา แม้จะไม่ยาวนัก แต่มันยากต่อการย่อยนึก ดังนั้นเราจะแยกเป็นสองส่วน ในส่วนนี้ มาเริ่มจากส่วนแรกซึ่งมีพลังพอที่จะ Parse ส่วนง่ายๆ ของภาษา Stoffle บริบทย้อนกลับ: จำได้ว่าเรากำลังผ่านขั้นตอน Parse โปรแกรมง่ายๆ ที่ประกอบด้วย Variable Binding Expression เดียว:
Source
my_var = 1 Tokens (Output ของ Lexer, Input สำหรับ Parser)
[:identifier, :'=', :number] หลังจากดู Tokens ที่เราต้องจัดการ และนึกภาพ Lexer Output สำหรับ Expressions เรียบง่ายอื่นๆ ดูเหมือนว่าไอเดียดีคือลองเชื่อม Token Types กับ Parsing Methods เฉพาะเจาะจง:
def parse_expr_recursively parsing_function = determine_parsing_function if parsing_function.nil? unrecognized_token_error return end send(parsing_function) end ใน Implementation เริ่มต้นของ #parse_expr_recursively เราทำตรงนี้พอดี เนื่องจากจะมี Token Types หลายแบบที่ต้องจัดการ การแยกกระบวนการตัดสินใจไปเป็นเมธอดแยก - #determine_parsing_function - จึงดีกว่า ซึ่งเราจะได้เห็นในทันที
เมื่อเสร็จสิ้น ไม่ควรมี Tokens ที่ไม่รู้จัก แต่เพื่อกันพลาด เราจะเช็คว่า Parsing Function ผูกกับ Current Token หรือไม่ ถ้าไม่ได้ เราจะเพิ่ม Error เข้า Instance Variable @errors ซึ่งเก็บ Issues ทั้งหมดระหว่าง Parsing เราจะไม่รายละเอียดที่นี่ แต่ดู Implementation เต็มได้ที่ GitHub หากสนใจ
#determine_parsing_function คืนค่า Symbol แทนชื่อ Parsing Method ที่จะเรียก เราจะใช้ send ของ Ruby เพื่อเรียกเมธอดที่เหมาะสมแบบไดนามิก
การกำหนด Parsing Method และการ Parse Variable Binding
ต่อไป มาดู #determine_parsing_function เพื่อเข้าใจกลไกเริ่มต้นสำหรับเรียกเมธอดเฉพาะเพื่อ Parse Constructs ต่างๆ ของ Stoffle #determine_parsing_function จะใช้สำหรับทุกอย่าง (Keywords, Unary Operators) ยกเว้น Binary Operators เราจะสำรวจเทคนิคสำหรับ Binary Operators ภายหลัง ตอนนี้มาดู #determine_parsing_function:
def determine_parsing_function if [:return, :identifier, :number, :string, :true, :false, :nil, :fn, :if, :while].include?(current.type) "parse_#{current.type}".to_sym elsif current.type == :'(' :parse_grouped_expr elsif [:"\n", :eof].include?(current.type) :parse_terminator elsif UNARY_OPERATORS.include?(current.type) :parse_unary_operator end end เหมือนที่อธิบายไป #current เป็น Virtual Pointer ไปยัง Token ที่กำลังประมวลผลอยู่ Implementation ของ #determine_parsing_function ตรงไปตรงมา เราดู Current Token (โดยเฉพาะ Type) และคืนค่า Symbol แทนเมธอดที่เหมาะสม
จำได้ว่าเรากำลัง Parse Variable Binding (my_var = 1) ดังนั้น Token Types ที่จัดการคือ [:identifier, :'=', :number] Current Token Type คือ :identifier ดังนั้น #determine_parsing_function จะคืน :parse_identifier ตามที่คุณคาดเดา มาดูขั้นตอนต่อไป เมธอด #parse_identifier:
def parse_identifier lookahead.type == :'=' ? parse_var_binding : AST::Identifier.new(current.lexeme) end นี่คือการแสดงออกง่ายๆ ของสิ่งที่ Parsing Methods อื่นๆ ทั้งหมดทำ ใน #parse_identifier - และเมธอด Parse อื่นๆ - เราเช็ค Tokens เพื่อตัดสินใจว่าโครงสร้างที่คาดหวังมีอยู่จริงหรือไม่ เรารู้ว่ามี Identifier แต่ต้องดู Token ถัดไปว่าเป็น Variable Binding (ถ้า Token ถัดไป Type เป็น :'=') หรือแค่ Identifier ตัวเดียว หรือเข้าร่วม Expression ซับซ้อนกว่า เช่น Arithmetic Expression ที่จัดการค่าที่เก็บใน Variables
เนื่องจากเรามี :'=' ถัดไป #parse_var_binding จะถูกเรียก:
def parse_var_binding identifier = AST::Identifier.new(current.lexeme) consume(2) AST::VarBinding.new(identifier, parse_expr_recursively) end ที่นี่ เราสร้าง AST Node ใหม่แทน Identifier ที่กำลังประมวลผล Constructor ของ AST::Identifier คาดหวัง Lexeme ของ Identifier Token (คือลำดับตัวอักษร สตริง "my_var" ในกรณีนี้) เราจึงส่งมันไป ต่อมาเราเลื่อนสองตำแหน่งใน Stream ของ Tokens ทำให้ Token Type :number กลายเป็น Token ถัดไปที่จะวิเคราะห์ จำได้ว่าเราจัดการ [:identifier, :'=', :number] อยู่
สุดท้าย เราสร้างและคืนค่า AST Node แทน Variable Binding Constructor ของ AST::VarBinding คาดหวังสองพารามิเตอร์: AST Node ของ Identifier (Left-hand side) และ Expression ใดๆ ที่ถูกต้อง (Right-hand side) มีจุดสำคัญหนึ่ง: เพื่อสร้าง Right-hand Side เราเรียก #parse_expr_recursively อีกครั้ง อาจรู้สึกแปลกเล็กน้อย แต่จำไว้ว่า Variable อาจถูก Bind กับ Expression ซับซ้อน ไม่ได้แค่ Number เหมือนตัวอย่าง ถ้าเราจะนิยาม Parsing Strategy ในคำเดียว จะเป็น Recursive ตอนนี้คุณคงเริ่มเข้าใจว่าทำไม #parse_expr_recursively จึงมีชื่อนี้
ก่อนจบส่วนนี้ มาสำรวจ AST::Identifier และ AST::VarBinding ให้เร็วๆ ก่อน แรก AST::Identifier:
class Stoffle::AST::Identifier < Stoffle::AST::Expression attr_accessor :name def initialize(name) @name = name end def ==(other) name == other&.name end def children [] end end ไม่มีอะไรแปลกใหม่ เหมาะจะบอกว่า Node เก็บชื่อตัวแปร และไม่มี Children
ต่อไป AST::VarBinding:
class Stoffle::AST::VarBinding < Stoffle::AST::Expression attr_accessor :left, :right def initialize(left, right) @left = left @right = right end def ==(other) children == other&.children end def children [left, right] end end Left-hand side เป็น Node AST::Identifier Right-hand side เป็นประเภท Node ทุกอย่างเกือบหมด - จาก Number เรียบง่าย เช่นตัวอย่าง ไปจนถึงสิ่งซับซ้อนกว่า - แทน Expression ที่ Identifier ถูก Bind ไว้ #children ของ Variable Binding คือ AST Nodes ที่เก็บใน @left และ @right
จาก Source ไปสู่ AST: ตัวอย่างที่สอง
รูปแบบปัจจุบันของ #parse_expr_recursively Parse Expressions เรียบง่ายได้บ้างแล้ว ตามที่เห็นในส่วนก่อน ในส่วนนี้ เราจะเสร็จสิ้น Implementation เพื่อให้ Parse Entities ซับซ้อนกว่าได้ เช่น Binary และ Logical Operators ที่นี่ เราจะสำรวจทีละขั้นตอนว่า Parser จัดการกับโปรแกรมที่ Define Function ยังไง นี่คือ Source, Tokens แบบง่ายจาก Lexer และภาพแสดง AST ที่จะสร้าง:
Source
fn double: num num * 2 end Tokens (Output ของ Lexer, Input สำหรับ Parser)
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] ภาพแสดง Output ของ Parser (Abstract Syntax Tree)
ก่อนไปต่อ มาย้อนกลับมาพูดถึง Operator Precedence Rules (กฎลำดับความสำคัญของออปอเรเตอร์) พวกมันฐานบนข้อตกลงทางคณิตศาสตร์ ในคณิตศาสตร์เป็นแค่ข้อตกลง ไม่มีอะไรพื้นฐานบังคับให้เป็น Precedence ที่เราคุ้นเคย กฎเหล่านี้ช่วยกำหนดลำดับที่ถูกต้องสำหรับการ Evaluate Expression และในกรณีของเรา คือการ Parse ให้ถูกต้องลำดับ เพื่อกำหนด Precedence ของแต่ละ Operator เราแค่มี Map (Hash) ของ Token Types และ Integers ตัวเลขมากกว่า = ควรจัดการ ก่อน:
# เรากำหนด Precedence Rules ที่บนสุดของ Stoffle::Parser module Stoffle class Parser # ... UNARY_OPERATORS = [:'!', :'-'].freeze BINARY_OPERATORS = [:'+', :'-', :'*', :'/', :'==', :'!=', :'>', :'<', :'>=', :'<='].freeze LOGICAL_OPERATORS = [:or, :and].freeze LOWEST_PRECEDENCE = 0 PREFIX_PRECEDENCE = 7 OPERATOR_PRECEDENCE = { or: 1, and: 2, '==': 3, '!=': 3, '>': 4, '<': 4, '>=': 4, '<=': 4, '+': 5, '-': 5, '*': 6, '/': 6, '(': 8 }.freeze # ... end end เทคนิคที่ใช้ใน #parse_expr_recursively ฐานบน Parser Algorithm ที่มีชื่อเสียงของนักวิทยาการคอมพิวเตอร์ Vaughan Pratt ใน Paper ปี 1973 "Top Down Operator Precedence" เหมือนที่คุณจะเห็น Algorithm นี้เรียบง่าย แต่ยากต่อการเข้าใจเต็มที่ อาจพูดได้ว่ารู้สึกเหมือน Magic เล็กน้อย สิ่งที่เราจะทำในโพสต์นี้เพื่อเข้าใจ intuitively คือเดินผ่านทีละขั้นตอนสิ่งที่เกิดขึ้นขณะ Parse สนิปเป็ต Stoffle ด้านบน โดยไม่ล่าช้า นี่คือ Version เสร็จสมบูรณ์ของ #parse_expr_recursively:
def parse_expr_recursively(precedence = LOWEST_PRECEDENCE) parsing_function = determine_parsing_function if parsing_function.nil? unrecognized_token_error return end expr = send(parsing_function) return if expr.nil? # When expr is nil, it means we have reached a \n or a eof. # Note that, here, we are checking the NEXT token. while nxt_not_terminator? && precedence < nxt_precedence infix_parsing_function = determine_infix_function(nxt) return expr if infix_parsing_function.nil? consume expr = send(infix_parsing_function, expr) end expr end #parse_expr_recursively ตอนนี้รับ Parameter precedence แทน "ระดับ" Precedence ที่พิจารณาในการเรียกครั้งนั้น นอกจากนี้ ส่วนแรกของเมธอดเหมือนเดิม แล้ว - ถ้าเราสร้าง Expression ได้ในส่วนแรก - มาส่วนใหม่ While Next Token ไม่ใช่ Terminator (Line Break หรือ End of File) และ Precedence (Parameter precedence) ต่ำกว่า Precedence ของ Next Token เราอาจจะ Consume Token Stream ต่อ
ก่อนดูใน While ลองคิดนิดหน่อยถึงความหมายของเงื่อนไขที่สอง (precedence < nxt_precedence) ถ้า Precedence ของ Next Token สูงกว่า Expression ที่เราสร้างเมื่อสักครู่ (Local Variable expr) อาจจะเป็น Child ของ Node ที่ยังไม่ได้สร้าง (จำได้ว่าเราสร้าง AST - Abstract Syntax Tree) ก่อนไป Parse สนิปเป็ต Stoffle ของเรา ลองมอง Expression คณิตศาสตร์ง่ายๆ: 2 + 2 เมื่อ Parse ส่วนแรกของเมธอดจะสร้าง Node AST::Number แทน 2 ตัวแรก เก็บใน expr แล้วเราเข้า While เพราะ Precedence ของ Next Token (:'+') สูงกว่า Default Precedence เราจะเรียก Parsing Method สำหรับบวก ส่ง AST::Number Node ไป ได้กลับ Node แทน Binary Operator (AST::BinaryOperator) สุดท้ายเรา Overwrite ค่าใน expr (Node แทน 2 ตัวแรก) ด้วย Node ใหม่แทน Plus Operator สังเกตว่า Algorithm นี้ทำให้เรา จัดเรียง Node ใหม่ เริ่มจากสร้าง AST::Number จบเป็น Child Node ลึกกว่าในต้นไม้ เป็น Child หนึ่งของ AST::BinaryOperator
Parse Function Definition ทีละขั้นตอน
ตอนเราเข้าใจ #parse_expr_recursively แล้ว มากลับมาที่ Function Definition เรียบง่าย:
fn double: num num * 2 end แม้แค่คิดจะดู Simplified Description ของ Parser Execution ขณะ Parse สนิปเป็ตนี้ อาจรู้สึกเหนื่อย (และจริงๆ อาจเป็นจริง!) แต่ผมคิดว่ามันมีค่ามากสำหรับเข้าใจ #parse_expr_recursively และ Parsing ของส่วนเฉพาะ (Function Definition และ Product Operator) ทั้งนี้ Token Types ที่จัดการ (Output ของ @tokens.map(&:type) ภายใน Parser หลัง Lexer Tokenize เสร็จ):
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] ตารางด้านล่างแสดงลำดับที่เมธอดสำคัญถูกเรียกขณะ Parse Tokens ข้างบน จำไว้ว่าเป็น Simplification หากต้องการเข้าใจทุก Step แท้จริง แนะนำใช้ Ruby Debugger เช่น Byebug Step Line-by-line
Parser ของเราภายใต้กล้องจุลทรรศน์
มี Test ใช้สนิปเป็ตนี้ใน Source ของ Stoffle หาได้ใน spec/lib/stoffle/parser_spec.rb คือ Test ที่ใช้สนิปเป็ตชื่อ
complex_program_ok_2.sfeเพื่อสำรวจ Parser Execution ทีละขั้นตอน แก้ Source ใส่
byebugต้นParser#parseรัน Test นั้นกับ RSpec แล้วใช้คำสั่งstepของ Byebugดูรายละเอียด Byebug ได้ที่ README ของโปรเจกต์บน GitHub
| เมธอดที่เรียก | Current Token | Next Token | ตัวแปร/ผลลัพธ์ที่น่าสนใจ | หมายเหตุ |
|---|---|---|---|---|
| parse | nil | :fn | ||
| parse_expr_recursively | :fn | :identifier | precedence = 0, parsing_function = :parse_fn | |
| parse_function_definition | :fn | :identifier | parse_fn เป็น Alias ของ parse_function_definition | |
| parse_function_params | :identifier | :":" | ||
| parse_block | :"\n" | :identifier | ||
| parse_expr_recursively | :identifier | :* | precedence = 0, parsing_function = :parse_identifier, nxt_precedence() returns 6, infix_parsing_function = :parse_binary_operator | |
| parse_identifier | :identifier | :* | ||
| parse_binary_operator | :* | :number | op_precedence = 6 | |
| parse_expr_recursively | :number | :"\n" | precedence = 6, parsing_function = :parse_number, nxt_precedence() returns 0 | |
| parse_number | :number | :"\n" |
ตอนเรามีภาพรวมเมธอดที่เรียกและลำดับแล้ว มาศึกษา Parsing Methods ที่ยังไม่ได้เห็นรายละเอียด
เมธอด #parse_function_definition
เมธอด #parse_function_definition ถูกเรียกเมื่อ Current Token เป็น :fn และ Next เป็น :identifier:
def parse_function_definition return unless consume_if_nxt_is(build_token(:identifier)) fn = AST::FunctionDefinition.new(AST::Identifier.new(current.lexeme)) if nxt.type != :"\n" && nxt.type != :':' unexpected_token_error return end fn.params = parse_function_params if nxt.type == :':' return unless consume_if_nxt_is(build_token(:"\n", "\n")) fn.body = parse_block fn end #consume_if_nxt_is - ตามชื่อ - เลื่อน Pointer ถ้า Next Token เป็น Type ที่กำหนด ไม่งั้นเพิ่ม Error เข้า @errors มันมีประโยชน์มาก - ใช้ในหลาย Parsing Methods - เมื่อต้องเช็คโครงสร้าง Tokens ว่า Syntax ถูกต้องหรือไม่ หลังจากนั้น Current Token เป็น Type :identifier (เราจัดการ 'double' ชื่อฟังก์ชัน) เราสร้าง AST::Identifier ส่งให้ Constructor สร้าง Node แทน Function Definition (AST::FunctionDefinition) เราจะไม่รายละเอียดที่นี่ แต่โดยพื้นฐาน AST::FunctionDefinition Node คาดหวังชื่อฟังก์ชัน, Array ของ Parameters (ถ้ามี) และ Body ของฟังก์ชัน
ขั้นตอนต่อไปใน #parse_function_definition คือตรวจสอบว่า Next Token หลัง Identifier เป็น Expression Terminator (Function ไม่มี Params) หรือ Colon (Function มี Params) ถ้ามี Params เช่น Function double เราเรียก #parse_function_params Parse พวกมัน เราจะดูเมธอดนี้ทันที แต่มาดูต่อ #parse_function_definition ก่อน
ขั้นตอนสุดท้ายคือ Syntax Check อีกครั้งว่ามี Terminator หลัง Function Name + Params แล้วค่อย Parse Function Body โดยเรียก #parse_block สุดท้ายคืนค่า fn ซึ่งมี Instance AST::FunctionDefinition ครบถ้วน พร้อมชื่อ, Parameters และ Body
รายละเอียดการ Parse Function Parameters
ในส่วนก่อน เราเห็น #parse_function_params ถูกเรียกใน #parse_function_definition ถ้ากลับดูตารางสรุป Execution Flow และ State ของ Parser จะเห็นตอน #parse_function_params เริ่มทำงาน Current Token เป็น :identifier และ Next เป็น :":" (เพิ่ง Parse ชื่อ Function เสร็จ) มาดูโค้ด:
def parse_function_params consume return unless consume_if_nxt_is(build_token(:identifier)) identifiers = [] identifiers << AST::Identifier.new(current.lexeme) while nxt.type == :',' consume return unless consume_if_nxt_is(build_token(:identifier)) identifiers << AST::Identifier.new(current.lexeme) end identifiers end ก่อนอธิบายแต่ละส่วน ลอง Recap Tokens ที่ประมวลผลและตำแหน่งปัจจุบัน:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] # here ▲ ส่วนแรกของ #parse_function_params ตรงไปตรงมา ถ้า Syntax ถูกต้อง (มี Identifier อย่างน้อยหนึ่งตัวหลัง :) เราเลื่อน Pointer สองตำแหน่ง:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] # ▲ ตอนนี้เราอยู่ที่ Parameter แรก (Token Type :identifier) ตามคาด สร้าง AST::Identifier Push เข้า Array ของ Parameters ที่อาจมีหลายตัว ในส่วนต่อไปของ #parse_function_params เรา Parse Params ต่อตราบใดที่ยังมี Parameter Separators (Token Type :',') จบเมธอดด้วยการคืนค่า Local Var identifiers Array ที่มี AST::Identifier Nodes หลายตัว แต่ในกรณีนี้มีแค่ตัวเดียว
Function Body จะเป็นยังไง?
มาเจาะลึกส่วนสุดท้ายของ Function Definition: Body ตอน #parse_block ถูกเรียก เราอยู่ที่ Terminator ที่จบรายการ Parameters:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] # ▲ Implementation ของ #parse_block:
def parse_block consume block = AST::Block.new while current.type != :end && current.type != :eof && nxt.type != :else expr = parse_expr_recursively block << expr unless expr.nil? consume end unexpected_token_error(build_token(:eof)) if current.type == :eof block end AST::Block คือ AST Node สำหรับแทน Block of Code กล่าวคือ AST::Block แค่เก็บ List ของ Expressions คล้าย Root Node ของโปรแกรม AST::Program (เห็นต้นโพสต์) การ Parse Block (Function Body) เราเลื่อนผ่าน Unprocessed Tokens จนเจอ Token จบ Block
เพื่อ Parse Expressions ใน Block เราใช้ #parse_expr_recursively ที่รู้จักแล้ว เราจะ Step Into เมธอดนี้ในทันที นี่คือจุดเริ่ม Parse Product Operation ภายใน Function double การติดตามจะทำให้เข้าใจการใช้ Precedence Values ใน #parse_expr_recursively และการจัดการ Infix Operator (* ในกรณีนี้) แต่ก่อนนั้น มาจบ #parse_block ก่อน
ก่อนคืน AST Node แทน Block เราเช็คว่า Current Token Type :eof หรือไม่ ถ้าใช่ คือ Syntax Error เพราะ Stoffle ต้องการ Block จบด้วย Keyword end เพื่อปิด #parse_block ควรบอกอะไรที่คุณสังเกตแล้ว: เงื่อนไข Loop หนึ่งเช็คว่า Next Token Type :else เพราะ #parse_block ถูก Share โดย Parsing Methods อื่นๆ รวมถึง Methods Parse Conditionals และ Loops ดูเน้นๆ นะ!
การ Parse Infix Operators
ชื่ออาจดู Fancy แต่ Infix Operators คือ Operators ที่เราคุ้นเคยในคณิตศาสตร์ บวกกับบางอย่างที่ Developer คุ้นเคย:
module Stoffle class Parser # ... BINARY_OPERATORS = [:'+', :'-', :'*', :'/', :'==', :'!=', :'>', :'<', :'>=', :'<='].freeze LOGICAL_OPERATORS = [:or, :and].freeze # ... end end พวกมันคาดหวังใช้แบบ Infix เมื่อใช้ Infix Notation ซึ่งเป็นกรณีของ Stoffle หมายถึงควรอยู่กลางสอง Operands (เช่น * ใน num * 2 ใน double) สิ่งน่าบอกคือแม้ Infix Notation จะนิยม มีวิธีวาง Operators อื่นๆ เช่น "Polish Notation" และ "Reverse Polish Notation"
เพื่อ Parse Function double ให้เสร็จ เราต้องจัดการ Operator *:
fn double: num num * 2 end ในส่วนก่อน เราบอกว่า Parse Expression ใน Body ของ double เริ่มตอน #parse_expr_recursively ถูกเรียกใน #parse_block ตอนนั้น ตำแหน่งใน @tokens:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] # ▲ และ Refresh เรื่อง #parse_expr_recursively:
def parse_expr_recursively(precedence = LOWEST_PRECEDENCE) parsing_function = determine_parsing_function if parsing_function.nil? unrecognized_token_error return end expr = send(parsing_function) return if expr.nil? # When expr is nil, it means we have reached a \n or a eof. # Note that here, we are checking the NEXT token. while nxt_not_terminator? && precedence < nxt_precedence infix_parsing_function = determine_infix_function(nxt) return expr if infix_parsing_function.nil? consume expr = send(infix_parsing_function, expr) end expr end ในส่วนแรก เราใช้ #parse_identifier เดิม Parse Variable num แล้ว ครั้งแรกเงื่อนไข While เป็น True Next Token ไม่ใช่ Terminator และ Precedence ของ Next Token มากกว่า Precedence ของการเรียก parse_expr_recursively ครั้งนี้ (precedence เป็น Default 0 ขณะ nxt_precedence คืน 6 เพราะ Next Token Type :'*') นี้บ่งชี้ Node ที่สร้างแล้ว (AST::Identifier แทน num) จะเป็น Child ลึกกว่าใน AST (คือ Child ของ Node ที่ยังจะสร้าง) เราเข้า Loop เรียก #determine_infix_function ส่ง Next Token (*):
def determine_infix_function(token = current) if (BINARY_OPERATORS + LOGICAL_OPERATORS).include?(token.type) :parse_binary_operator elsif token.type == :'(' :parse_function_call end end เพราะ * เป็น Binary Operator การรัน #determine_infix_function ให้ :parse_binary_operator กลับใน #parse_expr_recursively เราเลื่อน Token Pointer หนึ่งตำแหน่ง แล้วเรียก #parse_binary_operator ส่งค่า expr (AST::Identifier แทน num) ไปด้วย:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] #▲ def parse_binary_operator(left) op = AST::BinaryOperator.new(current.type, left) op_precedence = current_precedence consume op.right = parse_expr_recursively(op_precedence) op end class Stoffle::AST::BinaryOperator < Stoffle::AST::Expression attr_accessor :operator, :left, :right def initialize(operator, left = nil, right = nil) @operator = operator @left = left @right = right end def ==(other) operator == other&.operator && children == other&.children end def children [left, right] end end ที่ #parse_binary_operator เราสร้าง AST::BinaryOperator (Implementation ด้านบนถ้าสนใจ) แทน * ตั้ง Left Operand เป็น Identifier (num) ที่รับมาจาก #parse_expr_recursively แล้วเก็บ Precedence Value ของ * ไว้ Local Var op_precedence และเลื่อน Token Pointer เพื่อสร้าง Node * ให้เสร็จ เราเรียก #parse_expr_recursively อีกครั้ง! เราต้องทำแบบนี้เพราะ Right-hand Side ของ Operator ไม่ได้เป็นแค่ Number หรือ Identifier เดียว อาจเป็น Expression ซับซ้อน เช่น num * (2 + 2)
สิ่งสำคัญที่สุดที่นี่คือ วิธี ที่เราเรียก #parse_expr_recursively กลับ เราส่ง 6 เป็น Precedence Value (Precedence ของ * เก็บใน op_precedence) ที่นี่เราสังเกตด้านสำคัญของ Parsing Algorithm ที่กล่าวไปก่อนหน้า การส่ง Precedence Value ที่สูง คล้ายว่า * "ดึง" Next Token ให้เป็น Operand ของมัน นึกภาพถ้า Parse num * 2 + 1 Precedence Value ของ * ที่ส่งเข้าไปจะรับรองว่า 2 จะเป็น Right-hand Side ของ * ไม่ใช่ Operand ของ + ที่ Precedence ต่ำกว่า (5)
หลัง #parse_expr_recursively คืน AST::Number Node เราตั้งเป็น Right-hand Side ของ * และคืน AST::BinaryOperator Node ที่สมบูรณ์ ณ จุดนี้ เรา Parse โปรแกรม Stoffle เรียบร้อยเกือบหมด ยังเหลือ Parse Terminator Tokens บ้าง แต่ตรงไปตรงมาและไม่ค่อยน่าสนใจ ตอนจบ เราจะมี Instance AST::Program ที่ @ast พร้อม Expressions ที่แสดงภาพเป็นต้นไม้เหมือนต้นโพสต์และต้นส่วนที่สอง:
สรุป
ในโพสต์นี้ เราครอบคลุมด้านหลักของ Parser ของ Stoffle ถ้าคุณเข้าใจส่วนที่สำรวจ คุณไม่ควรจะยากกับ Parser Methods อื่นๆ ที่ไม่ได้ครอบคลุม เช่น Parsing Conditionals และ Loops ผมขอแนะนำให้สำรวจ Source Code ของ Parser เองและปรับ Implementation หากสนุก! Implementation มาพร้อม Test Suite ครบถ้วน อย่ากลัวลองทำและทำลาย Parser
ในโพสต์ต่อไปของชุดนี้ เราจะเปิดชีวิตให้มอนสเตอร์เล็กของเราโดย Implement ส่วนสุดท้ายที่ขาด: Tree-walk Interpreter ผมรอไม่及ที่จะอยู่กับคุณเมื่อเรารันโปรแกรม Stoffle แรก!
