

โครงสร้างข้อมูลโปรดของผมคือ Hash Table เพราะมัน เรียบง่ายแท้แต่วิถีอันทรงพลัง
คุณน่าจะเคยใช้มาก่อน เพราะมันเป็นวิธีที่มีประสิทธิภาพสำหรับการจัดเก็บคู่ Key-Value (กุญแจ-ค่า) ไม่ว่าจะเป็น Dictionary ใน Python, HashMap ใน Java, Object ใน JavaScript หรือ Hash ใน Ruby
แต่เบื้องหลังการทำงานมีแนวคิด Computer Science ที่น่าสนใจและคุ้มค่าที่จะศึกษา — และที่นี่เราจะเจาะลึกลงไปด้วยกัน!
Bucket และ Hash Function
แนวคิดหลักของ Hash Table คือการให้เรา ดึงข้อมูลได้อย่างรวดเร็ว (O(1)) โดยใช้ Key เป็นดัชนี
เพื่อความเข้าใจ ให้ดูตัวอย่างการใช้ Hash ใน Ruby:
prices = { apple: 0.50, ice_cream: 3, steak: 10 }ในการสร้าง Hash Table เราต้องมี 2 องค์ประกอบหลัก:
- ที่เก็บข้อมูล — โดยทั่วไปคือ Array (เรียกว่า Buckets)
- Hash Function — ฟังก์ชันที่แปลง Key ให้กลายเป็น Index ใน Array
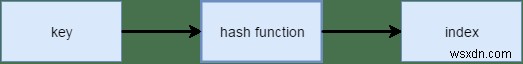
นี่คือความแตกต่างสำคัญระหว่าง Array ธรรมดากับ Hash Table:
- Array: เข้าถึงค่าได้เฉพาะผ่าน Index ที่เป็นตัวเลขเท่านั้น
- Hash Table: เข้าถึงค่าผ่าน Key — และ Key สามารถเป็น อะไรก็ได้ (String, Symbol, Integer, Object) ตราบใดที่เขียน Hash Function ให้มันได้
การสร้าง Hash Function แบบง่าย
Hash Function เป็นหัวใจสำคัญ — มันแปลง Key ให้กลายเป็น Index ที่ใช้ lookup หรือ update ค่าได้
วิธีง่ายสำหรับ String: แปลงตัวอักษรทุกตัวเป็นค่า ASCII แล้วบวกรวมกัน
BUCKETS = 32

def hash(input)
  input.to_s.chars.inject(0) { |sum, ch| sum + ch.ord } % BUCKETS
end
อธิบายโค้ด:
to_s— รับประกันว่าทำงานกับ String (ป้องกัน error)chars— แปลง String เป็น Array ของตัวอักษรinject— สะสมค่า (reduce/fold)ch.ord— ดึงค่า ASCII/Unicode ของตัวอักษร% BUCKETS— ใช้ Modulo ให้ผลลัพธ์อยู่ในขอบเขต Array เรียกแต่ละช่องว่า Bucket
การกระจาย Bucket (Bucket Distribution)
ในทาง lý thuyết เราต้องการให้ Bucket ทุกช่องถูกใช้งาน อย่างเท่าเทียม เพื่อประสิทธิภาพสูงสุด
ลองทดสอบ Hash Function ด้านบนด้วยสตริงสุ่ม 10,000 ค่า:
BUCKETS = 32
table = Array.new(BUCKETS) { 0 }
letters = ('a'..'z').to_a

10_000.times do
  input = Array.new(5) { letters.sample }.join
  table[hash(input)] += 1
end

puts table.inspect
# ผลลัพธ์: [302, 290, 299, 309, 321, 293, 316, 301, 296, 306, 340, 321, 313, 304, 318, 296, 331, 306, 348, 330, 310, 313, 298, 292, 304, 315, 337, 325, 325, 331, 319, 291]
ดูแล้วกระจายดีมาก! แต่...
เกิดอะไรขึ้นถ้าเพิ่มจำนวน Bucket?
ลองเปลี่ยน BUCKETS = 128:
[22, 24, 33, 36, 41, 58, 61, 66, 97, 77, 88, 110, 89, 82, 123, 121, 119, 111, 147, 178, 136, 176, 144, 180, 190, 193, 185, 192, 223, 209, 208, 196, 215, 251, 233, 226, 231, 236, 219, 218, 227, 221, 206, 220, 208, 213, 201, 191, 182, 165, 188, 141, 160, 135, 130, 117, 139, 106, 121, 85, 70, 93, 74, 61, 57, 54, 40, 46, 32, 36, 30, 21, 25, 17, 14, 16, 16, 14, 8, 11, 5, 5, 1, 1, 2, 1, 3, 0, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 2, 0, 4, 3, 6, 0, 2, 9, 13, 11, 12, 14, 12, 23, 12, 22]การกระจายแย่ลงมาก! Bucket กลางๆ ว่างเปล่ามาก ในขณะที่ปลายๆ แน่นหนา
สาเหตุ:
Hash Function แบบบวก ASCII ทำให้ สตริงที่มีความยาวเท่ากันจะให้ผลรวมอยู่ในช่วงแคบๆ ทำให้ Bucket หลายช่องไม่ถูกใช้เลย
Hash Function ที่ดีกว่า: ใช้ Bitwise Operations
BUCKETS = 256

def hash(input)
  input.to_s.each_char.inject(0) do |sum, ch|
    (sum << 8) ^ ch.ord ^ (sum >> 4)
  end % BUCKETS
end
สิ่งที่เกิดขึ้น:
<< 8— Left shift 8 บิต (คูณ 256)>> 4— Right shift 4 บิต (หาร 16)^— XOR (Exclusive OR) รวมค่าแบบสลับกัน
Bit shifting ทำให้ค่า กระจายกระจายกระจาย (mix up) ได้ดีมากขึ้น — การกระจาย Key ดีกว่าเดิมมาก (ยังไม่ใช่สมบูรณ์แบบ แต่พอใช้งานได้)
หากต้องการ Hash Function ระดับ Production จริง ให้ดู MurmurHash ซึ่ง Ruby ใช้อยู่จริง
การจัดการ Collision (Hash Collision)
ปัญหา: Key ต่างกัน อาจได้ Index เหมือนกัน — เรียกว่า Collision
หากไม่จัดการ ค่าใหม่จะทับค่าเก่า → ข้อมูลหาย!
กลยุทธ์หลัก 3 แบบ:
- Separate Chaining — ใช้ Linked List (หรือ Array) เก็บค่าทุกค่าที่ตก Bucket เดียวกัน
- Linear Probing (Open Addressing) — หา Bucket ถัดไปที่ว่าง (index+1, index+2...)
- Double Hashing — ใช้ Hash Function อีกตัวหา step size สำหรับ probing
ตัวอย่าง Separate Chaining:
สมมติ :abc และ :ccc ตก Bucket เดียวกัน (index 3):
3: [:abc, 100] → [:ccc, 200]
4: nil
5: [:yx, 50]
ตอน lookup ต้อง linear search ใน Linked List → เวลาอาจเสื่อมเป็น O(n) แทน O(1)
Big-O Notation: O(1) = คงที่, O(n) = เส้นตรงตามขนาดข้อมูล, O(log n) = ลอการิทึม
แก้ไข: Rehashing (Resize)
ไม่ให้ Linked List ยาวเกินไป → ต้อง ขยาย Array (เพิ่ม Bucket) และ Rehash ทุกค่าใหม่ เมื่อ Load Factor (n/buckets) เกินเกณฑ์ (เช่น 0.75)
Ruby, Java, Python ทำให้อัตโนมัติ — แต่มันดีที่คุณเข้าใจว่ามันเกิดอะไรขึ้นเบื้องหลัง
สรุป
จุดประสงค์ของบทความนี้ไม่ใช่ให้คุณเขียน Hash Table เอง — แต่มันคือการ เข้าใจว่ามันทำงานอย่างไร เพื่อให้คุณใช้งานได้อย่างมีสติ เข้าใจ trade-offs และ debug ได้ดีขึ้น
หวังว่าคุณจะได้เรียนรู้อะไรใหม่! อย่าลืมแชร์ถ้าชอบครับ 🙂
