

บทนำ
ในขณะที่ IT โตต่อไป Information Systems กลายเป็น Critical ในหลายอุตสาหกรรม Service Interruption ใน Information Systems อาจทำให้เกิด Economic Loss, Critical Data Loss, และกระทบ Brand Image โดยเฉพาะอุตสาหกรรม Communication, Finance, Medical Care, E-commerce, Logistics, และ Government ดังนั้น Service Continuity จึง Critical สำหรับการสร้าง Information Systems ปัจจุบันปรับปรุง Service Continuity โดยการสร้าง Disaster Recovery (DR) Centers ที่เก็บ Copy ของ Production Data
Traditional DR Solution และ Challenges
ใน Traditional DR Solution จะ Deploy DR Center 1 ต่อ 1 Production Data Center (DC) DR Center ไม่ให้ Service Access เว้นแต่ Production DC พบ Disaster นำไปสู่ Service Breakdown ที่ซ่อมแซมไม่ทัน ทำให้ DR Centers เผชิญ Challenges:
- เมื่อ Production Center พบ Power Failure, ไฟ, น้ำท่วม, หรือแผ่นดินไหว ต้อง Manual Switch Services ไป DR Center ต้องใช้ Professional Recovery Measures และ Debugging Disasters อาจทำให้ Service Interruption ยาวนานและ Service Discontinuity
- DR Center ไม่ให้ Services และ Idle อยู่ส่วนใหญ่ ทำให้ Resource Usage ต่ำ
เพื่อตอบสนองความต้องการ Efficient Resource Usage, Load Balancing, และ Automatic Switchover ระหว่าง 2 DCs Oracle® เปิดตัว End-to-End Active-Active DC Solution Solution นี้ให้ DCs ทั้งสอง Run Concurrently และ Share Service Loads เพื่อ Improve Overall Service Capability และ Resource Usage ยัง Ensure Automatic Failover ด้วย Zero Service Awareness กรณี Device Failures หรือ Single-DC Failure และ Boast Zero Recovery Point Objective (RPO) และ Zero Recovery Time Objective (RTO) หมายเหตุ: RTO ขึ้นกับ Application System และ Deployment Mode
มี 2 Availability Modes ใน Storage Industry ปัจจุบัน:
- Active-Passive (AP) หรือ Active-Standby
- Active-Active (AA) หรือ Metro Virtual Data Center (MVDC)
Critical Components ของ Database Layer
Database (DB) ควร Setup เป็น Active-Standby Mode พร้อม Zero Data Loss Option Components สำคัญ:
- Oracle Data Guard Broker: Automate และ Centralize Data Guard Configuration ช่วย Invoke Switchover หรือ Failover ด้วย Single Command สำหรับ Complex Role Changes
- Flashback Database: ให้ Rewind หรือ Revert สำหรับ DB เก็บ Flashback Log ใน Flash Recovery Area
- Fast-Start Failover (FSFO): Enable Failover ด้วย Zero Data Loss FSFO ไม่ Trigger เว้นแต่ Standby DB In-sync กับ Primary DB
- Observer: ให้ Separate Process รวมใน Data Guard CLI
dgmgrlMonitor State ของ Primary และ Standby DBs สำหรับ Failure Conditions
Data Guard Configuration
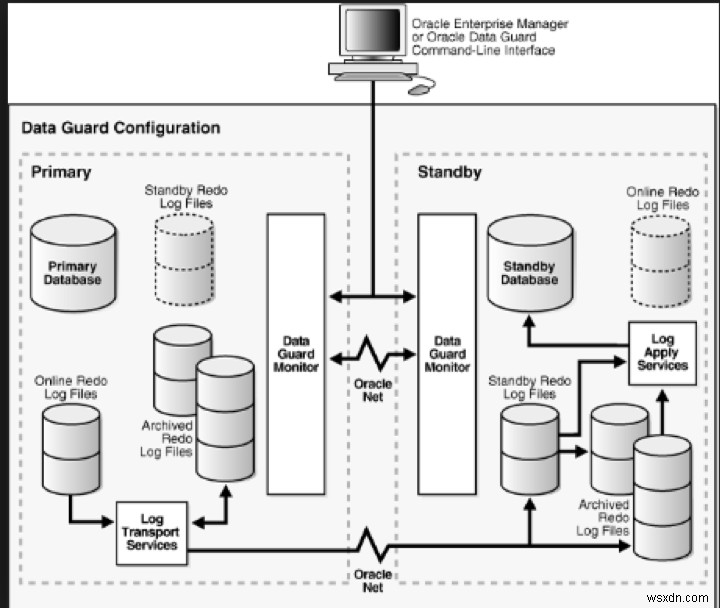
Image source: https://neeraj-dba.blogspot.com/2011/10/dataguard-broker-and-its-benefits_05.html
บน Primary DB Log Writer (LGWR) ส่ง Redo Data ให้ Log Network Server (LNSn) Processes ซึ่ง Initiate Network I/O ไป Multiple Remote Destinations แบบ Parallel Transactions ไม่ Commit บน Primary จนกว่า Redo Data จะ Received โดย LGWR SYNC Destinations ทั้งหมด
บน Standby DB Remote File Server (RFS) รับ Redo Data ผ่าน Network จาก LGWR และเขียนไป Standby Redo Log Files
Maximum Availability Architecture
ตอน Design Architecture สำหรับ Maximum Availability ควรพิจารณา Possible Causes ของ Downtime และ Classify Unplanned และ Planned Downtime
Unplanned Downtime รวม Unexpected Interruptions:
- Server Availability: Ensure Uninterrupted Access to DB Services ว่าแม้ Failure ของ Machine(s) Hosting DB Server (Hardware/Software Fault) Oracle Real Application Clusters (RAC) ให้ Protection ที่ Effective ที่สุด
- Data Availability: Mitigate Data Failures เช่น Loss, Damage, Corruption ของ Business-critical Data Plan ต้อง Ensure Always Have Access to Data
Planned Downtime รวม Scheduled Interruptions:
- System Changes
- Data Changes
- App Changes
Switchover Testing Scenarios สำหรับ MVDC
Switchover = Controlled, Planned Role Reversal Operation Primary และ Standby DBs ใน Data Guard Config สลับ Role หลัง Switchover แต่ละ DB ยังคง Participate ใน Data Guard Config ใน Role ใหม่
Switchover Process
- Original Primary DB สลับ Role เป็น Standby
- Original Standby DB เปลี่ยนเป็น Primary Role
Data Guard Broker จัดการอัตโนมัติตอน Switchover:
- Verify Primary และ Target Standby DBs Online และ No Errors
- Shutdown All แต่ 1 Instance ใน RAC Config สำหรับ Primary และ Standby ทั้งคู่
- Switch Roles: Broker Convert Original Primary เป็น Standby Role ก่อน แล้ว Transition Target Standby เป็น Primary Update Broker Config File บันทึก Role Changes เพื่อให้แต่ละ DB Run ใน Role ถูกต้องหลัง Restart
- Restart New Standby (Former Primary) เริ่ม Redo Apply จาก New Primary ถ้า RAC Broker Restart Instances ที่ Shutdown ก่อน Switchover
- Restart New Primary DB เปิดและเริ่ม Redo Transport Services ส่ง Redo Data ไป Standby ถ้า RAC Broker Restart Instances ที่ Shutdown ก่อน Switchover
Before Switchover:
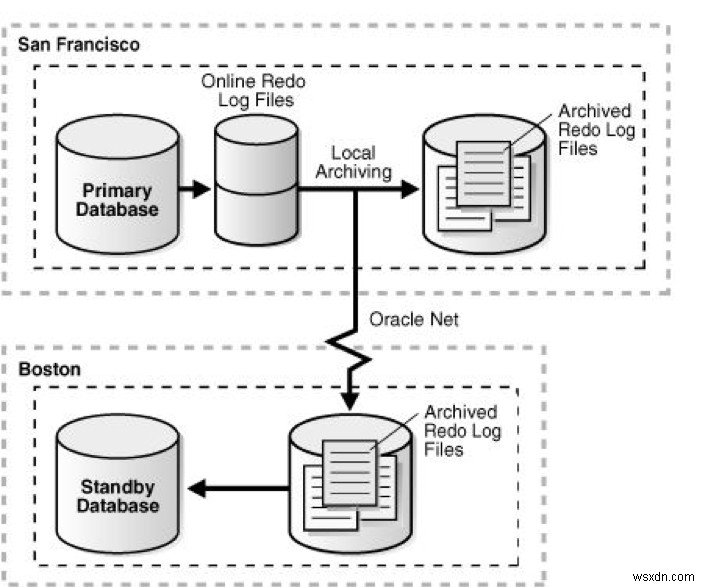
Image source: https://docs.oracle.com/cd/E11882_01/server.112/e41134/role_management.htm#SBYDB00615
After Switchover:
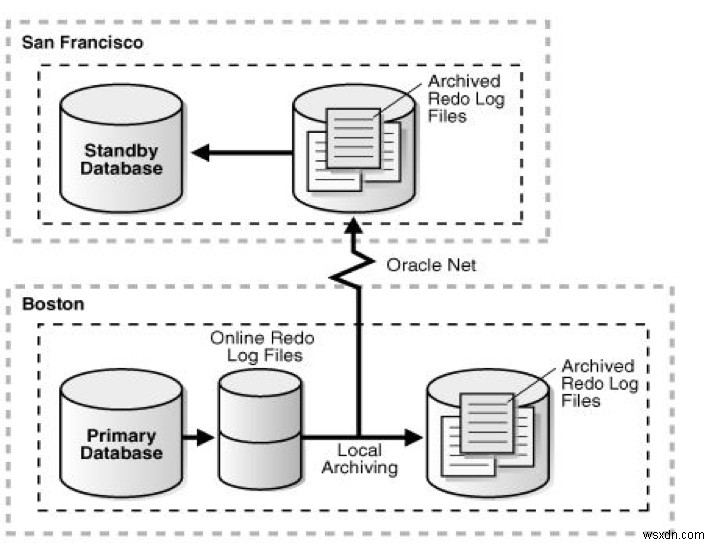
Image source: https://docs.oracle.com/cd/E11882_01/server.112/e41134/role_management.htm#SBYDB00615
Steps to Perform a Switchover
- Ensure Application Shutdown แล้ว และไม่มี User Connected ไป Database
- Disable Archive UTL Scripts ที่รันในทั้ง 2 DCs อย่างน้อย 30 นาที ก่อน Switchover เริ่ม หลัง Testing Complete และ DB รันใน Preferred Location ให้ Uncomment Archive Utility Scripts
- Run SQL Queries ใน Current Primary DB:
SELECT * FROM DBA_JOBS_RUNNING; (ไม่ควรมี Sys-owned Jobs รัน) SELECT OWNER, JOB_NAME, START_DATE, END_DATE, ENABLED FROM DBA_SCHEDULER_JOBS WHERE ENABLED='TRUE' AND OWNER <> 'SYS'; (Data Guard Broker ไม่ Kill Jobs ของ Sys) - Set
job_queue_processesและaq_tm_processes= 0 บันทึก Original Value ไว้ Reset หลัง Testing - Stop
emagentที่รันบน Primary DB - Run SQL Queries ใน Current Primary DB:
SELECT sid, username, status, program, inst_id FROM gv$session WHERE username is not null and status='ACTIVE' order by inst_id; (Validate Active Connections จำนวนมากอาจทำให้ Switchover ใช้เวลานาน) - Log Out ทุก
sqlplusSessions ที่ Connect assys - Run SQL Queries ใน Current Primary DB:
set linesize to 132 col value format a35 SELECT inst_id,name,value from gv$parameter WHERE name in ('job_queue_processes','aq_tm_processes'); (Check ค่าเป็น 0) - Run Command Validate Data Guard Configuration:
DGMGRL> show configuration verbose ** STATUS Should show success, do not proceed if not "success". - Check Cluster Ready Services (CRS) Status ทุก Resources Registered Online เพราะ Broker Handover ให้ CRS Mount/Shutdown DB ระหว่าง Process
- Switchover A Few Logs บน Primary DB และ Verify Applied บน Standby DB
- Before Proceeding Perform Switchover และ Monitor DRC Log และ Alert Log สำหรับ Failures Command ต่อไป Convert Old Primary เป็น Standby แล้ว Old Standby เป็น Primary:
DGMGRL> switchover to 'DDMPROD_STANDBY'; - After Switchover Complete Ensure Log Transport และ Log Apply Services Up และ Functioning Properly
Failover Testing Scenarios สำหรับ MVDC
Failover = Primary DB (All Instances ของ RAC Primary) Fail และ Standby DB Transition มารับ Role Primary Failover ทำในกรณี:
- Catastrophic Failure ของ Primary DB ไม่มีโอกาส Recover ใน Timely Manner
- เมื่อ Observer และ Standby DB ทั้งคู่ Lost Network Connection ไป Primary DB และ Standby DB Confirm ว่าอยู่ใน State Synchronized
Failover Scenarios
DB Conditions ที่ Trigger Fast-Start Failover:
- Primary Site Failure
- Primary DB Conditions:
- Instance Failure
- Last Surviving Instance (ถ้า RAC)
- Shutdown Abort ของ Last Available Instance
- Data Files Taken Offline เนื่องจาก I/O Errors (Threshold Ignored เมื่อ Failover เนื่องจาก Offline Data Files)
Network-related Conditions อาจ Cause Failover ก็ต่อเมื่อ Links ระหว่าง Primary-Observer และ Primary-Target Standby DBs Down Connection ระหว่าง Observer-Standby จำเป็นเพื่อ Observer Confirm Config ใน Synchronized State
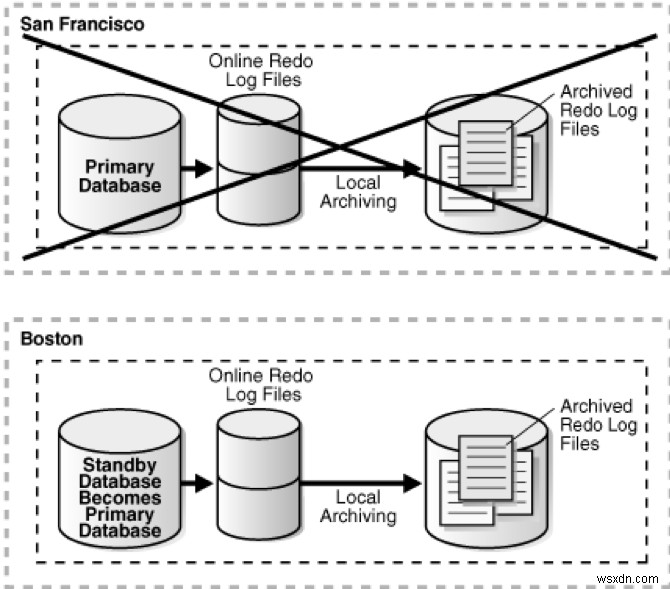
Image source: https://docs.oracle.com/cd/E11882_01/server.112/e41134/role_management.htm#SBYDB00615
สรุป
MVDC ช่วย Efficient Resource Usage, Load Balancing, High Availability, และ Automatic Switchover ระหว่าง 2 DCs ทั้งสอง DCs Run Concurrently (Active-Active) Share Service Loads Improve Overall Service Capability MVDC ลด Human Intervention ในการ Switch ระหว่าง Databases สำหรับ DR Failovers หรือ Upgrade/Maintenance Switchovers
ใช้แท็บ Feedback เพื่อแสดงความคิดเห็นหรือถามคำถาม
เพิ่มประสิทธิภาพสภาพแวดล้อมด้วยบริการผู้เชี่ยวชาญ
ผู้เชี่ยวชาญ Rackspace Application Services (RAS) ให้บริการ Professional และ Managed Services ครอบคลุม Portfolio หลากหลาย:
- Platform สำหรับ eCommerce และ Digital Experience
- Enterprise Resource Planning (ERP)
- Business Intelligence
- Salesforce Customer Relationship Management (CRM)
- Databases
- Email Hosting และ Productivity
เรามอบ:
- Unbiased Expertise: ลดความซับซ้อนและนำทางการ Modernization เน้นความสามารถที่สร้างคุณค่าทันที
- Fanatical Experience™: รวมแนวทาง Process First. Technology Second.® พร้อม Technical Support ให้ Soluation ครบวงจร
- Unrivaled Portfolio: ประยุกต์ประสบการณ์ Cloud มากมายช่วยเลือกและ Deploy เทคโนโลยีที่เหมาะสมบน Cloud ที่เหมาะสม
- Agile Delivery: ตรงจุดที่คุณอยู่ในการเดินทางและทำให้ความสำเร็จของเราสอดคล้องกับคุณ
แชทตอนนี้เพื่อเริ่มต้น
