

บทนำ
Standby database คือสำเนาที่สอดคล้องกันของ production database ซึ่งช่วยในกรณีเกิดภัยพิบัติ สูญหายข้อมูล หรือการเสียหายของ production
บทนำ
เหตุผลต่อไปนี้อาจเป็นสาเหตุของ lag ระหว่าง primary และ standby site:
- ปัญหา bandwidth เครือข่ายระหว่าง primary และ standby databases
- Standby database ไม่พร้อมใช้งาน
- การลบ archive redo data บน primary database โดยไม่ได้ตั้งใจ
คุณสามารถซิงค์ primary และ standby environments โดยการคัดลอกและนำ archive logs จาก primary site ไป apply แต่กระบวนการนี้ใช้เวลานานมาก
อีกทางหนึ่งคือกู้คืน standby site โดยใช้ incremental RMAN backup ของ primary site คุณยังสามารถใช้วิธีนี้เมื่อมี missing archived logs บน primary ที่ระบบไม่เคยนำไป apply ที่ standby database
ขั้นตอนการกู้คืน Physical Standby Database ด้วย Incremental RMAN Backup
เพื่อตั้งค่าสถานการณ์นี้ ผมลบ archive logs บางส่วนจาก primary site เพื่อจำลอง corrupt logs หรือ missing logs
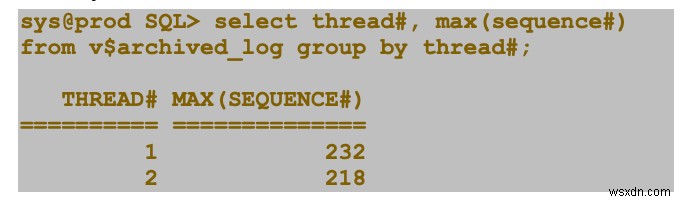
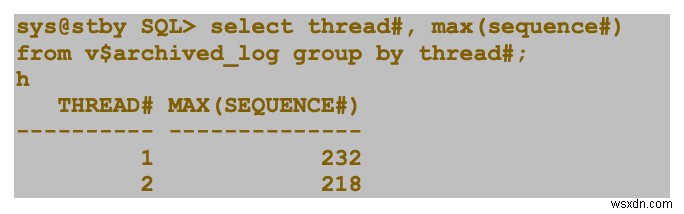
ขั้นตอนที่ 1: ตรวจสอบสถานะซิงค์ของ primary และ standby site
คุณต้องดูสถานะซิงค์ระหว่าง primary (prod) และ standby (stby) ให้รวดเร็ว
Primary site:
Standby site:
ขั้นตอนที่ 2: จำลองช่องว่างระหว่าง primary และ standby
คุณต้องล็อกอินไปที่ primary database และเปลี่ยน LOG_ARCHIVE_DEST_STATE_2 เป็น DEFER จากนั้นทำ manual log switches เพื่อสร้าง archive logs บ้าง จึงทำให้เกิด gap ระหว่าง primary และ standby:
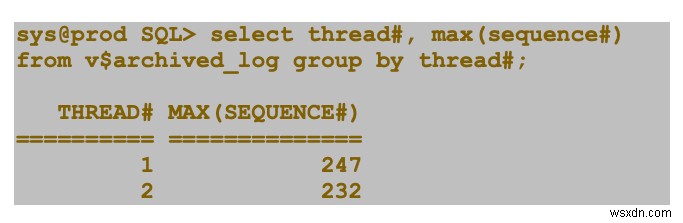
ตอนนี้ หาก你看 CURRENT_SCN ระหว่าง primary และ standby จะเห็นว่า standby ไม่ catch up เพราะคุณปิด sync ด้วยตนเอง
Primary site:
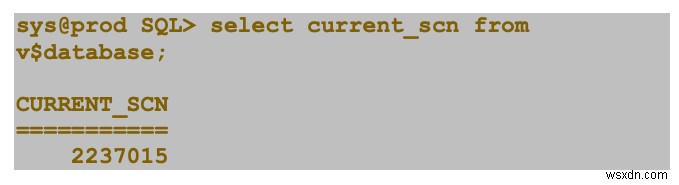
Standby site:
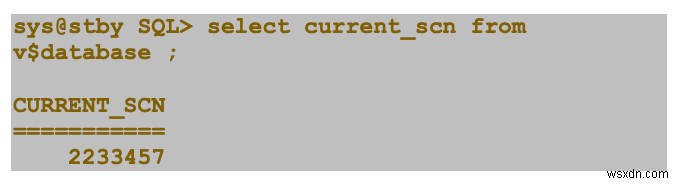
หากคุณ re-enable LOG_ARCHIVE_DEST_STATE_2 ตอนนี้ standby จะ catch up เองโดยอัตโนมัติ แต่คุณไม่ควรทำตัวเลือกนั้นทันที เพื่อสร้างการจำลอง gap คุณต้องลบ archive logs ด้วยตนเองจาก primary site
ตรวจสอบให้แน่ใจว่าในทั้งสอง site ไม่มี archive logs หลังจาก 232 และ 218 สำหรับ threads 1 และ 2 ตามลำดับ
ตอนนี้ คุณต้อง re-enable LOG_ARCHIVE_DEST_STATE_2 (ตั้งเป็น ENABLE):
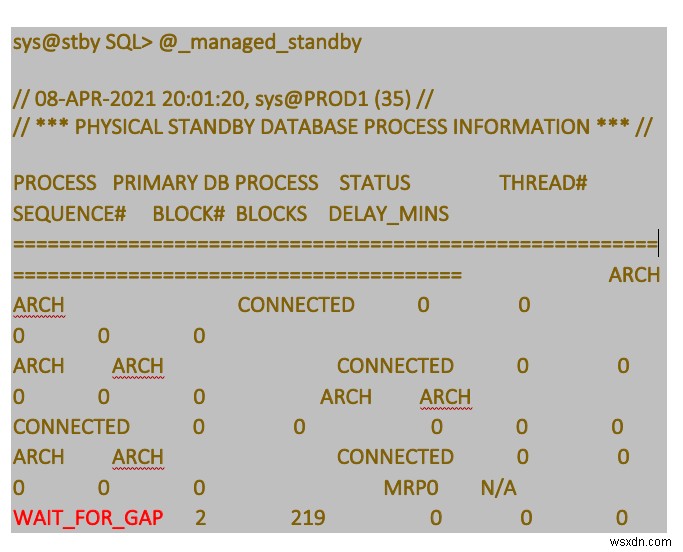
ตามที่คาดไว้ standby ไม่สามารถต่อยอด apply logs ได้ เพราะบาง logs หายไปจาก primary site
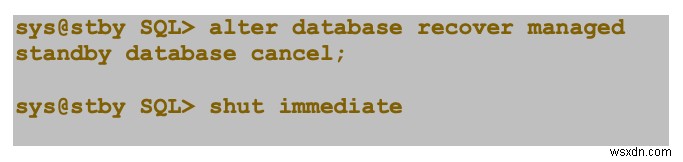
สุดท้าย ยกเลิก recovery และปิด standby instance:
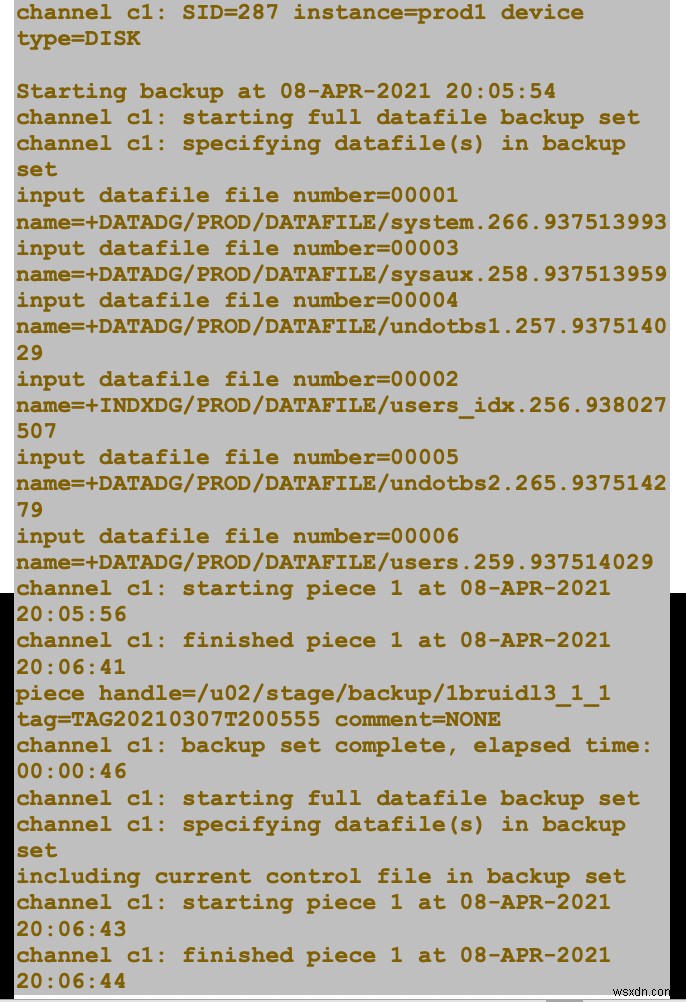
ขั้นตอนที่ 3: Incremental Backup
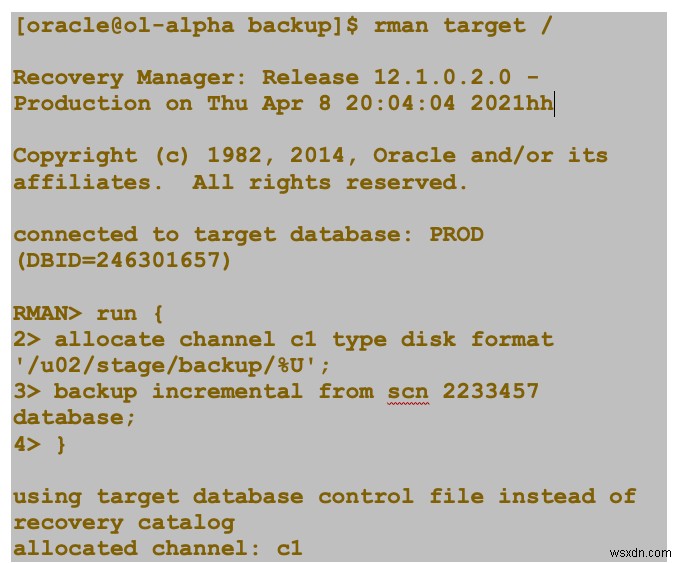
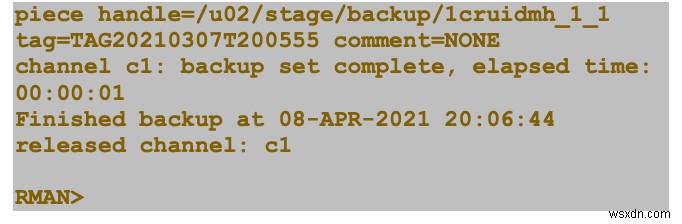
ล็อกอินไปที่ primary และทำ incremental backup จาก SCN ล่าสุดที่ applied ที่ standby:
ขั้นตอนที่ 4: สำรอง Standby Control File
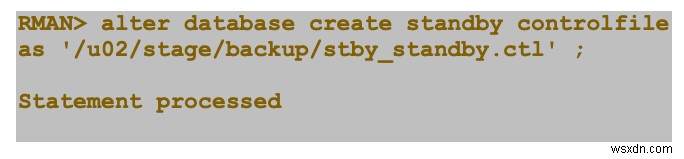
ตอนนี้ สำรอง control file บน standby site:
ขั้นตอนที่ 5: ส่ง backups ไปยัง standby site
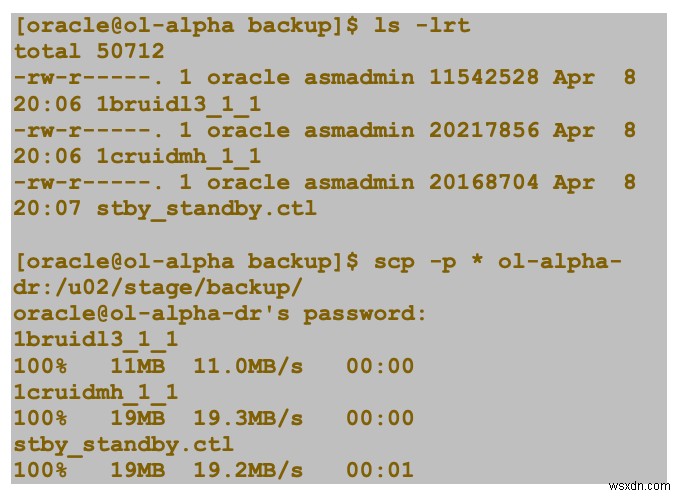
โอน incremental backup ที่เพิ่งทำไปยัง standby site:
ขั้นตอนที่ 6: กู้คืน Standby Control File
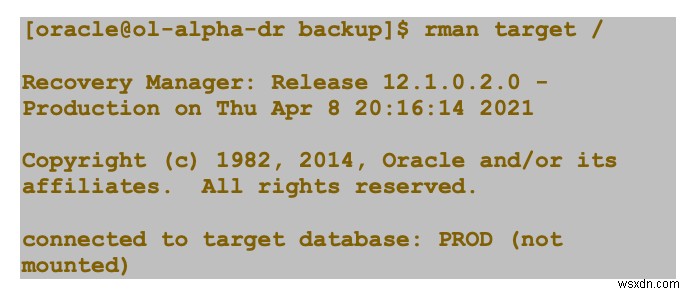
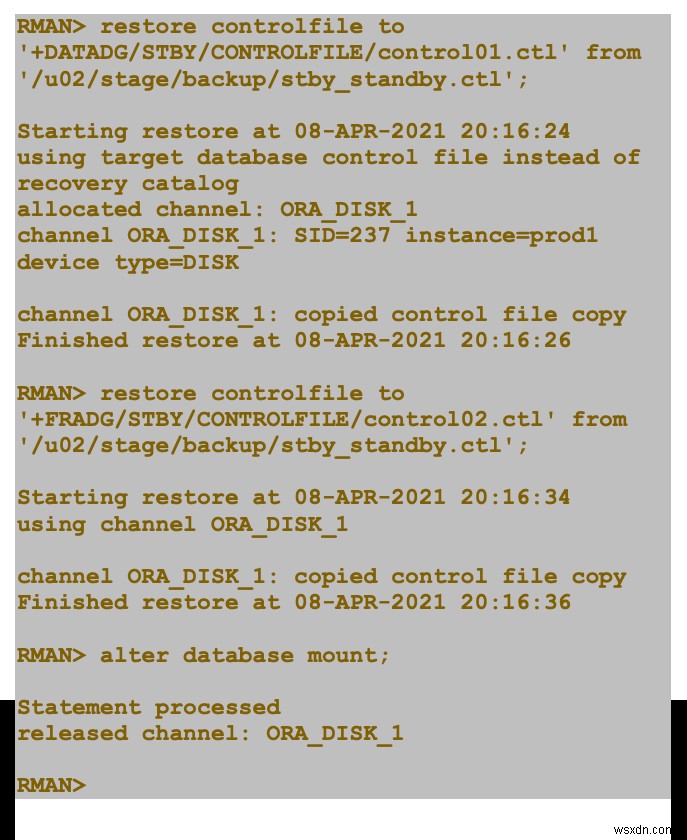
กู้คืน control file บน standby site:
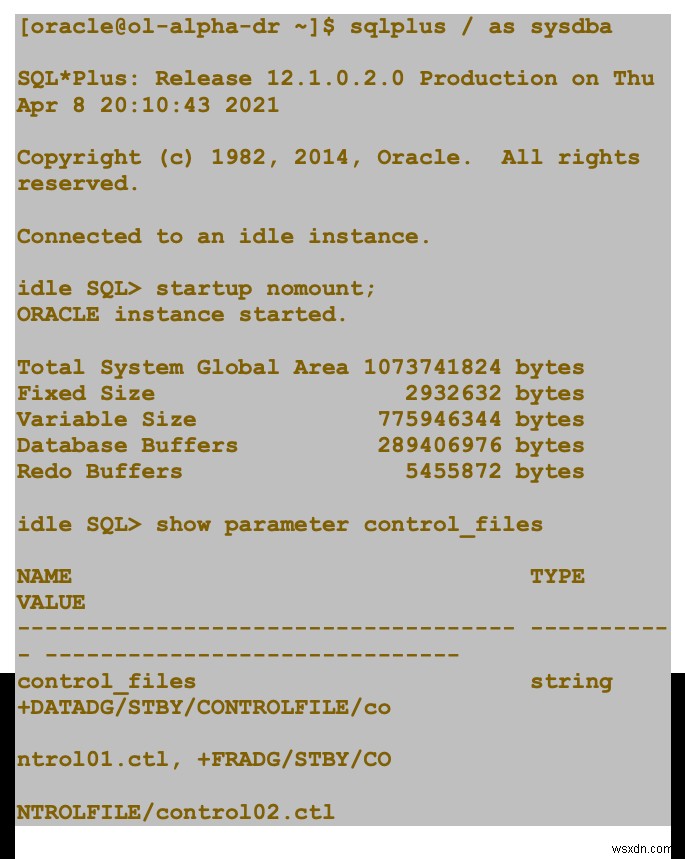
หมายเหตุ: ตรวจสอบให้แน่ใจว่าคุณลบ control files เก่าออกด้วยตนเองก่อนรันคำสั่งข้างต้น เพื่อยืนยันว่าคุณใช้ control files ใหม่
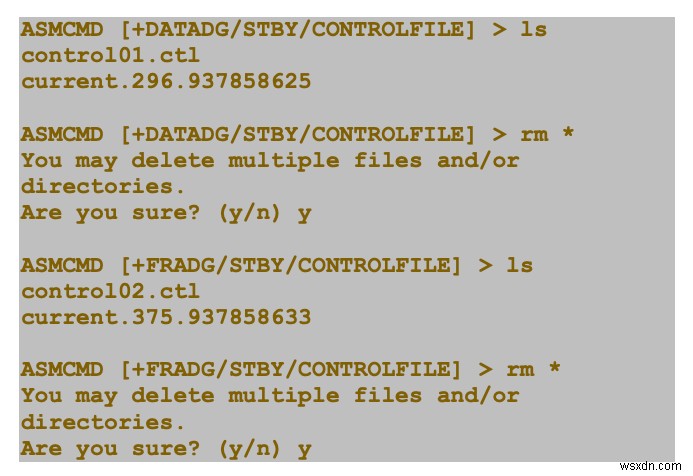
ล็อกอินเป็น grid user และลบ control files เก่า:
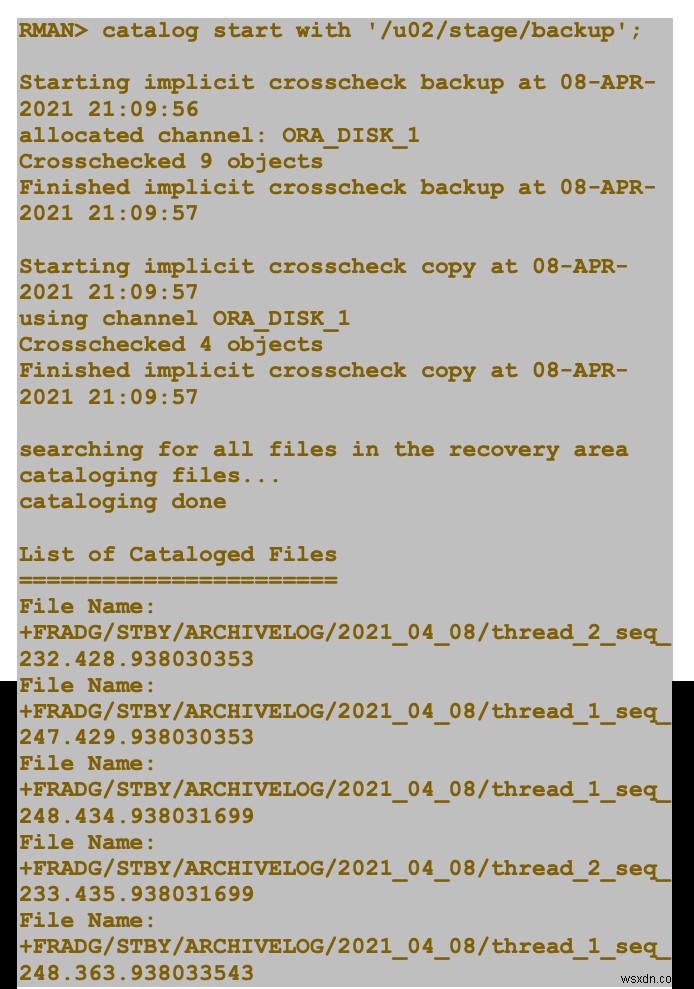
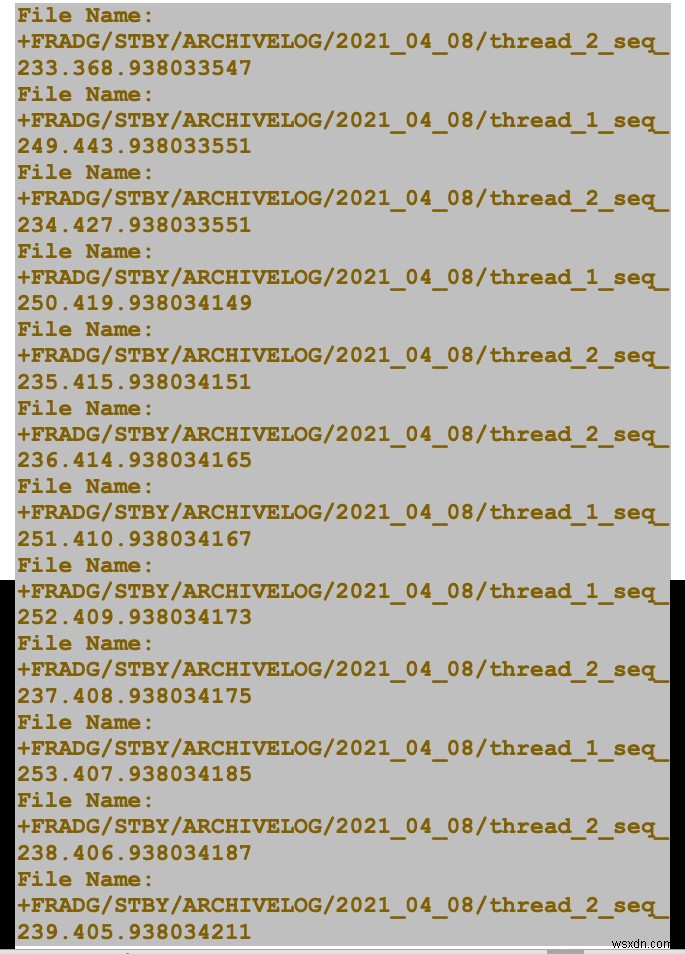
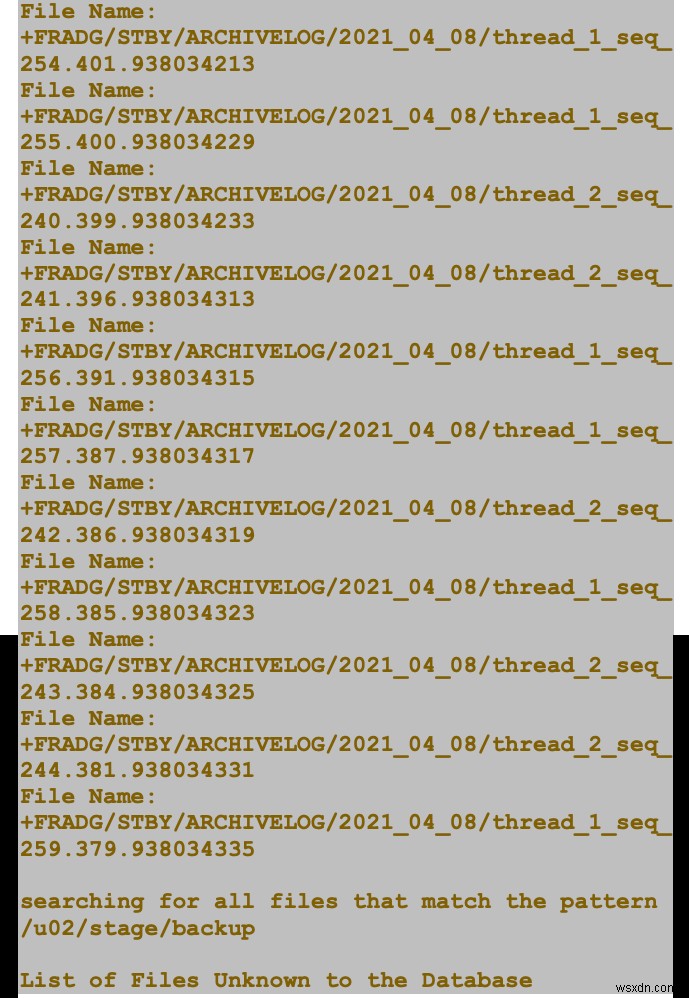
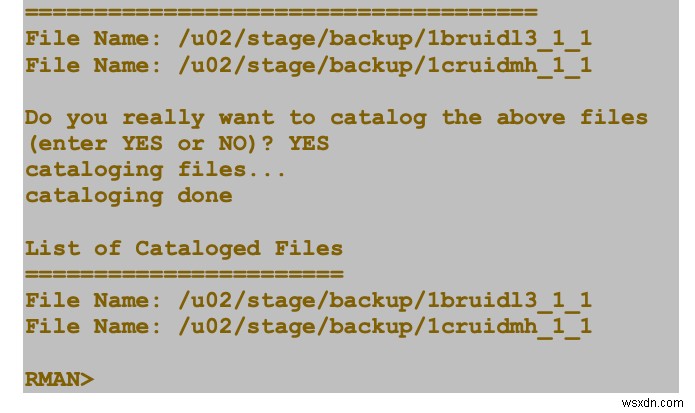
ขั้นตอนที่ 7: Catalog Backup Pieces
ตอนนี้ catalog กระบวนการ backup:
ขั้นตอนที่ 8: Catalog Existing Data Files
นอกจากนี้ ให้ catalog data files ที่มีอยู่:
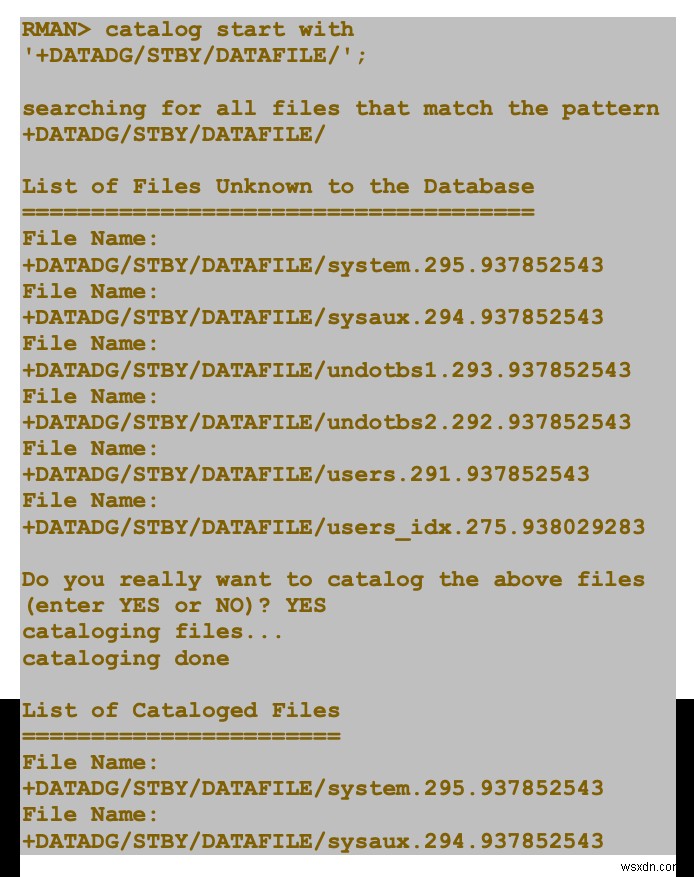
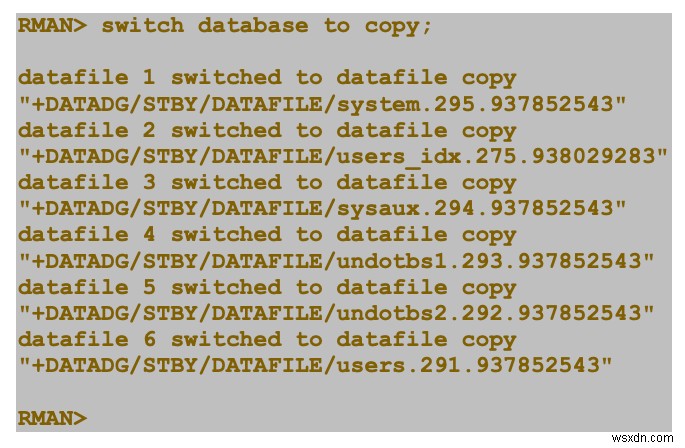
ขั้นตอนที่ 9: Switch Existing Data Files
สลับ data files ที่มีอยู่ทั้งหมดไปยัง image copies ของพวกเขา:
ขั้นตอนที่ 10: กู้คืนฐานข้อมูล
ตอนนี้ กู้คืนฐานข้อมูลของคุณ:
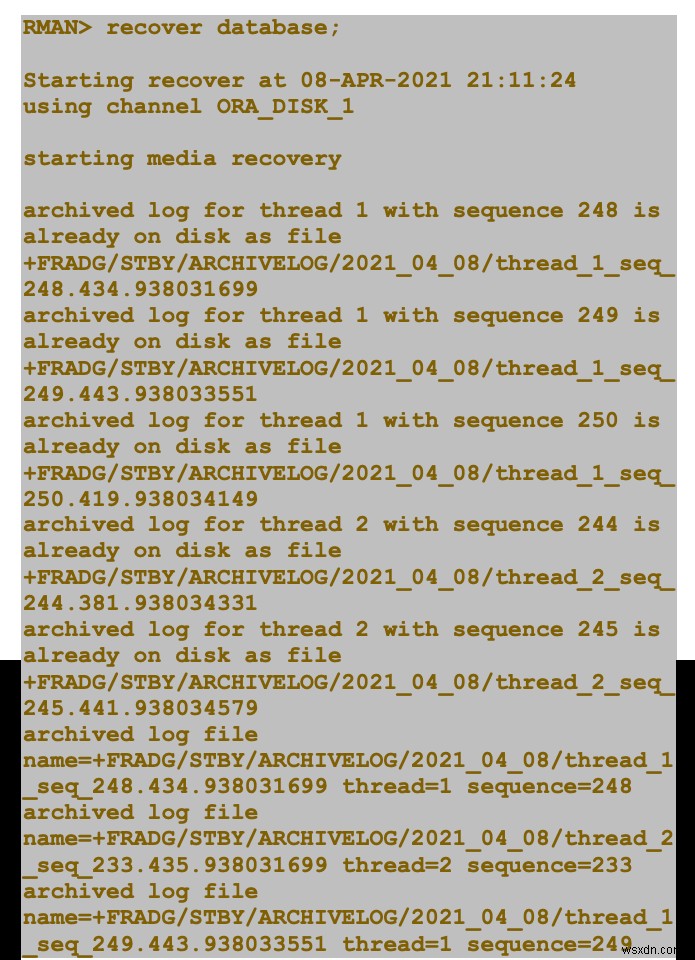
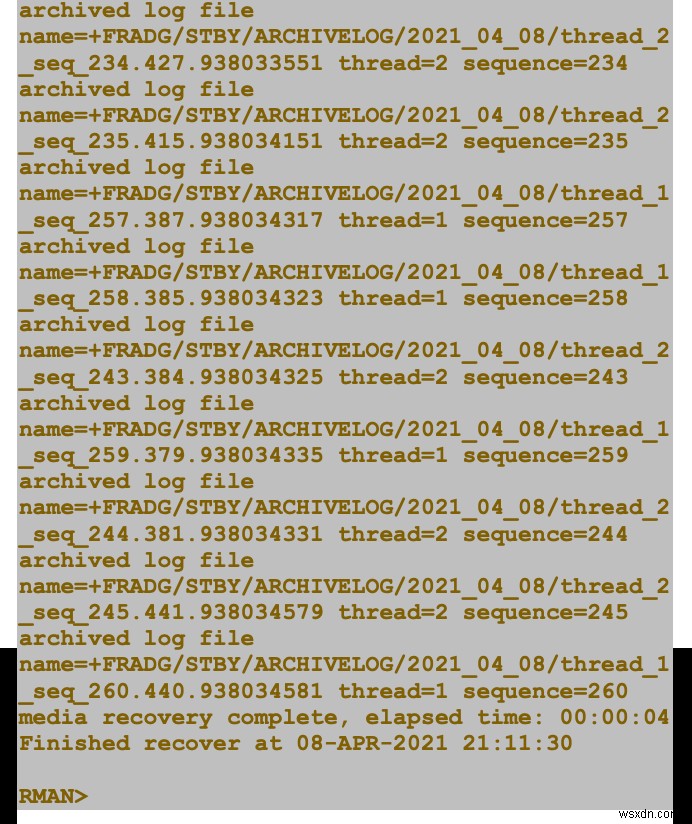
ขั้นตอนนี้จบการ refresh standby มีอีกไม่กี่ขั้นตอน!
ขั้นตอนที่ 11: ตรวจสอบสถานะซิงค์
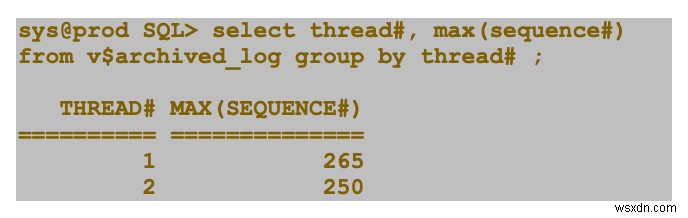
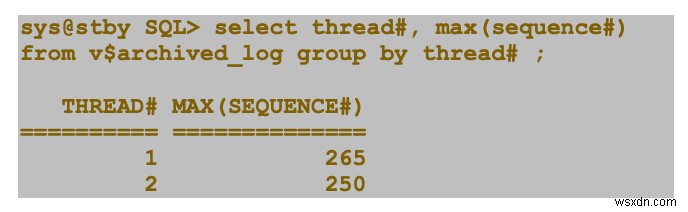
ดู sequences ทั้งสอง site อย่างรวดเร็ว สังเกตว่า standby catch up กับ primary แล้ว:
Primary site:
Standby site:
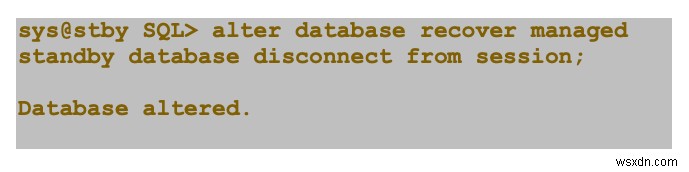
ขั้นตอนที่ 12: เริ่ม Media Recovery
เริ่ม media recovery บน standby site:
สรุป
ด้วยขั้นตอนที่กล่าวมาข้างต้น คุณสามารถกู้คืน standby site ได้ การใช้ incremental backup ของ production environment ช่วยประหยัดเวลาอย่างมาก
เรียนรู้เพิ่มเติมเกี่ยวกับบริการฐานข้อมูลของเรา
ใช้แท็บ Feedback เพื่อแสดงความคิดเห็นหรือถามคำถาม คุณยังสามารถเริ่มสนทนากับเราได้
