

“ความเรียบง่ายคือความเชี่ยวชาญสูงสุด”—Leonardo da Vinci
“ข้อมูลส่วนใหญ่ไม่เกี่ยวข้อง และความพยายามส่วนใหญ่ถูกว่างเปล่า แต่เพียงผู้เชี่ยวชาญเท่านั้นที่รู้ว่าควรละเว้นอะไร”—James Clear, Atomic Habits
คุณมีไปป์ไลน์ข้อมูลที่หรูหรา มีระบบหลายระบบ มันดูซับซ้อนและทันสมัยบนผิว แต่จริงๆ แล้วมันเป็นความสับสนที่ซับซ้อนใต้ฝ้า มันอาจต้องการงานประปามากมายเพื่อเชื่อมต่อชิ้นส่วนต่างๆ อาจต้องการการตรวจสอบตลอดเวลา อาจต้องการทีมใหญ่ที่มีความเชี่ยวชาญเฉพาะตัวเพื่อรัน ดีบั๊ก และจัดการ ไม่ต้องพูดถึง ยิ่งใช้ระบบมากเท่าไหร่ ยิ่งมีที่จัดเก็บข้อมูลซ้ำมากเท่านั้น และโอกาสที่ข้อมูลจะ out-of-sync หรือ stale เพิ่มขึ้นอีกด้วย อีกทั้ง เนื่องจากแต่ละระบบย่อยพัฒนาโดยอิสระโดยบริษัทต่างกัน การอัปเกรดหรือแก้บั๊กของพวกเขาอาจทำลายไปป์ไลน์และเลเยอร์ข้อมูลของคุณ
ถ้าคุณไม่ระวัง คุณอาจจบลงกับสถานการณ์ดังวิดีโอ 3 นาทีด้านล่าง แนะนำให้ดูก่อนดำเนินต่อ
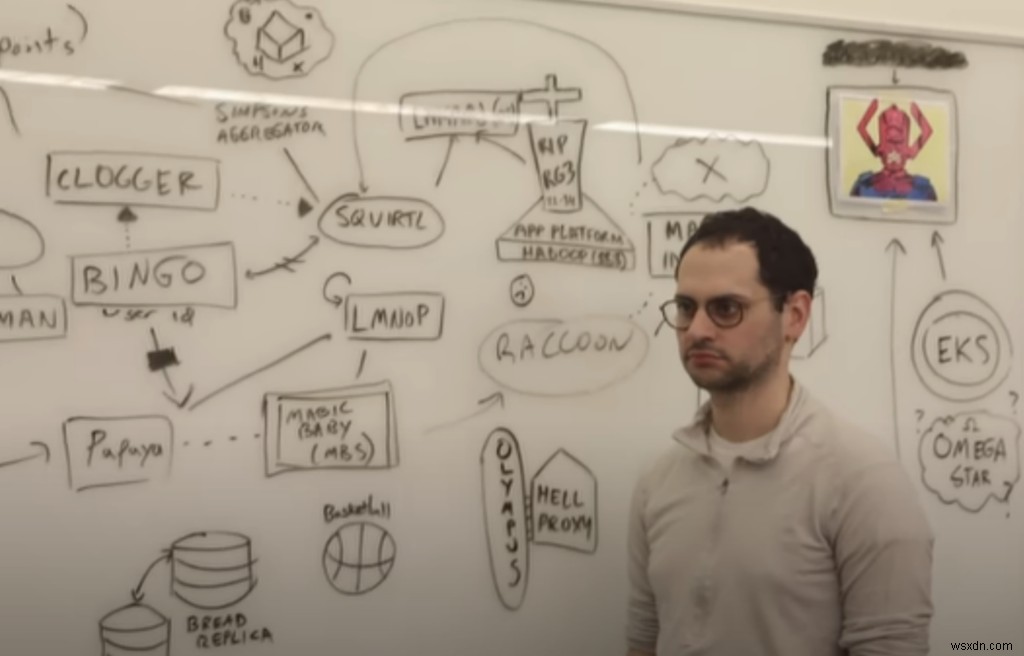
ความซับซ้อนเกิดขึ้นเพราะแม้แต่ละระบบอาจดูเรียบง่ายบนผิว แต่จริงๆ แล้วนำตัวแปรเหล่านี้เข้าสู่ไปป์ไลน์ของคุณและอาจเพิ่มความซับซ้อนเป็นจำนวนมาก:
- โปรโตคอล—ระบบขนส่งข้อมูลอย่างไร? (HTTP, TCP, REST, GraphQL, FTP, JDBC)
- รูปแบบข้อมูล—ระบบรองรับรูปแบบไหน? (Binary, CSV, JSON, Avro)
- สคีม่าข้อมูลและวิวัฒนาการ—ข้อมูลจัดเก็บอย่างไร? (ตาราง, Streams, กราฟ, เอกสาร)
- SDK และ API—ระบบมี SDK และ API ที่จำเป็นไหม?
- ACID และ BASE—ให้ความสอดคล้อง ACID หรือ BASE?
- การย้ายถิ่นฐาน—ระบบให้วิธีย้ายข้อมูลเข้า/ออกง่ายไหม?
- ความทนทาน—ระบบมีการรับประกันเรื่องความทนทานอย่างไร?
- ความพร้อมใช้งาน—ระบบมีการรับประกันเรื่อง availability อย่างไร? (99.9%, 99.999%)
- ความสามารถในการขยายตัว—มัน scale อย่างไร?
- ความปลอดภัย—ระบบปลอดภัยแค่ไหน?
- ประสิทธิภาพ—ระบบเร็วแค่ไหนในการประมวลผลข้อมูล?
- ตัวเลือกโฮสติ้ง—โฮสต์หรือ on-premise เท่านั้น หรือผสม?
- คลาวด—ทำงานบนคลาวดของฉัน ได้ไหม? ภูมิภาค ไหน?
- ระบบเพิ่มเติม—ต้องการระบบเพิ่มเติมไหม? (เช่น Zookeeper สำหรับ Kafka)
ตัวแปรอย่างรูปแบบข้อมูล สคีม่า และโปรโตคอล รวมกันเป็นสิ่งที่เรียกว่า "transformational overhead" (ค่าใช้จ่ายในการแปลง) ตัวแปรอื่นๆ เช่น ประสิทธิภาพ ความทนทาน และความสามารถในการขยายตัว รวมกันเป็น "pipeline overhead" (ค่าใช้จ่ายของไปป์ไลน์) รวมกันแล้ว การจัดประเภทเหล่านี้มีส่วนทำให้เกิดสิ่งที่เรียกว่า "impedance mismatch" (ความไม่เข้ากันของอิมพิแดนซ์) ถ้าเราวัดได้ เราสามารถคำนวณความซับซ้อนและใช้มันทำให้ระบบเรียบง่ายขึ้น เราจะไปถึงที่นั่นในไม่ช้า
ตอนนี้คุณอาจโต้แย้งว่าระบบของคุณแม้ดูซับซ้อน แต่จริงๆ แล้วเป็นระบบที่เรียบง่ายที่สุดสำหรับความต้องการของคุณ แต่คุณจะพิสูจน์ได้อย่างไร?
กล่าวอีกนัยหนึ่ง คุณจะวัดและบอกได้จริงอย่างไรว่าเลเยอร์ข้อมูลของคุณเรียบง่ายหรือซับซ้อนจริง? และสอง คุณจะประมาณการได้อย่างไรว่าระบบของคุณจะยังคงเรียบง่ายเมื่อคุณเพิ่มฟีเจอร์มากขึ้น? นั่นคือ ถ้าคุณเพิ่มฟีเจอร์ใน roadmap คุณต้องเพิ่มระบบด้วยไหม?
นั่นคือที่มาของ "impedance mismatch test" (การทดสอบ impedance mismatch) แต่มาดูก่อนว่า impedance mismatch คืออะไร แล้วค่อยไปสู่การทดสอบ
Impedance Mismatch คืออะไร?
คำศัพท์นี้มาจากวิศวกรรมไฟฟ้า เพื่ออธิบายความไม่เข้ากันของอิมพิแดนซ์ไฟฟ้า ทำให้สูญเสียพลังงานเมื่อถ่ายโอนพลังงานจากจุด A ไป B
พูดง่ายๆ คือ สิ่งที่คุณมีไม่ตรงกับสิ่งที่คุณต้องการ เพื่อใช้มัน คุณต้องนำสิ่งที่มีอยู่ แปลงเป็นสิ่งที่ต้องการ แล้วค่อยใช้ ดังนั้นจึงมีความไม่เข้ากันและค่าใช้จ่าย (overhead) ที่เกี่ยวข้องกับการแก้ไขความไม่เข้ากัน
ในกรณีของเรา คุณมีข้อมูลในรูปแบบหรือปริมาณบางอย่าง และต้องแปลงมันก่อนที่จะใช้ได้ การแปลงอาจเกิดหลายครั้ง และอาจใช้หลายระบบระหว่างทาง
ในโลกฐานข้อมูล impedance mismatch เกิดขึ้น 2 เหตุผล:
- Transformational overhead (ค่าใช้จ่ายในการแปลง): วิธีที่ระบบประมวลผลหรือจัดเก็บข้อมูลแตกต่างจากรูปแบบข้อมูลจริง หรือวิธีที่คุณคิดถึงมัน ตัวอย่าง: ในเซิร์ฟเวอร์ คุณมีความยืดหยุ่นจัดเก็บข้อมูลในโครงสร้างข้อมูลมากมาย เช่น collections, streams, Lists, Sets, Arrays ฯลฯ ช่วยสร้างแบบจำลองข้อมูลตามธรรมชาติ แต่คุณต้องแมปข้อมูลนี้เข้าไปในตารางใน RDBMS หรือ JSON document stores เพื่อจัดเก็บ แล้วทำตรงข้ามสำหรับการอ่าน ข้อไม่เข้ากันเฉพาะระหว่างโมเดลภาษาเชิงวัตถุและโมเดลตารางเชิงสัมพันธ์ เรียกว่า "Object-relational impedance mismatch"
- Pipeline overhead (ค่าใช้จ่ายของไปป์ไลน์): ปริมาณและประเภทข้อมูลที่คุณประมวลผลในเซิร์ฟเวอร์ แตกต่างจากสิ่งที่ฐานข้อมูลของคุณจัดการได้ ตัวอย่าง: ถ้าคุณประมวลผลล้านๆ เหตุการณ์จากมือถือ RDBMS หรือ document store ทั่วไปอาจจัดเก็บไม่ได้ หรือไม่มี API สำหรับ aggregate หรือคำนวณเหล่านั้นง่ายๆ ดังนั้นคุณต้องการระบบประมวลผลสตรีมพิเศษ เช่น Kafka หรือ Redis Streams เพื่อประมวลผล และอาจต้องการ data warehouse เพื่อจัดเก็บ
การทดสอบ Impedance Mismatch
เป้าหมายของการทดสอบคือวัดความซับซ้อนของแพลตฟอร์มโดยรวม และว่าความซับซ้อนเพิ่มหรือลดเมื่อคุณเพิ่มฟีเจอร์ในอนาคต
วิธีการทดสอบคือคำนวณ "transformational overhead" และ "pipeline overhead" โดยใช้ "Impedance Mismatch Score" (IMS) นี่จะบอกว่าระบบของคุณซับซ้อนสัมพัทธ์กับระบบอื่นๆ หรือไม่ และว่าความซับซ้อนนั้นเติบโตตามเวลาเมื่อเพิ่มฟีเจอร์หรือไม่
สูตรคำนวณ IMS:

สูตรเพียงแค่รวม overhead ทั้งสองประเภท แล้วหารด้วยจำนวนฟีเจอร์ ดังนั้นคุณจะได้ overhead ต่อฟีเจอร์ทั้งหมด (คะแนนความซับซ้อน)
เพื่อเข้าใจดีขึ้น มาเปรียบเทียบไปป์ไลน์ข้อมูล 4 แบบง่ายๆ และคำนวณคะแนน และจินตนาการว่าสร้างแอปง่ายๆ ใน 2 ระยะ เพื่อดูว่าคะแนน IMS เปลี่ยนแปลงอย่างไรเมื่อเพิ่มฟีเจอร์
ระยะที่ 1: สร้างแดชบอร์ดเรียลไทม์
สมมติคุณได้รับเหตุการณ์คลิกปุ่มล้านๆ จากมือถือ และต้องการแจ้งเตือนถ้ามีการลดหรือเพิ่มขึ้น นอกจากนี้ คุณมองว่าทั้งหมดนี้เป็นฟีเจอร์หนึ่งของแอปพลิเคชันที่ใหญ่กว่า
กรณี 1: สมมติคุณใช้ RDBMS เพียงอย่างเดียวจัดเก็บเหตุการณ์เหล่านี้ แม้ตารางอาจไม่เหมาะสม
- Transformational overhead = 1
- คุณต้องแปลง event streams เป็นตาราง
- Pipeline overhead = 1
- คุณมี DB เดียวในไปป์ไลน์
- จำนวนฟีเจอร์ = 1
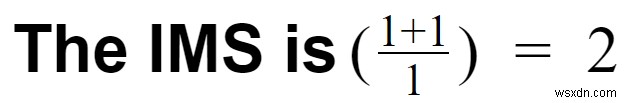
กรณี 2: สมมติคุณใช้ Kafka ประมวลผลเหตุการณ์ แล้วจัดเก็บใน RDBMS
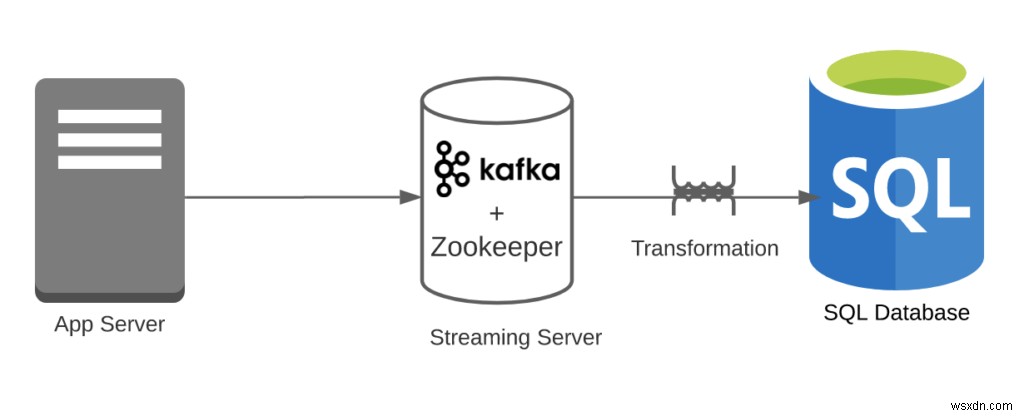
- Transformational overhead = 1
- Kafka จัดการ click streams ได้ง่าย แต่ Kafka ไป RDBMS เป็น overhead
- Pipeline overhead = 2
- คุณมี 2 ระบบ (RDBMS และ Kafka) หมายเหตุ: เราไม่ได้นับ Zookeeper
- จำนวนฟีเจอร์ = 1
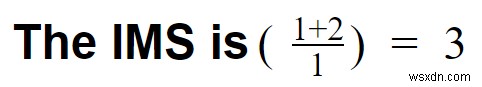
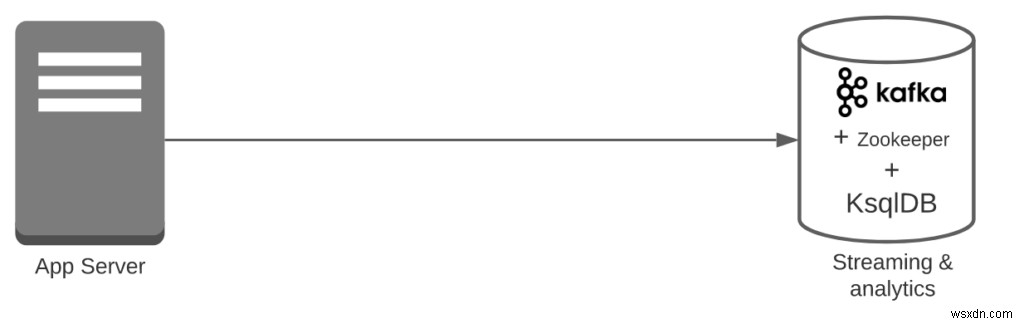
กรณี 3: สมมติคุณใช้ Kafka ประมวลผลเหตุการณ์ แล้วจัดเก็บใน KsqlDB
- Transformational overhead = 0
- Kafka จัดการ click streams ได้ง่าย
- Pipeline overhead = 1
- คุณมีเพียง 1 ระบบ (Kafka + KSqlDB) หมายเหตุ: เราไม่ได้นับ Zookeeper
- จำนวนฟีเจอร์ = 1
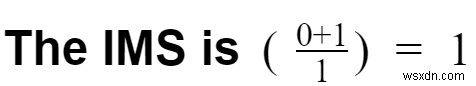
กรณี 4: สมมติคุณใช้ Redis Streams ประมวลผลเหตุการณ์ แล้วจัดเก็บใน RedisTimeseries (ทั้งคู่เป็นส่วนหนึ่งของ Redis และทำงาน native กับ Redis)
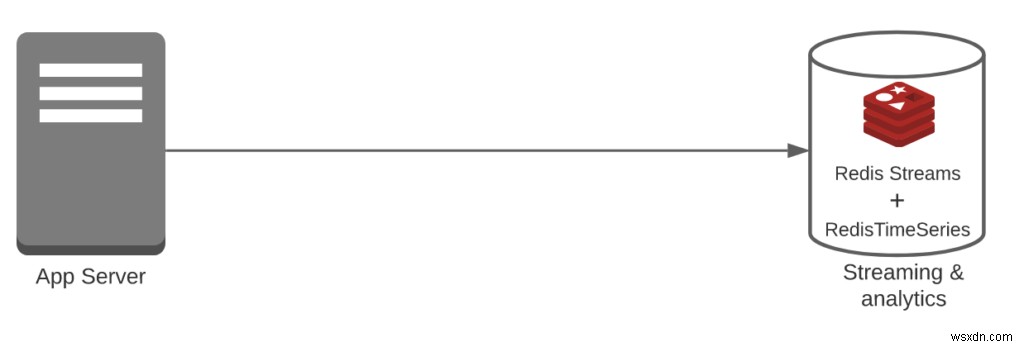
- Transformational overhead = 0
- Redis Streams จัดการ click streams ได้ง่าย
- Pipeline overhead = 1
- คุณมีเพียง 1 ระบบ (Redis Streams + RedisTimeSeries)
- จำนวนฟีเจอร์ = 1
สรุปหลังระยะที่ 1:
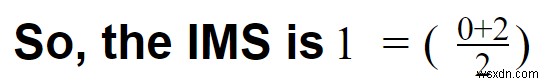
เราเปรียบเทียบ 4 ระบบ และพบว่า "กรณี 3" หรือ "กรณี 4" เรียบง่ายที่สุดด้วย IMS = 1 ณ จุดนี้ทั้งคู่เท่ากัน แต่จะคงอยู่เหมือนกันเมื่อเพิ่มฟีเจอร์ไหม?
มาเพิ่มฟีเจอร์และดูว่า IMS ทนได้ไหม
ระยะที่ 2: สร้างแดชบอร์ดเรียลไทม์พร้อม IP-Whitelisting
สมมติสร้างแอปเดียวกันแต่อยากให้มั่นใจว่ามาจาก IP ที่ whitelist เท่านั้น ตอนนี้เพิ่มฟีเจอร์ใหม่
กรณี 1: ใช้ RDBMS จัดเก็บเหตุการณ์ แม้ตารางไม่เหมาะสม และใช้ Redis หรือ MemCached สำหรับ IP-whitelisting
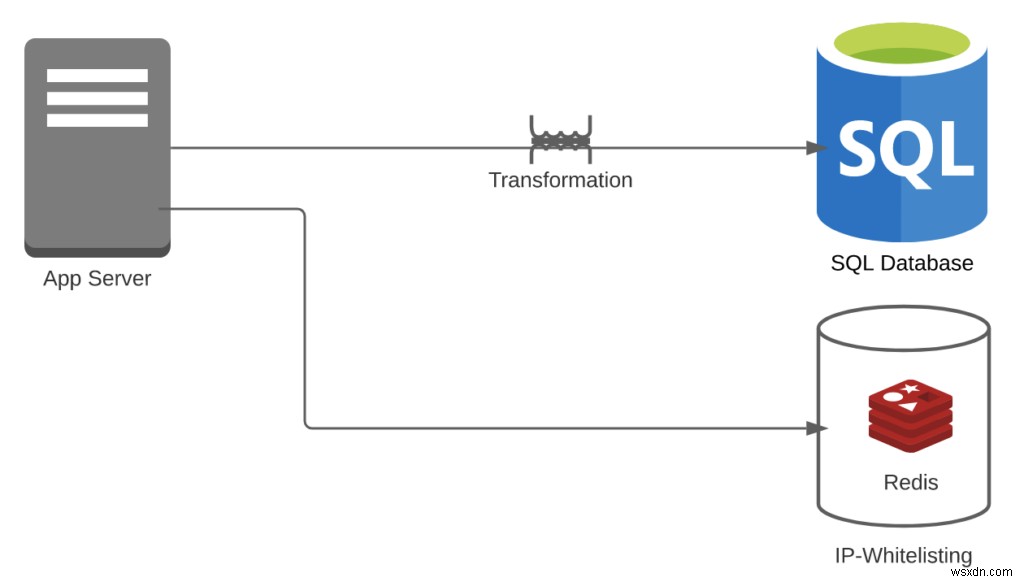
- Transformational overhead = 1
- สำหรับ IP-whitelisting ไม่ต้องแปลง แต่ต้องแปลง event streams เป็นตาราง
- Pipeline overhead = 2
- คุณมี Redis + RDBMS
- จำนวนฟีเจอร์ = 2
กรณี 2: ใช้ Redis + Kafka + RDBMS
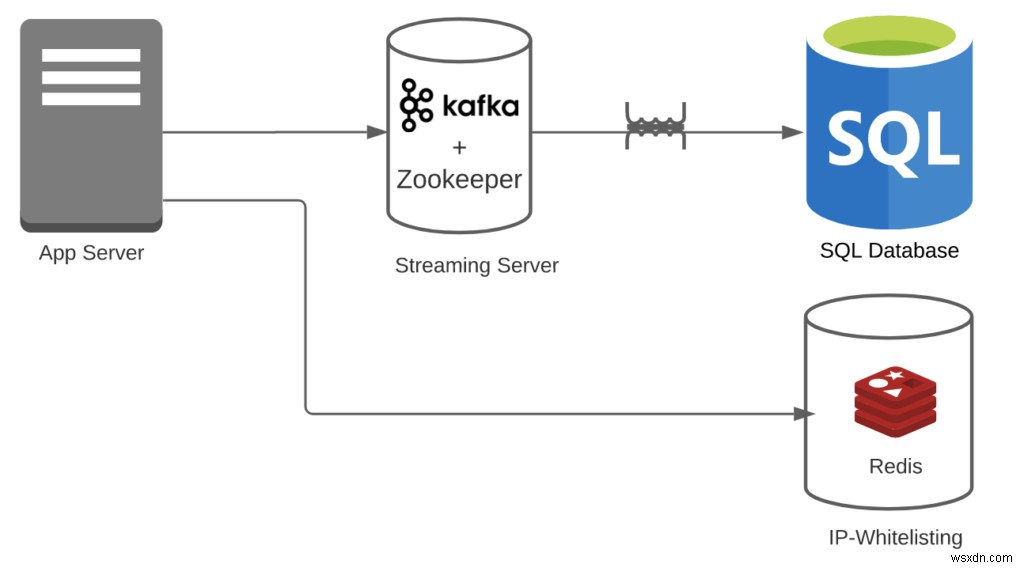
- Transformational overhead = 1
- สำหรับ IP-whitelisting ไม่ต้องแปลง Kafka จัดการ streams ได้ง่าย
- Pipeline overhead = 3
- คุณมี Redis + Kafka + RDBMS หมายเหตุ: เราไม่ได้นับว่า Kafka ต้องการ Zookeeper ถ้านับคะแนนจะแย่ลง
- จำนวนฟีเจอร์ = 2
กรณี 3: ใช้ Redis + Kafka + KsqlDB
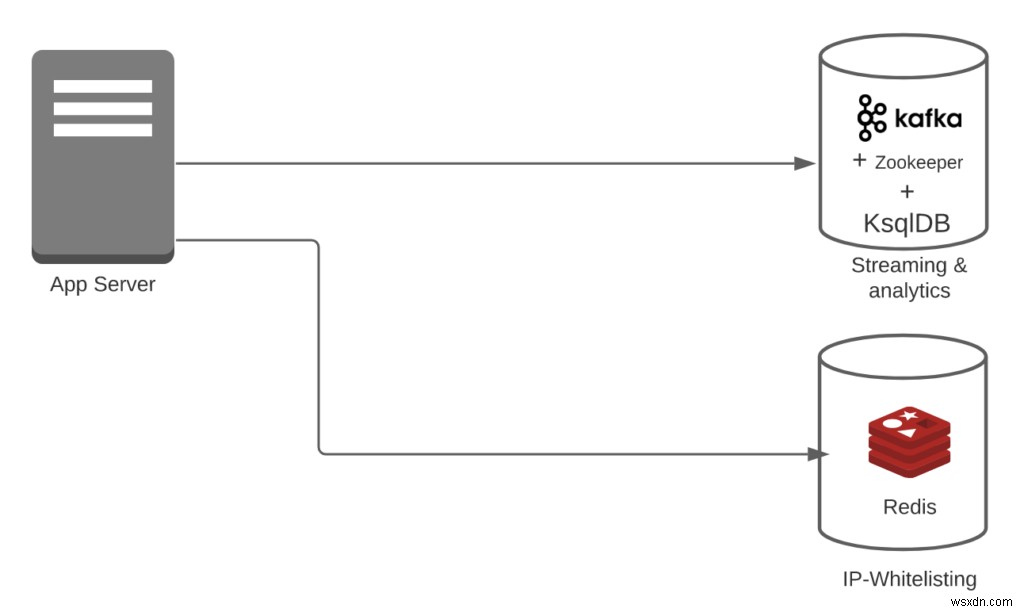
- Transformational overhead = 0
- สำหรับ IP-whitelisting ไม่ต้องแปลง Kafka และ KsqlDB จัดการ streams ได้ง่าย
- Pipeline overhead = 2
- คุณมี Redis + (Kafka + KsqlDB) หมายเหตุ: ในกรณีนี้ เราพิจารณา Kafka + KsqlDB เป็นระบบเดียวกัน
- จำนวนฟีเจอร์ = 2
กรณี 4: ใช้ Redis + Redis Streams + RedisTimeSeries
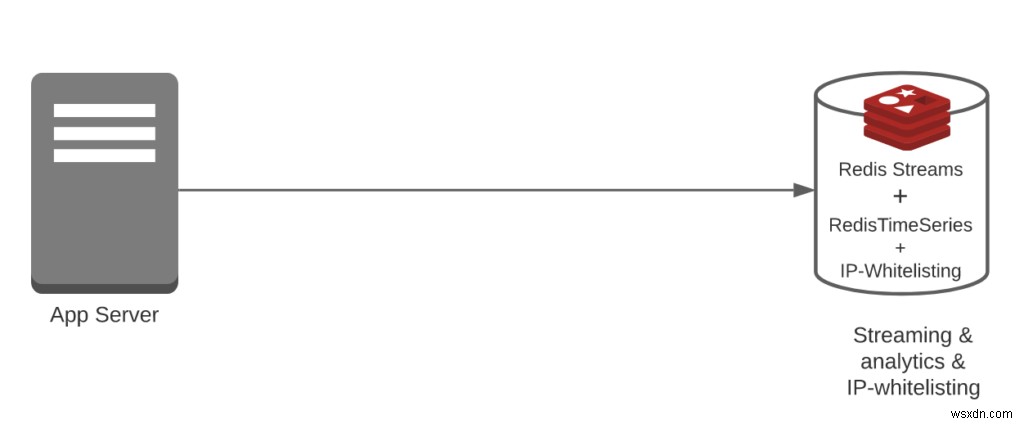
- Transformational overhead = 0
- สำหรับ IP-whitelisting ไม่ต้องแปลง Redis Streams และ RedisTimeseries จัดการ streams และ alerts ได้ง่าย
- Pipeline overhead = 1
- คุณมี Redis + Redis Streams + Redis TimeSeries หมายเหตุ: ทั้งสามเป็นส่วนหนึ่งของระบบเดียวกัน
- จำนวนฟีเจอร์ = 2
สรุปหลังระยะที่ 2:
เมื่อเราเพิ่มฟีเจอร์เพิ่มเติม:
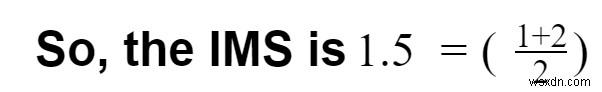
- กรณี 1 อยู่ที่ 2 ในระยะ-1 และลดลงเหลือ 1.5
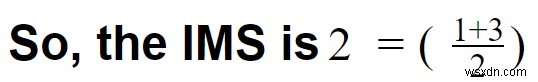
- กรณี 2 อยู่ที่ 3 ในระยะ-1 และลดลงเหลือ 2
- กรณี 3 อยู่ที่ 1 ในระยะ-1 และคงที่ที่ 1
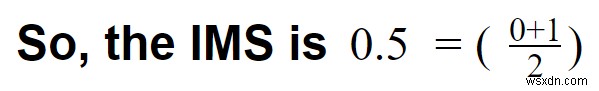
- กรณี 4 อยู่ที่ 1 ในระยะ-1 และลดลงเหลือ 0.5 (ดีที่สุด)
ในตัวอย่างของเรา กรณี 4 ที่มีคะแนน IMS ต่ำสุดคือ 1 จริงๆ แล้วดีขึ้นเมื่อเพิ่มฟีเจอร์ใหม่และจบที่ 0.5
โปรดทราบ: ถ้าเพิ่มฟีเจอร์ที่ต่างหรือมากกว่านี้ กรณี 4 อาจไม่ได้เป็นที่เรียบง่ายที่สุดตลอดไป แต่นั่นคือแนวคิดของคะแนน IMS เพียงแค่ระบุฟีเจอร์ทั้งหมด เปรียบเทียบสถาปัตยกรรมต่างๆ และดูว่าอันไหนดีที่สุดสำหรับกรณีการใช้งานของคุณ
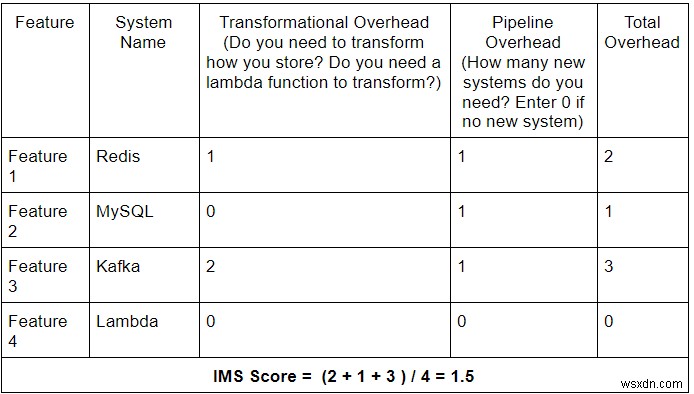
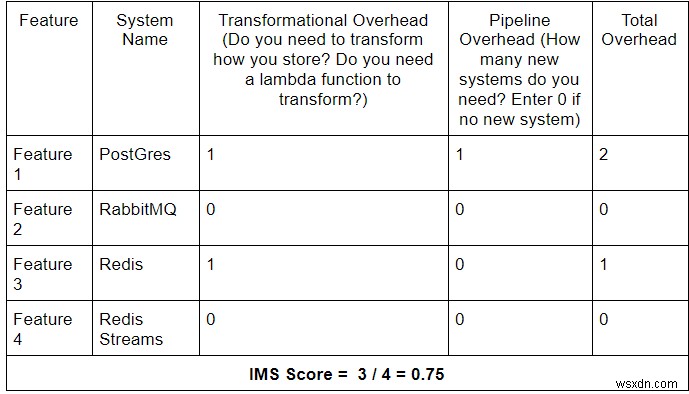
เพื่อทำให้ง่ายขึ้น เราให้เครื่องคิดเลขที่คุณสามารถนำไปใช้ในสเปรดชีตง่ายๆ เพื่อคำนวณคะแนน IMS
เครื่องคิดเลข IMS
วิธีใช้:
- สำหรับแต่ละเลเยอร์ข้อมูลหรือไปป์ไลน์ข้อมูล ให้ระบุ:
- ฟีเจอร์ที่มีอยู่
- ฟีเจอร์ใน roadmap สิ่งนี้สำคัญ เพราะคุณต้องการให้แน่ใจว่าเลเยอร์ข้อมูลรองรับฟีเจอร์ที่จะมาถึงได้โดยไม่มี overhead เพิ่ม
- จากนั้นแมป Transformational overhead และ Pipeline overhead สำหรับแต่ละฟีเจอร์
- สุดท้าย หารผลรวมของ overhead ทั้งหมดด้วยจำนวนฟีเจอร์
- ทำซ้ำขั้นตอน 2 และ 3 สำหรับไปป์ไลน์ที่มีระบบต่างกัน เพื่อเปรียบเทียบ
ไปป์ไลน์ข้อมูล 1
ไปป์ไลน์ข้อมูล 2
สรุป
มันง่ายมากที่จะถูกพัดพาไปสร้างเลเยอร์ข้อมูลซับซ้อนโดยไม่คิดถึงผลลัพธ์ คะแนน IMS ถูกสร้างขึ้นเพื่อช่วยให้คุณตัดสินใจอย่างมีสติ
คุณสามารถใช้คะแนน IMS เพื่อเปรียบเทียบระบบหลายระบบสำหรับกรณีการใช้งานของคุณ และดูว่าอันไหนดีที่สุดสำหรับชุดฟีเจอร์ของคุณ คุณยังสามารถตรวจสอบได้ว่าระบบของคุณทนต่อการขยายฟีเจอร์และยังคงเรียบง่ายที่สุดได้
จำไว้เสมอ:
“ความเรียบง่ายคือความเชี่ยวชาญสูงสุด” — Leonardo da Vinci
“ข้อมูลส่วนใหญ่ไม่เกี่ยวข้อง และความพยายามส่วนใหญ่ถูกว่างเปล่า แต่เพียงผู้เชี่ยวชาญเท่านั้นที่รู้ว่าควรละเว้นอะไร” — James Clear, Atomic Habits
