

What We're Building (สิ่งที่เรากำลังสร้าง)
ในบทความนี้ เราสร้าง extremely durable LLL streams ที่ survive ได้ง่าย:
- Network outages
- Page refreshes
- ปิด website
- ปิดฝา laptop
Bonus: คุณ view same stream บน multiple devices (เช่น phone และ laptop) พร้อมกัน
ไม่ว่าคุณจะพยายามทำลาย stream มัน continue ใน background ขณะคุณ disconnected และ resume smoothly ตอนกลับมา นี่คือ incredible user experience
Durable LLM streams demo 👇
Inspiration (แรงบันดาลใจ)
ตอน building with AI best practice คือ stream AI responses real-time
แทนที่จะรอ whole response user เห็น content real-time ขณะ generated - amazing สำหรับ UX Tools อย่าง AI SDK by Vercel ทำให้มัน extremely easy:
import { openai } from "@ai-sdk/openai"; import { streamText } from "ai"; const { textStream } = streamText({ model: openai("gpt-4o"), prompt: "Invent a new holiday and describe its traditions.", });เพื่อทำ real-time LLM streams work ทางเทคนิค คุณ connect client ไป API และ stream data back ใช้ protocols อย่าง Server Sent Events (SSE):
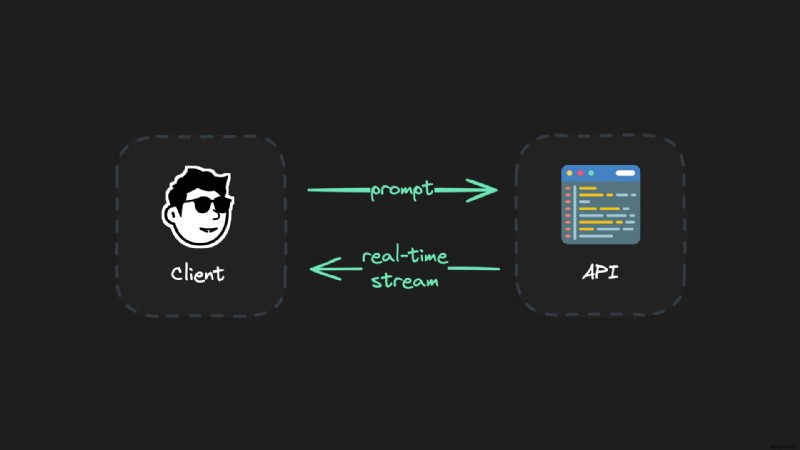
แต: setup นี้มีปัญหา
ถ้าอะไรเกิดขึ้นระหว่าง stream เช่น internet disconnect, ปิด laptop lid, หรือ network hiccup ทั้ง generation หาย คุณต้องเริ่มใหม่และรอ whole generation อีกครั้ง นี่ annoying มากสำหรับ longer generations (เช่น expensive models อย่าง O1)
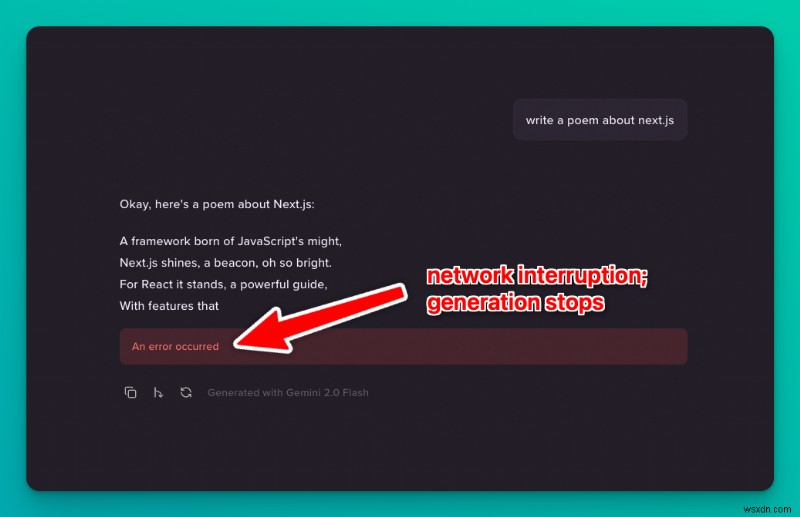
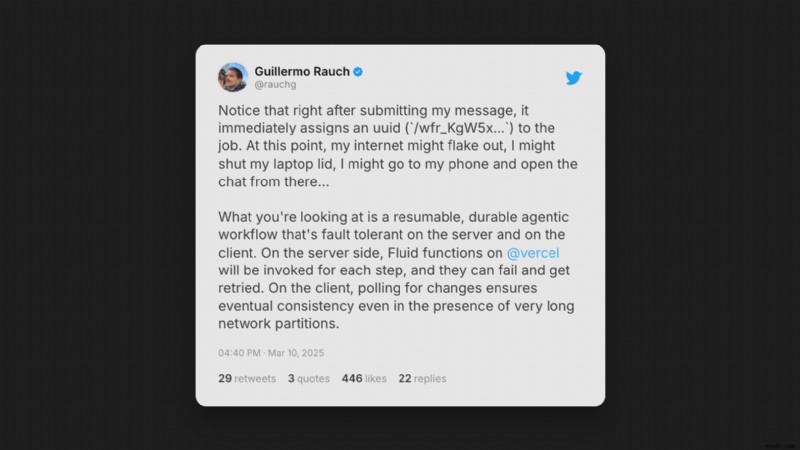
Obviously ปัญหานี้อยู่บน radar ของคน มี real demand สำหรับ reliable real-time LLM streaming และ devs มากขึ้น experiment ways ทำให้มัน work:
Building High-Durability LLM Streams (การสร้าง High-Durability LLM Streams)
Secret sauce สำหรับสร้าง truly durable, resumable LLM streams คือ separating client จาก generation environment Client connections unstable และ disconnected ได้หลายเหตุผล เช่น ปิด laptop, network problems หรือ refresh page
โดยแยก client และ generation processes generation จะ continue uninterrupted Clients reconnect ได้เวลาไหนก็ได้ โดยไม่ interrupt ongoing generation
Bad idea: Persistent, direct connection:
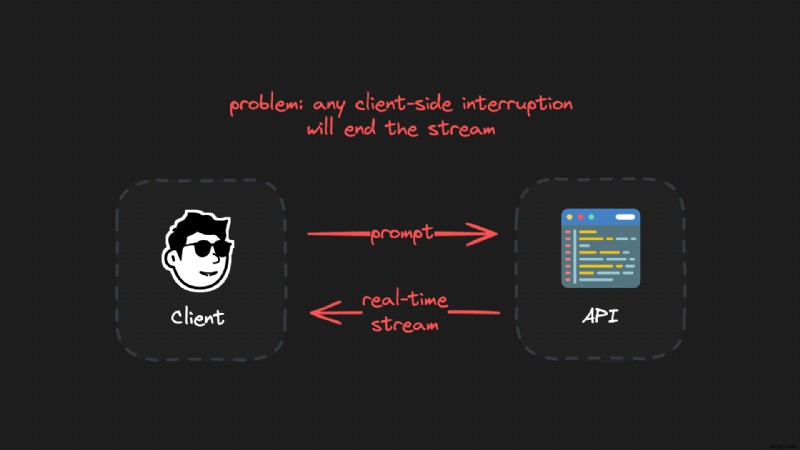
Good idea: Replaceable, interruptible stream connection:
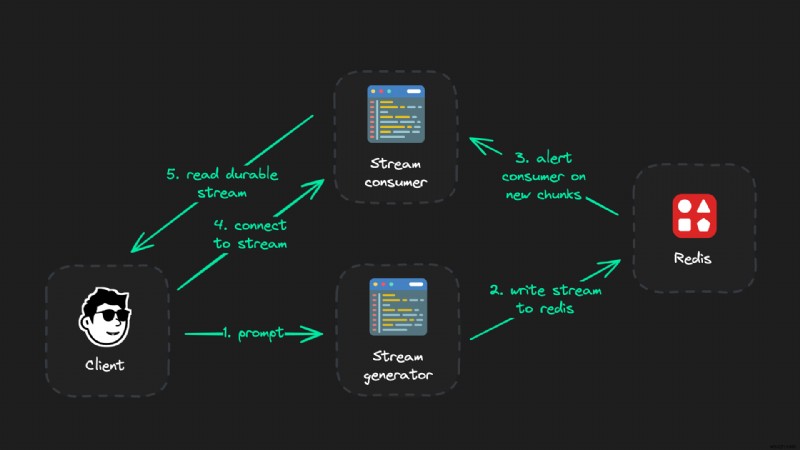
และใช่ — architecture นี่อาจดู complex สำหรับ simple AI stream แตที่คุณจะเห็นในโค้ด ตอนนี้ มันแค่ few lines of code และใช้ few minutes implement
Setting up Durable Streams (การตั้งค่า Durable Streams)
Extremely reliable LLM stream setup มี 3 ส่วน:
- The client (frontend)
- The stream generator (API route)
- The stream consumer (API route อีกตัว)
ทุก connections ตรงไป client สามารถ interrupted หรือ paused ได้เวลาไหนก็ได้ Logic ที่ responsible สำหรับ generate LLM output stream (stream generator) ควรเป็น independent API ที่ไม่มี active connection ไป client
แทนที่จะ เรา connect ไป client via consumer — ที่แค่อ่าน data จาก Redis และ "stupid" ค่อนข้าง มันมี purpose เดียว: อ่าน generator's output และ provide all LLM chunks ที่ client ยังไม่เห็น ทุกครั้งที่ client connect นั่นแหละ
Quick summary - what each part does:
- Client: Trigger stream generator (แตไม่ maintain open connection) และ render real-time stream
- Stream generator: Generate LLM output real-time และ publish ไป Redis
- Stream consumer: อ่าน generator's stream และ push chunks ไป client
Generator รับผิดชอบแค่อ่าน LLM stream และ publish ไป Redis real-time เราได้ replaceable connection จาก client ไป stream consumer ที่ ended, reconnected ได้ — ไม่มีอะไร affect stream generator
Code Examples (ตัวอย่างโค้ด)
ใน section นี้ เราดูโค้ด เพื่อทำให้ principles ชัดเจน เราดู actual complete production code implementation ท้ายสุด
ตอนนี้ เข้าใจโค้ดง่ายกว่า ถ้าเราดู core snippets และ purpose แทน entire code files
1. The Client
Client มี 3 responsibilities:
- Generating session IDs
- Triggering the generator
- Rendering the generation stream
มาดูแต่ละอย่าง:
Client: Generating Session IDs
ตอน client connect หรือ reconnect ไป stream เราอยากส่ง all messages ที่ client ยังไม่เห็น หมายความว่าใน active stream แต่ละ message มีแค่ exact delta ที่ client ต้องเห็น ไม่ใช่ entire stream
ตอน reconnect entire stream จน current generation point ส่งไป และ subscription ทุก future events seamless โดยไม่ missing chunks
How?
Redis Streams วิธี efficient store และ retrieve real-time data มี not-yet-seen functionality built-in ผ่านสิ่งที่เรียกว่า consumer groups สิ่งเดียวที่เราต้องทำ: ensure แต่ละ client มี unique session — หมายถึง assign แต่ละ generation unique ID
เราจะเรียน consumer groups ตอนดู stream consumer พวกมันดูแบบนี้:
await redis.xgroup("redis-key", { type: "CREATE", group: "my-group-name", id: "0", });Entire logic ของว่า client ไหนเห็น stream ไหนจนจุดไหน และ pieces ไหน missing ถูกจัดการโดย Redis streams อย่างสมบูรณ์ ด้วย guaranteed precision เราไม่เคยได้ missing LLM chunk และส่งแค่ data ที่ client ต้องการ
สิ่งเดียวที่ client ต้องทำตอนนี้: assign ID สำหรับแต่ละ generation เราใช้ nanoid:
import { customAlphabet } from "nanoid" const nanoid = customAlphabet("0123456789", 6);Client: Triggering a Generation Stream
Interaction เดียวที่ client มีกับ generation engine คือ trigger it ทางเทคนิค คุณ trigger generation จาก anywhere else ได้ (เช่น CRON jobs, automated pipelines)
ใน simplest form นี่แค่ fetch call ไป generation API route:
// 👇 trigger stream generator await fetch("/api/llm-stream", { method: "POST", headers: { "Content-Type": "application/json", }, body: JSON.stringify({ prompt, sessionId }), });Client: Reading a Generation Stream
หลัง trigger generation generator เริ่ม stream LLM output เข้า centralized Redis store — completely decoupled จาก client มา connect ไป stream consumer เพื่ออ่าน generation stream:
// 👇 connect to stream consumer const res = await fetch(`/api/check-stream?sessionId=${sessionId}`, { headers: { "Content-Type": "text/event-stream" }, });แค่นี้!
นี่คือ 3 responsibilities ของ client 當然 เรา fancy ได้มากด้วย custom hooks สำหรับ ID generation, react-query สำหรับ additional reliability และมากกว่า — เราจะถึงใน complete code examples ต่อไป
2. The Stream Generator
Stream generator เปิด LLM stream และเขียนแต่ละ chunk ไป Redis stream มัน publish message สำหรับทุก chunk ที่เขียน เพื่อ alert stream consumer เรื่อง new data สำหรับ real-time updates
Note: อีกครั้ง นี่ intentionally not full code example เราจะถึง full code ท้ายสุด — นี่เพื่อเข้าใจ concept
import { streamText } from "ai" import { redis } from "@/utils" const result = await new Promise( async (resolve, reject) => { const { textStream } = streamText({ model: openai("gpt-4o"), prompt, onError: (err) => reject(err), onFinish: async () => { resolve({ // ... }), }) for await (const chunk of textStream) { if (chunk) { const chunkMessage: ChunkMessage = { type: MessageType.CHUNK, content: chunk, } // 👇 write chunk to redis stream await redis.xadd(streamKey, "*", chunkMessage) // 👇 alert consumer that there's a new chunk await redis.publish(streamKey, { type: MessageType.CHUNK }) } } } )3. The Stream Consumer
Stream consumer connect ไป Redis และ listen new chunk alerts via Redis pub/sub แต่ละ client ได้ own consumer group track seen/unseen messages
Note: Publish ไม่ transfer actual chunk มันแค่ alert ว่ามี new chunk ใน stream
ตอน new chunk available stream consumer API อ่านจาก stream และ forward ไป all connected clients Redis consumer groups track ค่าแต่ละ client เห็น เพื่อ guarantee transfer no duplicates หรือ missing chunks
Core stream consumer ดูแบบนี้:
const streamKey = `llm:stream:${sessionId}`; const groupName = `sse-group-${nanoid()}`; await redis.xgroup(streamKey, { type: "CREATE", group: groupName, id: "0", }); const readStreamMessages = async () => { const chunks = (await redis.xreadgroup( groupName, `consumer-1`, streamKey, // 👇 built-in Redis stream functionality: only send unseen messages ">" )) as StreamData[]; if (chunks?.length > 0) { const [_streamKey, messages] = chunks[0]; for (const [_messageId, fields] of messages) { const rawObj = arrToObj(fields); const validatedMessage = validateMessage(rawObj); if (validatedMessage) { controller.enqueue(json(validatedMessage)); } } } }; // 👇 initial read await readStreamMessages(); const subscription = redis.subscribe(streamKey); subscription.on("message", async () => { // 👇 read every time a new chunk is written to stream await readStreamMessages(); });Note: เราสร้าง consumer group ทุก connection นี่ทำงานดีเพราะ Redis handle operation นี้ idempotently เช่น ไม่เกิดอะไรถ้า group มีอยู่แล้ว
Full Code (โค้ดเต็ม)
SessionID generation
จนตอนนี้ เราดู individual code pieces เข้าใจ clients' tasks, stream generator และ stream consumer แยกกัน ตอนนี้ มาดูว่า pieces นี้ fit กันอย่างไรด้วยการดู full implementation
เริ่มจาก การสร้าง sessionId ควร resilient กว่าแค่ nanoid() แตถ้า website refreshed หรือ closed? ตอน reconnect เราจะเสีย generated sessionId ถ้าไม่ store ที่ไหน — มันต้อง persist นานเท่า generation runs
โชคดี localStorage perfect สำหรับนี้:
import { customAlphabet } from "nanoid"; import { useRouter } from "next/navigation"; import { useCallback, useEffect, useState } from "react"; export const useLLMSession = () => { const [sessionId, setSessionId] = useState<string>(""); const router = useRouter(); const nanoid = customAlphabet("0123456789", 6); const updateUrlWithSessionId = useCallback( (id: string) => { const url = new URL(window.location.href); url.searchParams.set("sessionId", id); router.replace(url.toString(), { scroll: false }); }, [router], ); useEffect(() => { const urlParams = new URLSearchParams(window.location.search); const urlSessionId = urlParams.get("sessionId"); const storedSessionId = localStorage.getItem("llm-session-id"); if (urlSessionId) { localStorage.setItem("llm-session-id", urlSessionId); setSessionId(urlSessionId); } else if (storedSessionId) { setSessionId(storedSessionId); updateUrlWithSessionId(storedSessionId); } else { const newSessionId = nanoid(); localStorage.setItem("llm-session-id", newSessionId); setSessionId(newSessionId); updateUrlWithSessionId(newSessionId); } // eslint-disable-next-line react-hooks/exhaustive-deps }, []); const clearSessionId = useCallback(() => { localStorage.removeItem("llm-session-id"); setSessionId(""); const url = new URL(window.location.href); url.searchParams.delete("sessionId"); router.replace(url.toString(), { scroll: false }); }, [router]); const regenerateSessionId = () => { const newSessionId = nanoid(); localStorage.setItem("llm-session-id", newSessionId); setSessionId(newSessionId); updateUrlWithSessionId(newSessionId); return newSessionId; }; return { sessionId, regenerateSessionId, clearSessionId, }; };Client
เราเห็น 2 ส่วนสำคัญของ client: เริ่ม stream และ connect ไป stream เมื่อได้ confirmation จาก API ว่า generator running เรา connect ไป stream ใช้ react-query's refetch utility เพื่อ invoke connection query
นี่คือการรวม pieces ทั้งหมด:
app/page.tsx
"use client" import { useLLMSession } from "@/use-llm-session" import { useMutation, useQuery } from "@tanstack/react-query" import { FormEvent, useRef, useState, useEffect } from "react" import { MessageType, validateMessage, type ChunkMessage, type MetadataMessage, StreamStatus, } from "@/lib/message-schema" // precondition = stream is ready to read class PreconditionFailedError extends Error { constructor(message: string) { super(message) this.name = "PreconditionFailedError" } } export default function Home() { const { sessionId, regenerateSessionId, clearSessionId } = useLLMSession() const [prompt, setPrompt] = useState("") const [status, setStatus] = useState< "idle" | "loading" | "streaming" | "completed" | "error" >("idle") const [response, setResponse] = useState("") const [chunkCount, setChunkCount] = useState(0) const controller = useRef<AbortController | null>(null) const responseRef = useRef<HTMLDivElement>(null) const isInitialRequest = useRef(true) // keep generation in viewport useEffect(() => { if (responseRef.current) { responseRef.current.scrollTop = responseRef.current.scrollHeight } }, [response]) // start generator const { mutate, error, isIdle } = useMutation({ mutationFn: async (newSessionId: string) => { controller.current?.abort() isInitialRequest.current = false await fetch("/api/llm-stream", { method: "POST", headers: { "Content-Type": "application/json", }, body: JSON.stringify({ prompt, sessionId: newSessionId }), }) }, onSuccess: () => { setStatus("streaming") refetch() }, }) // connect to running stream const { refetch } = useQuery({ queryKey: ["stream", sessionId], queryFn: async () => { if (!sessionId) return null setResponse("") setChunkCount(0) const abortController = new AbortController() controller.current = abortController const res = await fetch(`/api/check-stream?sessionId=${sessionId}`, { headers: { "Content-Type": "text/event-stream" }, signal: controller.current.signal, }) if (res.status === 412) { // stream is not yet ready, retry connection throw new PreconditionFailedError("Stream not ready yet") } if (!res.body) return null const reader = res.body.pipeThrough(new TextDecoderStream()).getReader() let streamContent = "" while (true) { const { value, done } = await reader.read() if (done) break if (value) { const messages = value.split("\n\n").filter(Boolean) for (const message of messages) { if (message.startsWith("data: ")) { const data = message.slice(6) try { const parsedData = JSON.parse(data) const validatedMessage = validateMessage(parsedData) if (!validatedMessage) continue switch (validatedMessage.type) { case MessageType.CHUNK: const chunkMessage = validatedMessage as ChunkMessage streamContent += chunkMessage.content setResponse((prev) => prev + chunkMessage.content) setChunkCount((prev) => prev + 1) break case MessageType.METADATA: const metadataMessage = validatedMessage as MetadataMessage if (metadataMessage.status === StreamStatus.COMPLETED) { setStatus("completed") } break case MessageType.ERROR: setStatus("error") break } } catch (e) { console.error("Failed to parse message:", e) } } } } } return streamContent }, refetchOnWindowFocus: false, refetchOnMount: false, retry(failureCount, error) { if (isInitialRequest.current === true) return false if (error instanceof PreconditionFailedError) { return failureCount < 10 } return false }, }) const handleSubmit = async (e: FormEvent) => { e.preventDefault() setStatus("loading") const newSessionId = regenerateSessionId() mutate(newSessionId) } const handleReset = () => { controller.current?.abort() clearSessionId() setPrompt("") setResponse("") setChunkCount(0) setStatus("idle") } return ( <main className="flex min-h-screen flex-col items-center justify-between p-12 sm:p-24"> <div className="z-10 max-w-5xl w-full items-center justify-between font-mono text-sm"> <h1 className="text-4xl tracking-tight font-bold mb-8 text-center"> Resumable LLM Stream </h1> <form onSubmit={handleSubmit} className="mb-8"> <div className="mb-4"> <label htmlFor="prompt" className="block text-sm font-medium mb-2"> Enter your prompt: </label> <textarea autoFocus id="prompt" value={prompt} onChange={(e) => setPrompt(e.target.value)} className="w-full p-2 border border-zinc-700 rounded-md min-h-[100px] focus:outline-none focus:ring-2 focus:ring-blue-500 focus:border-transparent transition-all duration-200" placeholder="Ask the AI something..." disabled={status === "loading" || status === "streaming"} /> </div> <div className="flex gap-4"> <button type="submit" disabled={status === "loading" || status === "streaming"} className="px-4 py-2 bg-blue-600 text-white rounded-md hover:bg-blue-700 disabled:bg-gray-400" > {status === "loading" ? "Starting..." : status === "streaming" ? "Streaming..." : "Generate Response"} </button> <button type="button" onClick={handleReset} className="px-4 py-2 bg-zinc-600 text-white rounded-md hover:bg-zinc-700" > Reset </button> </div> </form> <div className="mt-8"> <h2 className="text-xl tracking-tight font-semibold mb-2"> Response: </h2> {status === "error" ? ( <div className="p-4 bg-red-100 border border-red-300 rounded-md text-red-800"> <p className="font-bold">Error:</p> <p>{error?.message}</p> </div> ) : status === "idle" && !response ? ( <p className="text-gray-500"> Enter a prompt and click "Generate Response" to see the AI's response. </p> ) : ( <div ref={responseRef} className="flex flex-col h-96 overflow-y-auto p-4 bg-zinc-900 text-zinc-200 border border-zinc-800 rounded-md whitespace-pre-wrap [&::-webkit-scrollbar]:w-2 [&::-webkit-scrollbar-thumb]:bg-zinc-700 [&::-webkit-scrollbar-track]:bg-zinc-800" > <div>{response || "Loading..."}</div> </div> )} {(status === "streaming" || status === "completed") && ( <div className="mt-2 text-sm text-gray-500"> <p>Session ID: {sessionId}</p> <p>Status: {status}</p> <p>Chunks received: {chunkCount}</p> <p> Connection: {status === "streaming" ? "Active SSE" : "Closed"} </p> </div> )} </div> </div> </main> ) }Stream Generator
นี่คือ entire code สำหรับ stream generator ถ้า LLM generation fail ที่จุดไหน มัน auto-retry ด้วย Upstash Workflow สำหรับ maximum reliability:
api/llm-stream/route.ts
import { MessageType, StreamStatus, type ChunkMessage, type MetadataMessage, } from "@/lib/message-schema"; import { redis } from "@/utils"; import { openai } from "@ai-sdk/openai"; import { serve } from "@upstash/workflow/nextjs"; import { streamText } from "ai"; interface LLMStreamResponse { success: boolean; sessionId: string; totalChunks: number; fullContent: string; } export const { POST } = serve(async (context) => { const { prompt, sessionId } = context.requestPayload as { prompt?: string; sessionId?: string; }; if (!prompt || !sessionId) { throw new Error("Prompt and sessionId are required"); } const streamKey = `llm:stream:${sessionId}`; await context.run("mark-stream-start", async () => { const metadataMessage: MetadataMessage = { type: MessageType.METADATA, status: StreamStatus.STARTED, completedAt: new Date().toISOString(), totalChunks: 0, fullContent: "", }; await redis.xadd(streamKey, "*", metadataMessage); await redis.publish(streamKey, { type: MessageType.METADATA }); }); const res = await context.run("generate-llm-response", async () => { const result = await new Promise<LLMStreamResponse>( async (resolve, reject) => { let fullContent = ""; let chunkIndex = 0; const { textStream } = streamText({ model: openai("gpt-4o"), prompt, onError: (err) => reject(err), onFinish: async () => { resolve({ success: true, sessionId, totalChunks: chunkIndex, fullContent, }); }, }); for await (const chunk of textStream) { if (chunk) { fullContent += chunk; chunkIndex++; const chunkMessage: ChunkMessage = { type: MessageType.CHUNK, content: chunk, }; await redis.xadd(streamKey, "*", chunkMessage); await redis.publish(streamKey, { type: MessageType.CHUNK }); } } }, ); return result; }); await context.run("mark-stream-end", async () => { const metadataMessage: MetadataMessage = { type: MessageType.METADATA, status: StreamStatus.COMPLETED, completedAt: new Date().toISOString(), totalChunks: res.totalChunks, fullContent: res.fullContent, }; await redis.xadd(streamKey, "*", metadataMessage); await redis.publish(streamKey, { type: MessageType.METADATA }); }); });สำหรับ complete type-safety ผมเขียน message schemas ทั้งหมดใน zod:
message-schema.ts
import { z } from "zod"; export const MessageType = { CHUNK: "chunk", METADATA: "metadata", EVENT: "event", ERROR: "error", } as const; export const StreamStatus = { STARTED: "started", STREAMING: "streaming", COMPLETED: "completed", ERROR: "error", } as const; export const baseMessageSchema = z.object({ type: z.enum([ MessageType.CHUNK, MessageType.METADATA, MessageType.EVENT, MessageType.ERROR, ]), }); export const chunkMessageSchema = baseMessageSchema.extend({ type: z.literal(MessageType.CHUNK), content: z.string(), }); export const metadataMessageSchema = baseMessageSchema.extend({ type: z.literal(MessageType.METADATA), status: z.enum([ StreamStatus.STARTED, StreamStatus.STREAMING, StreamStatus.COMPLETED, StreamStatus.ERROR, ]), completedAt: z.string().optional(), totalChunks: z.number().optional(), fullContent: z.string().optional(), error: z.string().optional(), }); export const eventMessageSchema = baseMessageSchema.extend({ type: z.literal(MessageType.EVENT), }); export const errorMessageSchema = baseMessageSchema.extend({ type: z.literal(MessageType.ERROR), error: z.string(), }); export const messageSchema = z.discriminatedUnion("type", [ chunkMessageSchema, metadataMessageSchema, eventMessageSchema, errorMessageSchema, ]); export type Message = z.infer<typeof messageSchema>; export type ChunkMessage = z.infer<typeof chunkMessageSchema>; export type MetadataMessage = z.infer<typeof metadataMessageSchema>; export type EventMessage = z.infer<typeof eventMessageSchema>; export type ErrorMessage = z.infer<typeof errorMessageSchema>; export const validateMessage = (data: unknown): Message | null => { const result = messageSchema.safeParse(data); return result.success ? result.data : null; };Stream Consumer
สุดท้าย มาดู full stream consumer implementation นี่คือ replaceable connection ที่ส่ง along all unseen chunks อัตโนมัติตอน client connect:
api/check-stream/route.ts
import { redis } from "@/utils" import { nanoid } from "nanoid" import { NextRequest, NextResponse } from "next/server" import { validateMessage, MessageType, type ErrorMessage, } from "@/lib/message-schema" export const dynamic = "force-dynamic" export const maxDuration = 60 export const runtime = "nodejs" type StreamField = string type StreamMessage = [string, StreamField[]] type StreamData = [string, StreamMessage[]] const arrToObj = (arr: StreamField[]) => { const obj: Record<string, string> = {} for (let i = 0; i < arr.length; i += 2) { obj[arr[i]] = arr[i + 1] } return obj } const json = (data: Record<string, unknown>) => { return new TextEncoder().encode(`data: ${JSON.stringify(data)}\n\n`) } export async function GET(req: NextRequest) { const { searchParams } = new URL(req.url) const sessionId = searchParams.get("sessionId") if (!sessionId) { return NextResponse.json( { error: "Stream key is required" }, { status: 400 } ) } const streamKey = `llm:stream:${sessionId}` const groupName = `sse-group-${nanoid()}` const keyExists = await redis.exists(streamKey) if (!keyExists) { return NextResponse.json( { error: "Stream does not (yet) exist" }, { status: 412 } ) } try { await redis.xgroup(streamKey, { type: "CREATE", group: groupName, id: "0", }) } catch (_err) {} const response = new Response( new ReadableStream({ async start(controller) { const readStreamMessages = async () => { const chunks = (await redis.xreadgroup( groupName, `consumer-1`, streamKey, ">" )) as StreamData[] if (chunks?.length > 0) { const [_streamKey, messages] = chunks[0] for (const [_messageId, fields] of messages) { const rawObj = arrToObj(fields) const validatedMessage = validateMessage(rawObj) if (validatedMessage) { controller.enqueue(json(validatedMessage)) } } } } await readStreamMessages() const subscription = redis.subscribe(streamKey) subscription.on("message", async () => { await readStreamMessages() }) subscription.on("error", (error) => { console.error(`SSE subscription error on ${streamKey}:`, error) const errorMessage: ErrorMessage = { type: MessageType.ERROR, error: error.message, } controller.enqueue(json(errorMessage)) controller.close() }) req.signal.addEventListener("abort", () => { console.log("Client disconnected, cleaning up subscription") subscription.unsubscribe() controller.close() }) }, }), { headers: { "Content-Type": "text/event-stream", "Cache-Control": "no-cache, no-transform", Connection: "keep-alive", }, } ) return response }Quick Summary & Final Words (สรุปเร็วและคำปิดท้าย)
เราเพิ่งสร้าง extremely robust LLM stream ที่ handle network interruptions, page refreshes และแม้แต่ complete disconnections นี่คือสิ่งที่เราทำ:
-
Decoupled generation from delivery: โดยแยก LLM generation จาก client connection content generation continues regardless ของ client problems
-
Persistent storage using Redis streams: เราใช้ Redis streams เป็น persistent message broker เก็บแต่ละ chunk ของ LLM response ขณะ generated
-
Real-time Updates with Redis Pub/Sub: เราสร้าง notification system ด้วย Redis Pub/Sub notify stream consumers ตอนมี new chunks
-
Automatic reconnection: Client reconnect ได้เวลาไหนก็ได้ และได้ all content อัตโนมัติ guaranteed without duplicates หรือ missing chunks รวมถึง content generated ระหว่าง disconnect
-
Session Management: เราสร้าง session system ที่ให้ users view streams บน multiple devices พร้อมกัน
Bottom line เราตอนนี้ provide exceptional user experience (UX) ให้ users ผมแนะนำ approach นี้มาก โดยเฉพาะถ้าคุณสร้างอย่าง LLM chat service
Cheers for reading! ถ้ามี feedback หรืออยากเป็น guest author บน Upstash ติดต่อ josh@upstash.com 🙌
