

ในบทความนี้ เราจะเรียนรู้เทคนิคการดึงข้อมูลเว็บ (web scraping) โดยใช้โมดูล lxml ที่มีใน Python
Web Scraping คืออะไร?
Web scraping ใช้เพื่อดึงข้อมูลจากเว็บไซต์ด้วยความช่วยเหลือของโปรแกรมรวบรวมข้อมูล (crawler/scanner) Web scraping มีประโยชน์ในการดึงข้อมูลจากหน้าเว็บที่ไม่มีฟังก์ชัน API ใน Python สามารถทำ web scraping ได้ด้วยโมดูลต่างๆ เช่น Beautiful Soup, Scrapy และ lxml
ในที่นี้เราจะพูดถึง web scraping โดยใช้โมดูล lxml
ก่อนอื่น เราต้อง ติดตั้ง lxml
พิมพ์ในเทอร์มินัลหรือคอมมานด์พรอมป์ท −
>>> pip install lxml
ในที่นี้ใช้ xpath เพื่อเข้าถึงข้อมูล
ในบทความนี้ เราจะดึงข้อมูลจากเว็บไซต์ที่รู้จักกันในชื่อ Steam ซึ่งมีข้อมูลเกี่ยวกับเกมต่างๆ
https://store.steampowered.com/genre/Free%20to%20Play/
ในหน้านั้น เราจะลองดึงข้อมูลจากส่วน "Popular New Releases" ที่นี่เราจะดึงชื่อ, ราคา, แท็กที่เกี่ยวข้อง และแพลตฟอร์มเป้าหมาย
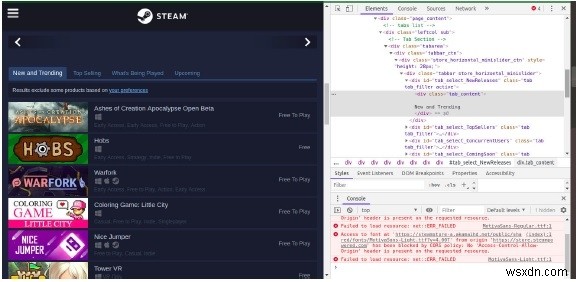
ในหน้าเว็บ ให้ดูโค้ด HTML ของแท็บ New Releases โดยใช้ฟีเจอร์ Inspect Element ใน Chrome ที่นี่เราจะได้รู้ว่าแท็กใดจัดเก็บข้อมูลที่ต้องการ
ในเว็บไซต์นี้ ทุกรายการในลิสต์ถูกห่อหุ้มในแท็ก div ที่มี id="tab_content" ซึ่งต่อมาถูกห่อหุ้มใน
แท็ก div ที่มี id="tab_select_newreleases"
ตอนนี้มาดูการนำไปใช้งานกันเลย
