

การดึงข้อมูลเว็บ (Web Scraping) ไม่ได้สนใจเฉพาะผู้ชื่นชอบวิทยาการข้อมูล แต่นักศึกษาหรือผู้เรียนที่ต้องการเจาะลึกลงไปในเว็บไซต์ก็สามารถทำได้ Python มีไลบรารีสำหรับ web scraping หลายตัว รวมถึง:
- Scrapy
- Urllib
- BeautifulSoup
- Selenium
- Python Requests
- LXML
บทความนี้จะพูดถึงไลบรารี lxml ของ Python เพื่อดึงข้อมูลจากเว็บเพจ ซึ่งสร้างขึ้นบน libxml2 XML parsing library ที่เขียนด้วย C ทำให้เร็วกว่า Beautiful Soup แต่ก็ยากต่อการติดตั้งบนบางคอมพิวเตอร์ โดยเฉพาะ Windows
การติดตั้งและนำเข้า lxml
ติดตั้ง lxml จากบรรทัดคำสั่งด้วย pip:
pip install lxml
หรือ
conda install -c anaconda lxml
เมื่อติดตั้ง lxml เรียบร้อยแล้ว ให้นำเข้าโมดูล html ซึ่งแปลง HTML จาก lxml:
>> from lxml import html
ดึงซอร์สโค้ดของหน้าที่ต้องการ scrape - มี 2 ทางเลือก: ใช้ไลบรารี python requests หรือ urllib เพื่อสร้างออบเจกต์ lxml HTML element ที่มี HTML ทั้งหมดของหน้า เราจะใช้ requests library เพื่อดาวน์โหลดเนื้อหา HTML ของหน้า
ติดตั้ง python requests:
$ pipenv install requests
ดึงข้อมูลหุ้นจาก Yahoo Finance
สมมติเราต้องการดึงข้อมูลหุ้น/Equity จาก google.finance หรือ yahoo.finance นี่คือสกรีนชอตของ Microsoft Corporation จาก Yahoo Finance:
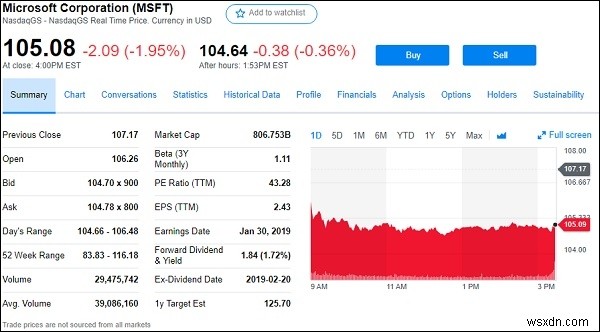
จาก URL ด้านบน (https://finance.yahoo.com/quote/msft) เราจะดึงฟิลด์ทั้งหมดของหุ้นที่มองเห็นได้ เช่น Previous Close, Open, Bid, Ask, Day's range, 52week range, volume และอื่นๆ
โค้ดด้านล่างทำได้โดยใช้โมดูล lxml ของ Python:
lxml_scrape3.py
from lxml import html
import requests
from time import sleep
import json
import argparse
from collections import OrderedDict
from time import sleep

def parse(ticker):
    url = "https://finance.yahoo.com/quote/%s?p=%s" % (ticker, ticker)
    response = requests.get(url, verify=False)
    print("Parsing %s" % (url))
    sleep(4)
    parser = html.fromstring(response.text)
    summary_table = parser.xpath('//div[contains(@data-test,"summary-table")]//tr')
    summary_data = OrderedDict()

    other_details_json_link = "https://query2.finance.yahoo.com/v10/finance/quoteSummary/{0}?formatted=true&lang=en-US®ion=US&modules=summaryProfile%2CfinancialData%2CrecommendationTrend%2CupgradeDowngradeHistory%2Cearnings%2CdefaultKeyStatistics%2CcalendarEvents&corsDomain=finance.yahoo.com".format(ticker)

    summary_json_response = requests.get(other_details_json_link)

    try:
        json_loaded_summary = json.loads(summary_json_response.text)
        y_Target_Est = json_loaded_summary["quoteSummary"]["result"][0]["financialData"]["targetMeanPrice"]['raw']
        earnings_list = json_loaded_summary["quoteSummary"]["result"][0]["calendarEvents"]['earnings']
        eps = json_loaded_summary["quoteSummary"]["result"][0]["defaultKeyStatistics"]["trailingEps"]['raw']
        datelist = []
        for i in earnings_list['earningsDate']:
            datelist.append(i['fmt'])
        earnings_date = ' to '.join(datelist)

        for table_data in summary_table:
            raw_table_key = table_data.xpath('.//td[contains(@class,"C(black)")]//text()')
            raw_table_value = table_data.xpath('.//td[contains(@class,"Ta(end)")]//text()')
            table_key = ''.join(raw_table_key).strip()
            table_value = ''.join(raw_table_value).strip()
            summary_data.update({table_key: table_value})

        summary_data.update({'1y Target Est': y_Target_Est, 'EPS (TTM)': eps, 'Earnings Date': earnings_date, 'ticker': ticker, 'url': url})
        return summary_data
    except:
        print("Failed to parse json response")
        return {"error": "Failed to parse json response"}

if __name__ == "__main__":
    argparser = argparse.ArgumentParser()
    argparser.add_argument('ticker', help='')
    args = argparser.parse_args()
    ticker = args.ticker
    print("Fetching data for %s" % (ticker))
    scraped_data = parse(ticker)
    print("Writing data to output file")
    with open('%s-summary.json' % (ticker), 'w') as fp:
        json.dump(scraped_data, fp, indent=4)
เพื่อรันโค้ดข้างต้น ให้พิมพ์คำสั่งด้านล่างในเทอร์มินัล:
c:\Python\Python361>python lxml_scrape3.py MSFT
เมื่อรัน lxml_scrap3.py จะพบว่าไฟล์ .json ถูกสร้างในไดเรกทอรีทำงานปัจจุบัน ชื่อประมาณ "stockName-summary.json" เนื่องจากพยายามดึงฟิลด์ msft (Microsoft) จาก Yahoo Finance ไฟล์จึงถูกสร้างชื่อ "msft-summary.json"
สกรีนชอตของผลลัพธ์ที่ได้:
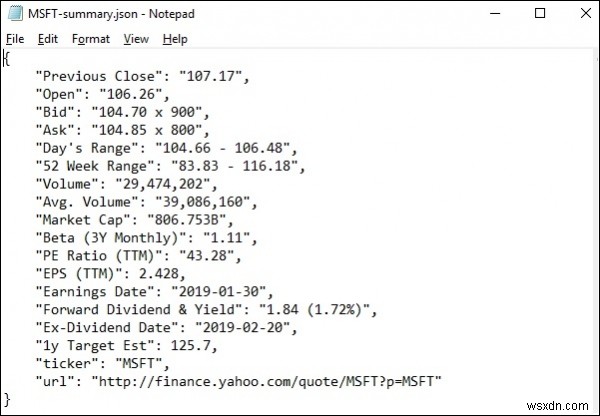
ดังนั้นเราจึงดึงข้อมูลที่ต้องการทั้งหมดจาก yahoo.finance ของ Microsoft สำเร็จ โดยใช้ lxml และ requests แล้วบันทึกข้อมูลในไฟล์ ซึ่งนำไปใช้แชร์หรือวิเคราะห์การเคลื่อนไหวราคาหุ้น Microsoft ได้
