

เผยแพร่ครั้งแรกเมื่อวันที่ 27 พฤศจิกายน 2563 ที่ ObjectRocket.com/blog
Elasticsearch® เก่งในการกระจายข้อมูลทั่วเคลสเตอร์ด้วยการตั้งค่าเริ่มต้น แต่หลังจากเคลสเตอร์ของคุณเริ่มเติบโต คุณควรปรับการตั้งค่าเริ่มต้นเพื่อเพิ่มประสิทธิภาพ เรามาทบทวนพื้นฐานของ sharding และให้แนวทางปฏิบัติที่ดีที่สุดสำหรับการจัดทำดัชนีและ shard
บทนำสู่ Elasticsearch Sharding
มีเอกสารมากมายเกี่ยวกับวิธีการทำงานของ Elasticsearch shards แต่แนวคิดพื้นฐานของ sharding คือการแยกข้อมูลของคุณออกเป็นชิ้นเล็กๆ หลายชิ้น เพื่อให้การค้นหาสามารถทำงานบนหลายส่วนพร้อมกันได้ เพื่ออำนวยความสะดวกในการทำคลัสเตอร์และการประมวลผลแบบขนานของฟังก์ชันดัชนี ให้แบ่งดัชนีแต่ละอันในอินสแตนซ์ Elasticsearch ของคุณเป็นชิ้นที่มีหมายเลข ชิ้นเหล่านี้เรียกว่า shards มาดูพฤติกรรมสำคัญของพวกมัน:
- แต่ละ shard จะถูกจำลองขึ้นอยู่กับการตั้งค่า number of replicas สำหรับดัชนี ดังนั้น สำหรับการตั้งค่า number of replicas เป็นหนึ่ง จะมีสำเนาของแต่ละ shard สองชุด: หนึ่ง shard primary และหนึ่ง shard replica Primary shard เป็น shard หลักและใช้สำหรับการดำเนินการ
indexing/writeและsearch/readในขณะที่ replica shards ใช้สำหรับการดำเนินการsearch/readเท่านั้น และสำหรับการกู้คืนหาก primary ล้มเหลว - Replica shards ต้องอยู่บนโฮสต์ที่ต่างจาก primary shard parent ของมัน
- Shards จะกระจายตัวทั่วจำนวนโฮสต์ในเคลสเตอร์โดยอัตโนมัติเป็นค่าเริ่มต้น แต่โฮสต์ทางกายภาพเดียวกันอาจมี primary shards หลายตัว คุณสามารถใช้การตั้งค่า Elasticsearch เพื่อปรับพฤติกรรมนี้ (rebalancing, shards allocation, ฯลฯ) แต่ขั้นตอนนั้นอยู่นอกขอบเขตของโพสต์นี้
- แต่ละ shard ต้องอยู่ในโฮสต์เพียงหนึ่งเท่านั้น เนื่องจาก shards ไม่สามารถแบ่งได้
- คุณสามารถตั้งค่าจำนวน shards ที่ดัชนีสร้างขึ้นระหว่างการสร้างดัชนี หรือใช้ค่าเริ่มต้นทั่วไป หลังจากสร้างดัชนีแล้ว คุณไม่สามารถเปลี่ยนจำนวน shards ได้โดยไม่ต้อง reindex
- คุณสามารถตั้งค่าจำนวน replicas ที่ดัชนีมีระหว่างการสร้างดัชนี หรือใช้ค่าเริ่มต้นทั่วไป คุณสามารถเปลี่ยนจำนวนนี้หลังจากสร้างดัชนีแล้ว
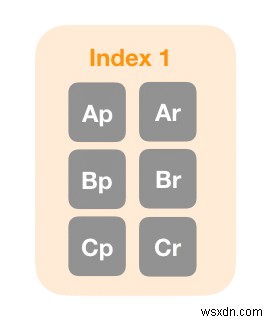
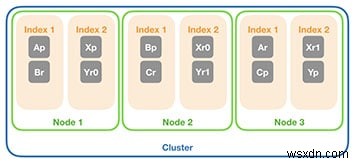
มาดูตัวอย่างเล็กๆ ผมสร้างดัชนีด้วยจำนวน shard สาม และการตั้งค่า replica เป็นหนึ่ง ตามที่คุณเห็นในแผนภาพก่อนหน้า Elasticsearch สร้าง shards ให้หกชุด: สาม primary shards (Ap, Bp, และ Cp) และสาม replica shards (Ar, Br, และ Cr)
Elasticsearch 確保 replicas และ primaries อยู่บนโฮสต์ที่ต่างกัน แต่คุณสามารถจัดสรร primary shards หลายตัวให้โฮสต์เดียวกันได้ เกี่ยวกับเรื่องโฮสต์ มาดูวิธีจัดสรร shards ให้โฮสต์ของคุณ
การจัดสรร Shard และ Elasticsearch แบบคลัสเตอร์
Elasticsearch พยายามจัดสรร shards ทั่วโฮสต์ที่พร้อมใช้งานทั้งหมดโดยค่าเริ่มต้น ที่ Rackspace ObjectRocket แต่ละคลัสเตอร์ประกอบด้วย master nodes, client nodes และ data nodes Data nodes ในสถาปัตยกรรมของเราเป็น buckets ที่คุณสามารถกำหนด shards ได้
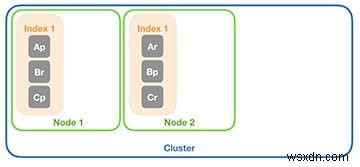
ใช้ตัวอย่างก่อนหน้า มาเอา shards หกชุดนั้นไปกำหนดให้กับ ObjectRocket for Elasticsearch cluster ที่มี data nodes สองตัว (ขั้นต่ำ) ในแผนภาพต่อไป คุณจะเห็นว่าสำหรับแต่ละ shard primary จะอยู่บน data node หนึ่ง ในขณะที่ replica รับประกันว่าจะอยู่บนอีกโหนดหนึ่ง โปรดทราบว่าตัวอย่างที่นี่แสดงเพียงการจัดสรรที่เป็นไปได้หนึ่งทาง ไม่ว่าจะจัดสรรอย่างไร สิ่งที่แน่นอนคือ replica จะถูกวางบน data node ที่ต่างจาก primary ของมันเสมอ
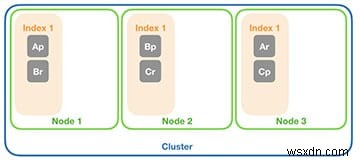
ตอนนี้ มาขยายตัวอย่างนี้และเพิ่ม data node ตัวที่สาม สังเกตว่ามี shard สองชุดถูกย้ายไปยัง data node ใหม่ ดังนั้นคุณมี shard สองชุดบนแต่ละโหนด
สุดท้าย มาเพิ่มดัชนีใหม่ให้กับเคลสเตอร์นี้ด้วยจำนวน shard สอง และจำนวน replicas ตั้งค่าเป็นสอง นี่จะให้คุณ primary ใหม่สองตัว (Xp และ Yp) และ replica สี่ตัว (Xr0, Xr1, Yr0, Yr1) ที่คุณสามารถกระจายทั่วเคลสเตอร์ได้ตามภาพต่อไป:
นั่นคือทั้งหมด
หลุมโจรที่ควรหลีกเลี่ยง
Elasticsearch ทำงานหนักทั้งหมดให้คุณ แต่มีหลุมโจรบางอย่างที่ควรหลีกเลี่ยง
หลุมโจร #1—ดัชนีขนาดใหญ่และ shards ขนาดใหญ่
การแก้ไขปัญหาดัชนีขนาดใหญ่พร้อม shards ขนาดใหญ่เป็นหนึ่งในปัญหาที่ง่ายที่สุดในการลดทอนใน Elasticsearch ผู้ใช้เริ่มต้นด้วยดัชนีเดียวที่จัดการได้ง่าย อย่างไรก็ตาม เมื่อแอปพลิเคชันของพวกเขาเติบโต ดัชนีของพวกเขาก็เติบโตตาม นี่นำไปสู่ shards ขนาดใหญ่ เพราะขนาด shard เกี่ยวข้องโดยตรงกับปริมาณข้อมูลเคลสเตอร์
ปัญหาแรกที่เกิดขึ้นคือประสิทธิภาพการใช้งานเคลสเตอร์ที่แย่ เมื่อ shards โตขึ้น มันจะยากขึ้นที่จะวางบน data node ต้องการพื้นที่ว่างบน data node มากถึงบล็อกข้อมูลขนาดใหญ่เพื่อเก็บ shard ไว้ที่นั่น สภาวะนี้นำไปสู่โหนดที่มีพื้นที่ว่างมากที่ไม่ได้ใช้ ตัวอย่างเช่น หากผมมี data nodes 8 GB แต่แต่ละ shard 6 GB ผมจะเหลือพื้นที่ 2 GB บน data nodes แต่ละตัวของผม ปัญหาที่สองคือ hot spotting หากคุณรวมข้อมูลของคุณไว้ใน shard น้อยๆ แล้ว คำขอที่ซับซ้อนจะไม่สามารถแบ่งออกไปยังโหนดจำนวนมากและดำเนินการแบบขนานได้
อย่าซื่อกับดัชนี
ใช้หลายดัชนีเพื่อแก้ปัญหาพื้นที่ว่างที่ค้างอยู่ กระจายข้อมูลของคุณทั่วหลายดัชนีเพื่อเพิ่มจำนวน shards ในเคลสเตอร์และกระจายข้อมูลอย่างสม่ำเสมอ นอกจากนี้ คล้ายกับเกม Tetris เมื่อ Elasticsearch วาง shards หลายดัชนีจะง่ายกว่าในการดูแล ความสามารถ alias ใน Elasticsearch ยังคงทำให้หลายอินสแตนซ์ปรากฏเป็นดัชนีเดียวให้แอปของคุณ ส่วนใหญ่ของ Elastic Stack สร้างดัชนีรายวันโดยค่าเริ่มต้น ซึ่งเป็นแนวทางปฏิบัติที่ดี คุณสามารถใช้ aliases เพื่อจำกัดขอบเขตการค้นหาไปยังช่วงวันที่เฉพาะ ใช้ curator เพื่อลบดัชนีเก่าเมื่ออายุมากขึ้น และปรับการตั้งค่าดัชนีเมื่อข้อมูลของคุณเติบโตโดยไม่ต้อง reindex ข้อมูลเก่า
เพิ่มจำนวน shard เมื่อขนาดดัชนีของคุณเพิ่มขึ้น
เพิ่มดัชนีบ่อยขึ้นและเพิ่มจำนวน shard เมื่อดัชนีของคุณโตขึ้น หลังจากคุณเห็นขนาด shard เริ่มเกินพื้นที่ที่ต้องการ คุณสามารถอัปเดต index template ของคุณ (หรือสิ่งที่คุณใช้สร้างดัชนีใหม่) ให้ใช้ shard มากขึ้นสำหรับแต่ละดัชนี อย่างไรก็ตาม นี้ช่วยได้ก็ต่อเมื่อคุณสร้างดัชนีใหม่บ่อย ดังนั้นคำแนะนำนี้จึงอยู่ลำดับที่สอง มิฉะนั้น คุณต้อง reindex เพื่อแก้ไขจำนวน shard ซึ่งเป็นงานมากกว่าการจัดการหลายดัชนี
กฎทั่วไปของเรา: หาก shard ใหญ่กว่า 40% ของขนาด data node shard นั้นอาจใหญ่เกินไป ในกรณีนี้ เราแนะนำให้ reindex ไปยังดัชนีที่มี shard มากขึ้น หรือยกระดับเป็นแผนขนาดใหญ่กว่า (ความจุมากขึ้นต่อ data node)
หลุมโจร #2—ดัชนีหรือ shards มากเกินไป
กรณีกลับกันคือดัชนีหรือ shards มากเกินไป หลังจากอ่านส่วนก่อนหน้า คุณอาจพูดว่า "ดีแล้ว ผมจะใส่ทุก doc ในดัชนีของมันและสร้าง shard ล้านชุด" ปัญหาที่นั่นคือดัชนีและ shards มี overhead overhead นั้นแสดงออกในทรัพยากรพื้นที่เก็บข้อมูล หน่วยความจำ และประสิทธิภาพการประมวลผล
เนื่องจากเคลสเตอร์ต้องรักษาสถานะของ shards ทั้งหมดและตำแหน่งของพวกมัน จำนวน shards มากมายจะกลายเป็นการทำบัญชีขนาดใหญ่ ซึ่งส่งผลต่อการใช้หน่วยความจำ นอกจากนี้ เนื่องจากคุณต้องแบ่งคำขอมากขึ้น คุณจะใช้เวลามากมายในการกระจายหรือรวบรวมสำหรับคำขอ หลุมโจรนี้ขึ้นอยู่กับขนาดของเคลสเตอร์ กรณีการใช้งาน และปัจจัยอื่นๆ มาก แต่โดยทั่วไปเราสามารถลดทอนได้ด้วยคำแนะนำไม่กี่ข้อ
Shards ควรไม่เกิน 50 GB
โดยทั่วไป 25 GB เป็นขนาดที่เหมาะสมสำหรับ large shards และ 50 GB ต้อง reindex การพิจารณานี้เกี่ยวข้องกับประสิทธิภาพของ shard และกระบวนการย้าย shard เมื่อจำเป็น เมื่อ rebalancing ให้ย้าย shards ไปยังโหนดอื่นในเคลสเตอร์ การถ่ายโอนข้อมูล 50 GB อาจใช้เวลานานเกินไปและทำให้สองโหนดค้างอยู่ตลอดกระบวนการ
รักษาขนาด shard ให้น้อยกว่า 40% ของขนาด data node
ตามที่กล่าวไว้ก่อนหน้า เมตริกขนาด shard ที่สองที่เราสนใจคือเปอร์เซ็นต์ของความจุ data node ที่ shard ใช้ ที่บริการ Rackspace ObjectRocket เราเสนอขนาดแผนที่แตกต่างกันซึ่งเกี่ยวข้องกับปริมาณพื้นที่เก็บข้อมูลบน data nodes เราพยายามปรับขนาดเคลสเตอร์และ shards เพื่อให้แน่ใจว่า shard ที่ใหญ่ที่สุดไม่ใช้เกิน 40% ของความจุ data node ในเคลสเตอร์ที่มีดัชนีหลายตัวขนาดต่างๆ นี้มีประสิทธิภาพค่อนข้างดี อย่างไรก็ตาม ในเคลสเตอร์ที่มีดัชนีใหญ่เพียงไม่กี่ตัว เราจะกระตือรือร้นมากขึ้นและพยายามรักษาความจุของ data node ให้ต่ำกว่า 30%
ในอุดมการณ์ ตรวจสอบให้แน่ใจว่าคุณไม่ได้ทำให้ความจุบน data node ค้างอยู่ หาก shards ของคุณประมาณ 45% ของขนาด data node คุณต้องการ data node ที่ประมาณครึ่งหนึ่งของการใช้งานเพื่อวาง shard นั้น นั่นคือพื้นที่ว่างมากที่ไม่ได้ใช้!
สรุป
การเลือกการตั้งค่า shard และการจัดทำดัชนีที่เหมาะสมอาจยาก แต่ด้วยการวางแผน การตัดสินใจที่ดีล่วงหน้า และการปรับแต่งขณะดำเนินการ คุณสามารถรักษาเคลสเตอร์ของคุณให้แข็งแรงและทำงานได้อย่างเหมาะสม เราช่วยธุรกิจปรับปรุงอินสแตนซ์ Elasticsearch ของพวกเขาทั้งเวลา
เรียนรู้เพิ่มเติมเกี่ยวกับบริการ DBA ของ Rackspace
ใช้แท็บ Feedback เพื่อแสดงความคิดเห็นหรือถามคำถาม คุณยังสามารถคลิก Sales Chat เพื่อแชททันทีและเริ่มสนทนาได้
