

เผยแพร่ครั้งแรกเมื่อวันที่ 12 ธันวาคม 2562 ที่ ObjectRocket.com/blog
วันหยุดกำลังจะมาถึง และฤดูกาลนี้เป็นเครื่องหมายครบรอบ 1 ปีของ milestone สำคัญในประวัติศาสตร์ Rackspace ObjectRocket ก่อนวันหยุดปี 2562 เราได้นำเสนอ High Availability (HA) บนบริการ ObjectRocket PostgreSQL® ทุก datastore ที่เราเสนอบน ObjectRocket สร้างขึ้นสำหรับ production workloads ต้องการ HA สำหรับลูกค้าทุกคน
ทำไม HA จึงสำคัญ?
หากคำว่า HA ไม่คุ้นเคยกับคุณ มาทบทวนกันสั้นๆ ว่าทำไม HA จึงสำคัญ ข้อดีหลัก 3 ข้อของ HA คือ:
- Downtime เป็นศูนย์หรือลดลงมาก
- ป้องกันการสูญเสียข้อมูล
- เพิ่มประสิทธิภาพฐานข้อมูล
มีหลายวิธีในการนำ HA ไปใช้กับ datastores และมีเทคโนโลยีหลายอย่าง แต่ส่วนประกอบสำคัญของโซลูชัน HA เกือบทุกอย่างคือ data replica หมายความว่าคุณเห็น dataset หรือ database เดียว แต่เบื้องหลังมี replica (สำเนา) ที่ถูกต้องหนึ่งหรือมากกว่าของข้อมูลนั้น หากฐานข้อมูลหลัก primary ในแผนการจำลองส่วนใหญ่ พบปัญหา เช่น hardware failure, software failure หรือ corruption replica สามารถแทนที่ master ได้ จุดสุดท้ายนี้เกี่ยวกับส่วนประกอบหลักที่สองของระบบ HA ส่วนใหญ่ คือกลไก failover แบบอัตโนมัติ (promotion หรือ election ในแผนอื่น) Replication ให้การมีสำเนาข้อมูลที่แข็งแกร่งหลายชุด อย่างไรก็ตาม คุณควรพร้อมที่จะ:
- ตรวจจับปัญหาที่ไม่คาดคิดบน primary
- เลือก replica ที่เหมาะสมเพื่อ promote เป็น primary
- ซ่อมแซม primary ที่ล้มเหลวและสร้าง replica ใหม่ (เพื่อแทนที่ตัวที่คุณ promote)
ส่วนประกอบสุดท้าย บางครั้งรวมกับส่วนที่สอง คืออุปกรณ์สำหรับส่งคำขอไปยังโหนดที่ถูกต้อง หากคุณชี้แอปพลิเคชันของคุณไปที่ primary สำหรับการเขียนข้อมูล (best practice) และ primary นั้นล้มเหลว แอปพลิเคชันของคุณจะไม่ชี้ไปยัง primary ที่ promote ใหม่ อีกครั้ง มีหลายวิธีแก้ไข แต่ยอดนิยมคือใช้ proxies หรือ load balancers ชี้แอปพลิเคชันของคุณไปที่ proxy หรือ load balancer และมันจะกำหนดที่ถูกต้องที่จะส่ง traffic ของคุณโดยไม่ชี้แอปพลิเคชันโดยตรงไปที่ database server
เพื่อรวมทั้งหมดเข้าด้วยกัน ระบบ failover แบบอัตโนมัติและ proxy/load balancer ทำงานร่วมกันเมื่อเกิด failover เมื่อคุณ promote master ใหม่ proxy หรือ load balancer จะนำ traffic ไปยัง master ใหม่ ไม่มีการเปลี่ยนแปลงในแอปพลิเคชันของคุณ และนอกจาก blip ที่อาจเกิดขึ้นระหว่าง promotion แอปพลิเคชันไม่จำเป็นต้องรู้ว่ามีการ promote เกิดขึ้น นี่คือภาพรวมระดับสูงของกระบวนการ ซึ่งครอบคลุมส่วนประกอบพื้นฐาน ตอนนี้ มาลงลึกไปที่เทคโนโลยีที่เราใช้สำหรับแต่ละส่วนของโซลูชันของเรา
เทคโนโลยีที่เราใช้
ตอนนี้เราทบทวนส่วนประกอบสำคัญแล้ว มาลงลึกดูว่าเราให้แต่ละส่วนประกอบก่อนหน้านี้อย่างไร:
Replication
Postgres รองรับหลายแผนการจำลองแบบเนทีฟ ปัจจุบันคุณสามารถกำหนดค่า replica หนึ่งหรือสองตัวได้ แต่เราจะขยายตัวเลือกในอนาคต อีกรายละเอียดเล็กน้อยของ replication คือแนวคิดของ synchronous และ asynchronous replication ด้วย synchronous replication primary รอแต่ละ replica ยืนยันว่า write เสร็จสิ้นก่อนที่ primary จะถือว่า write เสร็จ ใน asynchronous primary ยิง writes ไปที่ replicas แต่ไม่ยืนยันการเสร็จสิ้นก่อนยืนยันการเขียนของแอปพลิเคชันหรือไคลเอ็นต์ โซลูชันที่เราใช้ช่วยให้เรารองรับทั้ง asynchronous และ synchronous replication ได้ โดยค่าเริ่มต้น เราเปิดใช้งาน synchronous replication และเรากำหนดค่า replication ในสภาพแวดล้อมของเราเพื่อยืนยันว่า write ถูกเขียนไปที่ Write-ahead Log (WAL) บน primary และอย่างน้อยหนึ่ง replica คุณสามารถเปลี่ยนการตั้งค่าต่อ transaction หรือ session ได้
Failover และ promotion
มีเครื่องมือโอเพนซอร์สและของบุคคลที่สามหลายอย่างที่ให้ฟังก์ชัน failover และ promotion แต่เราเลือก Patroni เนื่องจากลักษณะเด่นดังต่อไปนี้:
- Native Kubernetes® support: เราสร้างแพลตฟอร์มใหม่บน Kubernetes ดังนั้นคุณสามารถนำเครื่องมือที่ต่อกับ Kubernetes ได้เลย แทนที่จะต้องการ state หรือ consensus mechanism อื่น นี่คือกุญแจสำคัญ
- Active development และ community: ชุมชนรอบ Patroni ทำงานอย่าง活跃และช่วยให้เรา collaborate และ contribute ของเราเองได้เมื่อฟังก์ชันเติบโต นอกจากนี้ มีทรัพยากรมากมาย ตั้งแต่การพูดในงานประชุม เอกสารถึงตัวอย่าง operator จาก Zalando ช่วยให้เราเรียนรู้เทคโนโลยี
- Simple Architecture: เครื่องมืออื่นๆ หลายอย่างต้องการทรัพยากร dedicated นอกเหนือจากอินสแตนซ์ Postgres เพื่อจัดการ load balancing และ primary promotion Patroni ห่อหุ้ม Postgres และใช้ Kubernetes native components เพื่อจัดการฟังก์ชันอื่นๆ ดังนั้นเราไม่ได้จัดสรรทรัพยากรเพิ่มเติมสำหรับ HA
แม้ mileage ของคุณอาจแตกต่าง เราพบว่า Patroni เป็นตัวเลือกที่ดีมาก ง่ายต่อการกำหนดค่าและดูแลรักษาในสภาพแวดล้อมของเรา คุณบอก Patroni เพียงว่าโหนดไหนอยู่ใน HA group ไหน และมันจะจัดการส่วนที่เหลือ มันกำหนดค่า replication ตรวจจับ primary ที่ล้มเหลว promote replicas สร้าง replicas ใหม่ และแม้แต่งานกับ Kubernetes ในส่วนสุดท้ายของกระบวนการ
Request routing
สุดท้าย Patroni และ Kubernetes native construct ที่เรียกว่า service แทนชิ้นส่วนสุดท้ายของปริศนา Service ใน Kubernetes ทำงานเหมือน proxy ที่ส่ง traffic ตาม labels บนกลุ่ม containers (a pod) Patroni ติดฉลาก active primary ด้วย label master และ Kubernetes ดูแลการส่ง database traffic เฉพาะไปยัง pods ที่มี label master จำไว้ว่าเป็นคำอธิบายระดับสูง แต่ในทางปฏิบัติมันทำงานแบบนี้ กระบวนการนี้ยังสามารถขยายเพื่อให้ secondary port ที่ส่ง database read requests ไปยัง replicas (เพื่อลดโหลดบน primary)
นี่คือภาพรวมสั้นๆ ของเทคโนโลยีที่มีอยู่ แต่บอกเราถ้าคุณอยากได้ยินเพิ่มเติม เราชอบคุย shop talk กับลูกค้า
ลองใช้เลยตอนนี้!
หน้าจอ Create an Instance ใน Mission Control มีส่วนภายใต้ Step 2 ที่ชื่อ Customize Your Instance ที่นั่นคุณสามารถคลิกกล่องเพื่อทำให้ลูกศรสีเขียว ซึ่งเพิ่ม HA replicas ของอินสแตนซ์ PostgreSQL ของคุณ คุณยังสามารถเลือกจำนวน replicas (หนึ่งหรือสอง) โดยคลิก ellipses (…) ที่มุมขวาบน
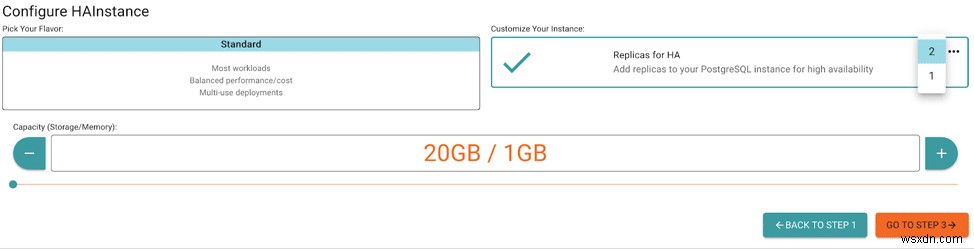
โดยค่าเริ่มต้น เราแนะนำสอง replicas เพื่อให้แม้ระหว่าง outage คุณก็ยังมี redundancy แต่คุณสามารถเลือกหนึ่งได้
ใช้แท็บ Feedback เพื่อแสดงความคิดเห็นหรือถามคำถาม คุณยังสามารถคลิก Sales Chat เพื่อแชททันทีและเริ่มสนทนาได้
