

เรายินดีที่จะประกาศการเปิดตัว Milestone แรกในการพัฒนา RediSearch 2.0 RediSearch เป็นเครื่องมือค้นหาแบบเรียลไทม์ที่ช่วยให้คุณสืบค้นข้อมูลใน Redis เพื่อตอบคำถามที่ซับซ้อนหลากหลายรูปแบบได้
Milestone นี้ ซึ่งเรียกว่า 2.0-M01 แสดงถึงการปรับโครงสร้างใหม่ในวิธีการรักษาดัชนีให้ซิงค์กับข้อมูล แทนที่จะต้องเขียนข้อมูลผ่านดัชนี (โดยใช้คำสั่ง FT.ADD) RediSearch จะติดตามข้อมูลที่เขียนใน Hashes และจัดทำดัชนีโดยอัตโนมัติ
ข้อได้เปรียบหลักคือ ตอนนี้คุณสามารถเพิ่ม RediSearch เข้าไปใน Redis instance ที่มีอยู่แล้ว และสร้างดัชนีรอง (secondary index) ได้โดยไม่ต้องแก้ไขโค้ดแอปพลิเคชัน ทำให้คุณเริ่มใช้ RediSearch กับข้อมูลเดิมได้ทันที เพียงแค่โหลดโมดูล RediSearch และกำหนดสคีมา (schema) RediSearch 2.0 จะพร้อมใช้งานทั่วไป (General Availability) ในฤดูใบไม้ร่วงนี้
(หมายเหตุ: คุณลักษณะใหม่นี้นำเสนอการเปลี่ยนแปลงบางอย่างใน API (ระบุด้านล่าง) เราพยายามรักษาความเข้ากันได้กับรุ่นก่อนหน้า (backward compatibility) มากที่สุด แต่ในกรณีนี้ไม่สามารถทำได้ เราวางแผนที่จะปรับปรุงและแก้ไขต่อไปเมื่อได้รับฟีดแบ็กจากลูกค้า)
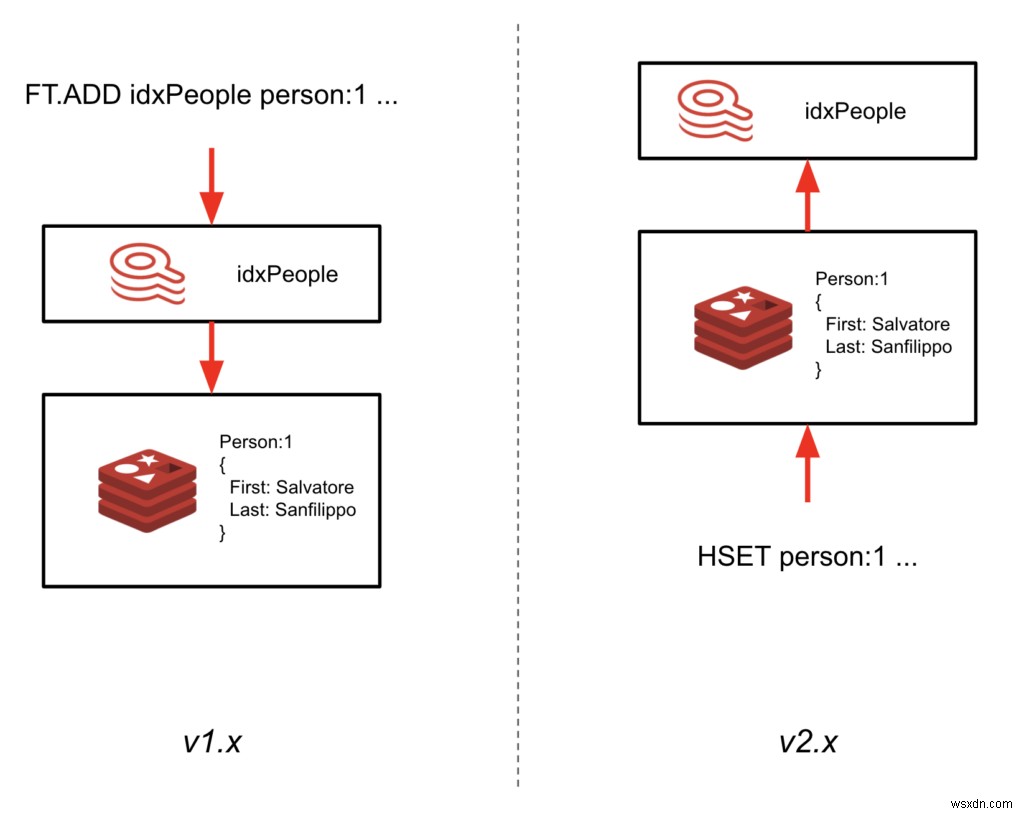
การเปลี่ยนแปลงใน API
ตามที่กล่าวไว้ข้างต้น Milestone ของ RediSearch 2.0 นี้รวมถึงการเปลี่ยนแปลง API หลายประการ:
- ดัชนีไม่ได้อยู่ใน key space อีกต่อไป หากคุณเคยใช้ดัชนี key (idx:<index name>) เพื่อแสดงรายการดัชนีในฐานข้อมูล วิธีนี้จะไม่ทำงานอีกต่อไป อย่างไรก็ตาม เราได้เพิ่มคำสั่ง FT._LIST เพื่อคืนค่าดัชนีทั้งหมดในฐานข้อมูล
- ดัชนีต้องสร้างพร้อม prefix/filter ค่าเหล่านี้ระบุว่าดัชนีจะจัดทำดัชนีเอกสารใดโดยอัตโนมัติ คุณสามารถระบุ prefix แบบง่าย และ/หรือนิพจน์ filter ที่ซับซ้อนได้
- ไม่สามารถอัปเกรดได้ หากคุณมี RDB ที่สร้างด้วยรุ่นเก่าของ RediSearch รุ่น 2.0 จะอ่านไม่ได้ ปัจจุบันคุณต้องจัดทำดัชนีข้อมูลทั้งหมดใหม่ (re-index) อย่างไรก็ตาม เรากำลังพัฒนากระบวนการอัปเกรดสำหรับรุ่น GA
- ทำงานได้กับ Redis 6 ขึ้นไปเท่านั้น
- คำสั่ง FT ถูกแมปกับคำสั่ง Redis ที่เทียบเท่า ทำให้แอปพลิเคชันเดิมยังคงทำงานกับ RediSearch 2.0 ได้ การแมปมีดังนี้:
- FT.ADD => HSET
- FT.DEL => DEL (DD โดยค่าเริ่มต้น)
- FT.GET => HGETALL
- FT.MGET => HGETALL
- Inverted index เองไม่ได้ถูกบันทึกลง RDB อีกต่อไป ไม่ได้หมายความว่าไม่รองรับ persistence RediSearch บันทึกนิยามดัชนีลง RDB และจัดทำดัชนีข้อมูลในพื้นหลังหลังจาก Redis เริ่มทำงาน คุณสามารถตรวจสอบสถานะการจัดทำดัชนีผ่านคำสั่ง FT.INFO
API ใหม่
การอัปเดต API ที่ใหญ่ที่สุดคือวิธีการสร้างดัชนี ใน RediSearch 2.0 ใช้คำสั่ง FT.CREATE สำหรับสร้างดัชนี ส่วนที่เพิ่มเข้ามาใน API ไฮไลท์ด้วยสีเหลืองดังนี้:
FT.CREATE {index} ON {structure} [PREFIX {count} {prefix} [{prefix} ..] [FILTER {filter}] [LANGUAGE_FIELD {lang_field}] [LANGUAGE {lang}] [SCORE_FIELD {score_field}] [SCORE {score}] [PAYLOAD_FIELD {payload_field}] [TEMPORARY {seconds}] [MAXTEXTFIELDS] [NOOFFSETS] [NOHL] [NOFIELDS] [NOFREQS] [STOPWORDS {num} {stopword} ...] SCHEMA {field} [TEXT [NOSTEM] [WEIGHT {weight}] [PHONETIC {matcher}] | NUMERIC | GEO | TAG [SEPARATOR {sep}] ] [SORTABLE][NOINDEX] ...
ลองดูรายละเอียดบางส่วน:
- ON {structure} รองรับเฉพาะ HASH เท่านั้นตอนนี้
- PREFIX {count} {prefix} บอกดัชนีว่าควรจัดทำดัชนี key ใด สามารถเพิ่ม prefix หลายค่าได้ เนื่องจากอาร์กิวเมนต์นี้เป็น optional ค่าเริ่มต้นคือ * (ทุก key)
- FILTER {filter} เป็นนิพจน์ filter ด้วยภาษา aggregation expression ของ RediSearch ทั้งหมด สามารถใช้ @__key เพื่อเข้าถึง key ที่เพิ่ม/เปลี่ยนแปลงไปเมื่อสักครู่
- LANGUAGE และ SCORE ให้คุณทับทิ้งภาษาและคะแนนเริ่มต้นสำหรับเอกสารทั้งหมดที่จัดทำดัชนี
- LANGUAGE_FIELD, SCORE_FIELD, และ PAYLOAD_FIELD อนุญาตให้มีภาษาและการให้คะแนนเฉพาะเอกสาร และใช้ payload เป็นฟิลด์ภายในเอกสาร
ข้อจำกัดและการเปลี่ยนแปลงอื่นๆ
Milestone RediSearch 2.0-M01 นี้ยังนำการอัปเดตอื่นๆ มาด้วย:
- NOSAVE ไม่รองรับอีกต่อไป
- การอัปเดต Hashes หมายความว่าเอกสารทั้งหมดจะถูกจัดทำดัชนี (keyspace notifications ไม่ระบุว่าฟิลด์ไหนเปลี่ยนไป) ดังนั้นการอัปเดตบางส่วน (partial updates) จะช้าลง เรายังคงศึกษาทางเลือกเพื่อปรับปรุงประสิทธิภาพในสถานการณ์เหล่านี้
- ชื่อฟิลด์ตอนนี้คือ case-sensitive การประกาศฟิลด์ "FOO" และจัดทำดัชนีเป็น "foo" จะไม่ทำงาน
- คำสั่ง FT.ADD จะถูกแมปไปเป็น hset ตามตัวอย่างนี้:
FT.ADD idx doc1 1.0 LANGUAGE eng PAYLOAD payload FIELDS f1 v1 f2 v2
ถูกแมปเป็น
HSET doc1 __score 1.0 __language eng __payload payload f1 v1 f2 v2
หมายความว่า ฟิลด์ score, language, และ payload ในดัชนีของคุณต้องชื่อ __score, __language, __payload ตามลำดับ เพื่อให้การแมปทำงานได้ตามที่คาดหวัง
- FT.ADDHASH ไม่รองรับอีกต่อไป ให้ใช้ HSET แทน
- FT.OPTIMIZE ไม่รองรับอีกต่อไป ฟังก์ชัน Garbage Collection ของ RediSearch รับผิดชอบในการเพิ่มประสิทธิภาพดัชนี
สรุป
เราตื่นเต้นมากกับการเปลี่ยนแปลงเหล่านี้ เพราะตอนนี้คุณสามารถโหลด RediSearch เข้าไปในฐานข้อมูล Redis ที่มีอยู่ และจัดทำดัชนีข้อมูลเดิมที่อยู่ใน Hashes ได้ ทำได้โดยไม่ต้องอัปเดตโลจิกแอปพลิเคชันเมื่อจัดการเอกสารเหล่านี้ คุณสามารถลองใช้ Milestone release นี้ได้โดยดาวน์โหลดซอร์สโค้ดจาก GitHub หรือใช้ Docker image 1:99:1 RedisSarch รุ่นนี้ยังไม่พร้อมสำหรับ production แต่เราต้องการแชร์ให้ลองใช้เพื่อรวบรวมฟีดแบ็ก กรุณาแชร์ความคิดเห็นหรือปัญหาใน GitHub repository หรือ Redis Community forum ของเรา
