

RedisTimeSeries เป็นโมดูล Redis ที่นำโครงสร้างข้อมูล time-series มาสู่ Redis แบบเนทีฟ โซลูชัน time-series ที่สร้างขึ้นบน Sorted Sets (หรือ Redis Streams) เดิมๆ สามารถได้ประโยชน์จากฟีเจอร์ของ RedisTimeSeries เช่น การเขียนข้อมูลปริมาณมาก อ่านข้อมูลเวลาแป๊บ ภาษาคิวรีที่ยืดหยunnable การดาวน์แซมเพลิง และอีกมากมาย!
โดยทั่วไป ข้อมูล time-series ค่อนข้างเรียบง่าย แต่เราต้องคำนึงถึงลักษณะอื่นๆ ด้วย:
- ความเร็วข้อมูล: เช่น สร้างเมตริกหลายร้อยจากอุปกรณ์หลายพันต่อวินาที
- ปริมาณ (Big data): ข้อมูลสะสมหลายเดือน (แม้แต่วันหลายปี)
ดังนั้น ฐานข้อมูลอย่าง RedisTimeSeries จึงเป็นเพียงส่วนหนึ่งของโซลูชันโดยรวม คุณยังต้องคิดว่าจะ เก็บรวบรวม (ingest), ประมวลผล, และ ส่ง ข้อมูลทั้งหมดไปยัง RedisTimeSeries อย่างไร สิ่งที่คุณต้องการจริงๆ คือไปป์ไลน์ข้อมูลที่ขยายได้ ซึ่งทำหน้าที่เป็นบัฟเฟอร์แยก producers และ consumers
ที่นี่ Apache Kafka เข้ามามีบทบาท! นอกจากโบรกเกอร์หลักแล้ว Kafka ยังมีระบบนิเวศส่วนประกอบที่ครบครัน รวมถึง Kafka Connect (ซึ่งเป็นส่วนหนึ่งของสถาปัตยกรรมโซลูชันในบล็อกนี้) ไลบรารีไคลเอ็นต์หลายภาษา Kafka Streams, Mirror Maker ฯลฯ
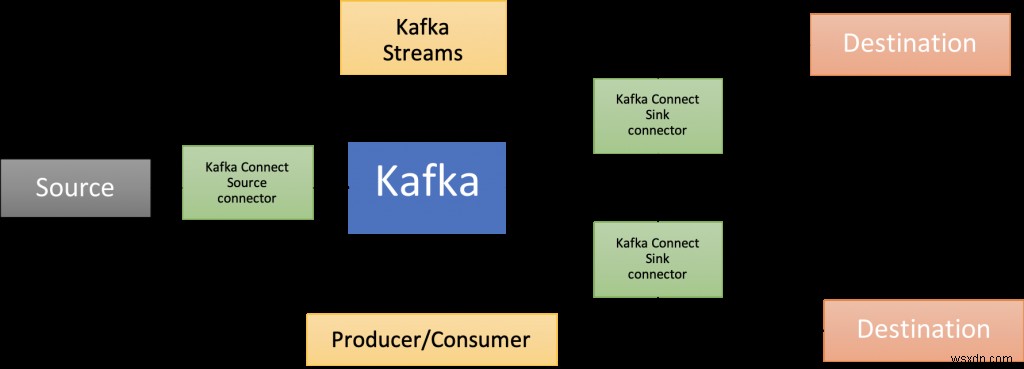
บล็อกนี้ให้ตัวอย่างปฏิบัติจริงของการใช้ RedisTimeSeries ร่วมกับ Apache Kafka สำหรับวิเคราะห์ข้อมูล time-series
โค้ดพร้อมใช้งานที่ GitHub repo https://github.com/abhirockzz/redis-timeseries-kafka
เริ่มจากสำรวจ use case ก่อน โปรดทราบว่ามีการทำให้เข้าใจง่ายเพื่อวัตถุประสงค์ของบล็อก และจะอธิบายเพิ่มเติมในส่วนต่อไป
สถานการณ์: การตรวจสอบอุปกรณ์
จินตนาการว่ามีหลายสถานที่ แต่ละแห่งมีอุปกรณ์หลายตัว และคุณต้องรับผิดชอบตรวจสอบเมตริกอุปกรณ์—ตอนนี้พิจารณาเฉพาะอุณหภูมิและความดัน เมตริกเหล่านี้จะเก็บไว้ใน RedisTimeSeries (แน่นอน!) และใช้ naming convention สำหรับ key คือ temp:5:1 แต่ละจุดข้อมูล time-series จะมี Labels (key-value pairs) ดังนี้—metric, location, device เพื่อให้คิวรีได้อย่างยืดหยุ่น ตามที่จะเห็นในส่วนถัดไป
นี่คือตัวอย่างการเพิ่มจุดข้อมูลด้วยคำสั่ง TS.ADD:
# อุณหภูมิของอุปกรณ์ 2 ในสถานที่ 3 พร้อม labels:
TS.ADD temp:3:2 * 20 LABELS metric temp location 3 device 2
# ความดันของอุปกรณ์ 2 ในสถานที่ 3:
TS.ADD pressure:3:2 * 60 LABELS metric pressure location 3 device 2
สถาปัตยกรรมโซลูชัน
ภาพรวมระดับสูงของโซลูชัน:
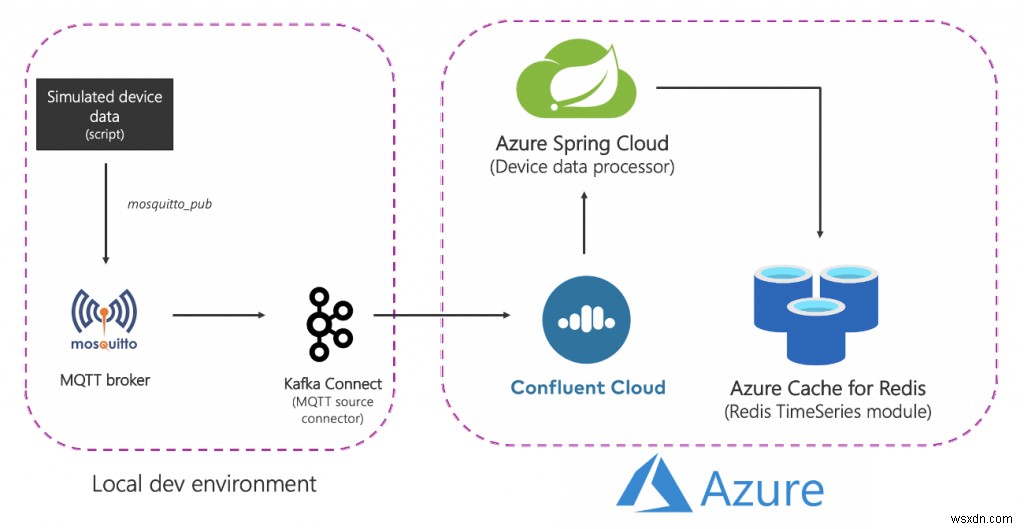
ลองแยกส่วนดู:
ส่วนประกอบแหล่งที่มา (local)
- MQTT broker (mosquitto): MQTT เป็นโปรโตคอลมาตรฐานสำหรับ IoT สถานการณ์ที่ใช้เป็นการผสมผสานระหว่าง IoT และ Time Series — รายละเอียดในภายหลัง
- Kafka Connect: ใช้ MQTT source connector ส่งข้อมูลจาก MQTT broker ไปยัง Kafka cluster
บริการ Azure
- Azure Cache for Redis Enterprise tiers: ระดับ Enterprise ตามบน Redis Enterprise รุ่นพาณิชย์ของ Redis จาก Redis นอกจาก RedisTimeSeries แล้ว Enterprise tier ยังรองรับ RediSearch และ RedisBloom ลูกค้าไม่ต้องกังวลเรื่อง license Azure Cache for Redis จะช่วยดำเนินการได้ ผ่านข้อเสนอ Azure Marketplace
- Confluent Cloud on Azure: บริการ Apache Kafka แบบจัดการเต็มรูปแบบ ด้วยเลเยอร์การจัดเตรียมรวมจาก Azure ไป Confluent Cloud ลดภาระการจัดการข้ามแพลตฟอร์ม และประสบการณ์รวมสำหรับการใช้ Confluent Cloud บนโครงสร้างพื้นฐาน Azure ช่วยให้ผสานรวมกับแอปพลิเคชัน Azure ได้ง่าย
- Azure Spring Cloud: ปรับให้การปรับใช้ Spring Boot microservices บน Azure ง่ายขึ้น Azure Spring Cloud แก้ปัญหาโครงสร้างพื้นฐาน จัดการการตั้งค่า service discovery CI/CD integration การปรับใช้แบบ blue-green และอื่นๆ บริการทำหน้าที่หนักๆ ให้นักพัฒนาโฟกัสที่โค้ด
โปรดทราบว่าบางบริการโฮสต์ในท้องถิ่นเพื่อความเรียบง่าย ในระดับ production ควรรันบน Azure เช่น สามารถรัน Kafka Connect cluster พร้อม MQTT connector ใน Azure Kubernetes Service
สรุปโฟลว์ end-to-end:
- สคริปต์สร้างข้อมูลอุปกรณ์จำลอง ส่งไปยัง MQTT broker ท้องถิ่น
- ข้อมูลถูกดึงโดย MQTT Kafka Connect source connector ส่งไปยัง topic ใน Confluent Cloud Kafka cluster บน Azure
- ประมวลผลเพิ่มเติมโดย Spring Boot app บน Azure Spring Cloud แล้วเก็บลง Azure Cache for Redis instance
ถึงเวลาเริ่มส่วนปฏิบัติ! ก่อนนั้น ตรวจสอบให้แน่ใจว่ามีสิ่งต่อไปนี้:
ข้อกำหนดเบื้องต้น:
- บัญชี Azure — สร้างฟรีได้ที่นี่
- ติดตั้ง Azure CLI
- JDK 11 เช่น OpenJDK
- Maven และ Git เวอร์ชันล่าสุด
ตั้งค่าองค์ประกอบโครงสร้างพื้นฐาน
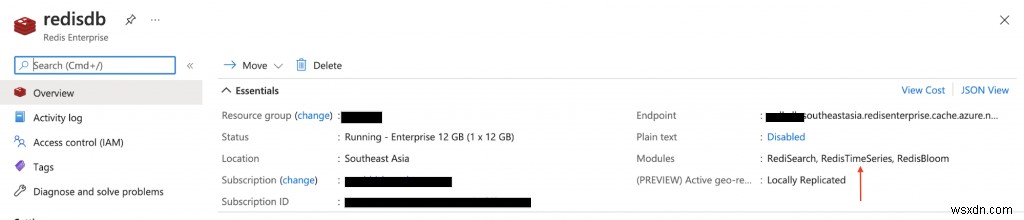
ทำตามเอกสารเพื่อจัดเตรียม Azure Cache for Redis (Enterprise Tier) ซึ่งมาพร้อมโมดูล RedisTimeSeries
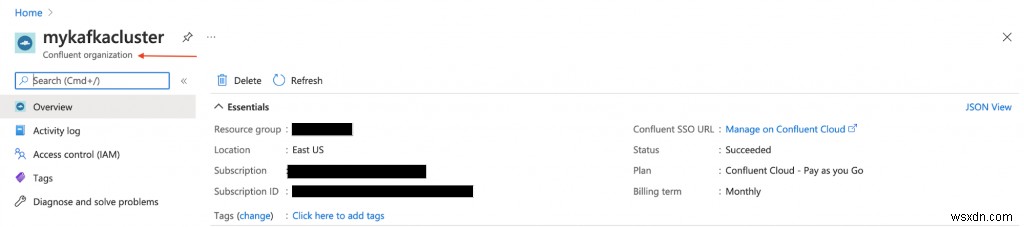
จัดเตรียม Confluent Cloud cluster บน Azure Marketplace สร้าง Kafka topic (ใช้ชื่อ mqtt.device-stats) และสร้าง credentials (API key และ secret) สำหรับเชื่อมต่อ cluster อย่างปลอดภัย
สามารถจัดเตรียม Azure Spring Cloud instance ผ่าน Azure portal หรือ Azure CLI:
az spring-cloud create -n <name of Azure Spring Cloud service> -g <resource group name> -l <enter location e.g southeastasia>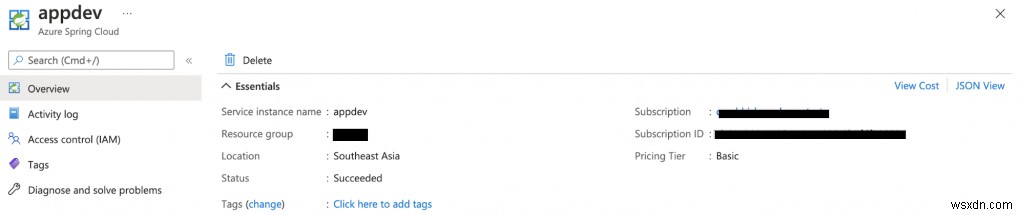
ก่อนต่อไป ให้ clone GitHub repo:
git clone https://github.com/abhirockzz/redis-timeseries-kafka
cd redis-timeseries-kafka
ตั้งค่าบริการท้องถิ่น
ส่วนประกอบประกอบด้วย:
- Mosquitto MQTT broker
- Kafka Connect พร้อม MQTT source connector
- Grafana สำหรับติดตามข้อมูล time-series บนแดชบอร์ด
MQTT broker
ติดตั้งและเริ่ม mosquitto broker ในเครื่อง Mac ท้องถิ่น
brew install mosquitto
brew services start mosquitto
ทำตามขั้นตอนตาม OS หรือใช้ Docker image ก็ได้
Grafana
ติดตั้งและเริ่ม Grafana ในเครื่อง Mac ท้องถิ่น
brew install grafana
brew services start grafana
ทำได้เหมือนกันสำหรับ OS อื่น หรือใช้ Docker image:
docker run -d -p 3000:3000 --name=grafana -e "GF_INSTALL_PLUGINS=redis-datasource" grafana/grafanaKafka Connect
ควรหาไฟล์ connect-distributed.properties ใน repo ที่ clone มา แทนที่ค่าสำหรับ properties เช่น bootstrap.servers, sasl.jaas.config ฯลฯ
ดาวน์โหลดและแตกไฟล์ Apache Kafka ในเครื่อง
เริ่ม Kafka Connect cluster ท้องถิ่น:
export KAFKA_INSTALL_DIR=<kafka installation directory e.g. /home/foo/kafka_2.12-2.5.0>
$KAFKA_INSTALL_DIR/bin/connect-distributed.sh connect-distributed.properties
ติดตั้ง MQTT source connector แบบ manual:
- ดาวน์โหลดไฟล์ ZIP connector/plugin จากลิงก์นี้
- แตกไฟล์ลงในหนึ่งในไดเรกทอรีที่ระบุใน plugin.path ของ Connect worker
หากใช้ Confluent Platform ในท้องถิ่น ให้ใช้ Confluent Hub CLI: confluent-hub install confluentinc/kafka-connect-mqtt:latest
สร้าง instance ของ MQTT source connector
ตรวจสอบไฟล์ mqtt-source-config.json ใส่ topic name ให้ถูกต้องสำหรับ kafka.topic และปล่อย mqtt.topics ไว้เดิม
curl -X POST -H 'Content-Type: application/json' https://localhost:8083/connectors -d @mqtt-source-config.json
# รอประมาณ 1 นาที ก่อนตรวจสอบสถานะ connector
curl https://localhost:8083/connectors/mqtt-source/status
ปรับใช้แอปพลิเคชันประมวลผลข้อมูลอุปกรณ์
ใน GitHub repo ที่ clone มา หาไฟล์ application.yaml ใน consumer/src/resources folder และแทนที่ค่าสำหรับ:
- Azure Cache for Redis host, port และ primary access key
- Confluent Cloud on Azure API key และ secret
สร้างไฟล์ JAR ของแอปพลิเคชัน:
cd consumer
export JAVA_HOME=<enter absolute path e.g. /Library/Java/JavaVirtualMachines/zulu-11.jdk/Contents/Home>
mvn clean package
สร้าง Azure Spring Cloud application และปรับใช้ JAR:
az spring-cloud app create -n device-data-processor -s <name of Azure Spring Cloud instance> -g <name of resource group> --runtime-version Java_11
az spring-cloud app deploy -n device-data-processor -s <name of Azure Spring Cloud instance> -g <name of resource group> --jar-path target/device-data-processor-0.0.1-SNAPSHOT.jar
เริ่มตัวสร้างข้อมูลอุปกรณ์จำลอง
ใช้สคริปต์ใน GitHub repo:
./gen-timeseries-data.shหมายเหตุ—สคริปต์เพียงใช้คำสั่ง mosquitto_pub CLI ส่งข้อมูล
ข้อมูลส่งไปยัง MQTT topic device-stats (นี่ ไม่ใช่ Kafka topic) ตรวจสอบได้ด้วย CLI subscriber:
mosquitto_sub -h localhost -t device-statsตรวจสอบ Kafka topic ใน Confluent Cloud portal ตรวจสอบ log ของ device data processor app ใน Azure Spring Cloud:
az spring-cloud app logs -f -n device-data-processor -s <name of Azure Spring Cloud instance> -g <name of resource group>เพลิดเพลินกับแดชบอร์ด Grafana!
เปิด Grafana UI ที่ localhost:3000
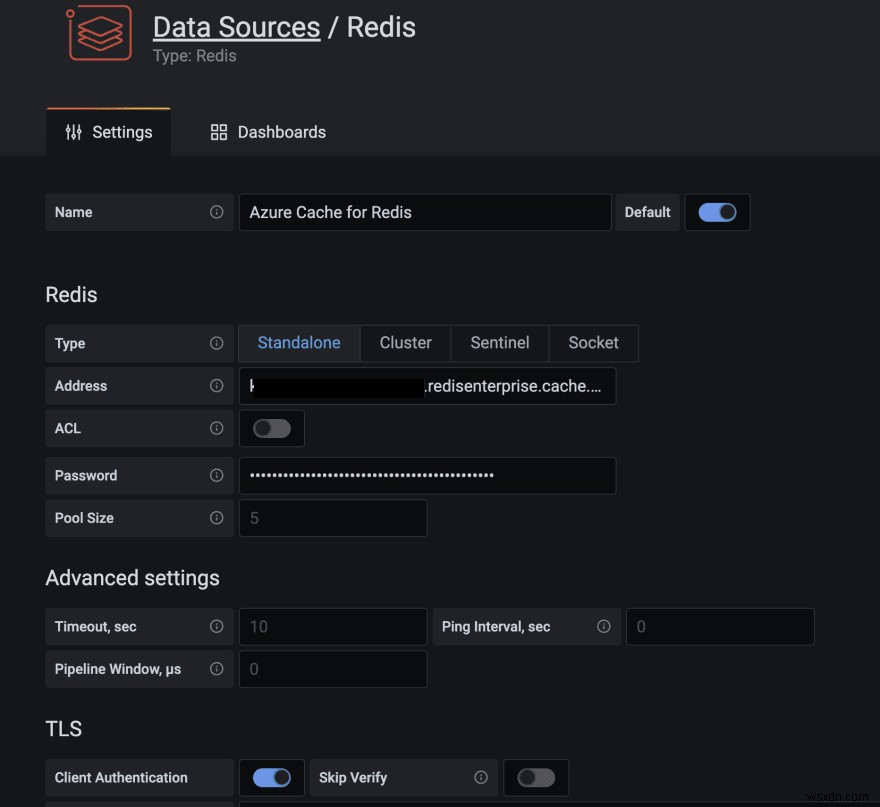
Redis Data Source plugin สำหรับ Grafana ทำงานกับฐานข้อมูล Redis ใดๆ รวมถึง Azure Cache for Redis ทำตามคำแนะนำในบล็อกนี้เพื่อตั้งค่า data source
นำเข้าแดชบอร์ดในโฟลเดอร์ grafana_dashboards ใน GitHub repo ที่ clone (ดูเอกสาร Grafana หากต้องการช่วยเหลือเรื่องการนำเข้าแดชบอร์ด)
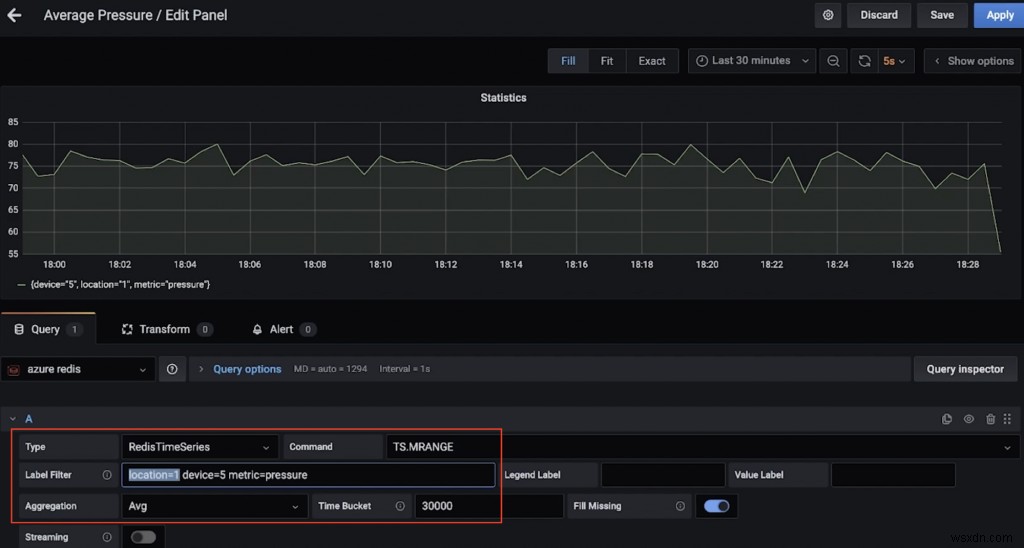
ตัวอย่าง แดชบอร์ดแสดงความดันเฉลี่ย (30 วินาที) สำหรับอุปกรณ์ 5 ในสถานที่ 1 (ใช้ TS.MRANGE)
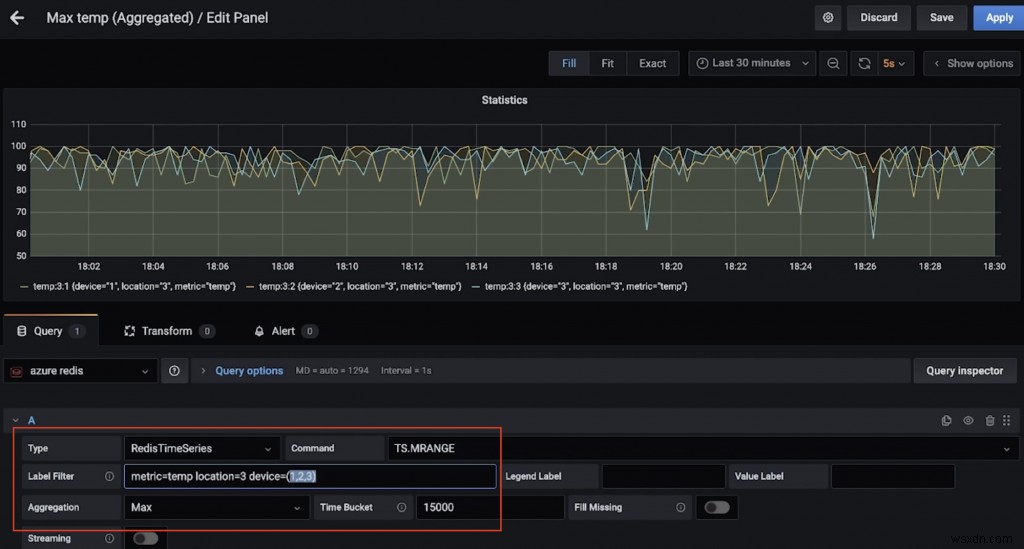
อีกแดชบอร์ดหนึ่ง แสดงอุณหภูมิสูงสุด (15 วินาที) สำหรับอุปกรณ์หลายตัวในสถานที่ 3 (เช่นกัน ใช้ TS.MRANGE)
อยากรันคำสั่ง RedisTimeSeries บ้าง?
เปิด redis-cli และเชื่อมต่อ Azure Cache for Redis instance:
redis-cli -h <azure redis hostname e.g. myredis.southeastasia.redisenterprise.cache.azure.net> -p 10000 -a <azure redis access key> --tlsเริ่มจากคิวรีง่ายๆ:
# ความดันในอุปกรณ์ 5 สถานที่ 1
TS.GET pressure:1:5
# อุณหภูมิในอุปกรณ์ 5 สถานที่ 4
TS.GET temp:4:5
กรองตามสถานที่ และดึงอุณหภูมิและความดันสำหรับ ทุก อุปกรณ์:
TS.MGET WITHLABELS FILTER location=3ดึงอุณหภูมิและความดันสำหรับทุกอุปกรณ์ในหนึ่งหรือหลายสถานที่ ภายในช่วงเวลาเฉพาะ:
TS.MRANGE - + WITHLABELS FILTER location=3
TS.MRANGE - + WITHLABELS FILTER location=(3,5)
– + หมายถึงทุกอย่างตั้งแต่ต้นจนถึง timestamp ล่าสุด แต่สามารถระบุเจาะจงได้
MRANGE คือสิ่งที่เราต้องการ! สามารถกรองอุปกรณ์เฉพาะในสถานที่ และเจาะลึกลงไปอุณหภูมิหรือความดัน:
TS.MRANGE - + WITHLABELS FILTER location=3 device=2
TS.MRANGE - + WITHLABELS FILTER location=3 metric=temp
TS.MRANGE - + WITHLABELS FILTER location=3 device=2 metric=temp
ทั้งหมดรวมกับ aggregation ได้
# จุดข้อมูลอุณหภูมิทั้งหมดไม่คุ้มค่า ลองเฉลี่ย (หรือ max) แทนทุกจุด?
TS.MRANGE - + WITHLABELS AGGREGATION avg 10000 FILTER location=3 metric=temp
TS.MRANGE - + WITHLABELS AGGREGATION max 10000 FILTER location=3 metric=temp
ยังสามารถสร้าง rule เพื่อ aggregation นี้และเก็บใน time series อื่นได้
เมื่อเสร็จสิ้น อย่าลืมลบทรัพยากรเพื่อหลีกเลี่ยงค่าใช้จ่ายที่ไม่ต้องการ
ลบทรัพยากร
- ทำตามขั้นตอนในเอกสารเพื่อลบ Confluent Cloud cluster—เพียงลบ Confluent organization
- เช่นกัน ควรลบ Azure Cache for Redis instance
บนเครื่องท้องถิ่น:
- หยุด Kafka Connect cluster
- หยุด mosquito broker (เช่น brew services stop mosquito)
- หยุด Grafana service (เช่น brew services stop grafana)
เราสำรวจไปป์ไลน์ข้อมูลสำหรับ ingest, process, และ query ข้อมูล time-series ด้วย Redis และ Kafka เมื่อคิดถึงขั้นตอนต่อไปและย้ายไปโซลูชันระดับ production ควรพิจารณาอีกสักเล็กน้อย
ข้อพิจารณาเพิ่มเติม
เพิ่มประสิทธิภาพ RedisTimeSeries
- Retention policy: ควรคิดเพราะจุดข้อมูล time-series ไม่ ถูกตัดหรือลบโดยอัตโนมัติ
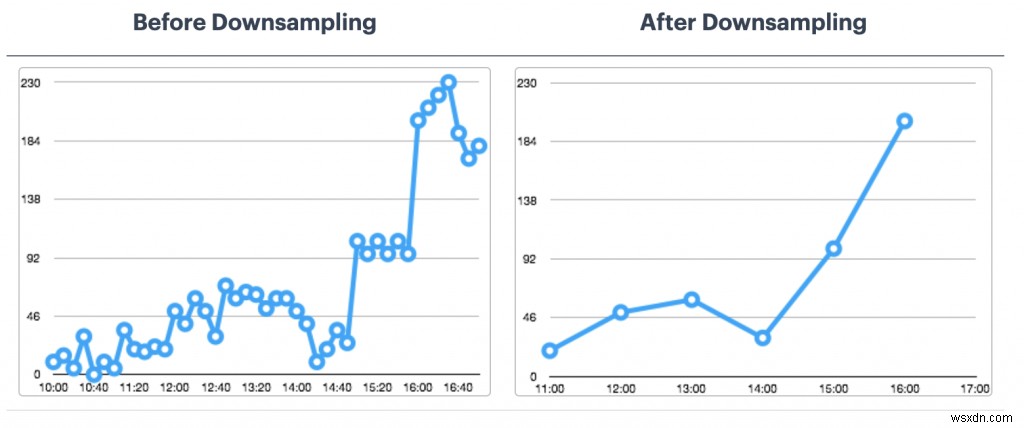
- Down-sampling และ Aggregation Rules: ไม่อยากเก็บข้อมูลตลอดไป ตั้ง rule ให้เหมาะสม (เช่น
TS.CREATERULE temp:1:2 temp:avg:30 AGGREGATION avg 30000) - Duplicate data policy: จะจัดการ duplicate samples อย่างไร? ตรวจสอบว่า default policy (BLOCK) ตรงความต้องการหรือไม่ ถ้าไม่ พิจารณาตัวเลือกอื่น
ไม่ใช่รายการครบถ้วน สำหรับตัวเลือกการตั้งค่าอื่นๆ โปรดดูเอกสาร RedisTimeSeries
การเก็บรักษาข้อมูลระยะยาว?
ข้อมูลมีค่า รวมถึง time series! อาจต้องการประมวลผลต่อ (เช่น รัน machine learning ดึงข้อมูลเชิงลึก predictive maintenance ฯลฯ) เพื่อให้เป็นไปได้ ต้องเก็บข้อมูลนานขึ้น และเพื่อคุ้มค่าและมีประสิทธิภาพ ควรใช้ object storage ที่ขยายได้ เช่น Azure Data Lake Storage Gen2 (ADLS Gen2)
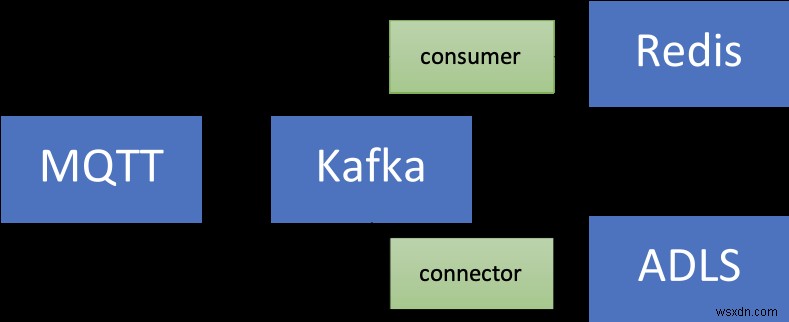
มี connector สำหรับสิ้นี้! สามารถปรับปรุงไปป์ไลน์ข้อมูลเดิมโดยใช้ Azure Data Lake Storage Gen2 Sink Connector แบบจัดการเต็มรูปแบบสำหรับ Confluent Cloud เพื่อประมวลผลและเก็บข้อมูลใน ADLS แล้วรัน machine learning ด้วย Azure Synapse Analytics หรือ Azure Databricks
ความสามารถในการขยาย
ปริมาณข้อมูล time-series เพิ่มขึ้นเพียงทางเดียว—ขึ้น! โซลูชันต้องขยายได้:
- โครงสร้างพื้นฐานหลัก: บริการจัดการให้ทีมโฟกัสที่โซลูชันแทนการตั้งค่าและบำรุงรักษาโครงสร้างพื้นฐาน โดยเฉพาะระบบกระจายที่ซับซ้อนอย่างฐานข้อมูลและสตรีมมิ่ง platform เช่น Redis และ Kafka
- Kafka Connect: สำหรับไปป์ไลน์ข้อมูล Kafka Connect platform เป็น stateless และขยายได้แนวนอนโดยธรรมชาติ มีตัวเลือกมากในการสถาปัตยกรรมและขนาด Kafka Connect worker clusters
- แอปพลิเคชันแบบกำหนดเอง: เหมือนในโซลูชันนี้ สร้างแอปพลิเคชันประมวลผลข้อมูลใน Kafka topics คุณสมบัติการขยายเดียวกันใช้ได้ ขยายแนวนอน จำกัดเฉพาะจำนวน Kafka topic partitions
การผสานรวม: ไม่ใช่แค่ Grafana! RedisTimeSeries ผสานกับ Prometheus และ Telegraf ได้ แต่ไม่มี Kafka connector ณ เวลาเขียนบล็อกนี้—จะเป็น add-on ที่ยอดเยี่ยม!
สรุป
แน่นอน สามารถใช้ Redis สำหรับ (เกือบ) ทุกอย่าง รวมถึง workload time-series! อย่าลืมคิดถึงสถาปัตยกรรม end-to-end สำหรับไปป์ไลน์ข้อมูลและการผสานรวม ตั้งแต่แหล่งข้อมูล time-series จนถึง Redis และต่อไป
