

บทความนี้เกี่ยวกับสองสิ่งที่ผมคิดว่าน่าตื่นเต้นที่สุดในโลก: โครงสร้างข้อมูลเชิงความน่าจะเป็น (probabilistic data structures) และโมดูล Redis (Redis modules) หากคุณเคยได้ยินเรื่องหนึ่งในสองอย่างนี้ คุณคงจะเข้าใจความตื่นเต้นของผม แต่ถ้าคุณอยากตามทันสิ่งดีๆ ที่สุดบนโลก ก็อ่านต่อไปได้เลย
เริ่มต้นด้วยข้อความนี้: การประมวลผลข้อมูลขนาดใหญ่ด้วยเวลาแฝงต่ำ (low-latency) เป็นเรื่องท้าทาย ปริมาณและความเร็วของข้อมูลที่เกี่ยวข้องสามารถทำให้การวิเคราะห์แบบเรียลไทม์เป็นเรื่องที่ต้องการทรัพยากรมากมาย เนื่องจากประสิทธิภาพสูงและความหลากหลาย Redis จึงมักถูกใช้เพื่อแก้ปัญหาเช่นนี้ ความสามารถในการจัดเก็บ จัดการ และส่งมอบข้อมูลหลายรูปแบบในเวลาไม่ถึงมิลลิวินาที ทำให้ Redis เป็นที่เก็บข้อมูลที่เหมาะสมในหลายกรณีที่ต้องการการคำนวณออนไลน์
แต่ทุกอย่างเป็นสัมพัทธ์ มีมาตราส่วนที่ใหญ่โตมากจนทำให้การวิเคราะห์แบบเรียลไทม์ที่แม่นยำกลายเป็นเรื่องเป็นไปไม่ได้ในทางปฏิบัติ ปัญหาที่ซับซ้อนจะยิ่งยากขึ้นเมื่อขนาดใหญ่ขึ้น แต่มันเรามักลืมว่าปัญหาเรียบง่ายก็ปฏิบัติตามกฎเดียวกัน แม้แต่การบวกเลขพื้นฐานก็กลายเป็นภาระมหึมาเมื่อข้อมูลใหญ่เกินไป เร็วเกินไป หรือเมื่อเราไม่มีทรัพยากรพอที่จะประมวลผล และในขณะที่ทรัพยากรมีจำกัดและมีค่าใช้จ่ายสูง ข้อมูลก็เติบโตต่อเนื่องเหมือนไม่มีใครรู้แล้ว
Count-Min Sketch คืออะไร?
Count-Min Sketch (หรือ CM Sketch) เป็นโครงสร้างข้อมูลเชิงความน่าจะเป็นที่มีประโยชน์อย่างยิ่งเมื่อคุณเข้าใจว่ามันทำงานอย่างไร และสำคัญกว่า คือ วิธีใช้งานมัน
โชคดีที่ลักษณะเฉพาะของ CM Sketch ที่เรียบง่าย ทำให้มันเข้าใจง่ายสำหรับมือใหม่ (ได้ที่เพื่อนๆ หลายคนของผมไม่สามารถติดตามบล็อก Top-K ได้)
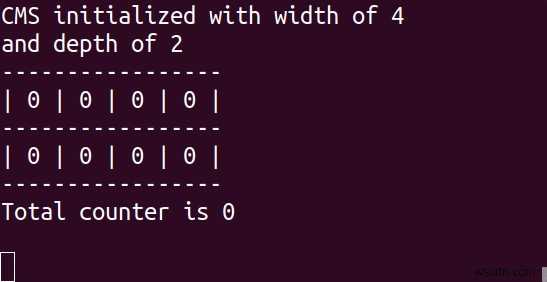
CM Sketch เป็นโมดูล Redis มาหลายปีแล้ว และเพิ่งถูกเขียนใหม่เป็นส่วนหนึ่งของโมดูล RedisBloom v2.0 แต่ก่อนที่เราจะลงลึกเข้าไปใน CM Sketch สิ่งสำคัญคือต้องเข้าใจว่าทำไมถึงใช้ โครงสร้างข้อมูลเชิงความน่าจะเป็น ใดๆ ในสามเหลี่ยมของความเร็ว พื้นที่ และความแม่นยำ โครงสร้างข้อมูลเชิงความน่าจะเป็นแลกความแม่นยำบางส่วนเพื่อแลกกับพื้นที่—อาจจะเป็น พื้นที่มากมาย! ผลกระทบต่อความเร็วแตกต่างกันไปตามอัลกอริทึมและขนาดชุดข้อมูล
- ความแม่นยำ: ตามนิยาม การเก็บเพียงส่วนหนึ่งของข้อมูลและอนุญาตให้เกิดการชนกันในพื้นที่จัดเก็บ ลดความแม่นยำลง แตคุณสามารถกำหนดอัตราความผิดพลาดสูงสุดตามกรณีการใช้งานของคุณได้
- พื้นที่หน่วยความจำ: ในโลกของข้อมูลขนาดใหญ่ที่มีการบันทึกเหตุการณ์หลายพันล้านครั้ง การจัดเก็บเพียงข้อมูลบางส่วนสามารถลดความต้องการพื้นที่จัดเก็บและต้นทุนได้อย่างมาก
- ความเร็ว: โครงสร้างข้อมูลแบบดั้งเดิมบางอย่างทำงานได้ไม่ค่อยมีประสิทธิภาพ ทำให้เวลาตอบสนองช้าลง (เช่น Sorted Set รักษาลำดับของทุกสมาชิก แต่คุณอาจสนใจแค่สมาชิกอันดับต้นๆ เนื่องจากอัลกอริทึมเชิงความน่าจะเป็นเก็บเพียงรายการบางส่วน จึงมีประสิทธิภาพมากกว่าและตอบคำถามได้เร็วกว่าบ่อยครั้ง)
โครงสร้างข้อมูลเชิงความน่าจะเป็นที่เหมาะสมจะช่วยให้คุณเก็บเพียงส่วนหนึ่งของข้อมูลในชุดข้อมูลของคุณ แลกกับความแม่นยำที่ลดลง อย่างไรก็ตาม ในหลายกรณี (เช่น บัญชีธนาคาร) ความแม่นยำที่ลดลงเป็นสิ่งที่ยอมรับไม่ได้ แต่สำหรับการแนะนำหนังหรือแสดงโฆษณาให้ผู้ใช้เว็บไซต์ ต้นทุนของข้อผิดพลาดที่นادرةพอสมควรคือต่ำ และการประหยัดพื้นที่อาจใหญ่โต
โดยพื้นฐาน CM Sketch ทำงานโดยการรวมจำนวนของทุกไอเท็มในชุดข้อมูลของคุณเข้าไปในอาร์เรย์ตัวนับหลายอาร์เรย์ เมื่อมีการสอบถาม มันจะคืนค่าจำนวนน้อยที่สุดของไอเท็มนั้นจากทุกอาร์เรย์ ซึ่งช่วยลดการเพิ่มจำนวนขึ้นจากการชนกัน ไอเท็มที่มีอัตราการปรากฏหรือคะแนนต่ำ ("mouse flows") จะมีจำนวนน้อยกว่า อัตราความผิดพลาด ดังนั้นคุณสูญเสียข้อมูลเกี่ยวกับจำนวนจริงของพวกเขาและถูกจัดว่าเป็นสัญญาณรบกวน สำหรับไอเท็มที่มีอัตราการปรากฏหรือคะแนนสูง ("elephant flows") เพียงแค่ใช้จำนวนที่ได้รับ ถ้าพิจารณาขนาดของ CM Sketch ที่คงที่และสามารถใช้สำหรับไอเท็มจำนวนไม่จำกัด คุณจะเห็นศักยภาพในการประหยัดพื้นที่จัดเก็บที่มหาศาล
สำหรับพื้นหลัง Sketch เป็นคลาสของโครงสร้างข้อมูลและอัลกอริทึมที่ร่วมกัน พวกเขาจับลักษณะของข้อมูลของคุณเพื่อตอบคำถามเกี่ยวกับมัน ในขณะที่ใช้พื้นที่คงที่หรือเชิงเส้นย่อย (sublinear) CM Sketch ถูกอธิบายโดย Graham Cormode และ S. Muthu Muthukrishnan ในเอกสารประกอบปี 2005 ที่เรียกว่า "An Improved Data Stream Summary: The Count-Min Sketch and its Applications"
Count-Min Sketch: คืออะไรและทำงานอย่างไร
CM Sketch ใช้อาร์เรย์ตัวนับหลายอาร์เรย์เพื่อรองรับกรณีการใช้งานหลัก เรียกจำนวนอาร์เรย์ว่า "depth" (ความลึก) และจำนวนตัวนับในแต่ละอาร์เรย์ว่า "width" (ความกว้าง)
ทุกครั้งที่เราได้รับไอเท็ม เราใช้ฟังก์ชันแฮช (ซึ่งแปลงองค์ประกอบ—คำ ประโยค ตัวเลข หรือไบนารี—ให้เป็นตัวเลขที่สามารถใช้เป็นตำแหน่งในเซต/อาร์เรย์ หรือเป็นลายนิ้วมือ) เพื่อคำนวณตำแหน่งของไอเท็มและเพิ่มตัวน้ำนั้นในทุกอาร์เรย์ ตัวนับที่เกี่ยวข้องแต่ละตัวมีค่าเท่ากับหรือสูงกว่าค่าจริงของไอเท็ม เมื่อเราทำการสอบถาม เราจะผ่านทุกอาร์เรย์ด้วยฟังก์ชันแฮชเดียวกันและดึงตัวนับที่เกี่ยวข้องกับไอเท็มของเรา จากนั้นคืนค่าต่ำสุดที่เราพบ เนื่องจากเรารู้ว่าค่าของเราถูกเพิ่มขึ้น (หรือเท่ากัน)
แม้เราจะรู้ว่ามีไอเท็มหลายอย่างมีส่วนร่วมในตัวนับส่วนใหญ่ เนื่องจากการชนกันตามธรรมชาติ (เมื่อไอเท็มต่างๆ ได้รับตำแหน่งเดียวกัน) เรายอมรับ "สัญญาณรบกวน" ตราบใดที่มันอยู่ภายในอัตราความผิดพลาดที่เราต้องการ
ตัวอย่าง Count-Min Sketch
คณิตศาสตร์บ่งชี้ว่าด้วย depth 10 และ width 2,000 ความน่าจะเป็นที่จะไม่มีข้อผิดพลาดคือ 99.9% และอัตราความผิดพลาดคือ 0.1% (นี่คือเปอร์เซ็นต์ของจำนวนการเพิ่มทั้งหมด ไใช่ของไอเท็มที่ไม่ซ้ำกัน)
ในตัวเลขจริง หมายความว่าหากคุณเพิ่มไอเท็มที่ไม่ซ้ำกัน 1 ล้านรายการ ในเฉลี่ย แต่ละไอเท็มจะได้รับค่า 500 (1M/2K) แม้จะดูไม่สัดส่วน แต่ก็ยังอยู่ภายในอัตราความผิดพลาด 0.1% ซึ่งคือ 1,000 จาก 1 ล้านไอเท็ม
เช่นเดียวกัน หากมี "ช้าง" 10 ตัวปรากฏ 10,000 ครั้งแต่ละตัว ค่าของพวกเขาบนทุกเซตจะเป็น 10,000 หรือมากกว่า ทุกครั้งที่เรานับพวกเขาในอนาคต เราจะเห็นช้างอยู่ข้างหน้า สำหรับตัวเลขอื่นๆ ทั้งหมด (คือ หนูทั้งหมดที่จำนวนจริงคือ 1) พวกเขาไม่น่าจะชนกับช้างบนทุกเซต (เพราะ CM Sketch พิจารณาเฉพาะจำนวนน้อยที่สุด) เนื่องจากความน่าจะเป็นที่จะเกิดขึ้นนี้น้อยและลดลงไปอีกหากคุณเพิ่ม depth เมื่อคุณเริ่มต้น CM Sketch
Count-Min Sketch เหมาะสำหรับอะไร?
ตอนนี้เราเข้าใจพฤติกรรมของ CM Sketch แล้ว เราสามารถทำอะไรกับสัตว์เล็กน้อยนี้ได้บ้าง? นี่คือกรณีการใช้งานทั่วไป:
- สอบถามสองตัวเลขและเปรียบเทียบจำนวนของพวกเขา
- กำหนดเปอร์เซ็นต์ของไอเท็มที่เข้ามา สมมติ 1% ทุกครั้งที่ min-count ของไอเท็มสูงกว่า 1% ของจำนวนทั้งหมด เราคืนค่า true สามารถใช้เพื่อกำหนดผู้เล่นอันดับหนึ่งของเกมออนไลน์ได้
- เพิ่ม min-heap เข้าไปใน CM Sketch และสร้างโครงสร้างข้อมูล Top-K ทุกครั้งที่เพิ่มไอเท็ม เราตรวจสอบว่า min-count ใหม่สูงกว่าค่าต่ำสุดใน heap หรือไม่ และอัปเดตตามนั้น ไม่เหมือนโมดูล Top-K ใน RedisBloom ซึ่งลดลงเรื่อยๆ ตามเวลา CM Sketch ไม่เคยลืม ดังนั้นพฤติกรรมของมันจึงแตกต่างจาก Top-K แบบ HeavyKeeper เล็กน้อย
ใน RedisBloom API สำหรับ CM Sketch เรียบง่ายและง่ายต่อการใช้งาน:
- เพื่อเริ่มต้นโครงสร้างข้อมูล CM Sketch: INITBYDIM {key} {width} {depth} หรือ CMS.INITBYPROB {key} {error} {probability}
- เพื่อเพิ่มตัวนับของไอเท็ม: CMS.INCRBY {key} {item} {increment}
- เพื่อรับจำนวนน้อยที่สุดที่พบในตัวนับของไอเท็ม: CMS.QUERY {key} {item}
คำสั่งต่อไปนี้ถูกใช้เพื่อสร้างตัวอย่างแอนิเมชันที่ด้านบนของโพสต์นี้:
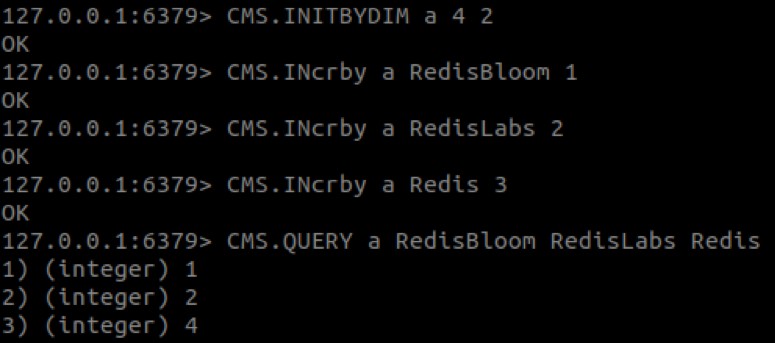
คุณสามารถเห็นได้ว่าค่าของ 'Redis' คือ 4 แทนที่จะเป็น 3 พฤติกรรมนี้คาดการณ์ไว้ได้ เนื่องจากใน CM Sketch จำนวนของไอเท็มมีแนวโน้มที่จะถูกเพิ่มขึ้น
ธุรกิจแบบ Sketchy
วิศวกรรมซอฟต์แวร์ทั้งหมดเกี่ยวกับการแลกเปลี่ยน (trade-offs) และวิธีการที่ได้รับ欢迎ในการแก้ไขปัญหาเช่นนี้อย่างมีประสิทธิภาพด้านต้นทุนคือการยอมเสียความแม่นยำเพื่อแลกกับประสิทธิภาพ วิธีนี้ได้รับการแสดงออกโดยการนำ HyperLogLog ของ Redis ไปใช้ โครงสร้างข้อมูลที่ออกแบบมาเพื่อให้คำตอบเกี่ยวกับความนับของเซต (set cardinality) ได้อย่างมีประสิทธิภาพ HyperLogLog เป็นสมาชิกของ משפחתโครงสร้างข้อมูลที่เรียกว่า "sketches" ซึ่งเช่นเดียวกับเพื่อนร่วมงานทางศิลปะในโลกจริง สื่อสารข้อมูลผ่านการประมาณค่าของหัวข้อของพวกเขา
โดยสรุปแบบกว้างๆ Sketches เป็นโครงสร้างข้อมูล (และอัลกอริทึมที่ร่วมกัน) ที่จับลักษณะของข้อมูลของคุณ—คำตอบสำหรับคำถามของคุณเกี่ยวกับข้อมูล โดยไม่ต้องจัดเก็บข้อมูลเอง อย่างเป็นทางการ Sketches มีประโยชน์เพราะพวกเขามีความซับซ้อนทางคอมพิวตเชิง漸近แบบ sublinear ดังนั้นจึงต้องการพลังคอมพิวตและ/หรือพื้นที่จัดเก็บน้อยกว่า แต่วันนี้ไม่มีอาหารกลางวันฟรี และประโยชน์ด้านประสิทธิภาพถูกชดเชยโดยความแม่นยำของคำตอบ ในหลายกรณี อย่างไรก็ตาม ข้อผิดพลาดยอมรับได้ตราบใดที่สามารถเก็บไว้ภายใต้เกณฑ์หนึ่ง Sketch ที่ดีคือ Sketch ที่ยอมรับข้อผิดพลาดของมันอย่างง่ายดาย และในความเป็นจริง Sketches หลายตัวทำให้ข้อผิดพลาด (หรือความน่าจะเป็นของข้อผิดพลาดเหล่านั้น) เป็นพารามิเตอร์ เพื่อให้สามารถกำหนดได้โดยผู้ใช้
Sketches ที่ดีมีประสิทธิภาพและมีความน่าจะเป็นของข้อผิดพลาดที่ถูกจำกัด แต่ Sketches ที่ยอดเยี่ยมคือ Sketches ที่สามารถคำนวณแบบขนานได้ Sketch ที่ขนานได้คือ Sketch ที่สามารถเตรียมได้อย่างอิสระบนส่วนต่างๆ ของข้อมูล และอนุญาตให้รวมส่วนๆ ของมันเข้าด้วยกันเป็นรวมที่มีความหมายและสอดคล้องกัน เนื่องจากแต่ละชิ้นของ Sketch ที่ยอดเยี่ยมสามารถคำนวณได้ที่สถานที่ต่างกันและ/หรือเวลาต่างกัน การขนานทำให้เป็นไปได้ที่จะใช้แนวทางแบ่งและเอาชนะ (divide-and-conquer) ที่ตรงไปตรงมาเพื่อแก้ไขปัญหาการขยายขนาด
ปัญหาที่พบบ่อย
HyperLogLog ที่กล่าวมาข้างต้นเป็น Sketch ที่ยอดเยี่ยม แต่เหมาะสมเฉพาะสำหรับการตอบคำถามประเภทเฉพาะ อีกเครื่องมือที่มีค่าไม่แพ้กันคือ Count Min Sketch (CMS) ตามที่อธิบายในเอกสาร "An Improved Data Stream Summary: The Count-Min Sketch and its Applications" โดย G. Cormode และ S. Muthukrishnan อุปกรณ์อัจฉริยะนี้ถูกสร้างขึ้นเพื่อให้คำตอบเกี่ยวกับความถี่ของตัวอย่าง ซึ่งเป็นบล็อกก่อสร้างทั่วไปในเปอร์เซ็นต์สูงของกระบวนการวิเคราะห์
หากมีเวลาและทรัพยากรเพียงพอ การคำนวณความถี่ของตัวอย่างเป็นกระบวนการง่ายๆ — เพียงแค่นับการสังเกต (ครั้งที่เห็น) สำหรับแต่ละตัวอย่าง (สิ่งที่เห็น) จากนั้นหารด้วยจำนวนการสังเกตทั้งหมดเพื่อรับความถี่ของตัวอย่ำนั้น แต่ในบริบทของการประมวลผลข้อมูลขนาดใหญ่เวลาแฝงต่ำ ไม่มีเวลาหรือทรัพยากรพอเลย คำตอบต้องถูกให้ทันทีขณะที่ข้อมูลสตรีมเข้ามา ไม่ว่าขนาดจะใหญ่แค่ไหน และขนาดของพื้นที่ตัวอย่างที่ใหญ่โตทำให้เป็นไปไม่ได้ที่จะเก็บตัวนับสำหรับแต่ละตัวอย่าง
ดังนั้น แทนที่จะติดตามตัวอย่างแต่ละตัวอย่างอย่างแม่นยำ เราสามารถพยายามประมาณความถี่ได้ วิธีหนึ่งคือการสุ่มตัวอย่างการสังเกตและหวังว่าตัวอย่างจะสะท้อนคุณสมบัติของภาพรวม ปัญหาของแนวทางนี้คือการטיחความสุ่มแท้เป็นงานที่ยาก ดังนั้นความสำเร็จของการสุ่มตัวอย่างอาจถูกจำกัดโดยกระบวนการเลือกของเราและ/หรือคุณสมบัติของข้อมูลเอง นี่คือที่ที่ CMS เข้ามาด้วยแนวทางที่แตกต่างกันอย่างรุนแรง จนดูเหมือนจะตรงข้ามกับ Sketch ที่ยอดเยี่ยม: CMS ไม่ได้แค่บันทึกการสังเกตทุกครั้ง แต่แต่ละครั้งก็ยังถูกบันทึกในตัวนับหลายตัวอีกด้วย!
當然有個轉折,而且這轉折既聰明又簡單。原始論文(以及其較輕量版本 "Approximating Data with the Count-Min Data Structure")很好地解釋了這一點,但我還是試著總結一下。CMS 的巧妙之處在於它儲存樣本的方式:它不獨立追蹤每個唯一樣本,而是使用其雜湊值。樣本的雜湊值被用作常數大小(在論文中參數化為 d)的計數器陣列的索引。通過採用多個(參數 w)不同的雜湊函數及其各自的陣列,該草圖通過在查詢結構時選擇與該樣本相關的所有計數器中的最小值來處理發現的雜湊碰撞。
需要一個例子,所以讓我們建立一個簡單的草圖來說明該數據結構的內部運作。為了保持草圖簡單,我們將使用較小的參數值。我們將 w 設為 3,意味著我們將使用三個雜湊函數 - 分別表示為 h1、h2 和 h3,並將 d 設為 4。為了儲存草圖的計數器,我們將使用一個 3×4 的陣列,總共有 12 個元素,初始化為 0。
現在我們可以檢查當樣本被添加到草圖時會發生什麼。假設樣本逐個到達,第一個樣本(記為 s1)的雜湊值為:h1(s1) = 1,h2(s1) = 2,h3(s1) = 3。為了在草圖中記錄 s1,我們將每個雜湊函數在相關索引處的計數器加 1。下表顯示陣列的初始和當前狀態:
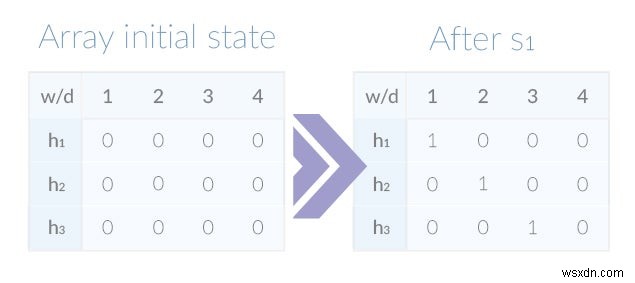
雖然草圖中只有一個樣本,但我們已經可以有效地查詢它。記住,樣本的觀察次數是其所有計數器的最小值,所以對於 s1 來說,它是通過以下方式獲得的:
min(array[1][h₁(s₁)], array[2][h₂(s₁)], array[3][h₃(s₁)]) =
min(array[1][1], array[2][2], array[3][3]) =
min(1,1,1) = 1
草圖也能回答關於尚未添加的樣本的查詢。假設 h₁(s₂) = 4,h₂(s₂) = 4,h₃(s₂) = 4,請注意查詢 s₂ 將返回結果 0。讓我們繼續添加 s₂ 和 s₃ (h₁(s₃) = 1,h₂(s₃) = 1,h₃(s₃) = 1) 到草圖中,得到以下結果:
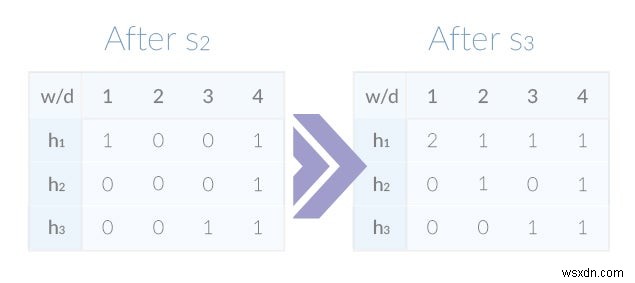
在我們人為設計的例子中,幾乎所有樣本的雜湊值都映射到唯一的計數器,唯一的例外是 h1(s1) 和 h1(s3) 的碰撞。因為兩個雜湊值相同,h1 的第 1 個計數器現在保持值 2。既然草圖選擇所有計數器的最小值,s1 和 s3 的查詢仍然返回正確結果 1。最終,然而,一旦發生足夠多的碰撞,查詢結果將變得不那麼準確。
CMS 的兩個參數 - w 和 d - 決定其空間/時間需求以及錯誤的概率和最大值。一種更直觀的初始化草圖的方法是提供錯誤的概率和上限,讓它然後推導出所需的 w 和 d 值。並行化是可能的,因為任意數量的子草圖可以作為陣列的總和被平凡地合併,只要在建構它們時使用相同的參數和雜湊函數。
關於 Count-Min Sketch 的幾個觀察
Count Min Sketch 的效率可以通過審視其需求來證明。CMS 的空間複雜度是 w、d 和它所使用的計數器寬度的乘積。例如,一個在 0.01% 概率下具有 0.01% 錯誤率的草圖,使用 10 個雜湊函數和 2000 計數器陣列來建立。假設使用 16 位計數器,產生的草圖數據結構的總記憶體需求為 40KB (還需要幾個額外的位元組來儲存觀察總數和幾個指標)。草圖的另一個計算方面同樣令人滿意——因為雜湊函數生成和計算便宜,存取數據結構,無論是讀取還是寫入,也都在常數時間內執行。
CMS 還有更多內容;草圖的作者還展示了如何用它來回答其他類似的問題。其中包括估計百分位數和識別重點項目 (heavy hitters / frequent items) 但超出了本文的範圍。
CMS 無疑是一個優秀的草圖,但至少有兩件事阻止它達到完美。我對 CMS 的第一個保留意見是它可能有偏差,從而高估觀察次數少的樣本的頻率。CMS 的偏差眾所周知,並提出了幾種改進。最近的是 Count Min Log Sketch ("Approximately counting with approximate counters" 來自 G. Pitel 和 G. Fouquier),本質上用對數寄存器取代 CMS 的線性寄存器,以減少相對誤差並允許更高的計數而不增加計數器寄存器的寬度。
雖然上述保留意見為大家所共享(儘管僅限於那些看懂數據結構的人),但我的第二個保留意見專屬於 Redis 社區。為了解釋這一點,我必須介紹 Redis Modules。
Redis Module
Redis Modules 今年早些時候在 RedisConf 上由 antirez 發布,徹底改變了我們的世界。它們無非是可加載的動態庫,Modules 允許 Redis 用戶比 Redis 本身跑得更快,去到以前從未夢想過的地方。雖然這篇文章不是關於 Modules 是什麼或如何製作它們的介紹,但這篇文章是(以及這篇文章,和這個網絡研討會)。
我有幾個原因想寫 Count Min Sketch Redis module,除了它極其有用之外。部分是學習經驗,部分是對 Modules API 的評估,但主要是因為將新數據結構建模到 Redis 中非常有趣。該模組提供了一個 Redis 介面,用於向草圖添加觀察、查詢它,以及將多個草圖合併為一個。
該模組將草圖的數據儲存在 Redis String 中,並使用直接記憶體存取 (DMA) 將鍵的內容映射到其內部數據結構。我還沒有對它進行詳細的效能基準測試,但我從本地測試的最初印象是,它的表現與任何核心 Redis 命令一樣好。像我們其他的模組一樣,countminsketch 是開源的,我鼓勵你嘗試並修改它。
在結束之前,我想兌現承諾,分享我關於 CMS 的 Redis 特有保留意見。這個問題也適用於其他草圖和數據結構,那就是 CMS 要求你在使用前先設置/初始化/創建它。要求強制初始化階段,例如 CMS 參數設置,打破了 Redis 的基本模式之一——數據結構不需要在使用前顯式聲明,因為它們可以按需創建。為了讓模組看起來更像 Redis 並繞過這個反模式,當隱含地暗示新草圖時(即在不存在的鍵上使用 CMS.ADD 命令),模組使用預設參數值,但也允許使用給定參數創建新的空草圖。
概率數據結構,或草圖,是驚人的工具,讓我們能夠以高效且足夠準確的方式跟上大數據增長和延遲預算縮減的步伐。本文提到的兩個草圖,以及其他如 Bloom Filter 和 T-digest,正迅速成為現代數據販子武器庫中不可或缺的工具。Modules 允許您使用在原生速度下運行並擁有本地數據存取權的自定義數據類型和命令來擴展 Redis。可能性是無限的,沒有什麼是不可能的。
想了解更多關於 Redis modules 以及如何開發它們嗎?有沒有一個數據結構,無論是概率性的還是非概率性的,你想討論或添加到 Redis?隨時通過我的 Twitter 帳戶或電子郵件聯繫我 - 我隨時可用 🙂
