

การออกแบบฐานข้อมูลเชิงสัมพันธ์ (RDD) สร้างแบบจำลองข้อมูลและข้อมูลเป็นชุดของตารางที่มีแถวและคอลัมน์ แต่ละแถวของความสัมพันธ์/ตารางแทนเรคอร์ด และแต่ละคอลัมน์แทนแอตทริบิวต์ของข้อมูล ภาษาสอบถามโครงสร้าง (SQL) ใช้จัดการฐานข้อมูลเชิงสัมพันธ์ การออกแบบฐานข้อมูลเชิงสัมพันธ์ประกอบด้วย 4 ขั้นตอน ซึ่งข้อมูลถูกสร้างแบบจำลองเป็นชุดของตารางที่เกี่ยวข้องกัน ขั้นตอนคือ -
- กำหนดความสัมพันธ์/แอตทริบิวต์
- กำหนดคีย์หลัก
- กำหนดความสัมพันธ์
- การปกติรูป (Normalization)
ฐานข้อมูลเชิงสัมพันธ์แตกต่างจากฐานข้อมูลอื่นในวิธีจัดระเบียบข้อมูลและดำเนินธุรกรรม ใน RDD ข้อมูลจัดระเบียบเป็นตาราง และการเข้าถึงข้อมูลทุกประเภทดำเนินการผ่านธุรกรรมที่ควบคุม การออกแบบฐานข้อมูลเชิงสัมพันธ์ตอบสนองคุณสมบัติ ACID (atomicity, consistency, integrity, durability) ที่ต้องการจากฐานข้อมูล การออกแบบฐานข้อมูลเชิงสัมพันธ์กำหนดให้ใช้เซิร์ฟเวอร์ฐานข้อมูลในแอปพลิเคชันสำหรับจัดการปัญหาข้อมูล
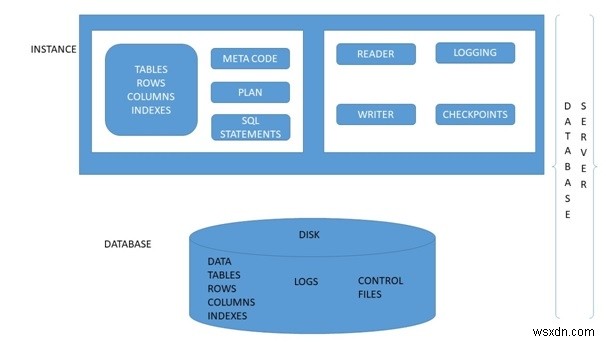
กระบวนการออกแบบฐานข้อมูลเชิงสัมพันธ์
การออกแบบฐานข้อมูลเป็นศิลปะมากกว่าวิทยาศาสตร์ เนื่องจากคุณต้องตัดสินใจหลายอย่าง ฐานข้อมูลมักปรับแต่งให้เหมาะกับแอปพลิเคชันเฉพาะ ไม่มีแอปพลิเคชันที่ปรับแต่งกันเหมือนกัน 2 ตัว และดังนั้น ไม่มีฐานข้อมูล 2 ตัวที่เหมือนกัน แนวทาง (โดยปกติในรูปแบบ מה לא לעשות แทน מה לעשות) ถูกให้มาในการตัดสินใจออกแบบเหล่านี้ แต่ตัวเลือกสุดท้ายอยู่ที่ผู้ออกแบบ
ขั้นตอน 1 - กำหนดวัตถุประสงค์ของฐานข้อมูล (การวิเคราะห์ความต้องการ)
- รวบรวมความต้องการและกำหนดวัตถุประสงค์ของฐานข้อมูลของคุณ
- การเขียนแบบฟอร์มอินพุตตัวอย่าง คิวรี และรายงานช่วยได้มาก
ขั้นตอน 2 - รวบรวมข้อมูล จัดระเบียบในตาราง และระบุคีย์หลัก
- เมื่อคุณตัดสินใจวัตถุประสงค์ของฐานข้อมูลแล้ว ให้รวบรวมข้อมูลที่ต้องจัดเก็บในฐานข้อมูล แบ่งข้อมูลเป็นตารางตามหัวข้อ
- เลือกคอลัมน์หนึ่ง (หรือหลายคอลัมน์) เป็นที่เรียกว่าคีย์หลัก ซึ่งระบุแต่ละแถวอย่างไม่ซ้ำกัน
ขั้นตอน 3 - สร้างความสัมพันธ์ระหว่างตาราง
ฐานข้อมูลที่ประกอบด้วยตารางอิสระและไม่เกี่ยวข้องกันมีประโยชน์น้อย (คุณอาจพิจารณาใช้สเปรดชีตแทน) อำนาจของฐานข้อมูลเชิงสัมพันธ์อยู่ที่ความสัมพันธ์ที่สามารถกำหนดระหว่างตารางได้ ด้านสำคัญที่สุดในการออกแบบฐานข้อมูลเชิงสัมพันธ์คือการระบุความสัมพันธ์ระหว่างตาราง ประเภทของความสัมพันธ์รวมถึง:
- one-to-many
- many-to-many
- one-to-one
One-to-Many
ในฐานข้อมูล "class roster" ครูอาจสอนศูนย์หรือหลายชั้นเรียน ในขณะที่ชั้นเรียนถูกสอนโดยครูคนเดียว (และเพียงคนเดียว) ในฐานข้อมูล "company" ผู้จัดการจัดการศูนย์หรือหลายพนักงาน ในขณะที่พนักงานถูกจัดการโดยผู้จัดการคนเดียว (และเพียงคนเดียว) ในฐานข้อมูล "product sales" ลูกค้าอาจสั่งซื้อหลายออเดอร์ ในขณะที่ออเดอร์ถูกสั่งโดยลูกค้าเฉพาะคนนี้ ประเภทความสัมพันธ์นี้เรียกว่า one-to-many
ความสัมพันธ์ one-to-many ไม่สามารถแสดงในตารางเดียวได้ ตัวอย่างเช่น ในฐานข้อมูล "class roster" เราอาจเริ่มด้วยตารางที่เรียกว่า Teachers ซึ่งจัดเก็บข้อมูลเกี่ยวกับครู (เช่น ชื่อ สำนักงาน โทรศัพท์ และอีเมล) เพื่อจัดเก็บชั้นเรียนที่แต่ละครูสอน เราอาจสร้างคอลัมน์ class1, class2, class3 แต่จะเจอปัญหาทันทีว่าจะสร้างคอลัมน์กี่คอลัมน์ ด้านอื่น ถ้าเราเริ่มด้วยตารางที่เรียกว่า Classes ซึ่งจัดเก็บข้อมูลเกี่ยวกับชั้นเรียน เราอาจสร้างคอลัมน์เพิ่มเติมเพื่อจัดเก็บข้อมูลเกี่ยวกับครู (คนเดียว) (เช่น ชื่อ สำนักงาน โทรศัพท์ และอีเมล) อย่างไรก็ตาม เนื่องจากครูอาจสอนหลายชั้นเรียน ข้อมูลของครูจะถูกซ้ำในหลายแถวในตาราง Classes
เพื่อรองรับความสัมพันธ์ one-to-many เราต้องออกแบบ 2 ตาราง: เช่น ตาราง Classes เพื่อจัดเก็บข้อมูลเกี่ยวกับชั้นเรียนด้วย classID เป็นคีย์หลัก และตาราง Teachers เพื่อจัดเก็บข้อมูลเกี่ยวกับครูด้วย teacherID เป็นคีย์หลัก เราสามารถสร้างความสัมพันธ์ one-to-many ได้โดยการจัดเก็บคีย์หลักของตาราง Teacher (คือ teacherID) (ปลาย "one" หรือ parent table) ในตาราง classes (ปลาย "many" หรือ child table) ตามภาพประกอบด้านล่าง
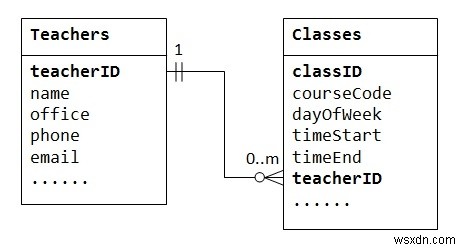 คอลัมน์ teacherID ในตารางลูก Classes เรียกว่าคีย์ต่างประเทศ (foreign key) คีย์ต่างประเทศของตารางลูกคือคีย์หลักของตารางพ่อ ใช้เพื่ออ้างอิงตารางพ่อ
Many-to-Many
ในฐานข้อมูล "product sales" ออเดอร์ของลูกค้าอาจมีสินค้าหนึ่งหรือหลายชิ้น และสินค้าหนึ่งชิ้นสามารถปรากฏในออเดอร์หลายออเดอร์ ในฐานข้อมูล "bookstore" หนังสือหนึ่งเล่มเขียนโดยผู้แต่งหนึ่งหรือหลายคน ในขณะที่ผู้แต่งหนึ่งคนอาจเขียนหนังสือศูนย์หรือหลายเล่ม ประเภทความสัมพันธ์นี้เรียกว่า many-to-many
มาลองทำตัวอย่างด้วยฐานข้อมูล "product sales" เราเริ่มด้วย 2 ตาราง: Products และ Orders ตาราง products มีข้อมูลเกี่ยวกับสินค้า (เช่น ชื่อ คำอธิบาย และ quantityInStock) ด้วย productID เป็นคีย์หลัก ตาราง orders มีออเดอร์ของลูกค้า (customerID, dateOrdered, dateRequired และ status) อีกครั้ง เราไม่สามารถจัดเก็บรายการที่สั่งซื้อบนตาราง Orders ได้ เนื่องจากเราไม่รู้ว่าจะสำรองคอลัมน์กี่คอลัมน์สำหรับรายการ เรายังไม่สามารถจัดเก็บข้อมูลออเดอร์ในตาราง Products ได้
เพื่อรองรับความสัมพันธ์ many-to-many เราต้องสร้างตารางที่ 3 (ที่เรียกว่า junction table) เช่น OrderDetails (หรือ OrderLines) โดยแต่ละแถวแทนรายการของออเดอร์เฉพาะ สำหรับตาราง OrderDetails คีย์หลักประกอบด้วย 2 คอลัมน์: orderID และ productID ที่ระบุแต่ละแถวอย่างไม่ซ้ำกัน คอลัมน์ orderID และ productID ในตาราง OrderDetails ใช้เพื่ออ้างอิงตาราง Orders และ Products ดังนั้น จึงเป็นคีย์ต่างประเทศในตาราง OrderDetails ด้วย
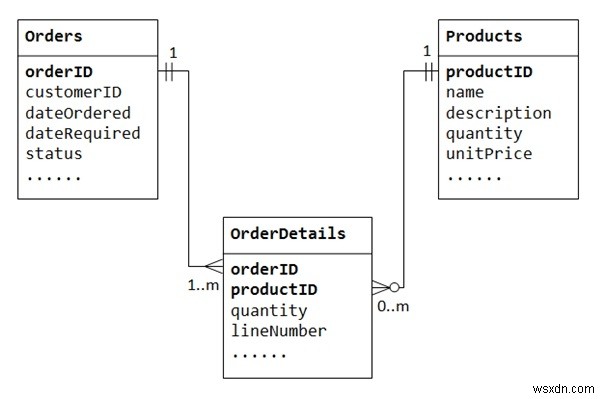
ความสัมพันธ์ many-to-many จริงๆ แล้วถูกนำไปใช้เป็นความสัมพันธ์ one-to-many 2 ความสัมพันธ์ ด้วยการนำ junction table มาใช้
ออเดอร์หนึ่งมีรายการมากใน OrderDetails รายการ OrderDetails หนึ่งรายการเป็นของออเดอร์เฉพาะ
สินค้าหนึ่งชิ้นอาจปรากฏใน OrderDetails หลายรายการ แต่ละรายการ OrderDetails ระบุสินค้าหนึ่งชิ้น
One-to-One
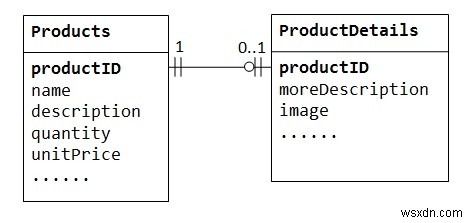
ในฐานข้อมูล "product sales" สินค้าอาจมีข้อมูลเสริมที่เป็นทางเลือก เช่น รูปภาพ คำอธิบายเพิ่มเติม และความคิดเห็น การเก็บไว้ในตาราง Products ทำให้เกิดช่องว่างมาก (ในเรคอร์ดที่ไม่มีข้อมูลทางเลือกเหล่านี้) นอกจากนี้ ข้อมูลขนาดใหญ่นี้อาจทำลดประสิทธิภาพฐานข้อมูล
แทนที่จะเป็นเช่นนั้น เราสามารถสร้างตารางอีกตารางหนึ่ง (เช่น ProductDetails, ProductLines หรือ ProductExtras) เพื่อจัดเก็บข้อมูลทางเลือก เรคอร์ดจะถูกสร้างเฉพาะสำหรับสินค้าที่มีข้อมูลทางเลือก สองตาราง Products และ ProductDetails แสดงความสัมพันธ์ one-to-one คือ สำหรับทุกแถวในตารางพ่อ มีแถวสูงสุดหนึ่งแถว (อาจเป็นศูนย์) ในตารางลูก คอลัมน์ productID เดียวกันควรใช้เป็นคีย์หลักสำหรับทั้งสองตาราง
บางฐานข้อมูลจำกัดจำนวนคอลัมน์ที่สามารถสร้างในตารางได้ คุณอาจใช้ความสัมพันธ์ one-to-one เพื่อแยกข้อมูลเป็น 2 ตาราง ความสัมพันธ์ one-to-one ยังมีประโยชน์สำหรับการจัดเก็บข้อมูลที่ละเอียดอ่อนในตารางที่ปลอดภัย ในขณะที่ข้อมูลที่ไม่ละเอียดอ่อนอยู่ในตารางหลัก
ชนิดข้อมูลคอลัมน์ (Column Data Types)
คุณต้องเลือกชนิดข้อมูลที่เหมาะสมสำหรับแต่ละคอลัมน์ ชนิดข้อมูลทั่วไปรวมถึง integers, floating-point numbers, string (หรือ text), date/time, binary, collection (เช่น enumeration และ set)
ขั้นตอน 4 - ปรับปรุง & ปกติรูปแบบ (Refine & Normalize the Design)
ตัวอย่างเช่น
- เพิ่มคอลัมน์เพิ่มเติม
- สร้างตารางใหม่สำหรับข้อมูลทางเลือกโดยใช้ความสัมพันธ์ one-to-one
- แยกตารางขนาดใหญ่เป็น 2 ตารางเล็กกว่า
- วิธีอื่นๆ
การปกติรูปแบบ (Normalization)
นำกฎการปกติรูปแบบมาใช้ตรวจสอบว่าฐานข้อมูลของคุณถูกต้องและเหมาะสมทางโครงสร้างหรือไม่
รูปแบบปกติที่ 1 (1NF): ตารางเป็น 1NF ถ้าทุกเซลล์มีค่าเดียว ไม่ใช่รายการค่า คุณสมบัตินี้เรียกว่า atomic 1NF ยังห้ามกลุ่มคอลัมน์ซ้ำ เช่น item1, item2, itemN แทนที่จะเป็นเช่นนั้น คุณควรสร้างตารางอื่นโดยใช้ความสัมพันธ์ one-to-many
รูปแบบปกติที่ 2 (2NF): ตารางเป็น 2NF ถ้าเป็น 1NF และทุกคอลัมน์ที่ไม่ใช่คีย์ขึ้นอยู่กับคีย์หลักอย่างสมบูรณ์ (fully dependent) นอกจากนี้ ถ้าคีย์หลักประกอบด้วยหลายคอลัมน์ ทุกคอลัมน์ที่ไม่ใช่คีย์ต้องขึ้นอยู่กับชุดทั้งหมด ไม่ใช่แค่ส่วนหนึ่ง
ตัวอย่างเช่น คีย์หลักของตาราง OrderDetails ประกอบด้วย orderID และ productID หาก unitPrice ขึ้นอยู่แค่กับ productID มันไม่ควรอยู่ในตาราง OrderDetails (แต่ควรอยู่ในตาราง Products) แต่ถ้าราคาต่อหน่วยขึ้นอยู่กับสินค้าและออเดอร์เฉพาะนั้น มันควรอยู่ในตาราง OrderDetails
รูปแบบปกติที่ 3 (3NF): ตารางเป็น 3NF ถ้าเป็น 2NF และคอลัมน์ที่ไม่ใช่คีย์เป็นอิสระต่อกัน กล่าวคือ คอลัมน์ที่ไม่ใช่คีย์ขึ้นอยู่กับคีย์หลัก เพียงคีย์หลักอย่างเดียว และไม่ใช่สิ่งอื่น ตัวอย่างเช่น สมมติเรามีตาราง Products ด้วยคอลัมน์ productID (คีย์หลัก), name และ unitPrice คอลัมน์ discountRate ไม่ควรอยู่ในตาราง Products ถ้ามันขึ้นอยู่กับ unitPrice ซึ่งไม่ใช่ส่วนหนึ่งของคีย์หลัก
รูปแบบปกติระดับสูงกว่า: 3NF มีข้อบกพร่อง ซึ่งนำไปสู่รูปแบบปกติระดับสูงกว่า เช่น Boyce/Codd Normal form, Fourth Normal Form (4NF) และ Fifth Normal Form (5NF) ซึ่งอยู่นอกขอบเขตของบทช่วยสอนนี้
บางครั้ง คุณอาจตัดสินใจฝ่าฝืนกฎการปกติรูปแบบบางอย่าง เพื่อเหตุผลด้านประสิทธิภาพ (เช่น สร้างคอลัมน์ totalPrice ในตาราง Orders ซึ่งสามารถคำนวณจากเรคอร์ด orderDetails) หรือเพราะผู้ใช้ปลายทางขอ ตรวจสอบให้แน่ใจว่าคุณเข้าใจอย่างเต็มที่ พัฒนาตรรกะโปรแกรมเพื่อจัดการ และจดบันทึกการตัดสินใจอย่างเหมาะสม
กฎความสมบูรณ์ (Integrity Rules)
คุณควรนำกฎความสมบูรณ์มาใช้ตรวจสอบความสมบูรณ์ของการออกแบบของคุณ -
1. Entity Integrity Rule - คีย์หลักไม่สามารถมีค่า NULL ได้ มิฉะนั้น มันจะระบุแถวได้อย่างไม่ซ้ำกัน สำหรับคีย์รวมที่ประกอบด้วยหลายคอลัมน์ ไม่มีคอลัมน์ไหนที่สามารถมีค่า NULL ได้ ส่วนใหญ่ RDBMS ตรวจสอบและบังคับกฎนี้
2. Referential Integrity Rule - ค่าคีย์ต่างประเทศแต่ละค่าต้องตรงกับค่าคีย์หลักในตารางที่อ้างอิง (หรือ parent table)
คุณสามารถแทรกแถวที่มีคีย์ต่างประเทศในตารางลูกได้ก็ต่อเมื่อค่ามีอยู่ในตารางพ่อ
ถ้าค่าของคีย์เปลี่ยนในตารางพ่อ (เช่น แถวถูกอัปเดตหรือลบ) ทุกแถวที่มีคีย์ต่างประเทศนี้ในตารางลูกต้องได้รับการจัดการตามลำดับ คุณสามารถ (a) ไม่อนุญาตการเปลี่ยนแปลง (b) cascade การเปลี่ยนแปลง (หรือลบเรคอร์ด) ในตารางลูกตามลำดับ (c) ตั้งค่าคีย์ในตารางลูกเป็น NULL
ส่วนใหญ่ RDBMS สามารถตั้งค่าให้ทำการตรวจสอบและรับรองความสมบูรณ์ของการอ้างอิง ในวิธีที่ระบุ
3. Business Logic Integrity - นอกจากกฎความสมบูรณ์ทั่วไป 2 ข้อข้างต้นแล้ว อาจมีความสมบูรณ์ (การตรวจสอบ) ที่เกี่ยวข้องกับตรรกะธุรกิจ เช่น รหัสไปรษณีย์ต้องเป็น 5 หลักในช่วงหนึ่ง วันที่และเวลาจัดส่งต้องอยู่ในช่วงเวลาทำการ จำนวนที่สั่งต้องเท่าหรือน้อยกว่าจำนวนในสต็อก ฯลฯ สิ่งเหล่านี้สามารถดำเนินการได้โดยกฎการตรวจสอบ (สำหรับคอลัมน์เฉพาะ) หรือตรรกะโปรแกรม
ดัชนีคอลัมน์ (Column Indexing)
คุณสามารถสร้างดัชนีบนคอลัมน์ที่เลือกเพื่ออำนวยความสะดวกในการค้นหาและดึงข้อมูล ดัชนีคือไฟล์ที่มีโครงสร้างที่เร่งการเข้าถึงข้อมูลสำหรับ SELECT แต่อาจทำช้า INSERT, UPDATE, และ DELETE ถ้าไม่มีโครงสร้างดัชนี ในการประมวลผลคิวรี SELECT ที่มีเกณฑ์การจับคู่ (เช่น SELECT * FROM Customers WHERE name='Tan Ah Teck') เครื่องยนต์ฐานข้อมูลต้องเปรียบเทียบทุกเรคอร์ดในตาราง ดัชนีเฉพาะ (เช่น โครงสร้าง BTREE) สามารถเข้าถึงเรคอร์ดได้โดยไม่ต้องเปรียบเทียบทุกเรคอร์ด อย่างไรก็ตาม ดัชนีต้องสร้างใหม่ทุกครั้งที่มีการเปลี่ยนแปลงเรคอร์ด ซึ่งทำให้เกิด overhead ที่เกี่ยวข้องกับการใช้ดัชนี
ดัชนีสามารถกำหนดบนคอลัมน์เดียว เซตของคอลัมน์ (เรียกว่า concatenated index) หรือส่วนหนึ่งของคอลัมน์ (เช่น 10 ตัวอักษรแรกของ VARCHAR(100)) (เรียกว่า partial index) คุณสามารถสร้างดัชนีได้มากกว่าหนึ่งในตาราง ตัวอย่างเช่น หากคุณค้นหาลูกค้าบ่อยๆ โดยใช้ customerName หรือ phone number คุณสามารถเร่งการค้นหาโดยการสร้างดัชนีบนคอลัมน์ customerName และ phoneNumber ส่วนใหญ่ RDBMS สร้างดัชนีบนคีย์หลักโดยอัตโนมัติ
