

ผมยังไม่มีลูก แต่เมื่อมี ผมอยากให้ลูกเรียนรู้ 2 เรื่อง:
- การเงินส่วนตัว
- Machine Learning
ไม่ว่าคุณจะเชื่อว่า singularity ใกล้เข้ามาหรือไม่ ไม่สามารถปฏิเสธได้ว่าลูกโลกนี้วิ่งด้วยข้อมูล การเข้าใจว่าข้อมูลถูกเปลี่ยนเป็นความรู้อย่างไร สำคัญสำหรับทุกคนในยุคนี้ — และสำคัญกว่านั้นสำหรับนักพัฒนา
นี่คือบทความแรกในซีรีส์ที่พยายามทำให้ Machine Learning (ML) เข้าถึงได้สำหรับ full-stack Ruby developers ด้วยการเข้าใจเครื่องมือ ML ที่มีอยู่ คุณจะช่วย stakeholders ตัดสินใจได้ดีขึ้น บทความหน้าจะเน้นเทคนิคและตัวอย่างปฏิบัติ แต่บทนี้เราจะวางเวที — แสดงแผนที่และตอกป้ายว่า "คุณอยู่ที่นี่"
จุดเริ่มต้นที่ย่อมเยาว์
Artificial Intelligence (AI) และ Machine Learning ไม่ใช่เรื่องใหม่ ในปี 1950 Arthur Samuel สร้างโปรแกรมคอมพิวเตอร์เล่นเช็คเกอร์ ใช้ "alpha-beta pruning" — อัลกอริทึมค้นหาทั่วไป
ทศวรรษ 1960 เห็น neural networks หลายชั้นและ nearest-neighbor algorithm ที่ใช้หา optimal pathing ในคลังสินค้า
ถ้า AI เก่าแล้ว ทำไม AI startups จึงเป็นที่นิยม? ตามความคิดผม มี 2 เหตุผล:
- กำลังคอมพิวติ้ง (ดู Moore's Law)
- ปริมาณข้อมูลที่เพิ่มขึ้นบนอินเทอร์เน็ตทุกวัน
มีสถิติ 2 อย่างเกี่ยวกับข้อมูลที่สร้างขึ้นทุกวันที่ทำให้ผมหैरลึกทุกครั้งที่คิดถึง:
- ณ ปี 2018 เราสร้างข้อมูล 2.5 quintillion bytes ต่อวัน หมายเลขนี้เพิ่มขึ้นแน่นอนตั้งแต่ Forbes ตีพิมพ์
- สองปีที่ผ่านมาเพียงอย่างเดียว สร้างข้อมูล 90% ของข้อมูลทั้งโลก
รวมกันหมายความว่า (1) ฮาร์ดแวร์สำหรับเก็บข้อมูลและรันอัลกอริทึมยิ่งไปยิ่งราคาถูก และ (2) ข้อมูลสำหรับ train ML models เพิ่มขึ้นอย่างรวดเร็ว
ทุกวันเราโต้ตอบ ถูกอิทธิพล และมีส่วนร่วมกับโลก AI และ ML ตัวอย่างเช่น คุณขอขอบคุณ (หรือโทษ) อัลกอริทึมสำหรับ:
- วงเงินเครดิตของคุณ
- ช่วยวินิจฉัยโรค
- อาจรวมถึงว่าคุณได้งานหรือไม่
- ช่วยหาเส้นทางมีประสิทธิภาพตามสภาพจราจร
- Alexa เข้าใจว่าคุณแค่จามเมื่อคุณบอกเธอ
- Spotify แนะนำเพลงโปรดใหม่
เหตุผลที่ผมพูดถึงลูกในอนาคต: ผมอยากให้เข้าใจว่าชีวิตดิจิทัลส่งผลต่อชีวิต "จริง" อย่างไร ความหมายของการตัดสินใจเกี่ยวกับความเป็นส่วนตัวของข้อมูล และวิธีสร้างความคิดของตัวเองว่ándo ควรไว้ใจเครื่องจักร และเมื่อไหร่ไม่ควร
ในส่วนที่เหลือ ผมจะให้ภาพรวม 3 ประเภทของ ML ที่ศึกษา: supervised learning, unsupervised learning, และ reinforcement learning เราจะพูดถึงความแตกต่างและปัญหาที่แต่ละอย่างแก้ได้ดี
Supervised Learning (การเรียนรู้ภายใต้การดูแล)
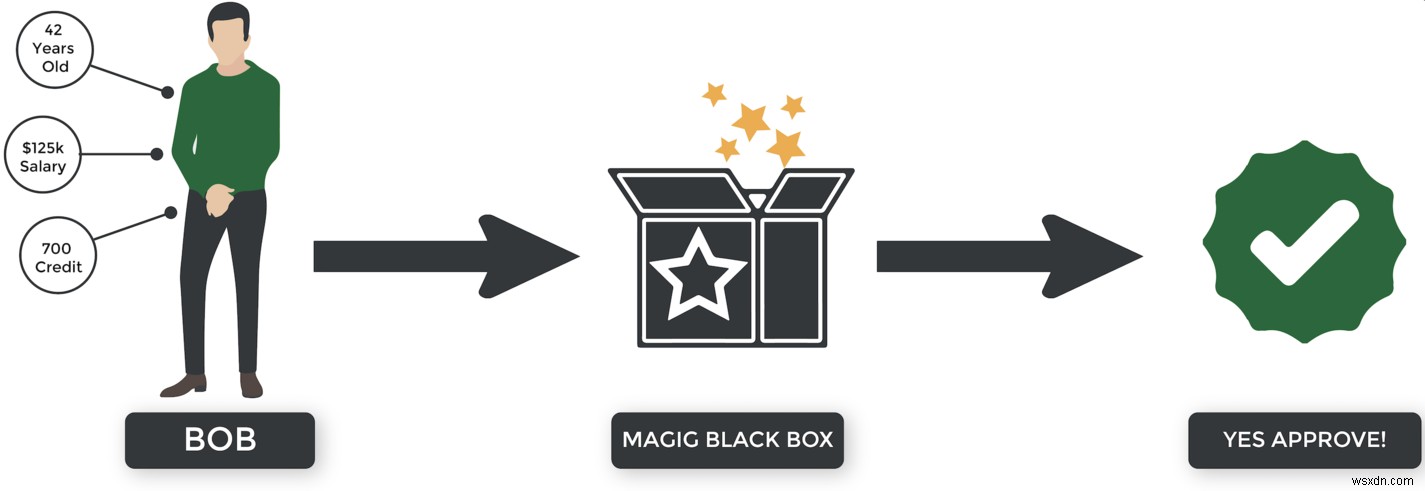
Supervised learning คือ... ถูกดูแลโดยมนุษย์ :) จินตนาการว่าเราสร้างระบบ supervised learning เพื่อตัดสินใจอนุมัติสินเชื่อที่อยู่อาศัย นี่คือวิธีที่อาจทำงาน:
- ธนาคารรวบรวม dataset ที่ map แอตทริบิวต์ลูกค้า (อายุ เงินเดือน ฯลฯ) ไปยังผลลัพธ์ (ชำระคืน 違约 ฯลฯ)
- เรา train ระบบด้วยข้อมูล
- ระบบใช้สิ่งที่เรียนรู้ทายผลลัพธ์ในอนาคตจากแอตทริบิวต์ผู้สมัคร
- ถ้าอัลกอริทึมทายถูก เราบอกว่า "เก่งมาก! ถูกต้อง" แต่ถ้าผิด เราบอกว่า "ไม่ถูกต้อง โปรดปรับปรุงและลองอีกครั้ง"
ตัวอย่างนี้เป็นปัญหา "classification" เพราะ output ของอัลกอริทึมเป็นหมวดหมู่ — ในกรณีนี้ อนุมัติหรือไม่อนุมัติ ตัวอย่าง classification problems อื่นๆ:
- บุคคลมีโรคหรือไม่
- X-ray มีกระดูกหักหรือไม่
- อีเมลเป็น spam หรือไม่
ถ้าสนใจคณิตศาสตร์เบื้องหลัง ML classification algorithms ค้นหา: naive Bayes classifiers, support vector machines, logistic regression, neural networks, random forests
นอกจาก classification problems ที่ให้ผล "ใช่/ไม่" supervised learning ยังแก้ regression problems ได้ — ทำนายบนสเกลต่อเนื่อง เช่น:
- มูลค่าหุ้นในอนาคต
- ความน่าจะเป็นที่ New England Patriots ชนะ Super Bowl
- เงินเดือนเฉลี่ยที่บริษัทต้องเสนอให้ผู้สมัครยอมรับ
อัลกอริทึมสำหรับ supervised regression: linear regression, non-linear regression, Bayesian linear regression
Unsupervised Learning (การเรียนรู้โดยไม่มีการดูแล)
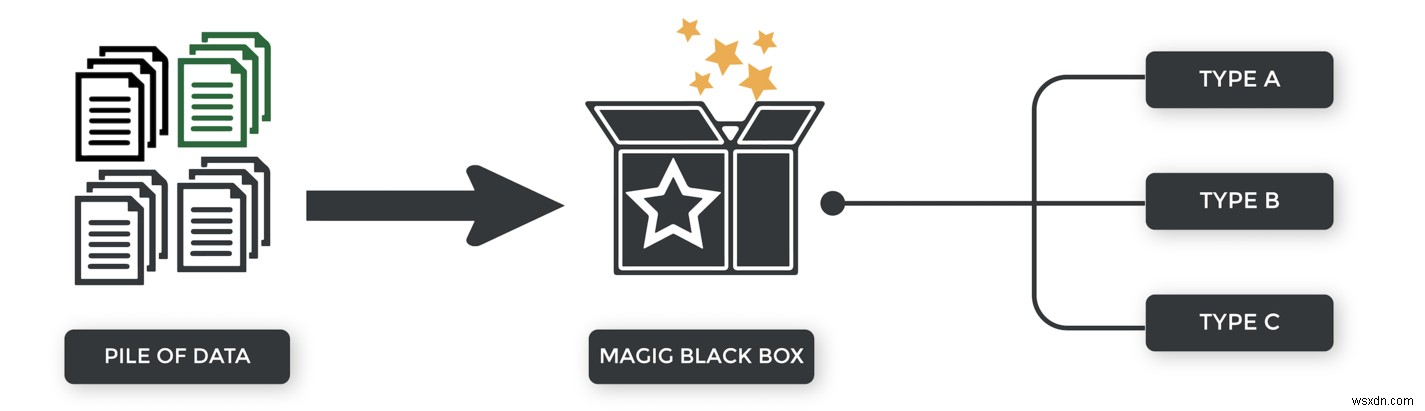
ใน supervised learning เรากำหนดหมวดหมู่ไว้ล่วงหน้า ผู้สมัครสินเชื่อได้อนุมัติหรือปฏิเสธ
ใน unsupervised learning เราไม่ให้หมวดหมู่ มันไม่มีให้เรา อัลกอริทึมต้องสรุปเอง
ทำไมต้องใช้ unsupervised approach?
1) บางครั้งเราไม่รู้หมวดหมู่ล่วงหน้า ข้อมูลส่วนใหญ่บนอินเทอร์เน็ตเป็น unstructured — ไม่มี labels
2) บางครั้งเราไม่รู้ว่าต้องการอะไร จึงขอให้อัลกอริทึมหา patterns/features ที่มีประโยชน์สำหรับการจัดหมวดหมู่
อีกวิธีจัดการ unstructured data กับ ML คือให้มนุษย์ดูและ label เอง มีบริษัทจ้างคน label data
แนวทางการเรียนรู้แบบ Unsupervised
2 เทคนิคทั่วไปใน unsupervised learning คือ association และ clustering
Association: จินตนาการคุณคือ Amazon มีข้อมูลลูกค้า ประวัติซื้อ ด้วย unsupervised learning คุณอาจแบ่งลูกค้าเป็น "ประเภทผู้ซื้อ" — เช่น พบว่าซื้อร่มสีชมพู มักซื้อชา Matcha ด้วย
Clustering: Clustering ดูข้อมูลและแบ่งเป็นจำนวนกลุ่มที่กำหนด เช่น มีข้อมูลบ้านมากมาย อยากดูว่ามี features (อาจเป็นข้อมูลอาชญากรรม?) ที่ทายได้ว่าบ้านอยู่ย่านไหน หรือ cosine similarity สำหรับ text classification (เช่น บทความนี้เกี่ยวกับเทนนิส ปั่นอาหาร หรืออวกาศ?)
สนใจเทคนิค unsupervised learning เฉพาะเจาะจง ค้นหา: k-means clustering, cosine similarity, hierarchical clustering, k-nearest-neighbor clustering
Reinforcement Learning (การเรียนรู้แบบเสริมแรง)
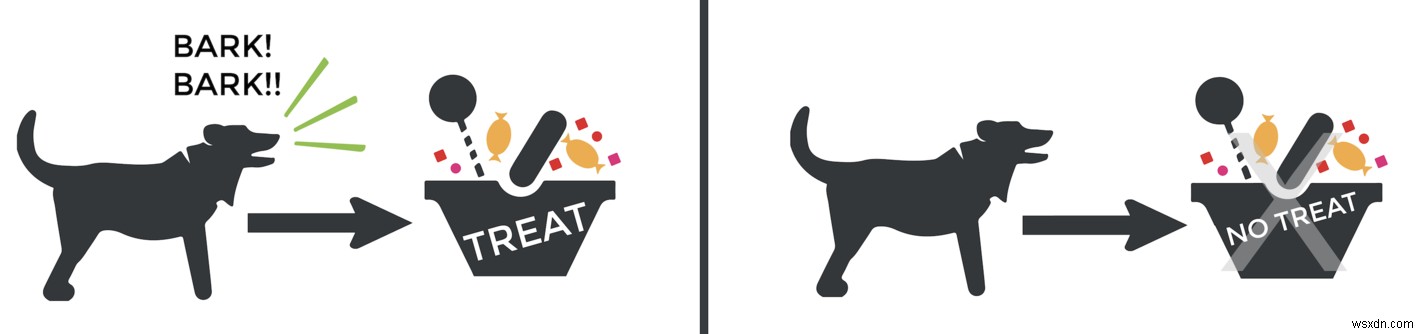
สาขา ML นี้ใช้ในเกมส์เพราะใช้อัลกอริทึมที่มุ่งเป้าหมาย ไม่เหมือน supervised learning แต่ละการตัดสินใจไม่ได้เป็นอิสระ — ให้ input ปัจจุบัน อัลกอริทึมตัดสินใจ และ input ถัดไปขึ้นอยู่กับการตัดสินใจนี้
เหมือนผมเคาะหัวสุนัขเมื่อมันหยุดเห่าเมื่อมีคนกดดอร์เบลล์ หรือขังในคาเซ็ตเมื่อมันไม่หยุดเห่า reinforcement algorithms ได้รับรางวัลเมื่อตัดสินใจที่เพิ่มประสิทธิภาพเป้าหมาย (เช่น คะแนนสูงสุด) และถูกลงโทษเมื่อตัดสินใจผิด
การประยุกต์ที่ชัดเจนของ reinforcement learning:
- เกมส์เช่นหมากรุกและ Go (แนะนำสารคดี AlphaGo บน Netflix ถ้ายังไม่ดู)
- หุ่นยนต์ (สอนบอททำงานที่ต้องการ)
- ยานยนต์อัตโนมัติ
- Robo-advisors ที่ฝึกให้ชนะตลาดหุ้น
สนใจอัลกอริทึมเบื้องหลัง reinforcement learning ค้นหา: Q-learning, state-action-reward-state-action (SARSA), DQN, asynchronous advantage actor critic
สรุป
หวังว่าตัวอย่างเหล่านี้ช่วยให้เข้าใจเทคนิค ML และวิธีที่แต่ละอย่างใช้สร้างอิทธิพลต่อโลกที่ซับซ้อนวันนี้ แม้ผมรู้สึก overwhelmed กับสิ่งที่ต้องเรียน แต่เริ่มต้นที่ไหนก็ดีกว่าไม่ทำอะไร และจำไว้ว่าสิ่งเหล่านี้ไม่ได้ใหม่มาก — เราแค่ได้ยินมากขึ้นเพราะข้อมูลเพิ่มขึ้นและกำลังประมวลผลถูกกว่า
