

Background tasks เป็นหนึ่งใน core pillars เมื่อพิจารณาเว็บแอปพลิเคชันสำหรับ scale แนวคิดพื้นฐานเรียบง่าย: Client ทำ request ไปที่เว็บแอปของคุณ และในการ handle request นั้น แอปของคุณทำ time-expensive tasks หลายอย่าง เพื่อให้ตอบสนอง client เร็วขึ้น แอปจะ enqueue background job ไปที่ background processing system Background processing จะรับผิดชอบ heavy lifting ทั้งหมด เช่น computations หรือ I/O operations การใช้ background jobs อย่างมีประสิทธิภาพเป็นหนึ่งใน building blocks สำคัญที่สุดเมื่อ scale เว็บแอปพลิเคชันของคุณ
ในฐานะ Rails developers เราได้รับพระคุณกับ libraries ยอดเยี่ยมหลายตัวให้เลือก ทุกตัวมีข้อได้เปรียบ ข้อเสีย และแม้แต่ backend databases ที่ต่างกัน Libraries เหล่านี้ทำให้ offload heavy lifting ง่ายขึ้น ทำให้แอปพลิเคชันของเราตอบสนองเร็วขึ้นและ serve ผู้ใช้มากขึ้นด้วยทรัพยากรน้อยลง
จนกว่าเร็วๆ นี้ เราใช้ Sidekiq ทำ majority ของ background processing jobs ของ Honeybadger มัน instrumental ในการช่วยให้เรา maintain blazing-fast user experience และ robust pipeline สำหรับประมวลผลข้อมูลปริมาณมากที่เรา ingest
Sidekiq ตกหล่นที่ไหนสำหรับเรา?
แม้จะ reliable Redis มี limitations บ้าง จนกว่าเร็วๆ นี้ เราใช้ Sidekiq สำหรับ job processing ทั้งหมด รวมถึง handling ingest สำหรับ error-tracking endpoints ของเรา Error traffic มีความผันผวนสูง เราจะเห็น 10x หรือ 20x จำนวน jobs ใน queues — ทำให้เกิด large backlogs จน autoscaling spin up workers พอที่จะ catch up แตปัญหาที่ใหญ่กว่าคือ memory exhaustion ใน ElastiCache cluster ของเรา
เรามี job traffic มากพอผ่าน ElastiCache cluster ที่ any significant delay ใน downstream processing จะทำให้ cluster เสี่ยง per memory การหมดหน่วยความจำ ในขณะที่เราใช้ separate cluster สำหรับเก็บ non-queue data ตามเวลา เรามี non-queue data บางส่วนปรากฏใน primary cluster ด้วย ซึ่งอาจถูก evict ในกรณี out-of-memory errors ปัญหาที่ critical กว่าคือ ไม่สามารถรับ jobs ใหม่ได้เมื่อ cluster หมด memory
ปัญหารองคือ Redis/ElastiCache ใช้ volatile-lru eviction policy โดยค่าเริ่มต้น ผลลัพธ์คือ ในช่วง high memory usage Redis จะลบ least recently used data ที่มี TTL set ไว้ ในบางจุด Honeybadger มี event ที่ memory usage สูงพอที่ Redis เริ่ม clear cache เมื่อเราไม่ตั้งใจ โชคดีที่ data ที่ถูก evict เป็น reproducible (เพราะ TTL) จึงไม่สูญเสีย permanent data
แต่มันทิ้งคำถามหนึ่งที่ต้องจัดการ - จะเกิดอะไรถ้า event คล้ายกันเกิดขึ้นและเราเริ่มสูญเสีย data ที่ rebuild ไม่ได้? เราจะ ensure ได้อย่างไรว่าเราไม่เคยสูญเสีย customer data? การจัดการ customer error data เป็นหัวใจของธุรกิจเรา ดังนั้น เราต้องการระบบที่ resilient ต่อ data loss
การใช้ Kafka สำหรับ ingest ข้อมูล
Kafka เป็น distributed event pipeline ที่เสนอทั้ง scalability และ resiliency ด้วยการ launch Insights ล่าสุด เราได้ประสบการณ์มากในการ stand up Kafka เป็น infrastructure เพื่อประมวลผล event data ของเราหลังจากนั้น เราอยากใช้ technology stack เดียวกันเพื่อประมวลผล error ingestion data ของเรา เรา aimed เพื่อให้ได้ redundant storage ด้วย expandability ที่ดีกว่า และ cost ที่ affordable มากขึ้นด้วย Kafka
เนื่องจากเรารัน AWS MSK cluster ของตัวเองสำหรับ Insights เรามี infrastructure และ autoscaling setup แล้ว หมายความว่าเรา "แค่" ต้อง setup topics ไป vàiตัว และสร้าง consumers ไป 몇 ตัว ที่รันโค้ดเดียวกับ Sidekiq workers ของเรา ค่อนข้าง straightforward ซึ่งทำให้เรา focus มากขึ้นที่ fine-tuning Kafka consumers ของเรา
การย้ายจาก Sidekiq ไป Karafka
Honeybadger สถาปัตยกรรมเป็น majestic monolith และ Karafka ช่วยให้เรารักษาสถาปัตยกรรมเดิม เราใช้ Karafka ประมวลผล Insights data บางส่วนอยู่แล้ว ดังนั้นเพิ่ม consumers ใหม่ไป几个ก็เป็นงานง่าย
ความแตกต่างหลักหนึ่งระหว่าง Karafka และ Sidekiq คือวิธีการ retrieve jobs ด้วย Karafka jobs จะถูก batched และประมวลผลร่วมกันใน single consumer run ใน consumer เราสามารถ iterate ผ่าน array of messages และรัน Sidekiq worker inline:
class NoticeConsumer < ApplicationConsumer def consume messages.each do |message| NoticeWorker.new.perform(message.payload) end end end ความแตกต่างอีกอย่างที่เราต้องพิจารณาคือ error handling ทำงานอย่างไร ด้วย Sidekiq เนื่องจากแต่ละ job เป็น atomic worker จัดการ error ของตัวเองผ่าน retries และ failure callbacks ด้วย Kafka's batching behavior มี options มากกว่าสำหรับ handling errors สิ่งที่โดดเด่นที่สุด Karafka 提供 mechanism ที่เรียกว่า Dead Letter Queue นี่ช่วยให้คุณระบุ error handling บน batch หรือ individual basis ได้
dead_letter_queue( topic: "ingestion.errors.dead", max_retries: 5, independent: true ) เมื่อ Karafka consumer พบความล้มเหลวในการประมวลผล individual message ใดๆ มันจะพยายาม reprocess 5 ครั้ง ถ้าล้มเหลวครั้งที่ 5 message จะถูกส่งไป topic ที่ระบุ Option independent: true บอก consumer ว่าเฉพาะ failed message ที่ต้องส่งไป DLQ ไม่ใช่ entire batch
การ Monitor และ Scale Karafka
ได้เป็นจริงว่า monitoring และ scaling Karafka consumers ค่อนข้าง complicated มีหลายสิ่งที่คุณ track ได้จากทั้ง AWS/MSK และ Karafka และหลาย knobs ที่คุณปรับเพื่อ tune ระบบ ต้องการ careful attention ต่อสิ่งที่โค้ดทำ และ behavior ของ data flow
ด้วย AWS CloudWatch เรา monitor หลายอย่าง แต่นี่คือ Kafka-specific metrics ที่เราดู:
- SumOffsetLag — สำหรับ topic และ consumer group ที่ระบุ นี่คือ sum ของ offset lag ทั้งหมด across all partitions
- EstimatedMaxTimeLag — สำหรับ topic และ consumer group ที่ระบุ นี่คือ ประมาณการ เวลาที่จะใช้ในการ catch up บน all partitions ไปยัง current offset
Karafka ยัง提供 instrumentation ที่ดี แต่คุณต้อง publish และ store ข้อมูลนี้เอง:
- processing_lag* — ค่านี้ available สำหรับทุก consumed batch of messages มันบอกเวลาที่ Karafka ใช้ในการนำ message จาก Kafka ไปเริ่ม process
- consumption_lag* — ค่านี้คล้าย processing_lag แต่เป็นเวลาตั้งแต่ last message ของ batch เข้าระบบ Kafka จนกว่า consumer จะเริ่ม process
- duration* — นี่คือเวลาที่ consumer ใช้ในการ process entire batch of messages
ได้เป็นจริงว่า scaling Sidekiq processes แตกต่างจาก scaling Karafka consumer processes มาก เมื่อเพิ่ม parallelization ของ Sidekiq คุณเพิ่ม processes มากขึ้นเท่าที่ Redis instance จัดการได้ ด้วย Kafka คุณ bound ที่จะมี at most 1 process ต่อ partition ใน topic โดย rule of thumb คุณจะอยากมี partitions มากกว่าที่วางแผนไว้ เนื่องจาก Kafka consumer สามารถ assigned ให้มากกว่า 1 partition
สิ่งอีกอย่างที่ต้องจดจำคือ scaling up และ scaling down Kafka consumers อาจเป็น very lengthy operation การเพิ่มและลบ consumers จาก consumer group ต้องการให้ group rebalance เอง หมายถึง reassigning partitions ตามความจำเป็น ในช่วง reassignment consumers หยุด processing messages แม้คุณ mitigate issue นี้ได้บ้างด้วย sticky-cooperative assignment คุณโดยทั่วไปอยาก avoid rebalancing ถ้าสามารถ โดย over-provisioning resources
เรากำลัง monitor SumOffsetLag เป็นหนึ่งใน scaling metrics สิ่งสำคัญที่ต้องจดคือ ในช่วง rebalancing metric นี้ไม่ได้ถูก report ดังนั้นคุณจินตนาการได้ว่าในช่วง rebalancing metric นี้จะเพิ่มขึ้นอย่างมากจน rebalancing เสร็จ นี่เป็นอีกเหตุผลที่สำคัญที่จะ keep scaling to a minimum
อะไรต่อไปสำหรับ Karafka ที่ Honeybadger?
เรารัน Kafka/Karafka implementation ที่ 100% มาเกินเดือนแล้ว และปลอดภัยที่จะพูดว่าเราพอใจมาก ยังไงก็ดีที่รู้ว่าเราสามารถ fallback ไป Sidekiq ได้ด้วยการกดปุ่มถ้าจำเป็น ความยืดหยุ่นนี้ให้ resiliency มากขึ้นเมื่อต้องการ maintenance work บนระบบเหล่านี้
ในกระบวนการย้ายจาก Sidekiq ไป Karafka เราเรียนรู้มากขึ้นเกี่ยวกับการทำงานกับ Kafka และ Karafka ถ้าคุณยังไม่ update เป็น Honeybadger gem ล่าสุด คุณควรดู! ผมเพิ่ม features ใหม่ๆ ให้ karafka plugin ตอนคุณ enable Insights gem ของเราจะเริ่ม track stats สำคัญบางอย่างเพื่อให้มุมมองที่ดีกว่าของ overall health ของ Kafka system ของคุณ
นอกจากนี้ เราตอนนี้มี Insights Karafka Dashboard ช่วย visualize data นี้และให้ความเข้าใจที่ดีกว่าของพฤติกรรม Kafka consumers ของคุณ Karafka Dashboard ต้องการ metrics enabled สำหรับ plugin ทำได้โดยเพิ่ม config นี้ใน honeybadger.yml:
karafka: insights: metrics: true นี่คือตัวอย่าง dashboard:
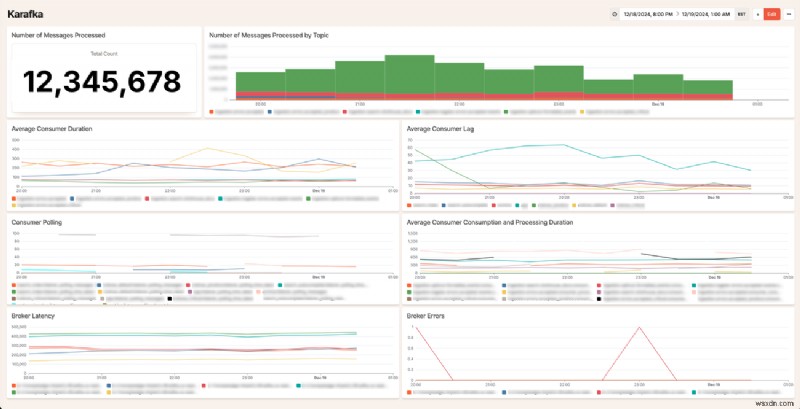
เราตื่นเต้นที่จะเห็นว่าลูกค้าของเราใช้ data นี้ปรับปรุง Kafka systems ของพวกเขาอย่างไร ถ้าคุณมีคำถามเกี่ยวกับการย้ายจาก Sidekiq ไป Karafka หรือเราใช้ Kafka อย่างไร สบายๆ ติดต่อมาได้เลย!
