

สำหรับการวิเคราะห์ข้อมูล Exploratory Data Analysis (EDA) ต้องเป็นขั้นตอนแรกของคุณ EDA ช่วยให้เรา −
ให้ insight เข้าสู่ชุดข้อมูล
เข้าใจโครงสร้างที่อยู่เบื้องล่าง
แยกพารามิเตอร์สำคัญและความสัมพันธ์ที่เกี่ยวข้องระหว่างพวกมัน
ทดสอบสมมติฐานที่อยู่เบื้องล่าง
การเข้าใจ EDA ด้วยชุดข้อมูลตัวอย่าง
เพื่อเข้าใจ EDA โดยใช้ Python เราสามารถนำข้อมูลตัวอย่างมาจากเว็บไซต์ใดๆ หรือจากดิสก์ท้องถิ่นของคุณ ฉันจะนำข้อมูลตัวอย่างจาก UCI Machine Learning Repository ซึ่งเป็นข้อมูลสาธารณะของ red variant ของ Wine Quality data set และพยายามดึง insight มากที่สุดเข้าสู่ชุดข้อมูลโดยใช้ EDA
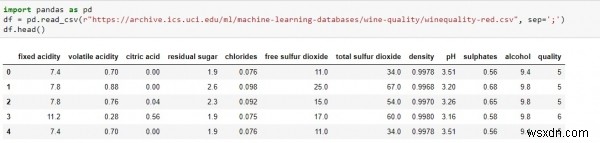
import pandas as pd df = pd.read_csv("https://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv") df.head()
การรันสคริปต์ข้างต้นใน Jupyter Notebook จะให้ผลลัพธ์ประมาณด้านล่าง −
เพื่อเริ่มต้น
ขั้นแรก นำเข้าไลบรารีที่จำเป็น pandas ในกรณีนี้
อ่านไฟล์ csv ด้วยฟังก์ชัน read_csv() ของไลบรารี pandas และแต่ละข้อมูลถูกแยกด้วย delimiter ";" ในชุดข้อมูลที่กำหนด
คืนค่าการสังเกต 5 รายการแรกจากชุดข้อมูลด้วยความช่วยเหลือของฟังก์ชัน ".head" ที่ให้โดยไลบรารี pandas เราสามารถรับการสังเกต 5 รายการสุดท้ายได้เช่นกันด้วยการใช้ฟังก์ชัน ".tail()" ของไลบรารี pandas
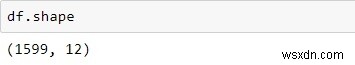
เราสามารถรับจำนวนแถวและคอลัมน์ทั้งหมดจากชุดข้อมูลโดยใช้ ".shape" เช่นด้านล่าง −
df.shape
เพื่อหาว่ามีคอลัมน์อะไรบ้าง ชนิดอะไร และมีค่าอะไรในมันหรือไม่ ด้วยความช่วยเหลือของฟังก์ชัน info()
df.info()
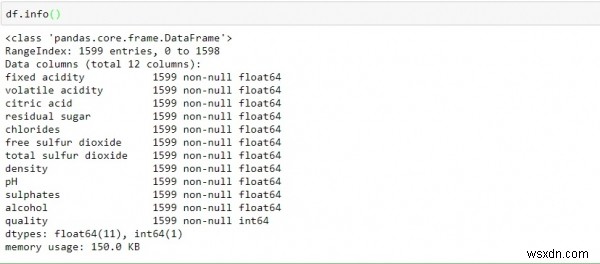
จากการสังเกตข้อมูลข้างต้น เราสามารถสรุปได้ −
ข้อมูลมีแค่ค่า float และ integer เท่านั้น
ตัวแปรคอลัมน์ทั้งหมดเป็น non-null (ไม่มีค่าว่างหรือ missing value)
ฟังก์ชันอีกอย่างที่มีประโยชน์จาก pandas คือ describe() ซึ่งให้ count, mean, standard deviation, minimum และ maximum values และ quantiles ของข้อมูล
df.describe()
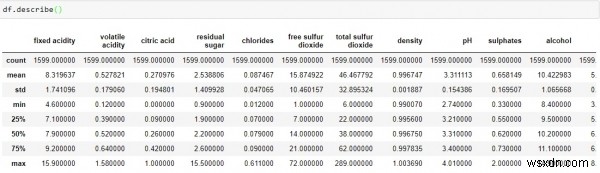
จากข้อมูลข้างต้น เราสรุปได้ว่า mean value ของแต่ละคอลัมน์น้อยกว่า median value (50%) ในคอลัมน์ index
มีความแตกต่างมากระหว่างค่า 75% และ max values ของ predictors "residual sugar", "free sulfur dioxide" และ "total sulfur dioxide"
สองการสังเกตข้างต้น ให้ indication ว่ามี extreme values - deviations ในชุดข้อมูลของเรา
Key insights สองสามอย่างที่เราสามารถได้จาก dependent variables ดังนี้ −
df.quality.unique()
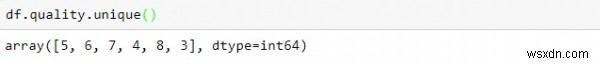
ใน "quality" score scale, 1 อยู่ที่ด้านล่าง .i.e. poor และ 10 อยู่ที่ด้านบน .i.e. best
จากข้างต้นเราสรุปได้ ไม่มี observation ไหน score 1(poor), 2 และ 9, 10(best) score ทุกคะแนนอยู่ระหว่าง 3 ถึง 8
df.quality.value_counts()
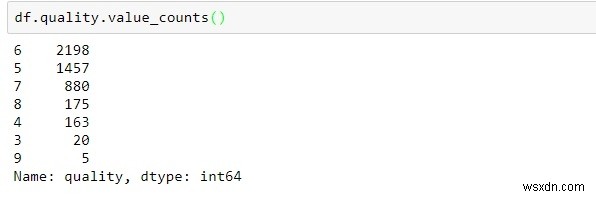
ข้อมูลที่ประมวลผลข้างต้นให้ข้อมูล vote count สำหรับแต่ละ quality score ในลำดับลดลง
ส่วนใหญ่ของ quality อยู่ในช่วง 5-7
Observations น้อยที่สุดสังเกตในหมวดหมู่ 3 และ 6
Data Visualizations (การแสดงข้อมูลภาพ)
ตรวจสอบ Missing Values −
เราสามารถตรวจสอบ missing values ในชุดข้อมูล white-whiskey csv ของเราด้วยความช่วยเหลือของไลบรารี seaborn โค้ดด้านล่างเพื่อทำให้สมบูรณ์ −
import pandas as pd import numpy as np import seaborn as sns import matplotlib.pyplot as plt %matplotlib inline sns.set() df = pd.read_csv("https://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-white.csv", sep=";") sns.heatmap(df.isnull(), cbar=False, yticklabels=False, cmap='viridis')
ผลลัพธ์
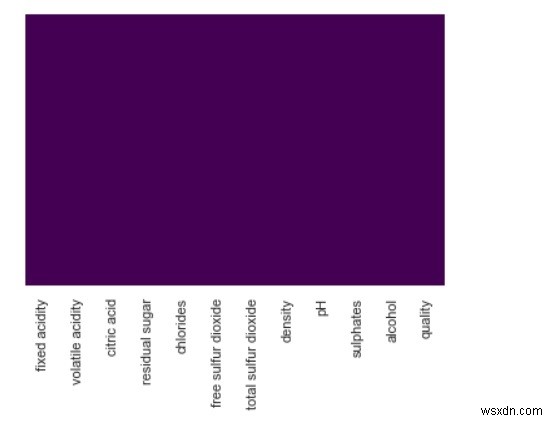
จากข้างต้นเราเห็นว่าไม่มี missing values ใน dataset หากมี เราจะเห็น figure แสดงด้วยสีเฉดต่างๆ บนพื้นหลังสีม่วง
กับ dataset อื่นที่มี missing values คุณจะสังเกตความแตกต่าง
ตรวจสอบ Correlation (ความสัมพันธ์)
เพื่อตรวจสอบ correlation ระหว่างค่าต่างๆ ของ dataset ใส่โค้ดด้านล่างใน dataset ที่มีอยู่ −
plt.figure(figsize=(8,4)) sns.heatmap(df.corr(),cmap='Greens',annot=False)
ผลลัพธ์
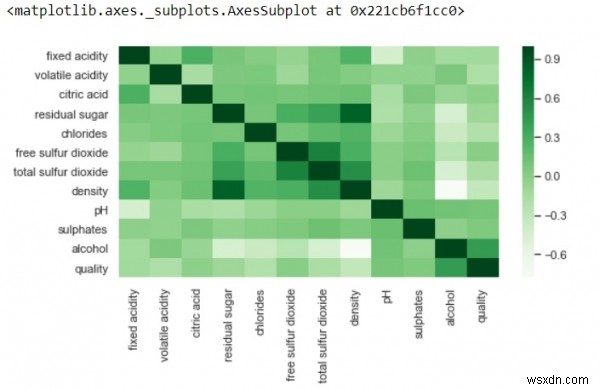
ข้างต้น positive correlation แสดงด้วยเฉดสีเข้ม และ negative correlation โดยเฉดสีอ่อน
เปลี่ยนค่า annot=True และ output จะแสดงค่าที่ features correlated กับกันใน grid-cells
เราสามารถสร้าง correlation matrix อีกอันกับ annot=True ได้ แก้ไขโค้ดของคุณโดยเพิ่มบรรทัดโค้ดด้านล่างในโค้ดที่มีอยู่ −
k = 12 cols = df.corr().nlargest(k, 'quality')['quality'].index cm = df[cols].corr() plt.figure(figsize=(8,6)) sns.heatmap(cm, annot=True, cmap = 'viridis')
ผลลัพธ์
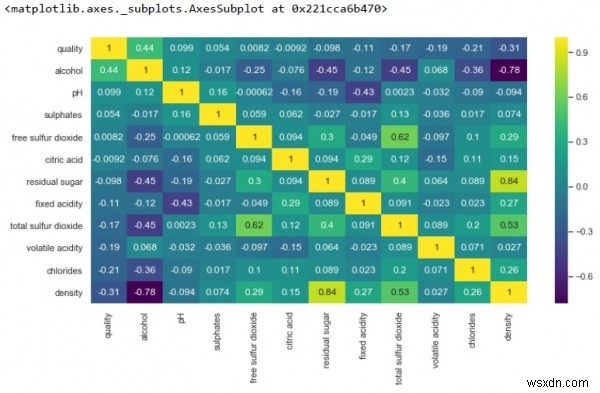
จากข้างต้นเราเห็น มี strong positive correlation ของ density กับ residual sugar อย่างไรก็ตาม strong negative correlation ของ density และ alcohol
นอกจากนี้ ไม่มี correlation ระหว่าง free sulphur dioxide และ quality
