

Data analysis toolpak เป็นหนึ่งในคุณสมบัติที่ดีที่สุดของ Excel เมื่อเราต้องทำการวิเคราะห์ทางสถิติขั้นสูง หากคุณมองหาท่าทางพิเศษสำหรับการใช้ data analysis toolpak ใน Excel คุณมาถูกที่แล้ว มีหลายวิธีในการใช้ data analysis toolpak ใน Excel บทความนี้จะอภิปราย 13 ตัวอย่างที่เหมาะสมของการใช้ Excel data analysis toolpak มาติดตามคู่มือทั้งหมดเพื่อเรียนรู้ทั้งหมดนี้
ขั้นตอนเปิดใช้งาน Data Analysis Toolpak ใน Excel
ก่อนจะวิเคราะห์คุณสมบัติทั้งหมดของ Excel data analysis toolpak เราต้องแสดงวิธีติดตั้ง toolpak นี้ ที่นี่เราจะสาธิตวิธีเปิดใช้งาน Data Analysis Toolpak ใน Excel ในการทำเช่นนี้ คุณต้องทำตามกระบวนการต่อไปนี้
📌 ขั้นตอน:
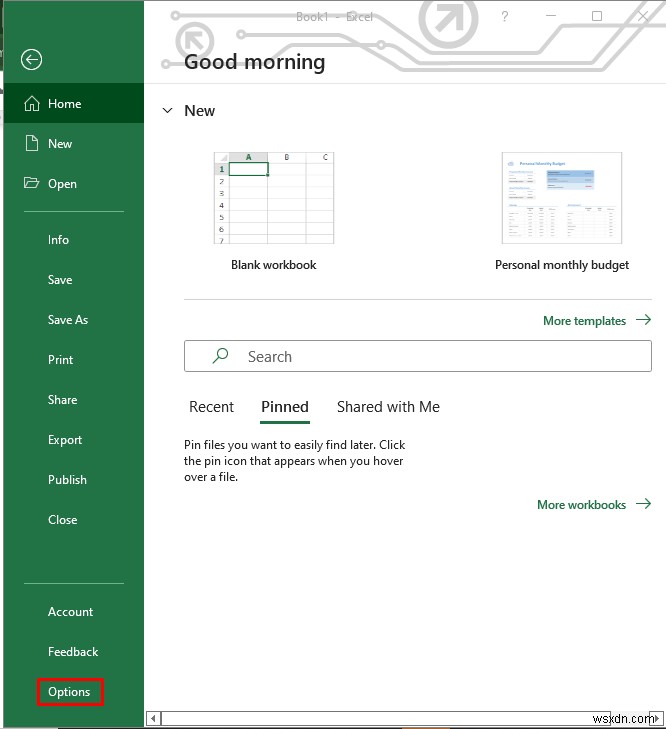
- ขั้นแรก ไปที่ Options จาก File
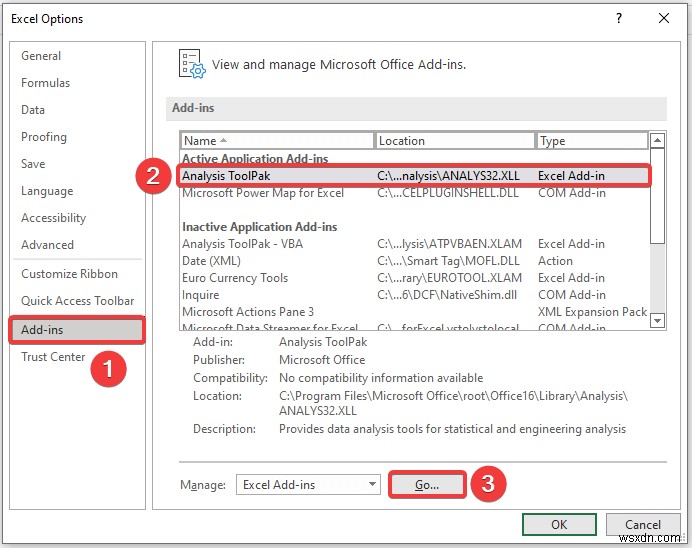
- จากนั้น ไปที่ Add-ins
- ที่นี่ เลือก Excel Add-ins ในเมนูดรอปดาวน์ Manage
- และคลิกที่ Go
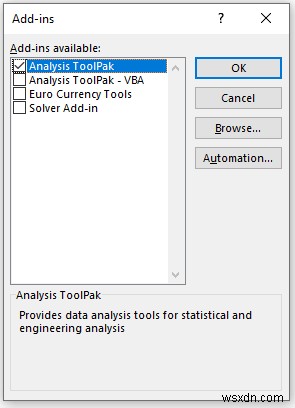
- จากนั้น หน้าต่างใหม่จะปรากฏ
- ที่นี่ ติ๊กถูก ตัวเลือก Analysis ToolPak และคลิกที่ OK นี่คือวิธีที่คุณจะสามารถเปิดใช้งาน Excel data analysis toolpak ได้
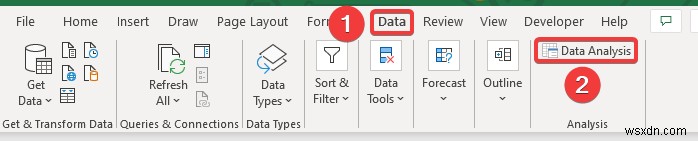
- ตอนนี้ ไปที่เมนู Analyze ในแท็บ Data ที่นี่คุณจะพบตัวเลือก Data Analysis
13 คุณสมบัติเก๋าของ Data Analysis Toolpak ที่คุณสามารถใช้ใน Excel
เราจะใช้ 13 วิธีที่มีประสิทธิภาพและเทคนิคในการใช้ data analysis toolpak ใน Excel ที่นี่ เราจะสาธิต 13 คุณสมบัติของ Excel data analysis toolpak ส่วนนี้ให้รายละเอียดอย่างละเอียดเกี่ยวกับ 13 วิธี คุณสามารถใช้ cualquiera ของพวกเขาสำหรับวัตถุประสงค์ของคุณ พวกเขามีความยืดหยุ่นสูงเมื่อพูดถึงการปรับแต่ง คุณควรเรียนรู้และนำไปใช้ทั้งหมด เพราะพวกเขาปรับปรุงความสามารถในการคิดและความรู้ Excel ของคุณ เราใช้เวอร์ชัน Microsoft Office 365 ที่นี่ แตคุณสามารถใช้เวอร์ชันอื่นๆ ตามความชอบของคุณได้
1. การวิเคราะห์ Anova
Anova ให้โอกาสแรกในการกำหนดว่าปัจจัยใดมีผลกระทบอย่างมีนัยสำคัญต่อชุดข้อมูลที่กำหนด หลังจากการวิเคราะห์เสร็จสิ้น นักวิเคราะห์จะทำการวิเคราะห์เพิ่มเติมเกี่ยวกับ ปัจจัยทางเมธอดโดโลยี ที่มีผลกระทบอย่างมีนัยสำคัญต่อลักษณะไม่สม่ำเสมอของชุดข้อมูล และเขาใช้ผลการวิเคราะห์ Anova ใน f-test เพื่อสร้างข้อมูลเพิ่มเติมที่เกี่ยวข้องกับ การวิเคราะห์การถดถอยประมาณ การวิเคราะห์ ANOVA เปรียบเทียบชุดข้อมูลหลายชุดพร้อมกันเพื่อดูว่ามีความเชื่อมโยงระหว่างพวกเขาหรือไม่ ANOVA เป็นวิธีทางสถิติที่ใช้วิเคราะห์ความแปรผันที่สังเกตได้ภายในชุดข้อมูลโดยแบ่งออกเป็นสองส่วน: 1) ปัจจัยเป็นระบบ และ 2) ปัจจัยสุ่ม
สูตรของ Anova:
F=MSE / MST
ที่นี่:
F = สัมประสิทธิ์ Anova
MST = ผลรวมค่าเฉลี่ยของกำลังสองเนื่องจากการรักษา
MSE = ผลรวมค่าเฉลี่ยของกำลังสองเนื่องจากข้อผิดพลาด
Anova มีสองประเภท: single factor และ two factors วิธีการเกี่ยวข้องกับการวิเคราะห์ความแปรผัน
- ใน two factors มีตัวแปรตามหลายตัว และใน one factor จะมีตัวแปรตามเดียว
- Single-factor Anova คำนวณผลของปัจจัยเดียวต่อตัวแปรเดียว และตรวจสอบว่าชุดข้อมูลตัวอย่างทั้งหมดเหมือนกันหรือไม่
- Single-factor Anova ระบุความแตกต่างที่มีนัยสำคัญทางสถิติระหว่างค่าเฉลี่ยของตัวแปรจำนวนมาก
1.1 การวิเคราะห์ Anova: Single Factor
ที่นี่ เราจะสาธิตวิธีทำการวิเคราะห์ Anova แบบ single factor ให้เราแนะนำชุดข้อมูล Excel ของเราก่อน เพื่อให้คุณเข้าใจว่าเรากำลังพยายามบรรลุอะไรกับบทความนี้ เรามีชุดข้อมูลที่แสดงกลุ่มของปัจจัย มาดูขั้นตอนในการทำการวิเคราะห์ Anova แบบ single factor
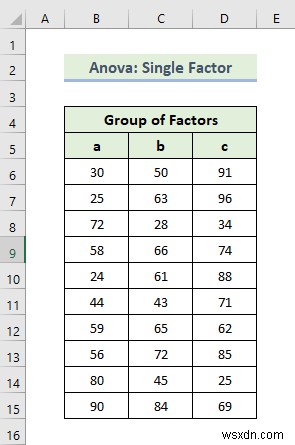
📌 ขั้นตอน:
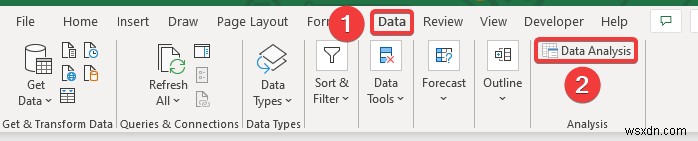
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
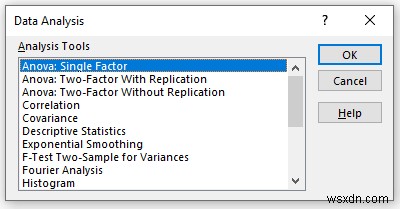
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก Anova: Single Factor
- จากนั้น คลิกที่ OK
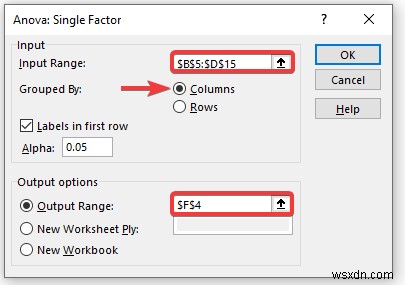
- ตอนนี้ หน้าต่าง Anova: Single Factor จะเปิด
- ใส่ข้อมูลในกล่อง Input Range ที่คุณต้องการกำหนดการวิเคราะห์ Anova โดยลากผ่านคอลัมน์หรือแถว
- ติ๊กถูก กล่องชื่อ Labels in First Row
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- ต่อไป คุณต้องติ๊กถูก Labels in the first row หากคุณเลือกช่วงข้อมูลอินพุตพร้อมป้ายกำกับ
- จากนั้น คลิกที่ OK
- ตามลำดับ ผลลัพธ์ Anova จะเป็นดังภาพด้านล่าง
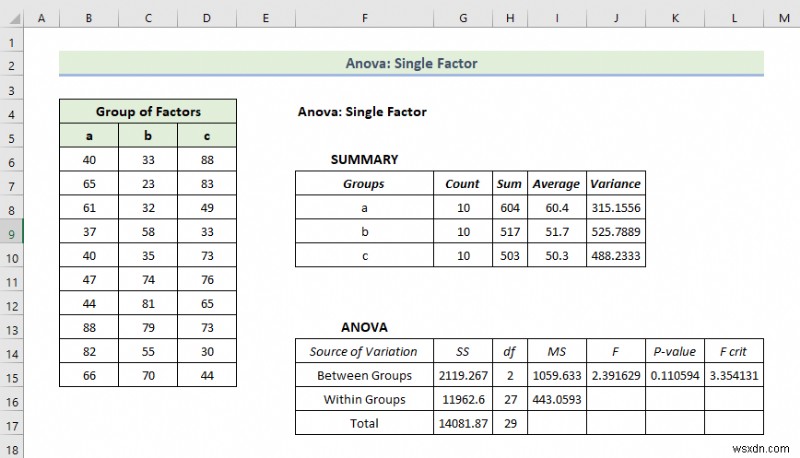
การตีความผลลัพธ์:
- ในตาราง Summary คุณจะพบค่าเฉลี่ยและความแปรผันของแต่ละกลุ่ม ที่นี่คุณเห็นระดับ เฉลี่ย คือ 60.4 สำหรับ Group a แต่ ความแปรผัน คือ 315.15 ซึ่งต่ำกว่ากลุ่มอื่นๆ มาก นั่นหมายความว่า สมาชิกในกลุ่มมีค่าน้อยกว่า
- ที่นี่ ผลลัพธ์ Anova ไม่ค่อยมีนัยสำคัญ เพราะคุณคำนวณแค่ความแปรผัน
- ที่นี่ ค่า P-values แปลความสัมพันธ์ระหว่างคอลัมน์และค่ามากกว่า 0.05 ดังนั้นจึงไม่มีนัยสำคัญทางสถิติ และไม่ควรมีความสัมพันธ์ระหว่างคอลัมน์
1.2 Anova: Two Factor with Replication
ที่นี่ เราจะสาธิตการวิเคราะห์ Anova แบบ two-factor with replication สมมติว่าคุณมีข้อมูลคะแนนสอบต่างๆ ของโรงเรียน มีสองกะในโรงเรียนนั้น หนึ่งเป็นกะเช้า อีกหนึ่งเป็นกะกลางวัน คุณต้องการทำ Data Analysis ของข้อมูลที่พร้อมเพื่อหาความสัมพันธ์ระหว่างคะแนนนักเรียนของสองกะ มาดูขั้นตอนในการทำการวิเคราะห์ Anova two-factor with replication
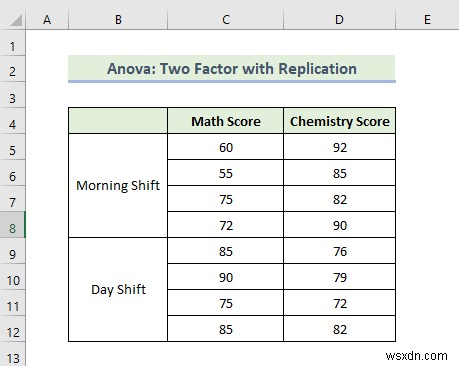
📌 ขั้นตอน:
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
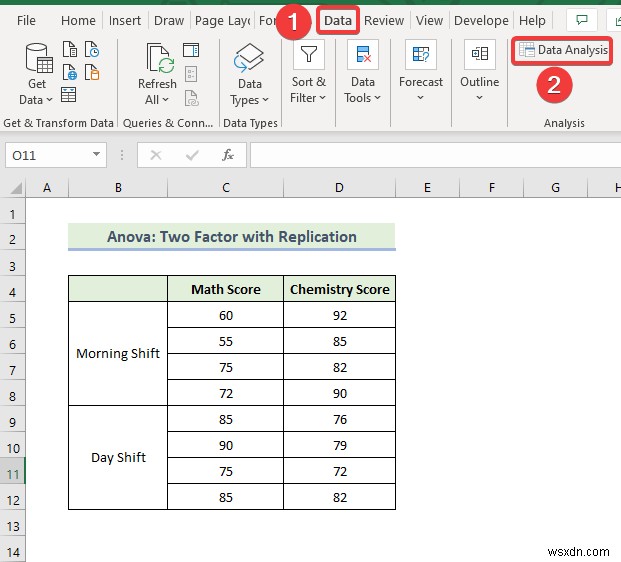
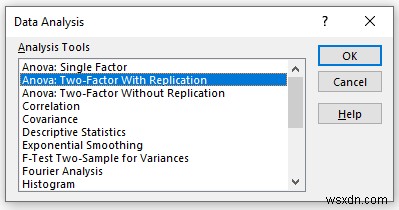
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก Anova: Two-Factor With Replication
- จากนั้น คลิกที่ OK
- ตอนนี้ หน้าต่าง ใหม่จะปรากฏ
- ใส่ข้อมูลในกล่อง Input Range ที่คุณต้องการกำหนดการวิเคราะห์ Anova โดยลากผ่านคอลัมน์หรือแถว
- ต่อไป ใส่ 4 ในกล่อง Rows per sample เนื่องจากคุณมี 4 แถวต่อกะ
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- จากนั้น คลิกที่ OK
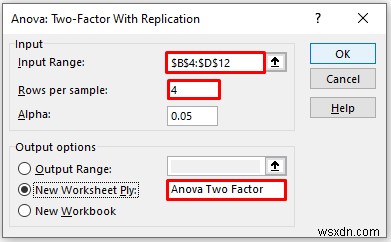
- ผลลัพธ์คือ คุณจะเห็นแผ่นงานใหม่ถูกสร้างขึ้น
- และ ผลลัพธ์ two-way Anova แสดงในแผ่นงานนี้
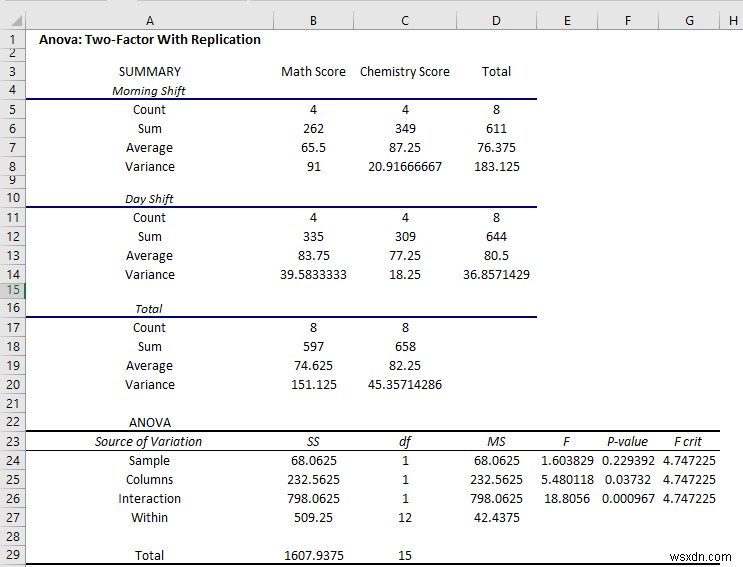
การตีความผลลัพธ์:
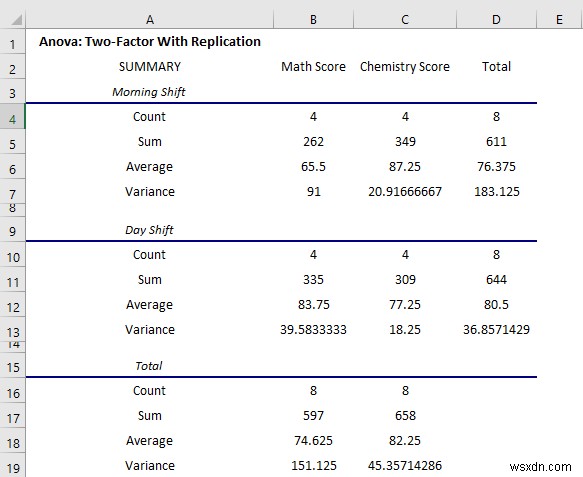
ที่นี่ ตารางแรก แสดงสรุปของกะ ในสรุป:
- คะแนนเฉลี่ยในกะ Morning ในคณิตศาสตร์คือ 65.5 แต่ในกะ Day คือ 83.75
- แตในสอบเคมี คะแนนเฉลี่ยในกะ Morning คือ 87.25 แต่ในกะ Day คือ 77.25
- ความแปรผันสูงมากที่ 91 ในกะ เช้า ในสอบคณิตศาสตร์
- คุณจะได้ภาพรวมของข้อมูลในสรุป
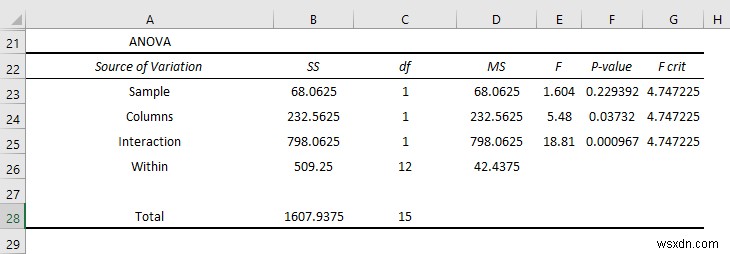
เช่นเดียวกัน คุณสามารถสรุปปฏิสัมพันธ์และผลกระทบแต่ละอย่างในส่วน Anova ได้ ในสรุป:
- P-value ของ Columns คือ 0.037 ซึ่งมีนัยสำคัญทางสถิติ ดังนั้นคุณจึงสามารถพูดได้ว่ามีผลของกะต่อผลงานของนักเรียนในการสอบ แต่ค่า ใกล้ ค่า alpha 0.05 ดังนั้นผลกระทบจึง น้อยกว่า
- แต่ P-value ของ interactions คือ 0.000967 ซึ่งน้อยกว่าค่า alpha มาก จึงมีนัยสำคัญทางสถิติ มาก และคุณสามารถพูดได้ว่าผลของกะต่อทั้งสองการสอบสูงมาก
1.3 Anova: Two Factor without Replication
ตอนนี้ เราจะทำการวิเคราะห์ความแปรผันโดยทำตามวิธี two factors without replication Anova Analysis เราสมมติว่าคุณมีข้อมูลคะแนนสอบต่างๆ ของโรงเรียน มีสองกะในโรงเรียน หนึ่งเป็นกะเช้า อีกหนึ่งเป็นกะกลางวัน คุณต้องการทำ Data Analysis ของข้อมูลที่พร้อมเพื่อหาความสัมพันธ์ระหว่างคะแนนนักเรียนของสองกะ มาดูขั้นตอนในการทำ two factor ANOVA without replication analysis
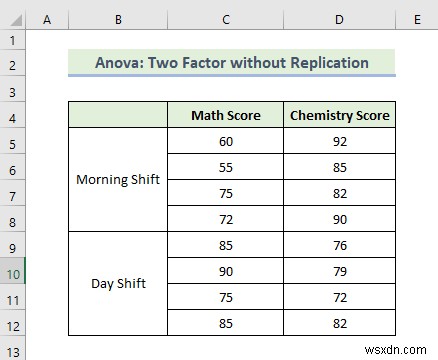
📌 ขั้นตอน:
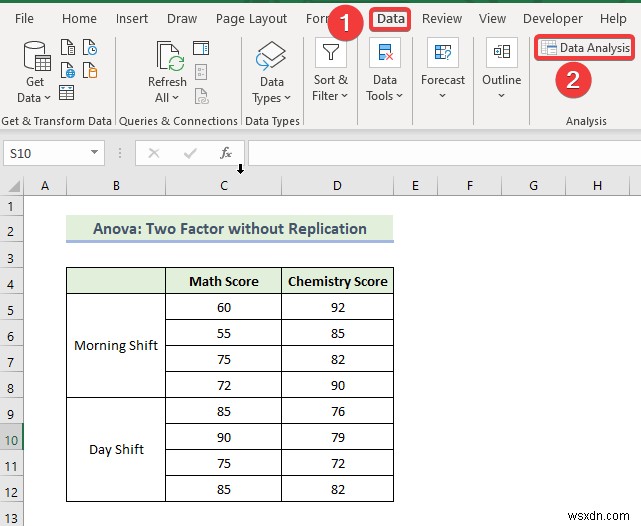
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
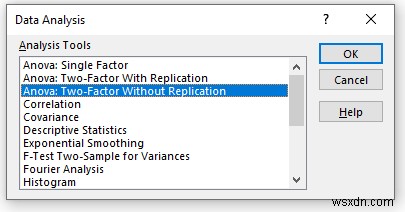
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก "Anova: Two-Factor Without Replication"
- จากนั้น คลิกที่ OK
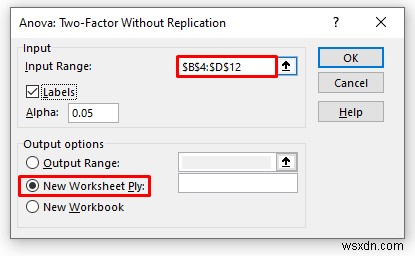
- ตอนนี้ หน้าต่าง ใหม่จะปรากฏ
- ใส่ข้อมูลในกล่อง Input Range ที่คุณต้องการกำหนดการวิเคราะห์ Anova โดยลากผ่านคอลัมน์หรือแถว
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- ต่อไป คุณต้องติ๊กถูก Labels หากช่วงข้อมูลอินพุตมีป้ายกำกับ
- จากนั้น คลิกที่ OK
- ผลลัพธ์คือ คุณจะเห็นแผ่นงานใหม่ถูกสร้างขึ้น
- ตามลำดับ คุณจะได้ผลลัพธ์ two-way Anova ตามภาพด้านล่าง
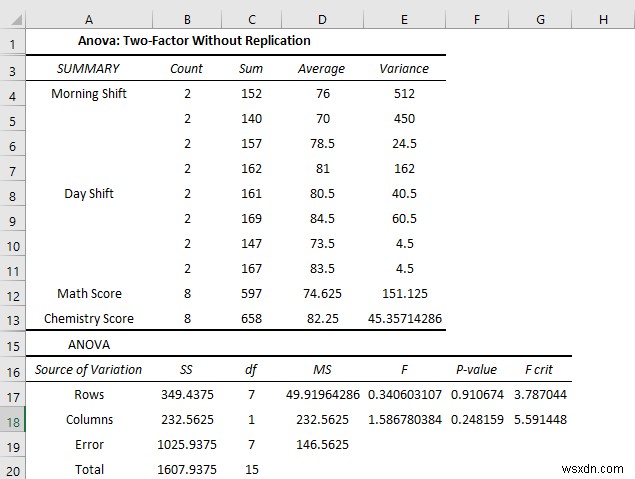
การตีความผลลัพธ์:
- คะแนนเฉลี่ยในกะ Morning ในคณิตศาสตร์คือ 65.5 แต่ในกะ Day คือ 83.75
- แตในสอบเคมี คะแนนเฉลี่ยในกะ Morning คือ 87 แต่ในกะ Day คือ 77.25
- P-value ของ Columns คือ 0.24 ซึ่งมีนัยสำคัญทางสถิติ ดังนั้นคุณจึงสามารถพูดได้ว่ามีผลของกะต่อผลงานของนักเรียนในการสอบ แต่ค่า ใกล้ ค่า alpha 0.05 ดังนั้นผลกระทบจึง น้อยกว่า
อ่านเพิ่มเติม: วิธีเพิ่ม Data Analysis ใน Excel (พร้อม 2 ขั้นตอนเร็ว)
2. การวิเคราะห์ Correlation
ตอนนี้ เราจะทำการวิเคราะห์ข้อมูล correlation ซึ่งเป็นคุณสมบัติที่ยอดเยี่ยมของ Excel data analysis toolpak ในสถิติ correlation หรือ correlation coefficient คือพารามิเตอร์ที่แสดงความสอดคล้องระหว่างสองตัวแปรตอบสนองต่อปริมาณที่ผันผวนอย่างต่อเนื่องของอีกตัวหนึ่ง ค่าของมันอยู่ระหว่าง -1 ถึง +1 ดังนั้น จึงมีสามสถานะในการกำหนดความสัมพันธ์ของตัวแปร คือ:
- -1 แสดง correlation ลบ หมายถึงตัวแปรเปลี่ยนแปลงในทิศทางตรงข้าม
- +1 แสดง correlation บวก หมายถึงตัวแปรเปลี่ยนแปลงในทิศทางเดียวกัน
- 0 แสดงไม่มี correlation หมายถึงไม่มีการเคลื่อนไหวที่ชัดเจนในทิศทางใดๆ ของตัวแปรเมื่อเปลี่ยนค่าตัวแปรอื่น
ที่นี่ เรามีชุดข้อมูลที่มีราคาหุ้นสองตัวในช่วงเวลาต่างๆ มาดูขั้นตอนในการทำ correlation data analysis
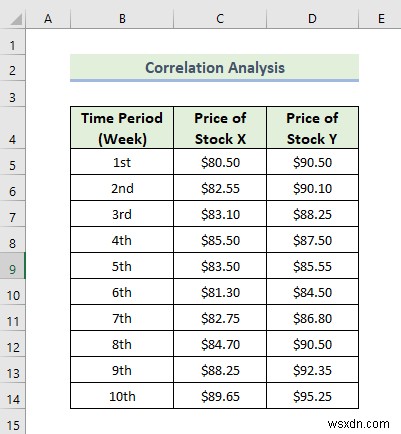
📌 ขั้นตอน:
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
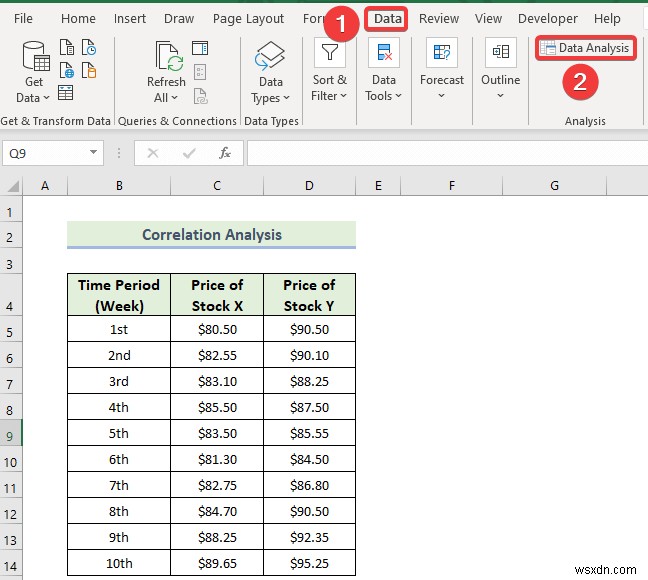
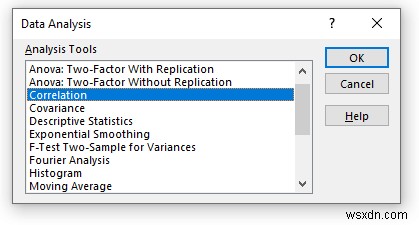
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก Correlation
- ต่อไป คลิก OK
- ตอนนี้ หน้าต่าง ใหม่จะปรากฏ
- ใส่ข้อมูลในกล่อง Input Range ที่คุณต้องการคำนวณ correlation โดยลากผ่านคอลัมน์หรือแถว
- ตอนนี้ คุณต้องติ๊กถูกตัวเลือก Columns ในตัวเลือก Grouped By
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- ต่อไป คุณต้องติ๊กถูก Labels in the first row หากช่วงข้อมูลอินพุตมีป้ายกำกับ
- จากนั้น คลิก OK
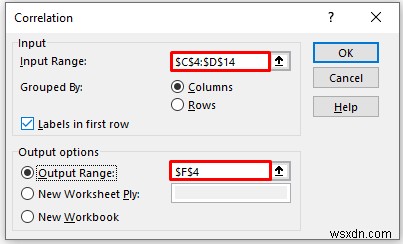
- ตามลำดับ คุณจะได้ผลลัพธ์ correlation ดังต่อไปนี้
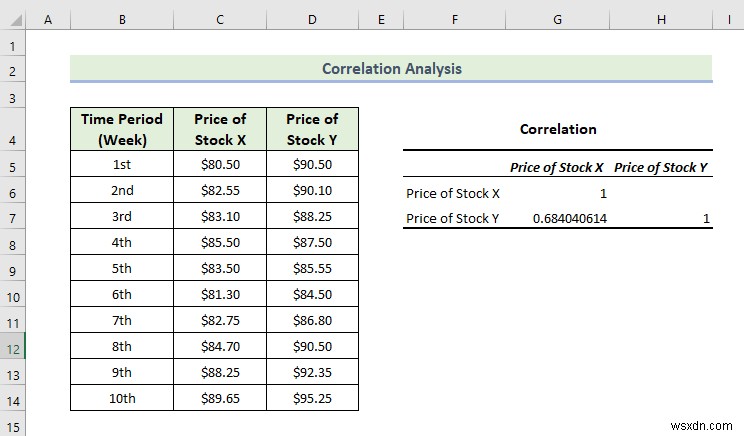
จากคำนวณข้างต้น เราสามารถเห็น correlation บวก ซึ่งหมายถึงตัวแปรเปลี่ยนแปลงในทิศทางเดียวกัน
อ่านเพิ่มเติม: วิธีวิเคราะห์ข้อมูล Time Series ใน Excel (พร้อมขั้นตอนง่ายๆ)
3. การวิเคราะห์ Covariance
ตอนนี้ เราจะทำการวิเคราะห์ข้อมูล covariance ซึ่งเป็นคุณสมบัติที่ยอดเยี่ยมของ Excel data analysis toolpak ความแปรผันร่วมของสองตัวแปรเป็นการวัดว่าตัวหนึ่งมีอิทธิพลต่ออีกตัวอย่างไร ชัดเจนว่ามันเป็นการประเมินความเบี่ยงเบนระหว่างสองตัวแปรที่จำเป็น เพิ่มเติม ตัวแปร ไม่จำเป็นต้องพึ่งพากัน
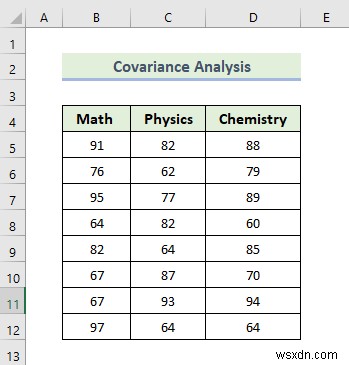
📌 ขั้นตอน:
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
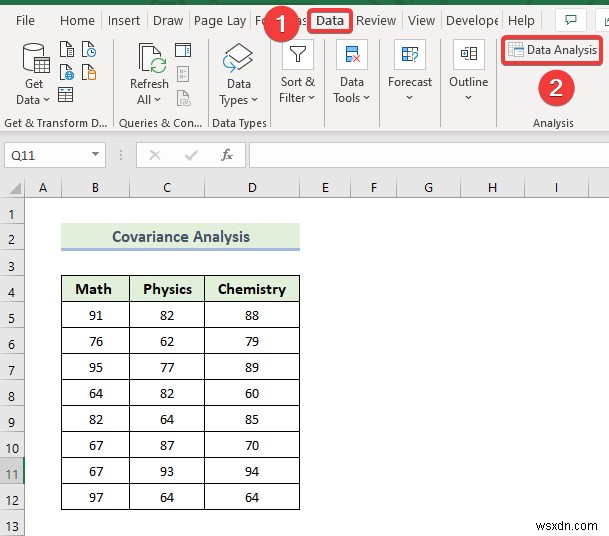
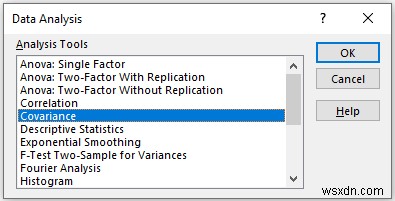
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก Covariance
- จากนั้น กด Enter
- จากนั้น คลิก OK
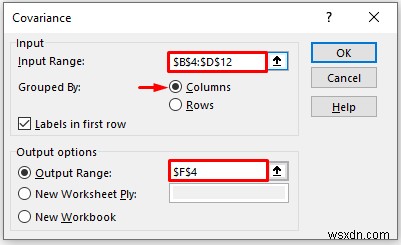
- ตอนนี้ หน้าต่าง ใหม่จะปรากฏ
- ใส่ข้อมูลในกล่อง Input Range ที่คุณต้องการคำนวณ covariance โดยลากผ่านคอลัมน์หรือแถว
- ตอนนี้ คุณต้องติ๊กถูกตัวเลือก Columns ในส่วน Grouped By
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- ต่อไป คุณต้องติ๊กถูก Labels in the first row หากช่วงข้อมูลอินพุตมีป้ายกำกับ
- จากนั้น คลิก OK
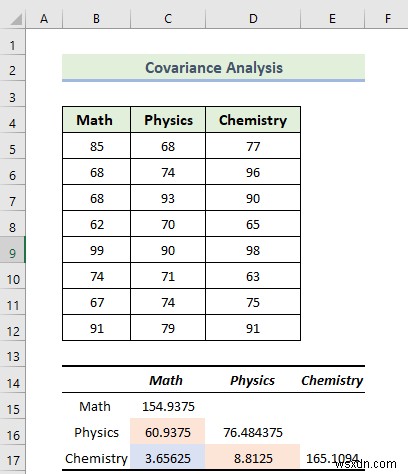
- ตามลำดับ คุณจะได้ผลลัพธ์ covariance ดังต่อไปนี้
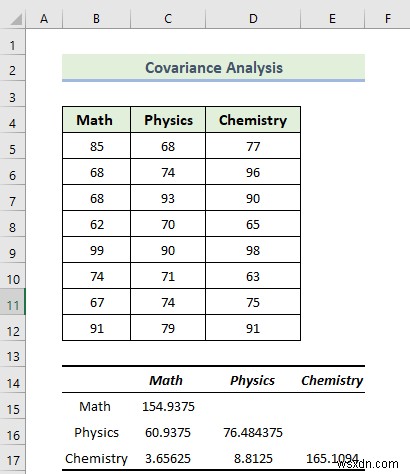
คำอธิบายผลลัพธ์:
เมทริกซ์ correlation ช่วยให้เราประเมินความสัมพันธ์ระหว่างตัวแปรหลายตัวและตัวแปรเดี่ยว ส่วนไฮไลท์จากภาพต่อไปนี้ระบุความแปรผันสำหรับแต่ละวิชา
- ความแปรผันของคณิตศาสตร์คือ 154.9375 และความแปรผันของฟิสิกส์คือ 76.484375 ต่อมา ความแปรผันของเคมีคือ 154.9375
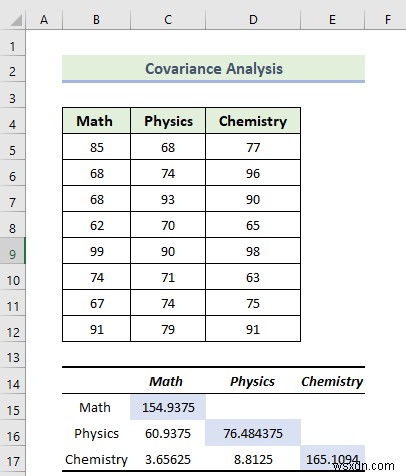
ส่วนไฮไลท์จากภาพต่อไปนี้ระบุค่าความแปรผันระหว่างสองวิชา คณิตศาสตร์และฟิสิกส์ คณิตศาสตร์และเคมี และฟิสิกส์และประวัติศาสตร์ มีค่าความแปรผันตามลำดับ 60.9375 3.65625 และ 8.8125 เมื่อ covariance ในกรณีนี้เป็นบวก แสดงว่าตัวแปรมีสัดส่วน หมายถึงเมื่อตัวหนึ่งเพิ่มขึ้น อีกตัวมักจะเพิ่มขึ้นพร้อมกัน
อ่านเพิ่มเติม: [แก้ไข:] Data Analysis ไม่แสดงใน Excel (2 วิธีแก้ไขที่มีประสิทธิภาพ)
4. การวิเคราะห์ Descriptive Statistics
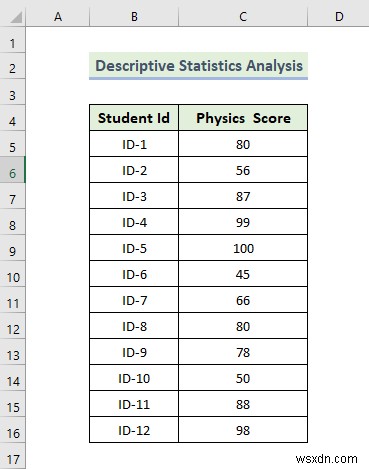
ตอนนี้ เราจะสาธิตวิธีทำ descriptive statistics analysis Excel data analysis toolpak อนุญาตให้เราทำ descriptive statistics analysis เพื่อวิเคราะห์ชุดข้อมูลเพื่อกำหนดลักษณะเฉพาะ ที่นี่ เรามีชุดข้อมูลที่มีคะแนนฟิสิกส์สำหรับนักเรียนแต่ละคน มาดูขั้นตอนในการทำ correlation data analysis
📌 ขั้นตอน:
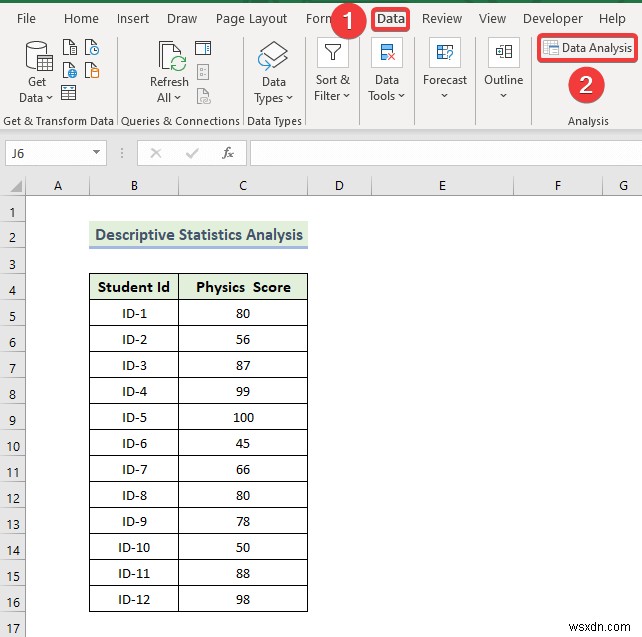
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
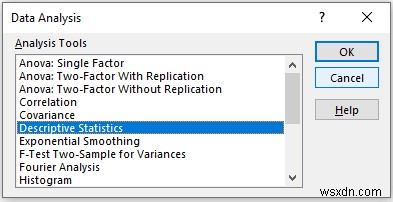
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก Descriptive Statistics
- จากนั้น คลิก OK
- ตอนนี้ หน้าต่าง ใหม่จะปรากฏ
- ใส่ข้อมูลในกล่อง Input Range ที่คุณต้องการคำนวณ descriptive statistics โดยลากผ่านคอลัมน์หรือแถว
- ตอนนี้ คุณต้องติ๊กถูกตัวเลือก Columns ในส่วน Grouped By
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- จากนั้น ติ๊กถูก Summary statistics
- จากนั้น คลิก OK
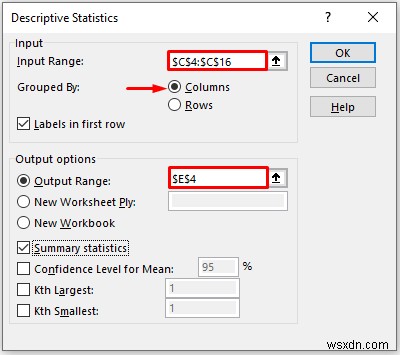
- ตามลำดับ คุณจะได้ผลลัพธ์ covariance ดังต่อไปนี้
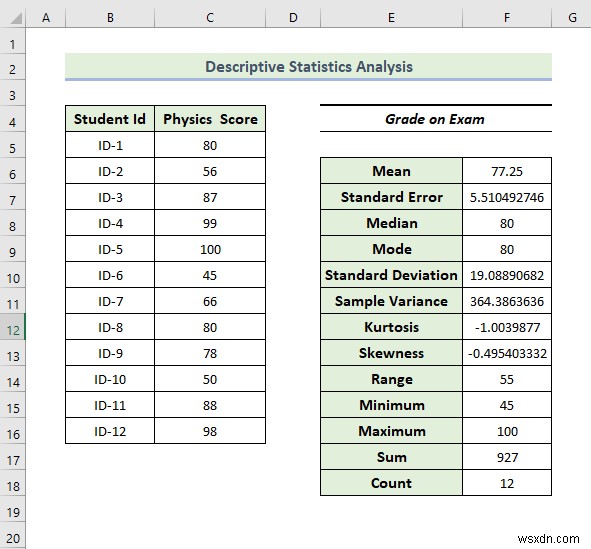
- ผลลัพธ์ข้างต้นให้ลักษณะเฉพาะของสองตัวแปร คือ ค่าเฉลี่ย ค่ามัธยฐาน ส่วนเบี่ยงเบนมาตรฐาน และค่าสูงสุดและต่ำสุดของชุดข้อมูล ซึ่งตามลำดับคือ 77.25, 80, 19.088, 45, และ 100
อ่านเพิ่มเติม: วิธีใช้ Analyze Data ใน Excel (5 วิธีง่ายๆ)
5. การวิเคราะห์ Exponential Smoothing
ตอนนี้ เราจะสาธิตวิธีทำ exponential smoothing analysis Excel data analysis toolpak อนุญาตให้เราทำ exponential smoothing เพื่อตัดสินใจที่เหมาะสมเกี่ยวกับปริมาณธุรกิจ ที่นี่ เรามีชุดข้อมูลที่มีจำนวนสินค้าที่ขายในสัปดาห์ต่างๆ โดยบริษัทผลิต มาดูขั้นตอนในการทำ exponential smoothing data analysis
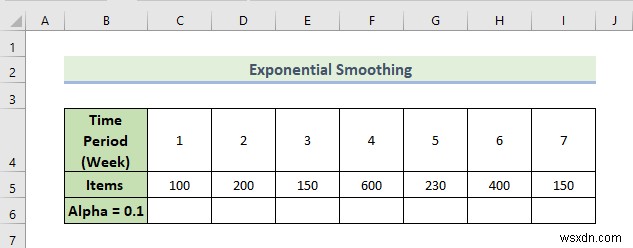
📌 ขั้นตอน:
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
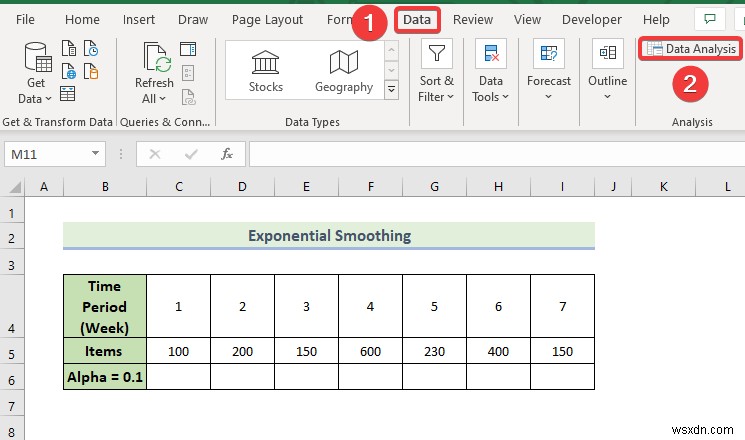
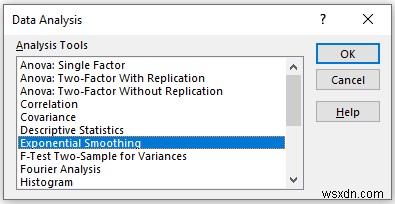
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก Exponential Smoothing
- จากนั้น คลิก OK
- ตอนนี้ หน้าต่าง ใหม่จะปรากฏ
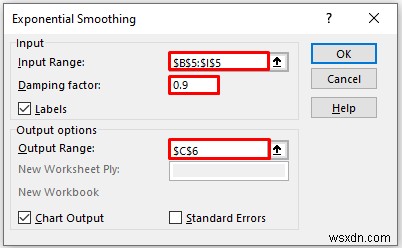
- ใส่ข้อมูลในกล่อง Input Range ที่คุณต้องการคำนวณ exponential smoothing โดยลากผ่านคอลัมน์หรือแถว
- ตอนนี้ คุณต้องใส่ 0.9 ในกล่อง Damping factor ที่นี่ เรา damping 1-alpha
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- ต่อไป คุณต้องติ๊กถูก Labels หากช่วงข้อมูลอินพุตมีป้ายกำกับ
- จากนั้น ติ๊กถูก Chat Output
- จากนั้น คลิก OK
- ตามลำดับ คุณจะได้ผลลัพธ์ exponential smoothing และแผนภูมิสำหรับ 0.1 alpha
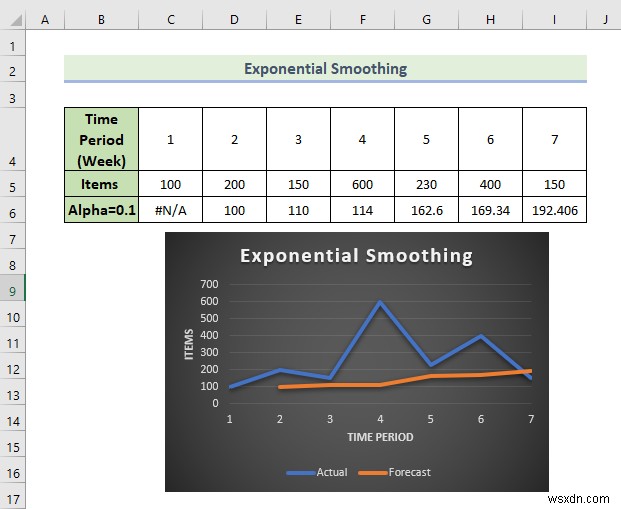
ที่นี่ จากผลลัพธ์ข้างต้น เราสามารถพูดได้ว่า Excel ไม่สามารถให้ข้อมูลสำหรับค่าแรกในวิธีนี้ได้ หากเราใช้ damping factor ใหญ่ เราจะได้ peaks และ valleys ที่เรียบกว่ามากขึ้น
6. การวิเคราะห์ F-Test Two-Sample for Variances
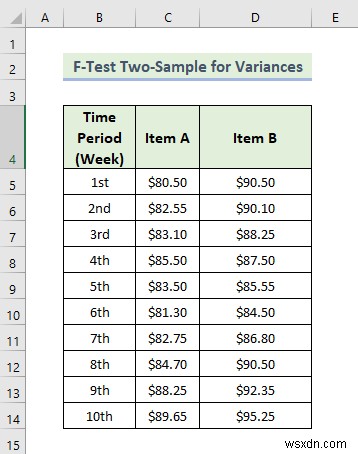
ตอนนี้ เราจะทำ F-test สำหรับ two sample variances โดยใช้ความแปรผันของสองตัวแปร F-test ให้การวิเคราะห์ทางสถิติใน Excel ที่นี่ เรามีชุดข้อมูลที่มีราคาขายสองรายการในสัปดาห์ต่างๆ โดยบริษัทผลิต มาดูขั้นตอนในการทำ f-test สำหรับ two sample variances
📌 ขั้นตอน:
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
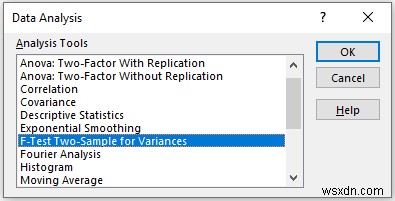
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก F-Test Two-Sample for Variances
- จากนั้น คลิก OK
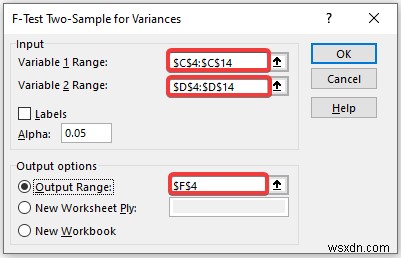
- ตอนนี้ หน้าต่าง ใหม่จะปรากฏ
- ใส่ข้อมูลในกล่อง Input Range ที่คุณต้องการคำนวณ F-test โดยลากผ่านคอลัมน์หรือแถว
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- ต่อไป คุณต้องติ๊กถูก Labels หากช่วงข้อมูลอินพุตมีป้ายกำกับ
- จากนั้น คลิก OK
- ตามลำดับ คุณจะได้ผลลัพธ์ต่อไปนี้ของ F-test สำหรับ two sample variances
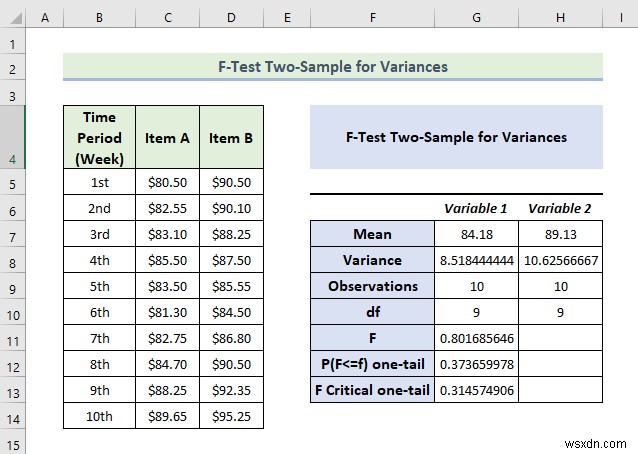
คำอธิบายผลลัพธ์:
- จากข้อมูลข้างต้น เราเห็นว่าค่าเฉลี่ยของตัวแปร 2 มากกว่าตัวแปร 1
- เรายังรู้ว่าหากค่า F มากกว่าค่า F Critical one-tail ในกรณีนี้ เราสามารถพูดได้ว่าไม่สอดคล้องกับ null hypothesis ในข้อมูลข้างต้น ค่า F คือ .8016 และค่า F Critical one-tail คือ 0.3145 ซึ่งบ่งชี้ว่า F มากกว่า F critical one-tail มาก กล่าวอีกนัยหนึ่ง ความแปรผันระหว่างสองตัวแปรไม่ตรงกัน
7. การวิเคราะห์ Moving Average
ตอนนี้ เราจะทำ moving average analysis ซึ่งเป็นหนึ่งในคุณสมบัติที่ดีที่สุดของ Excel data analysis toolpak Moving average หมายถึงช่วงเวลาของค่าเฉลี่ยเท่าเดิม แต่เคลื่อนที่เมื่อมีข้อมูลใหม่เพิ่มเข้ามา Moving average ทำให้ความผิดปกติ (peaks และ valleys) จากข้อมูลเรียบร้อยเพื่อให้มองเห็นแนวโน้มได้ง่าย ยิ่งช่วง interval ใหญ่ในการคำนวณ moving average จะทำให้การ smoothing ความผันผวนเกิดขึ้นมากขึ้น เนื่องจากมีจุดข้อมูลมากขึ้นรวมอยู่ในค่าเฉลี่ยที่คำนวณแต่ละครั้ง ที่นี่ เรามีชุดข้อมูลที่มีจำนวนสินค้าที่ขายในสัปดาห์ต่างๆ โดยบริษัทผลิต มาดูขั้นตอนในการทำ moving average analysis
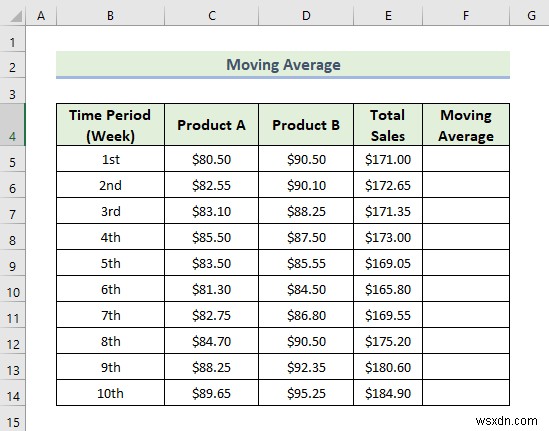
📌 ขั้นตอน:
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
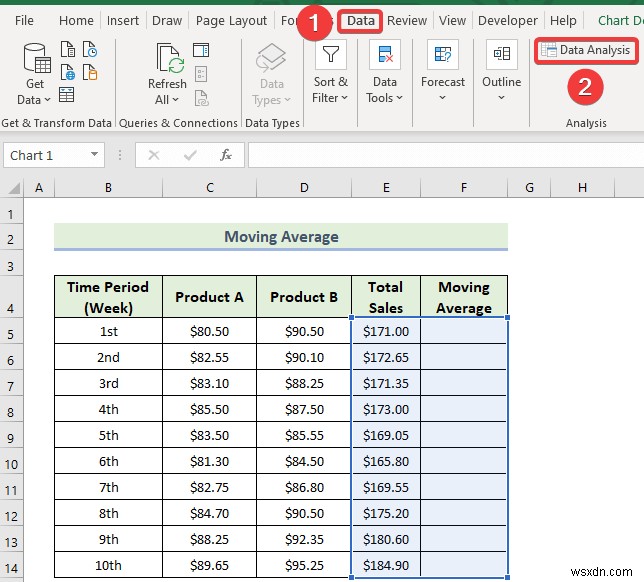
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก Moving Average
- จากนั้น คลิก OK
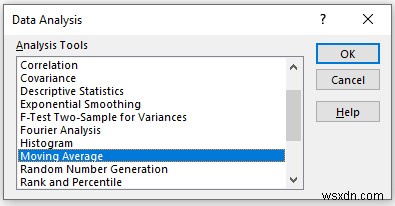
ในกล่อง Moving Average:
- ใส่ข้อมูลในกล่อง Input Range ที่คุณต้องการคำนวณ moving average โดยลากผ่านคอลัมน์หรือแถว
- เขียนจำนวนช่วงใน Interval
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- หากคุณต้องการดู trendline ของข้อมูลของคุณพร้อมแผนภูมิ ให้ติ๊กถูก Chart Output มิฉะนั้นปล่อยว่างไว้
- ต่อไป คุณต้องติ๊กถูก Labels in the first row หากช่วงข้อมูลอินพุตมีป้ายกำกับ
- จากนั้น คลิก OK
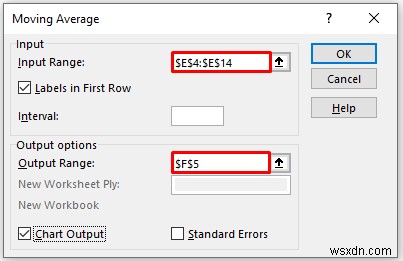
- ตามลำดับ คุณจะได้ moving average ของข้อมูลพร้อม trendline ของ Excel แสดงข้อมูลต้นฉบับและค่า moving average พร้อมความผันผวนที่เรียบร้อย
บทความที่คล้ายกัน
- วิธีวิเคราะห์ข้อมูลเชิงปริมาณใน Excel (พร้อมขั้นตอนง่ายๆ)
- Analyze Large Data Sets in Excel (6 Effective Methods)
- วิธีวิเคราะห์ข้อมูล Likert Scale ใน Excel (พร้อมขั้นตอนเร็ว)
- Analyse Qualitative Data from a Questionnaire in Excel
8. การสร้างตัวเลขสุ่ม
ตอนนี้ เราจะสร้างตัวเลขสุ่ม Excel data analysis toolpak อนุญาตให้เราสร้างตัวเลขสุ่มด้วยเกณฑ์ต่างๆ มาดูขั้นตอนในการทำ moving average analysis
📌 ขั้นตอน:
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
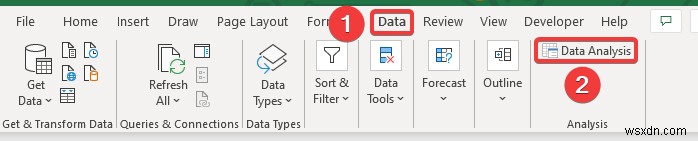
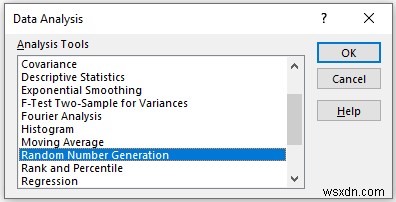
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก Descriptive Statistics
- จากนั้น คลิก OK
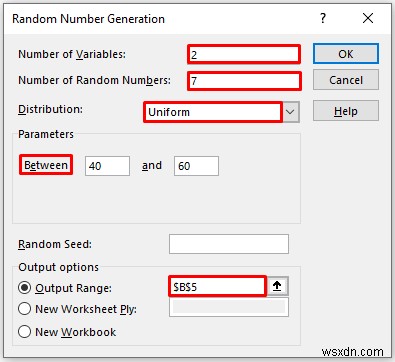
ในกล่อง Random Number Generation:
- ใส่ข้อมูลเกี่ยวกับ Number of Variables ซึ่งบ่งชี้จำนวนคอลัมน์ของตัวเลขสุ่มที่คุณต้องการในแผ่นงาน ที่นี่ เราใส่ 2 เพราะเราต้องการ 2 คอลัมน์
- ต่อไป คุณต้องใส่ข้อมูลใน Number of Random Numbers ซึ่งหมายถึงจำนวนแถวที่คุณต้องการในแผ่นงาน ที่นี่ ใส่ 7 หมายถึงเราต้องการ 7 แถวในแผ่นงานของเรา
- จากนั้น เลือก uniform ใน Distribution ที่นี่ Distribution หมายถึงว่าคุณต้องการการกระจายตัวเลขสุ่มแบบไหน
- ที่นี่ parameters บ่งชี้ขอบเขตของการกระจายของคุณ ในตัวอย่างนี้ เราใช้ 40 ถึง 60
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- จากนั้น คลิก OK
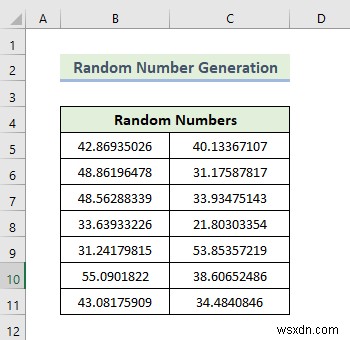
- ตามลำดับ คุณจะสามารถสร้างตัวเลขสุ่มด้วยเกณฑ์ที่ระบุได้ตามภาพด้านล่าง
9. การวิเคราะห์ Rank and Percentile
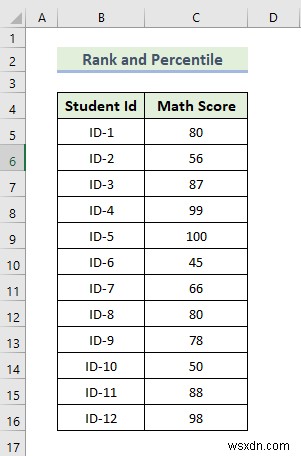
ตอนนี้ เราจะทำ rank and percentile analysis ที่นี่ เรามีชุดข้อมูลที่มี ID นักเรียนและคะแนนสอบคณิตศาสตร์ของพวกเขา เราจะคำนวณ rank และ percentile ของคะแนนสอบคณิตศาสตร์ของแต่ละนักเรียน มาดูขั้นตอนในการทำ rank and percentile analysis
📌 ขั้นตอน:
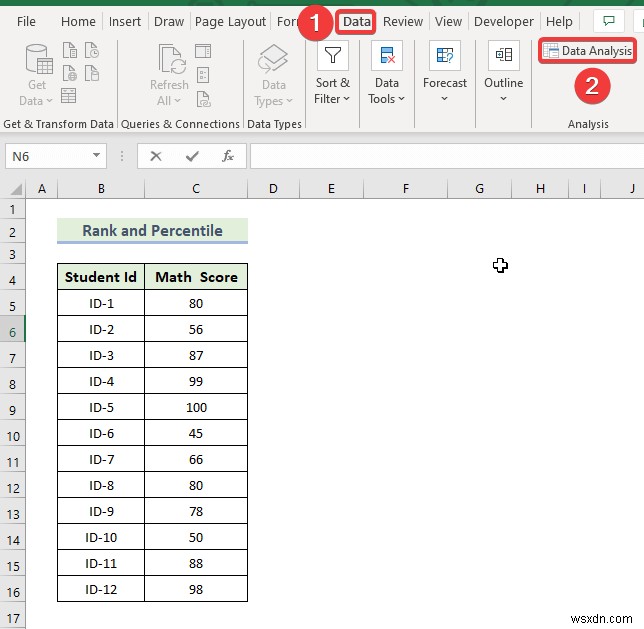
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
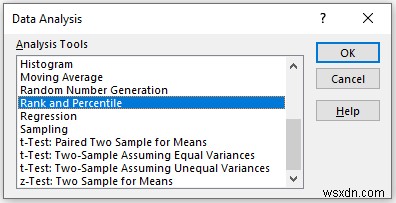
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก Rank and Percentile
- จากนั้น คลิก OK
ในกล่อง Rank and Percentile:
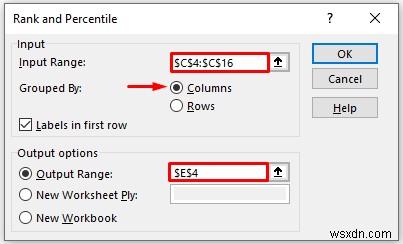
- ใส่ข้อมูลในกล่อง Input Range ที่คุณต้องการคำนวณ moving average โดยลากผ่านคอลัมน์หรือแถว
- ตอนนี้ คุณต้องติ๊กถูกตัวเลือก Columns ในส่วน Grouped By
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- ต่อไป คุณต้องติ๊กถูก Labels in the first row หากช่วงข้อมูลอินพุตมีป้ายกำกับ
- จากนั้น คลิก OK
- ตามลำดับ คุณจะได้ rank และ percentile สำหรับคะแนนสอบของแต่ละนักเรียนตามภาพด้านล่าง
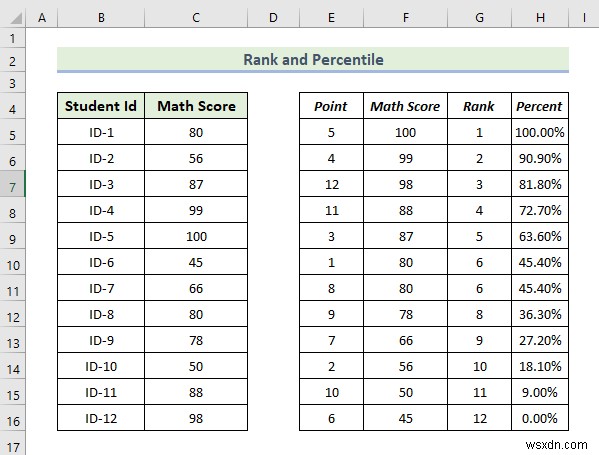
จากผลลัพธ์ข้างต้น เราเห็นว่าสามารถคำนวณ rank และ percentile ของคะแนนสอบของแต่ละนักเรียนได้ ที่นี่ Rank 1 คะแนนคือ 100 ซึ่งเป็นคะแนนคณิตศาสตร์ของ ID-5 และ rank สุดท้ายคะแนนคือ 45 ซึ่งเป็นคะแนนคณิตศาสตร์ของ ID-6
10. การวิเคราะห์ Regression
ตอนนี้ เราจะทำ regression analysis Regression analysis เป็นส่วนหนึ่งของสถิติที่ช่วยทำนายค่าตามตัวแปรสองตัวขึ้นไป ที่นี่ เรามีชุดข้อมูลที่มีชื่อผู้เล่น จำนวนแมตช์ที่เล่นโดยแต่ละผู้เล่น และจำนวนประตูที่ทำได้โดยแต่ละผู้เล่น มาดูขั้นตอนในการทำ regression analysis
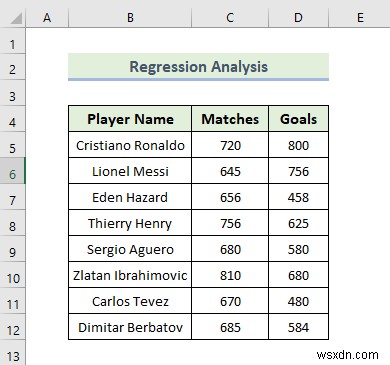
📌 ขั้นตอน:
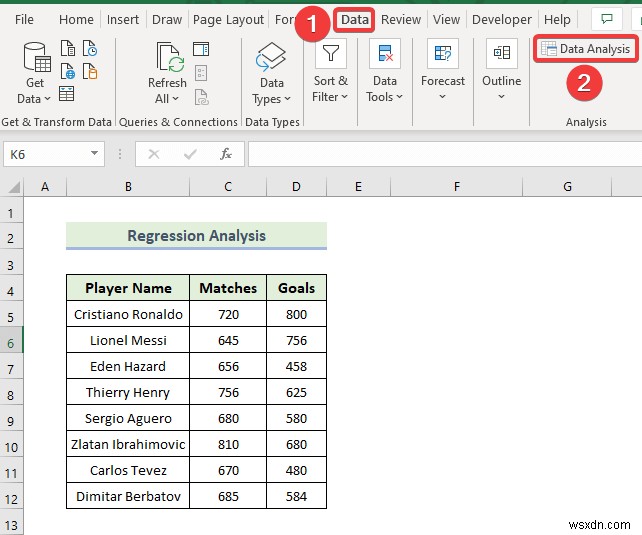
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
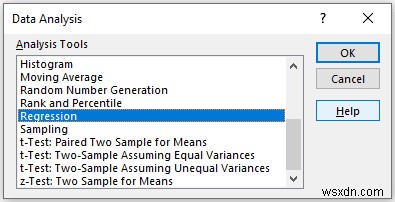
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก Regression
- จากนั้น คลิก OK
ในกล่อง Regression:
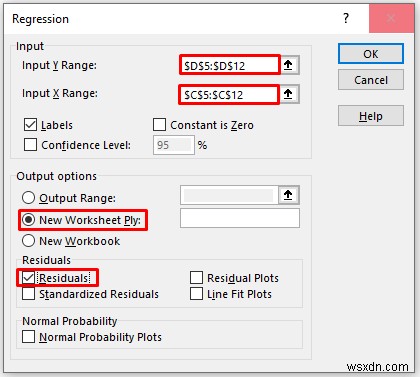
- ใส่ข้อมูลในกล่อง Input Range และใส่ช่วงข้อมูลในกล่อง Input X Range และ Input Y Range
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- ต่อไป คุณต้องติ๊กถูก Labels หากช่วงข้อมูลอินพุตมีป้ายกำกับ
- คุณยังต้องติ๊กถูกตัวเลือก Residuals เพื่อรับค่าเอาต์พุต
- จากนั้น คลิก OK
- ตามลำดับ คุณจะได้ผลลัพธ์ต่อไปนี้ของ regression analysis
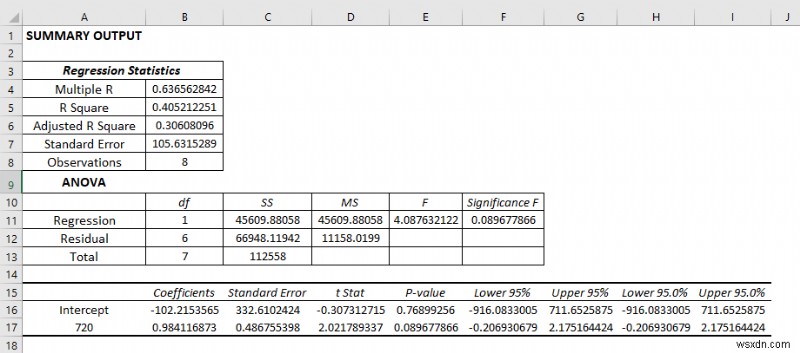
คำอธิบายผลลัพธ์ Regression Analysis:
Regression Statistics:
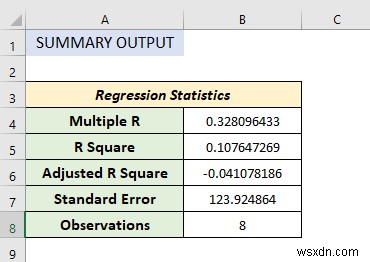
Regression statistics เป็นอาร์เรย์ของพารามิเตอร์ต่างๆ ที่อธิบายว่า linear regression ที่วัดได้เหมาะสมเพียงใด
- Multiple R เป็นพารามิเตอร์สัมประสิทธิ์การสหสัมพันธ์ที่บ่งชี้ความสัมพันธ์ระหว่างตัวแปร ค่าของมันอยู่ระหว่าง -1 ถึง +1 ค่าที่ใหญ่กว่าแสดงถึงความสัมพันธ์ที่แข็งแกร่งกว่า
- R Square เป็นสัญลักษณ์ของสัมประสิทธิ์การกำหนด มันบ่งชี้มาตราส่วนที่โมเดลข้อมูลเข้ากับ regression analysis ได้ดีแค่ไหน
- The adjusted R square ใช้ใน regression analysis หลายตัวแปร
- Standard Error เป็นพารามิเตอร์อีกตัวที่แสดงการเข้ากันได้ดีของ regression analysis ใดๆ ยิ่ง standard error น้อย ยิ่งสมการ linear regression แม่นยำ มันแสดงระยะทางเฉลี่ยของจุดข้อมูลจากสมการเชิงเส้น
Anova:
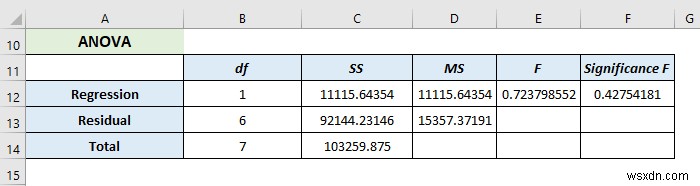
มันวิเคราะห์ความแปรผันของโมเดลข้อมูล
- ที่นี่ df แทน degree of freedom
- SS (sum of squares) เป็นสัญลักษณ์ของพารามิเตอร์ good-to-fit
- MS หมายถึง Mean Square
- F อ้างถึง Null Hypothesis มันทดสอบนัยสำคัญโดยรวมของโมเดล regression
- Significance of F หมายถึง P-value ของ F
Co-efficient Outcome:
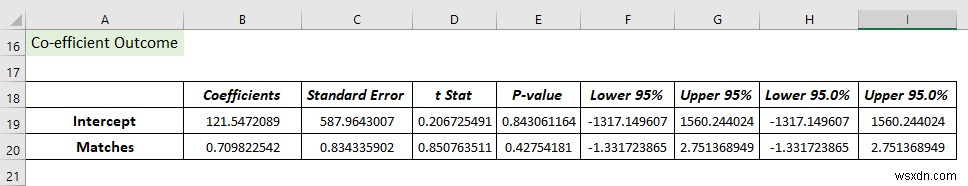
มันช่วยกำหนดค่า Y ได้ง่าย
Residual Output:
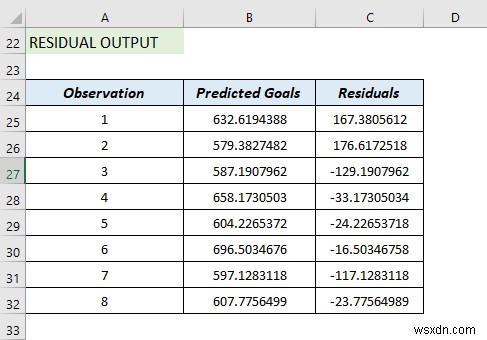
ดังนั้น มันเปรียบเทียบค่าประมาณกับค่าที่คำนวณได้
11. การวิเคราะห์ t-Test
ตอนนี้ เราจะทำ T-Test analysis ของชุดข้อมูล T-Test มีสามประเภท:
- Paired two samples for means
- Two samples assuming equal variances
- Two-samples using unequal variances
ส่วนนี้ให้รายละเอียดอย่างละเอียดเกี่ยวกับสามประเภทของ t-Test analysis คุณสามารถใช้ cualquiera สำหรับวัตถุประสงค์ของคุณ พวกเขามีความยืดหยุ่นสูงเมื่อพูดถึงการปรับแต่ง
11.1 t-Test: Paired Two Sample for Means
ตอนนี้ เราจะทำ t-Test: Paired Two Sample for Means ที่นี่ เรามีชุดข้อมูลที่มี ID นักเรียนและคะแนนคณิตศาสตร์และฟิสิกส์ของแต่ละนักเรียน มาดูขั้นตอนในการทำ t-Test: Paired Two Sample for Means analysis
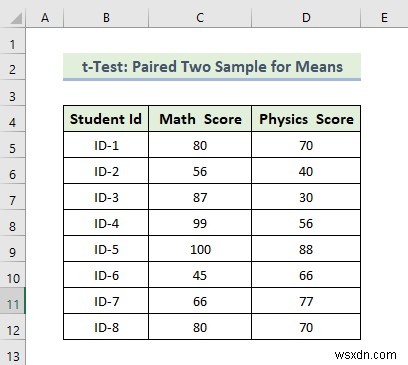
📌 ขั้นตอน:
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
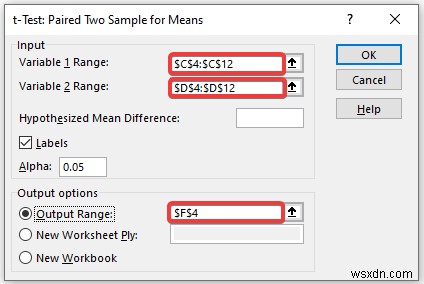
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก t-Test: Paired Two Samples for Means
- จากนั้น คลิก OK
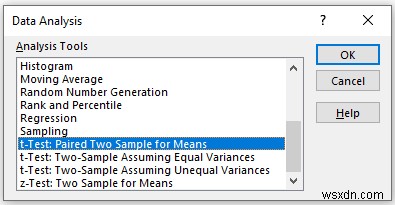
ในกล่อง t-Test: Paired Two Sample for Means:
- ใส่ข้อมูลในกล่อง Input และใส่ช่วงข้อมูลในกล่อง Variable 1 Range และ Variable 2 Range
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- ต่อไป คุณต้องติ๊กถูก Labels หากช่วงข้อมูลอินพุตมีป้ายกำกับ
- จากนั้น คลิก OK
- ตามลำดับ คุณจะได้ผลลัพธ์ต่อไปนี้ของ t-Test: Paired Two Sample for Means
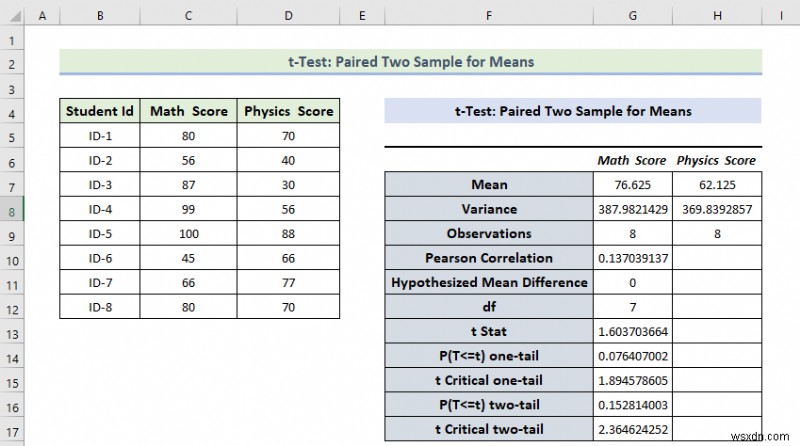
คำอธิบายผลลัพธ์:
- ที่นี่ เราเห็นว่าค่าเฉลี่ยของคะแนนคณิตศาสตร์มากกว่าค่าเฉลี่ยของคะแนนฟิสิกส์
- ความแปรผันของคะแนนคณิตศาสตร์ก็มากกว่าความแปรผันของคะแนนฟิสิกส์เช่นกัน
- หาก t Stat มากกว่า t Critical two-tail ในเงื่อนไขนี้ เราไม่สามารถปฏิเสธ null hypothesis ได้ ในคำนวณข้างต้น เราเห็นว่า t Stat และค่า t Critical two-tail คือ 1.603 และ 2.36464 ตามลำดับ นั่นหมายถึง 1.603 < 2.36464 ไม่ตรงกับ null hypothesis กล่าวอีกนัยหนึ่ง ความแปรผันระหว่างสองตัวแปรไม่ตรงกัน
11.2 t-Test Two-Sample Assuming Equal Variances
ตอนนี้ เราจะทำ t-Test: Two-Sample Equal Variances ที่นี่ เรามีชุดข้อมูลที่มี ID นักเรียนและคะแนนคณิตศาสตร์และฟิสิกส์ของแต่ละนักเรียน ที่นี่ equal variance หมายถึงเราได้ข้อมูลจากประชากรการกระจายปกติ มาดูขั้นตอนในการทำ t-Test: Two-Sample Equal Variances analysis
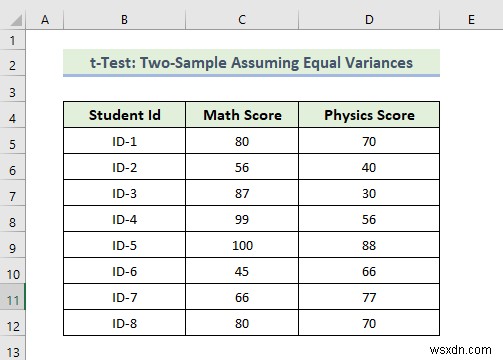
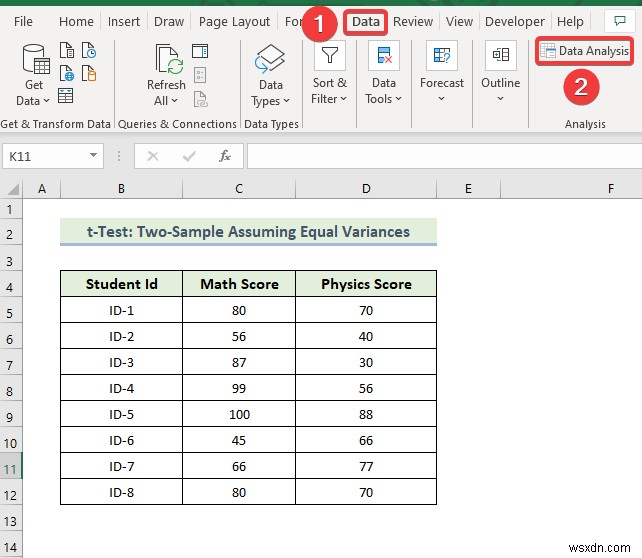
📌 ขั้นตอน:
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
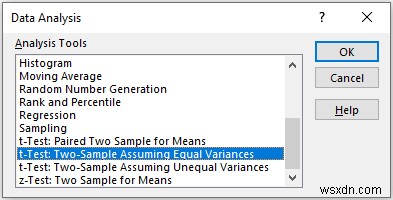
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก t-Test: Two-Sample Equal Variances
- จากนั้น คลิก OK
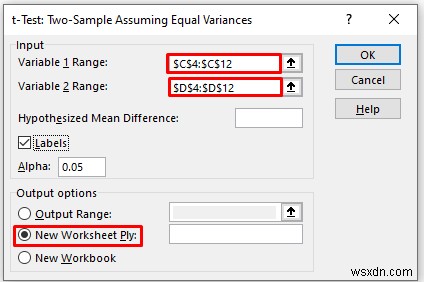
ในกล่อง t-Test: Paired Two Sample Equal Variances:
- ใส่ข้อมูลในกล่อง Input และใส่ช่วงข้อมูลในกล่อง Variable 1 Range และ Variable 2 Range
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- ต่อไป คุณต้องติ๊กถูก Labels หากช่วงข้อมูลอินพุตมีป้ายกำกับ
- จากนั้น คลิก OK
- ตามลำดับ คุณจะได้ผลลัพธ์ต่อไปนี้ของ t-Test: Two-Sample Equal Variances
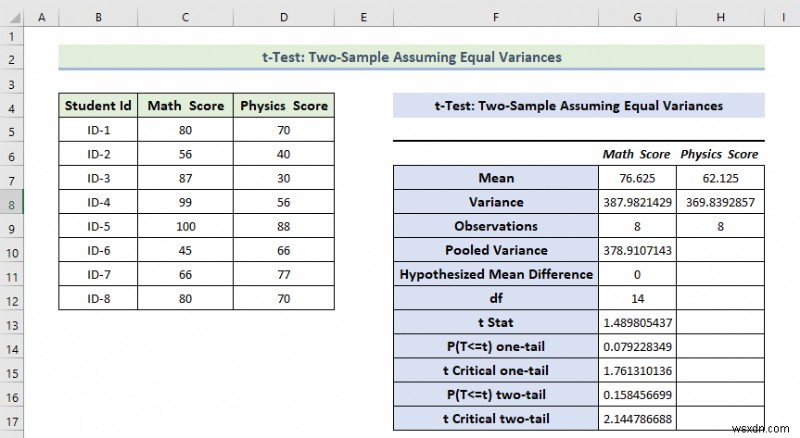
คำอธิบายผลลัพธ์:
- ที่นี่ เราเห็นว่าค่าเฉลี่ยของคะแนนคณิตศาสตร์มากกว่าค่าเฉลี่ยของคะแนนฟิสิกส์
- ความแปรผันของคะแนนคณิตศาสตร์ก็มากกว่าความแปรผันของคะแนนฟิสิกส์เช่นกัน
- หาก t Stat มากกว่า t Critical two-tail ในเงื่อนไขนี้ เราไม่สามารถปฏิเสธ null hypothesis ได้ ในคำนวณข้างต้น เราเห็นว่า t Stat และค่า t Critical two-tail คือ 1.48 และ 2.144 ตามลำดับ นั่นหมายถึง 1.48 < 2.144 ไม่ตรงกับ null hypothesis กล่าวอีกนัยหนึ่ง ความแปรผันระหว่างสองตัวแปรไม่ตรงกัน
11.3 t-Test: Two-Sample Assuming Unequal Variances
ตอนนี้ เราจะทำ t-Test: Two-Sample Unequal Variances ที่นี่ เรามีชุดข้อมูลที่มี ID นักเรียนและคะแนนคณิตศาสตร์และฟิสิกส์ของแต่ละนักเรียน ที่นี่ unequal variance หมายถึงเราได้ข้อมูลจากประชากรการกระจายที่ไม่สม่ำเสมอ มาดูขั้นตอนในการทำ t-Test: Two-Sample Unequal Variances analysis
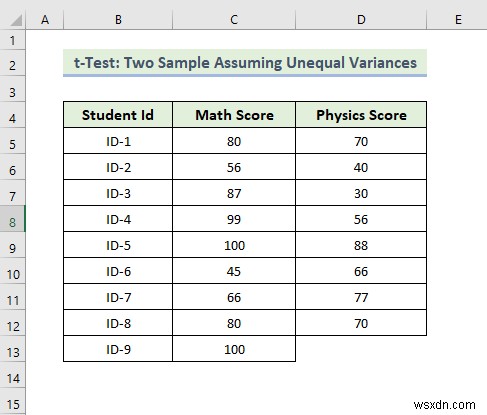
📌 ขั้นตอน:
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
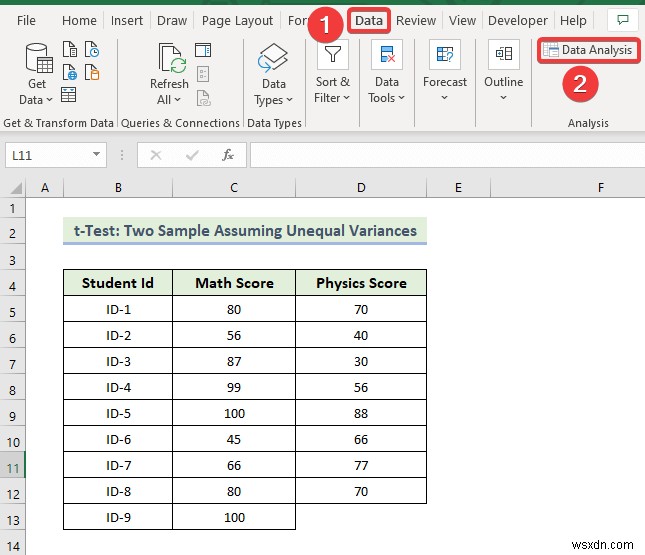
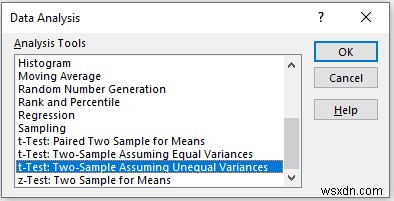
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก t-Test: Two-Sample Unequal Variances
- จากนั้น คลิก OK
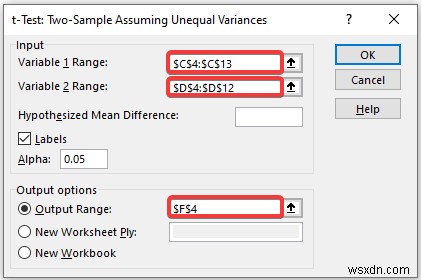
ในกล่อง t-Test: Paired Two Sample Unequal Variances:
- ใส่ข้อมูลในกล่อง Input และใส่ช่วงข้อมูลในกล่อง Variable 1 Range และ Variable 2 Range
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- ต่อไป คุณต้องติ๊กถูก Labels หากช่วงข้อมูลอินพุตมีป้ายกำกับ
- จากนั้น คลิก OK
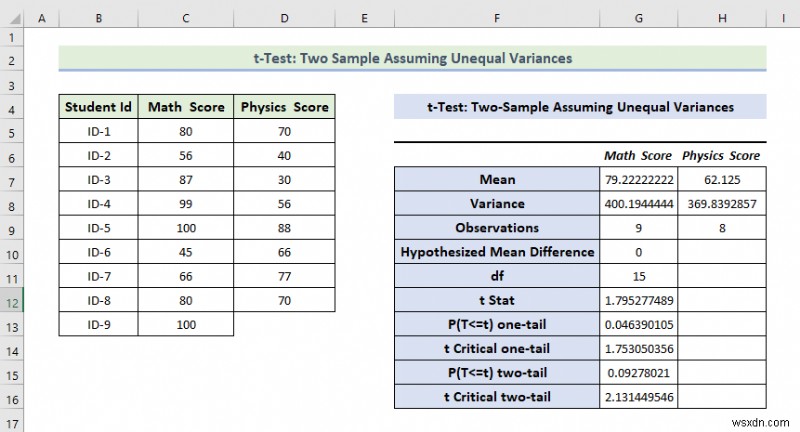
- ตามลำดับ คุณจะได้ผลลัพธ์ต่อไปนี้ของ t-Test: Two-Sample Unequal Variances
คำอธิบายผลลัพธ์:
- ที่นี่ เราเห็นว่าค่าเฉลี่ยของคะแนนคณิตศาสตร์มากกว่าค่าเฉลี่ยของคะแนนฟิสิกส์
- จากผลลัพธ์ข้างต้น เราเห็นความแปรผันของคะแนนคณิตศาสตร์ก็มากกว่าความแปรผันของคะแนนฟิสิกส์เช่นกัน
- หาก t Stat มากกว่า t Critical two-tail ในเงื่อนไขนี้ เราไม่สามารถปฏิเสธ null hypothesis ได้ ในคำนวณข้างต้น เราเห็นว่า t Stat และค่า t Critical two-tail คือ 79 และ 2.131 ตามลำดับ นั่นหมายถึง 1.79 < 2.131 ไม่ตรงกับ null hypothesis กล่าวอีกนัยหนึ่ง ความแปรผันระหว่างสองตัวแปรไม่ตรงกัน
12. z-Test: Two Sample for Means
ตอนนี้ เราจะทำ z-Test: Two-Sample Means ที่นี่ เรามีชุดข้อมูลที่มี ID นักเรียนและคะแนนคณิตศาสตร์และฟิสิกส์ของแต่ละนักเรียน ที่นี่เราจะใช้ ฟังก์ชัน VAR.P เพื่อคำนวณความแปรผันของทั้งสองตัวแปรของชุดข้อมูลต่อไปนี้ มาดูขั้นตอนในการทำ z-Test: Two-Sample Means analysis
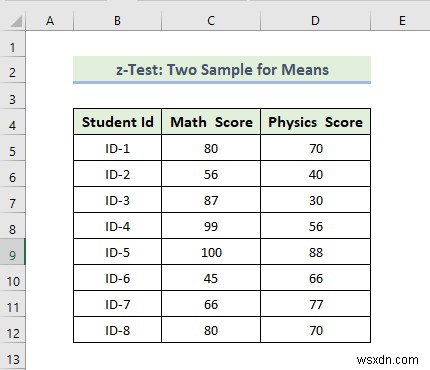
📌 ขั้นตอน:
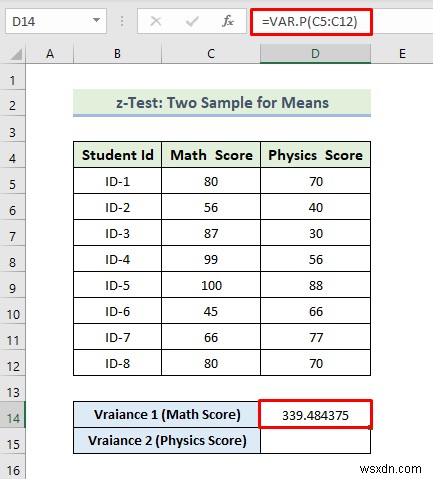
- ขั้นแรก เพื่อคำนวณความแปรผันของคะแนนคณิตศาสตร์ เราจะใช้สูตรต่อไปนี้ในเซลล์ D14:
=VAR.P(C5:C12)
- จากนั้น กด Enter
- ตามลำดับ คุณจะได้ความแปรผันของคะแนนคณิตศาสตร์ดังต่อไปนี้
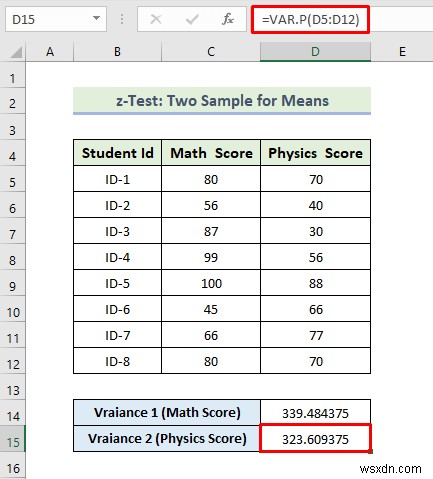
- ต่อไป เพื่อคำนวณความแปรผันของคะแนนฟิสิกส์ เราจะใช้สูตรต่อไปนี้ในเซลล์ D15:
=VAR.P(D5:D12)
- จากนั้น กด Enter
- ตามลำดับ คุณจะได้ความแปรผันของคะแนนฟิสิกส์ดังต่อไปนี้
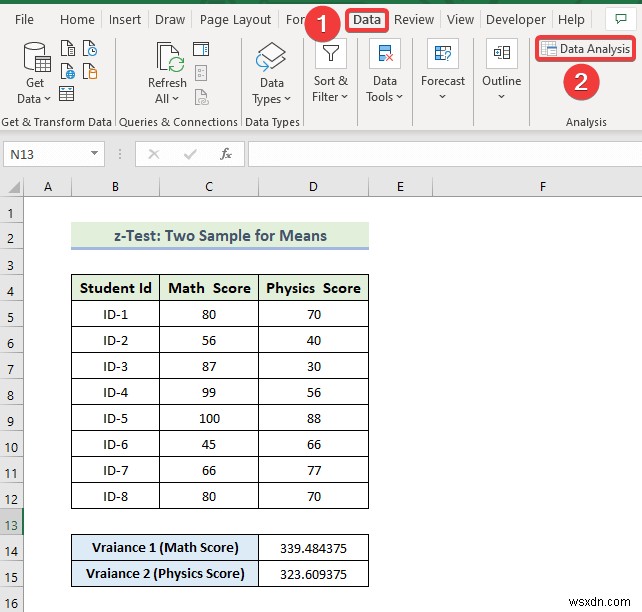
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
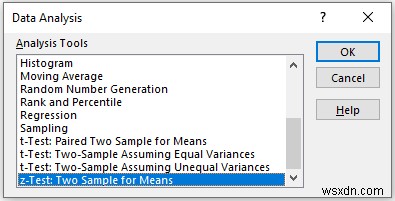
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก z-Test: Two-Sample Means
- จากนั้น คลิก OK
ในกล่อง z-Test: Two-Sample Means:
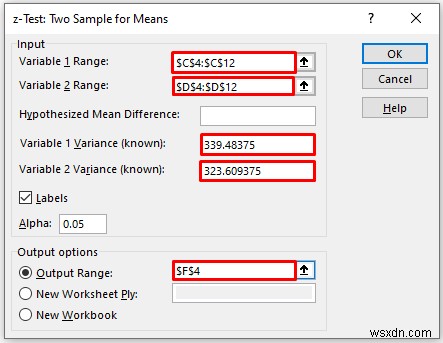
- ใส่ข้อมูลในกล่อง Input และใส่ช่วงข้อมูลในกล่อง Variable 1 Range และ Variable 2 Range
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- คุณต้องใส่ค่าความแปรผันของคะแนนคณิตศาสตร์และฟิสิกส์ตามลำดับใน Variable 1 Variance (known) และ Variable 2 Variance (known)
- ต่อไป คุณต้องติ๊กถูก Labels หากช่วงข้อมูลอินพุตมีป้ายกำกับ
- จากนั้น คลิก OK
- ตามลำดับ คุณจะได้ผลลัพธ์ต่อไปนี้ของตัวเลือก z-Test: Two-Sample Means
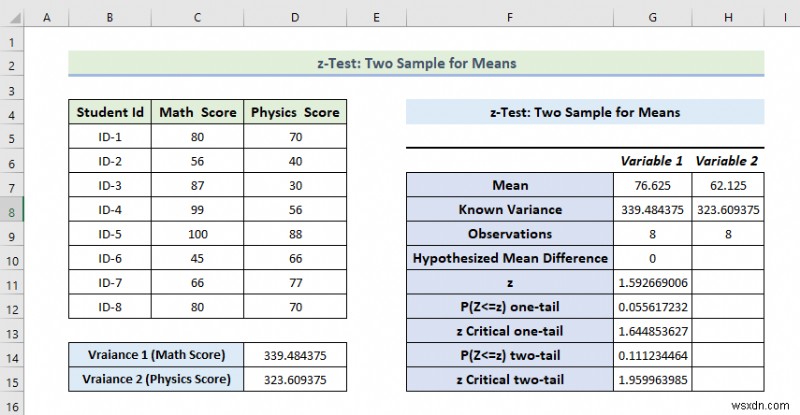
คำอธิบายผลลัพธ์:
- ที่นี่ เราเห็นว่าค่าเฉลี่ยของคะแนนคณิตศาสตร์มากกว่าค่าเฉลี่ยของคะแนนฟิสิกส์
- จากผลลัพธ์ข้างต้น เราเห็นความแปรผันของคะแนนคณิตศาสตร์ก็มากกว่าความแปรผันของคะแนนฟิสิกส์เช่นกัน
- หาก Z น้อยกว่า Z critical two-tall ในเงื่อนไขนี้ เราไม่สามารถปฏิเสธ null hypothesis ได้ ในคำนวณข้างต้น เราเห็นว่า z และ z Critical two-tail คือ 52 และ 1.95 ตามลำดับ นั่นหมายถึง 1.52 < 1.95 ซึ่งตรงกับ null hypothesis กล่าวอีกนัยหนึ่ง ความแปรผันระหว่างสองตัวแปรตรงกัน
อ่านเพิ่มเติม: วิธีทำ Case Study ด้วยการวิเคราะห์ข้อมูล Excel
13. การวิเคราะห์ Sampling
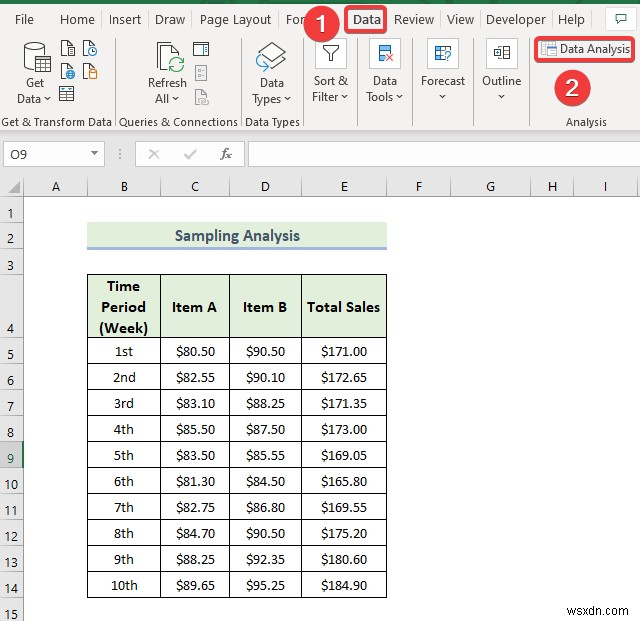
ตอนนี้ เราจะทำ sampling analysis ซึ่งเป็นหนึ่งในคุณสมบัติที่ดีที่สุดของ Excel data analysis toolpak ที่นี่ เรามีชุดข้อมูลที่มียอดขายแยกและมูลค่ายอดขายรวมของสองรายการสำหรับช่วงเวลาต่างๆ มาดูขั้นตอนในการทำ sampling analysis
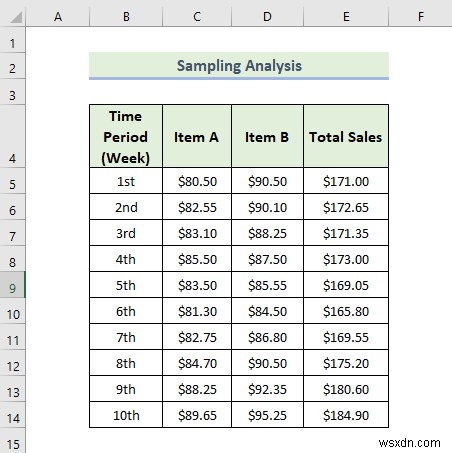
📌 ขั้นตอน:
- ขั้นแรก ไปที่แท็บ Data ในริบบิ้นด้านบน
- จากนั้น เลือกเครื่องมือ Data Analysis
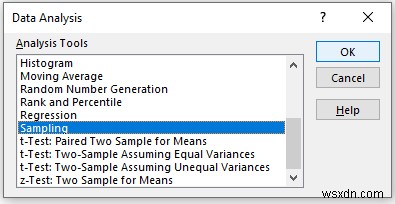
- เมื่อหน้าต่าง Data Analysis ปรากฏ ให้เลือกตัวเลือก Sampling
- จากนั้น คลิก OK
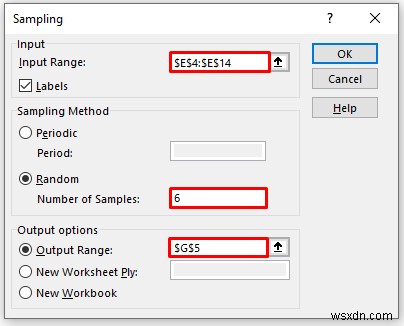
ในกล่อง Sampling:
- ใส่ข้อมูลในกล่อง Input Range ที่คุณต้องการคำนวณ moving average โดยลากผ่านคอลัมน์หรือแถว
- ในกล่อง Output Range ใส่ช่วงข้อมูลที่คุณต้องการให้ข้อมูลที่คำนวณได้เก็บไว้โดยลากผ่านคอลัมน์หรือแถว หรือคุณสามารถแสดงผลลัพธ์ในแผ่นงานใหม่โดยเลือก New Worksheet Ply และคุณยังสามารถดูผลลัพธ์ในสมุดงานใหม่โดยเลือก New Workbook
- คุณต้องใส่ข้อมูลในตัวเลือก Number of Samples
- ต่อไป คุณต้องติ๊กถูก Labels หากช่วงข้อมูลอินพุตมีป้ายกำกับ
- จากนั้น คลิก OK
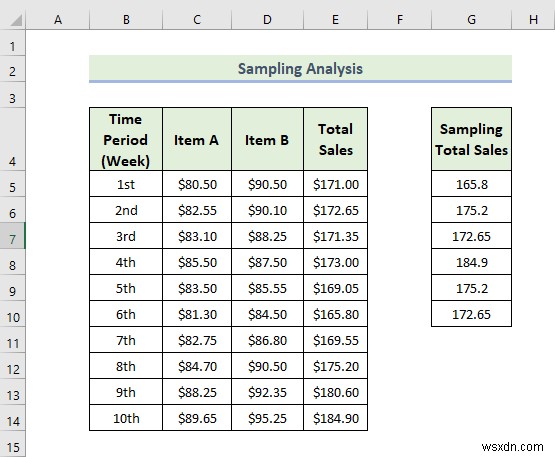
- ตามลำดับ คุณจะได้ผลลัพธ์ต่อไปนี้ของ Sampling analysis ในภาพต่อไปนี้ เราสามารถเลือกตัวอย่างได้หกตัวจากคอลัมน์ Total Sales หากคุณต้องการเลือกตัวอย่างข้อมูลเพิ่มเติมจากคอลัมน์นี้ คุณต้องใส่ตัวเลขมากขึ้นในกล่อง Number of Samples เมื่อหน้าต่าง Sampling ปรากฏ
อ่านเพิ่มเติม: วิธีวิเคราะห์ข้อมูลการขายใน Excel (10 วิธีง่ายๆ)
สรุป
นี่คือจบของเซสชันวันนี้ ที่นี่ เราสาธิต 13 ตัวอย่างที่เหมาะสมในการใช้ data analysis toolpak ฉเชื่อมั่นอย่างมากว่าตั้งแต่ตอนนี้ คุณอาจสามารถใช้ data analysis toolpak ใน Excel ได้ หากคุณมีคำถามหรือคำแนะนำ โปรดแชร์ในส่วนความคิดเห็นด้านล่าง
อย่าลืมตรวจสอบเว็บไซต์ Exceldemy.com ของเราสำหรับปัญหาและโซลูชันเกี่ยวกับ Excel ต่างๆ เรียนรู้วิธีใหม่ๆ และเติบโตต่อไป!
บทความที่เกี่ยวข้อง
- วิธีวิเคราะห์ข้อมูลใน Excel ด้วย Pivot Tables (9 ตัวอย่างที่เหมาะสม)
- Analyze Time-Scaled Data in Excel (With Easy Steps)
- วิธีวิเคราะห์ข้อมูลเชิงคุณภาพใน Excel (พร้อมขั้นตอนง่ายๆ)
- Analyze qPCR Data in Excel (2 Easy Methods)
- วิธีวิเคราะห์ข้อมูลข้อความใน Excel (5 วิธีที่เหมาะสม)
